
Qwen-Drive 1.0 开源:一个 4B 模型,如何同时做 3D 感知、驾驶问答与轨迹规划?
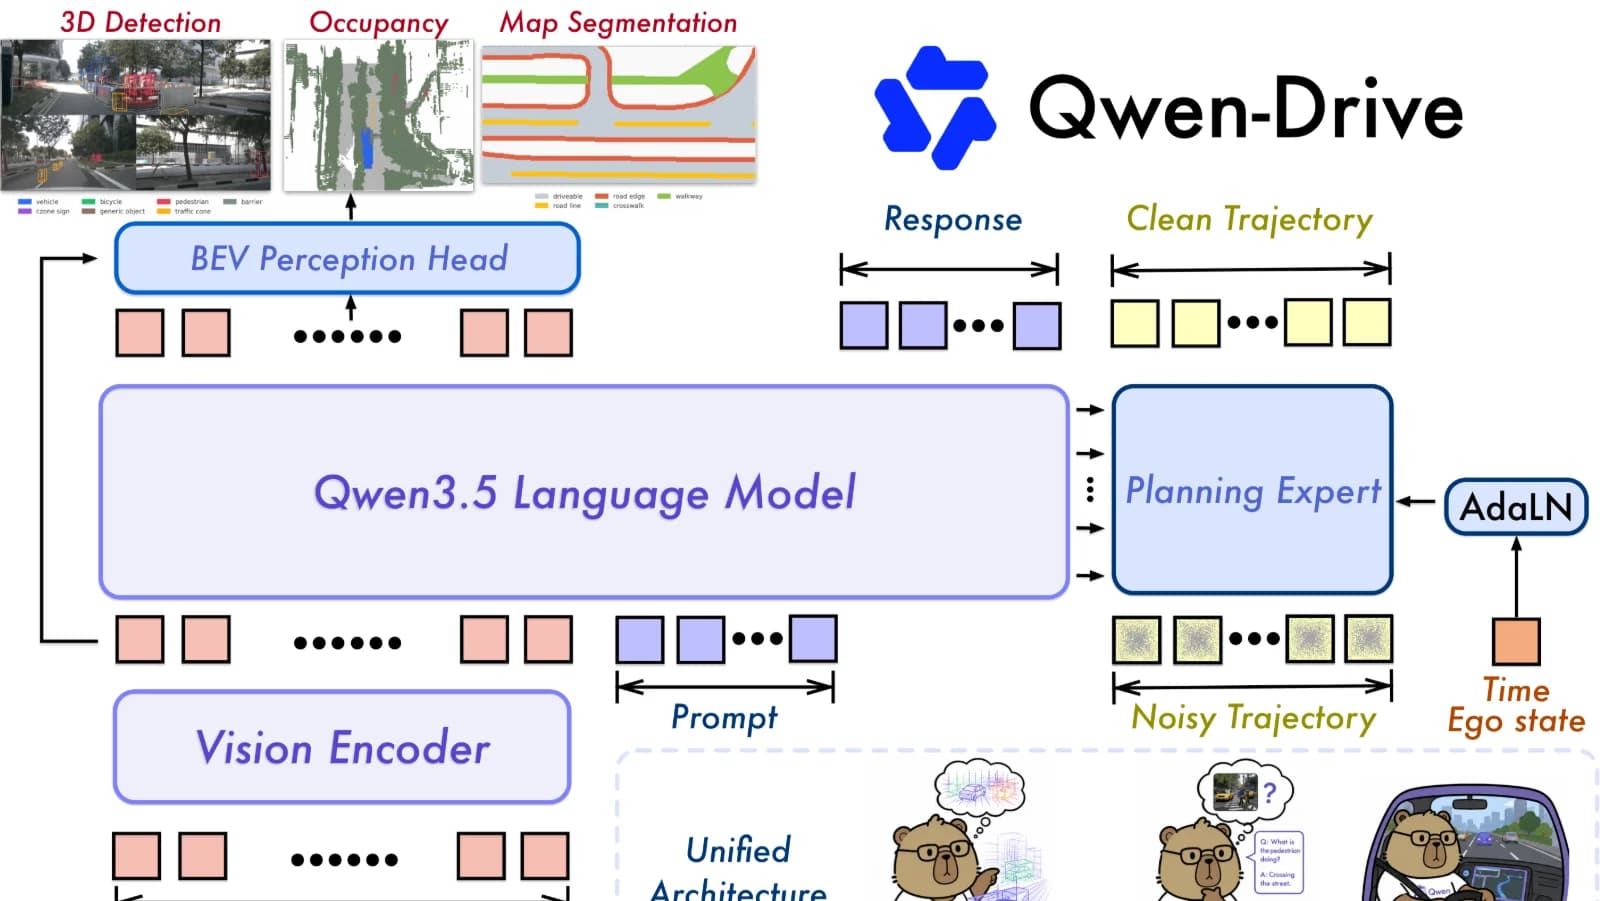
自动驾驶大模型正在走向一个很诱人的方向:一套模型既能看懂道路,也能解释为什么要减速,最后还能直接给出未来几秒怎么走。
但“能描述道路”与“真的理解三维空间”之间,还有一道很深的沟。
一个视觉语言模型可以流畅地说出“前方有车辆,应该保持安全距离”,却未必能准确回答:车辆究竟在几米外?可行驶区域延伸到哪里?旁边的障碍物会不会侵入未来轨迹?更现实的问题是,如果为了驾驶任务把通用视觉语言模型重新训练一遍,它原本的问答、知识和指令跟随能力还可能被破坏。
Qwen-Drive 1.0 想解决的正是这个矛盾。
它以 Qwen3.5-4B 为共享视觉语言底座,不改动预训练 VLM 的原生网络结构,而是在外部接入两个模块:一个 BEV 感知头负责 3D 检测、语义占据预测和 BEV 地图分割;一个 Planning Expert 通过 Flow Matching 生成车辆未来轨迹。原来的语言解码器则继续承担通用问答和驾驶场景问答。
更重要的是,这次发布的不只有论文。官方仓库 同时给出了权重、推理代码、Demo 数据、评测脚本和自定义数据接口。因此,这篇文章采用“工程实践为主、论文机制为辅”的方式:先弄清它是什么、能做什么,再实际跑起来,最后讨论它距离真实上车还有多远。
一句话概括:Qwen-Drive 1.0 不是把所有自动驾驶模块塞进一个黑盒,而是让一个共享 VLM 提供统一表征,再按任务外挂可检查的 3D 感知头和轨迹规划专家。
先看工程结论:它开放到了哪一步?
截至本文核验的 2026 年 9 月 5 日,官方发布的是 Qwen-Drive 1.0 的首个版本,仓库版本为 1.0.0,模型采用 Apache 2.0 许可证。
| 项目 | 当前官方发布内容 |
|---|---|
| 共享底座 | Qwen3.5-4B 视觉语言模型 |
| 三种模式 | VQA、直接规划、带推理的规划 |
| 3D 感知 | 3D 检测、语义 Occupancy、BEV 地图分割 |
| 轨迹输出 | 未来 5 秒、10 Hz、50 个 (x, y, heading) 路点 |
| 规划采样 | Flow Matching,默认 10 步 Euler 求解,可一次采样多条轨迹 |
| 模型文件 | VLM 约 9.1 GB;SFT/RL 规划专家各约 2.1 GB;感知头约 0.5 GB |
| 推荐硬件 | 官方建议 24 GB 以上显存的 GPU |
| 软件环境 | Python ≥ 3.10;PyTorch ≥ 2.8;Transformers 5.14.x;FlashAttention ≥ 2.8 |
| 开源范围 | 权重、推理代码、Demo、数据格式与评测脚本;当前仓库不包含完整训练代码 |
| 许可证 | Apache 2.0 |
这里有两个容易被模型名误导的地方。
第一,Qwen-Drive-1.0-4B 中的 4B 指共享 VLM 的规模。规划模式还会额外挂载约 1.1B 参数的 Planning Expert,因此论文在闭环对比中将完整规划模型记为约 5B,Hugging Face 侧栏也显示约 5B 参数。它不是“完整系统总共只有 4B”。
第二,“统一感知、问答和规划”不等于一次前向就同时吐出全部结果。三种任务共享 VLM,但使用不同输入组织、运行模式和任务头。工程上仍然要明确自己是在跑 VQA、规划还是感知。
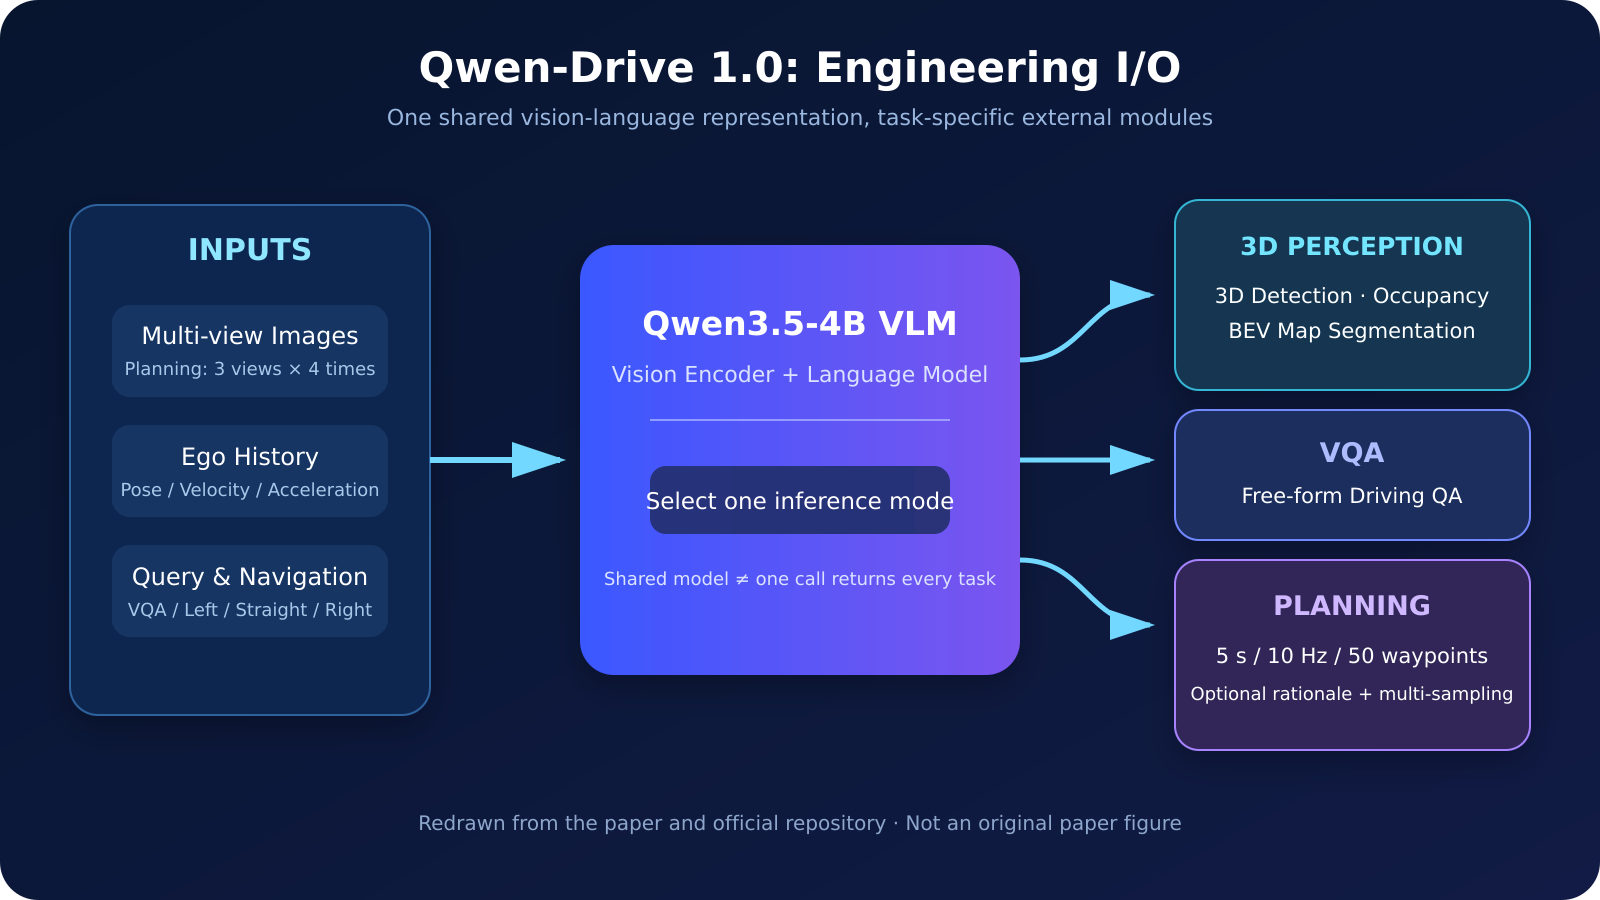
图 1 Qwen-Drive 1.0 的工程输入输出:共享表征不等于单次调用返回所有任务
核心设计:保留 VLM 主体,把驾驶能力接到外面
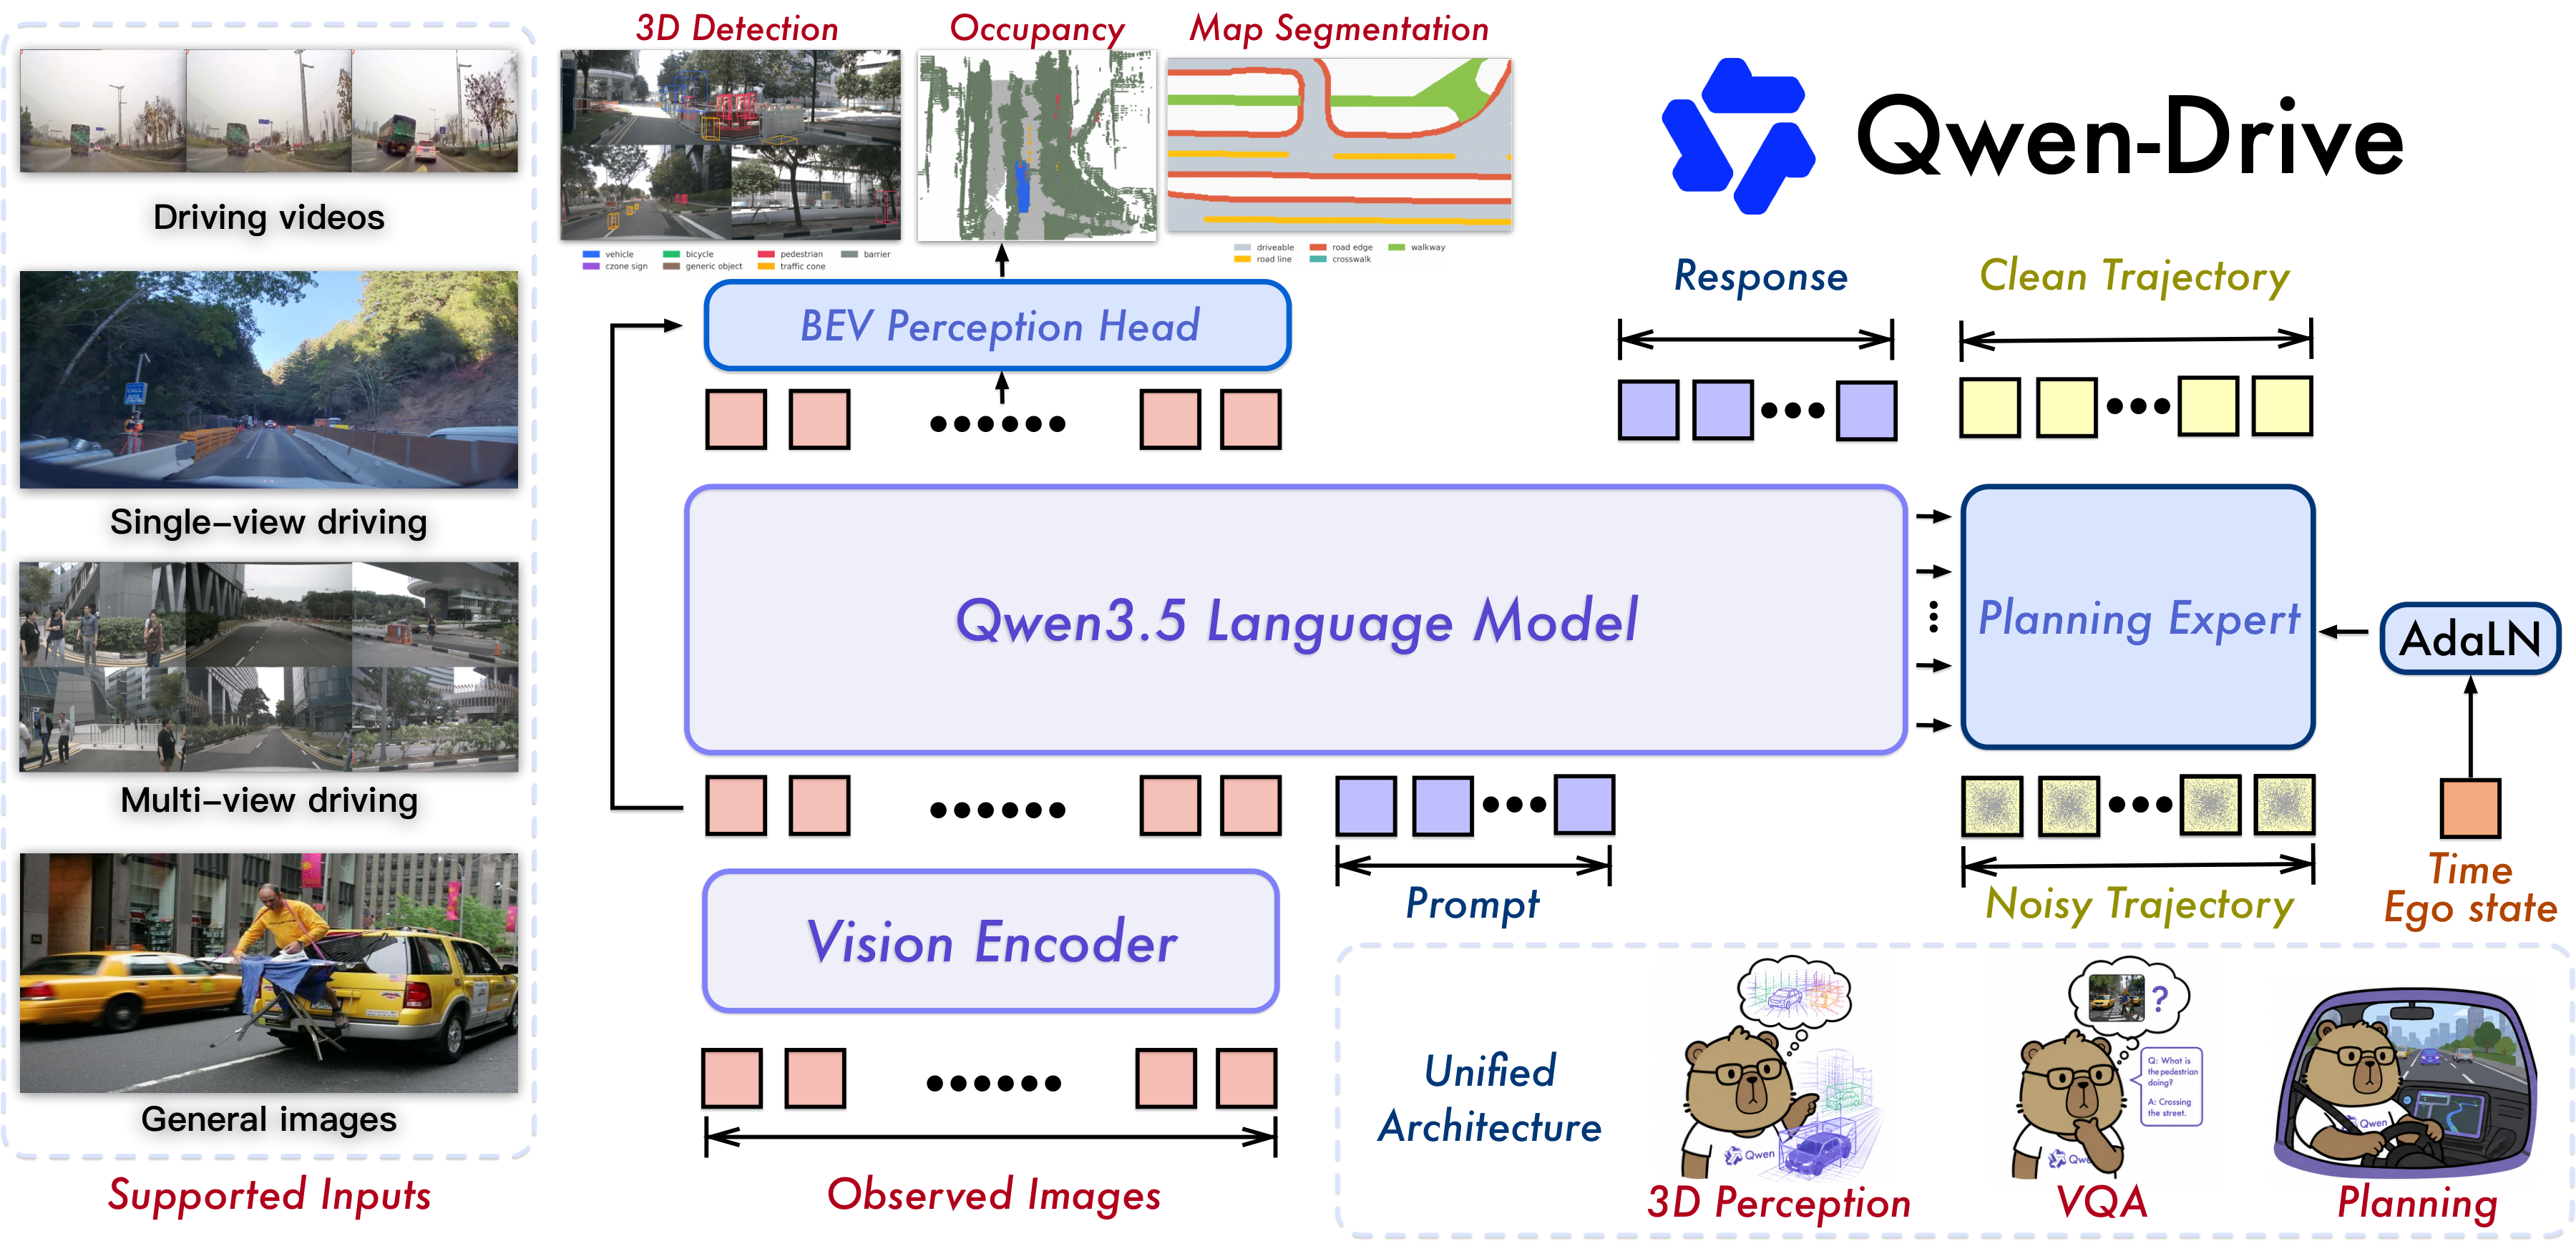
图 2 Qwen-Drive 1.0 统一架构:共享 Qwen3.5 VLM 外接 BEV 感知头与 Planning Expert
这张图是理解整套系统的关键。
左侧输入可以是通用图片、单视角道路图像、多视角相机环视,也可以是带时间序列的驾驶视频。所有图像先经过视觉编码器,再进入 Qwen3.5-4B VLM。随后根据任务不同,信息走向三条出口:
- VQA:直接由原有语言解码器生成文本回答;
- 3D 感知:BEV Perception Head 从视觉编码器和 VLM 中间表征构建鸟瞰空间;
- 运动规划:Planning Expert 读取 VLM 缓存的场景特征,生成未来自车轨迹。
这种设计的工程价值在于“底座稳定、任务模块可替换”。VLM 主体保持 Qwen3.5 的架构,驾驶能力主要通过外挂模块和分阶段训练获得。于是问答、感知和规划可以共用一套视觉语言表征,但感知结果仍然是可投影、可查看的 3D 框、Occupancy 和地图,而不是只藏在一段语言解释里。
BEV 感知头:让“看懂道路”变成可检查的空间输出
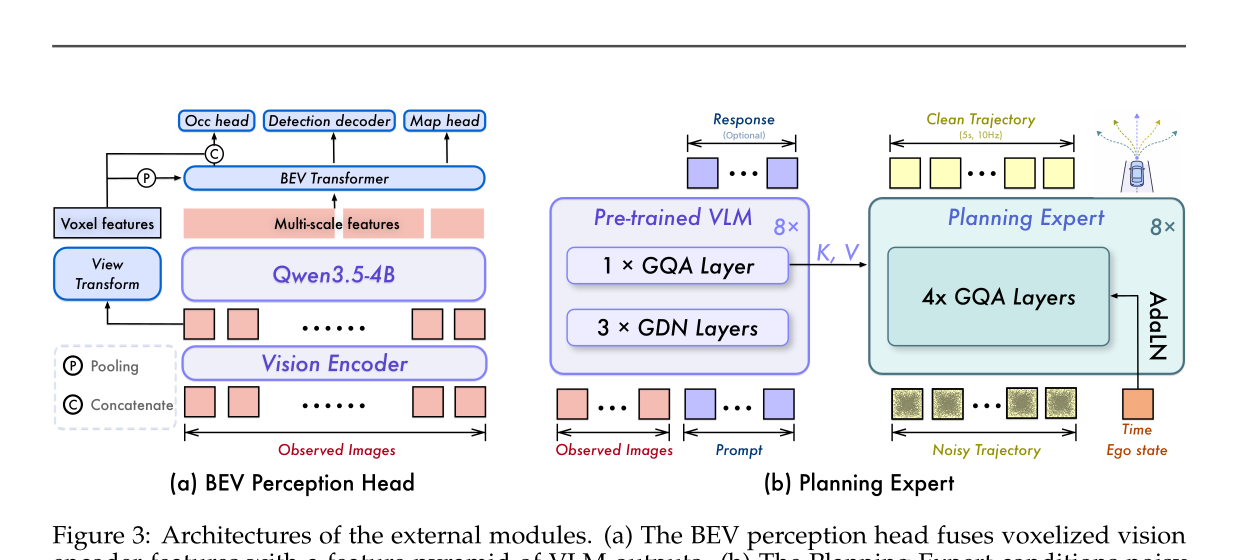
图 3 两个外部模块的内部结构:BEV 感知头融合低层视觉特征与 VLM 语义特征;规划专家读取 VLM 的 K/V 缓存生成轨迹
BEV 感知头同时读取两类信息:
- 视觉编码器输出的低层图像特征,保留纹理、边缘和局部几何;
- 图像 token 经过完整 VLM 后得到的高层语义特征,带有更丰富的场景上下文。
低层特征先经过深度感知的 View Transform,被“抬升”到三维体素空间;随后与 VLM 多尺度特征一起进入 BEV Transformer,最终由三个解码头分别输出:
- 最多 300 个 3D 目标框,覆盖 7 个统一类别;
200 × 200 × 16的语义占据网格,共 10 类;- 60 m × 30 m、0.15 m 分辨率的 BEV 地图,共 6 类。
这也是论文将它称为“3D probe”的原因:它不仅追求感知分数,还用显式输出检查共享 VLM 表征里到底有没有足够的三维信息。
不过,当前发布的感知模式并不是随便换一套相机就能稳定工作。官方权重在 nuScenes 六相机和 OpenScene/nuPlan 八相机配置上训练,输入分辨率固定为 896×512;换相机内参、外参、安装高度或视场角,都可能明显掉点。
Planning Expert:不是输出方向盘角度,而是生成未来 50 个路点
Planning Expert 是一个 32 层、隐藏维度 1024、约 1.1B 参数的轨迹生成网络。它从共享 VLM 的 8 个 GQA 层读取 K/V 缓存,再将场景信息与车辆历史轨迹、速度、加速度、导航指令、当前状态和 Flow 时间一起注入轨迹 token。
每次规划固定输出 50 个路点,对应未来 5 秒、10 Hz 的 (x, y, heading)。训练时,模型学习把高斯噪声轨迹还原成真实轨迹;推理时默认从噪声出发,用 10 步 Euler 求解得到最终结果。
它还支持两种规划方式:
DIRECT_PLANNING:VLM 处理完场景后直接生成轨迹;REASONING_PLANNING:VLM 先生成一段规划理由,再把包含这段理由的缓存交给规划专家。
官方同时发布了两个专家:planner-sft 来自模仿学习,直接规划和推理规划都能用;planner-rl 进一步在 NAVSIM、WOD-E2E 和 PAI-AV 的奖励上优化,只在“带推理的 rollout”上训练,因此官方要求它运行在 REASONING_PLANNING 模式。
四阶段训练:先让模型看见 3D,再教它规划
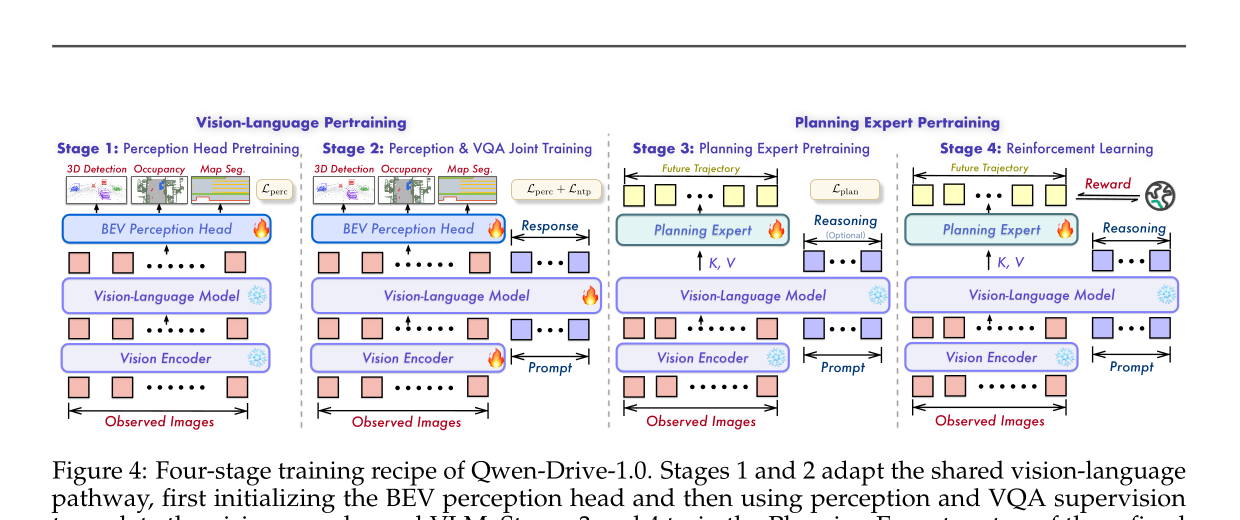
图 4 Qwen-Drive 1.0 四阶段训练流程:感知头预训练、感知与 VQA 联合训练、规划专家预训练、强化学习优化
Qwen-Drive 没有从一开始就把所有损失混在一起,而是分四步推进:
- 先冻结 VLM,只训练 BEV 感知头。 让新增模块学会构建和解码自车坐标系下的 3D 表征。
- 联合训练感知和 VQA。 视觉编码器、VLM 与 BEV 头一起更新;驾驶数据负责注入领域知识,通用视觉语言数据用于降低灾难性遗忘。
- 冻结视觉编码器与 VLM,只训练 Planning Expert。 轨迹监督来自多个公开驾驶数据集,既包含带规划理由的样本,也包含纯轨迹样本。
- 继续冻结 VLM,用强化学习优化规划专家。 NAVSIM、WOD-E2E 和 PAI-AV 分别提供与任务匹配的奖励,同时加入位移项约束轨迹不要为了刷奖励偏离真实驾驶过多。
这个顺序背后的工程逻辑很朴素:先稳定共享视觉表征,再训练动作头;把感知、问答和规划分开初始化,避免新增模块一上来就扰乱预训练 VLM。
实验到底证明了什么?
Qwen-Drive 的实验覆盖 3D 感知、驾驶问答、通用视觉语言能力、开放环规划、伪闭环规划和闭环模拟。数字很多,但真正值得记住的是下面几组。
1. VLM 可以被训练出显式 3D 能力
在统一标签后的 nuScenes 和 OpenScene 验证集上,Qwen-Drive-1.0-SFT 分别取得:
| 数据集 | 3D Detection mAP ↑ | BEV Map mIoU ↑ |
|---|---|---|
| nuScenes | 43.95 | 60.99 |
| OpenScene | 43.45 | 71.27 |
作者没有把这个轻量 BEV 头包装成一个专门冲榜的感知器,而是把它视为对共享表征的显式探针。从定性结果看,同一模型能够同时给出环视 3D 框、占据栅格和道路地图。
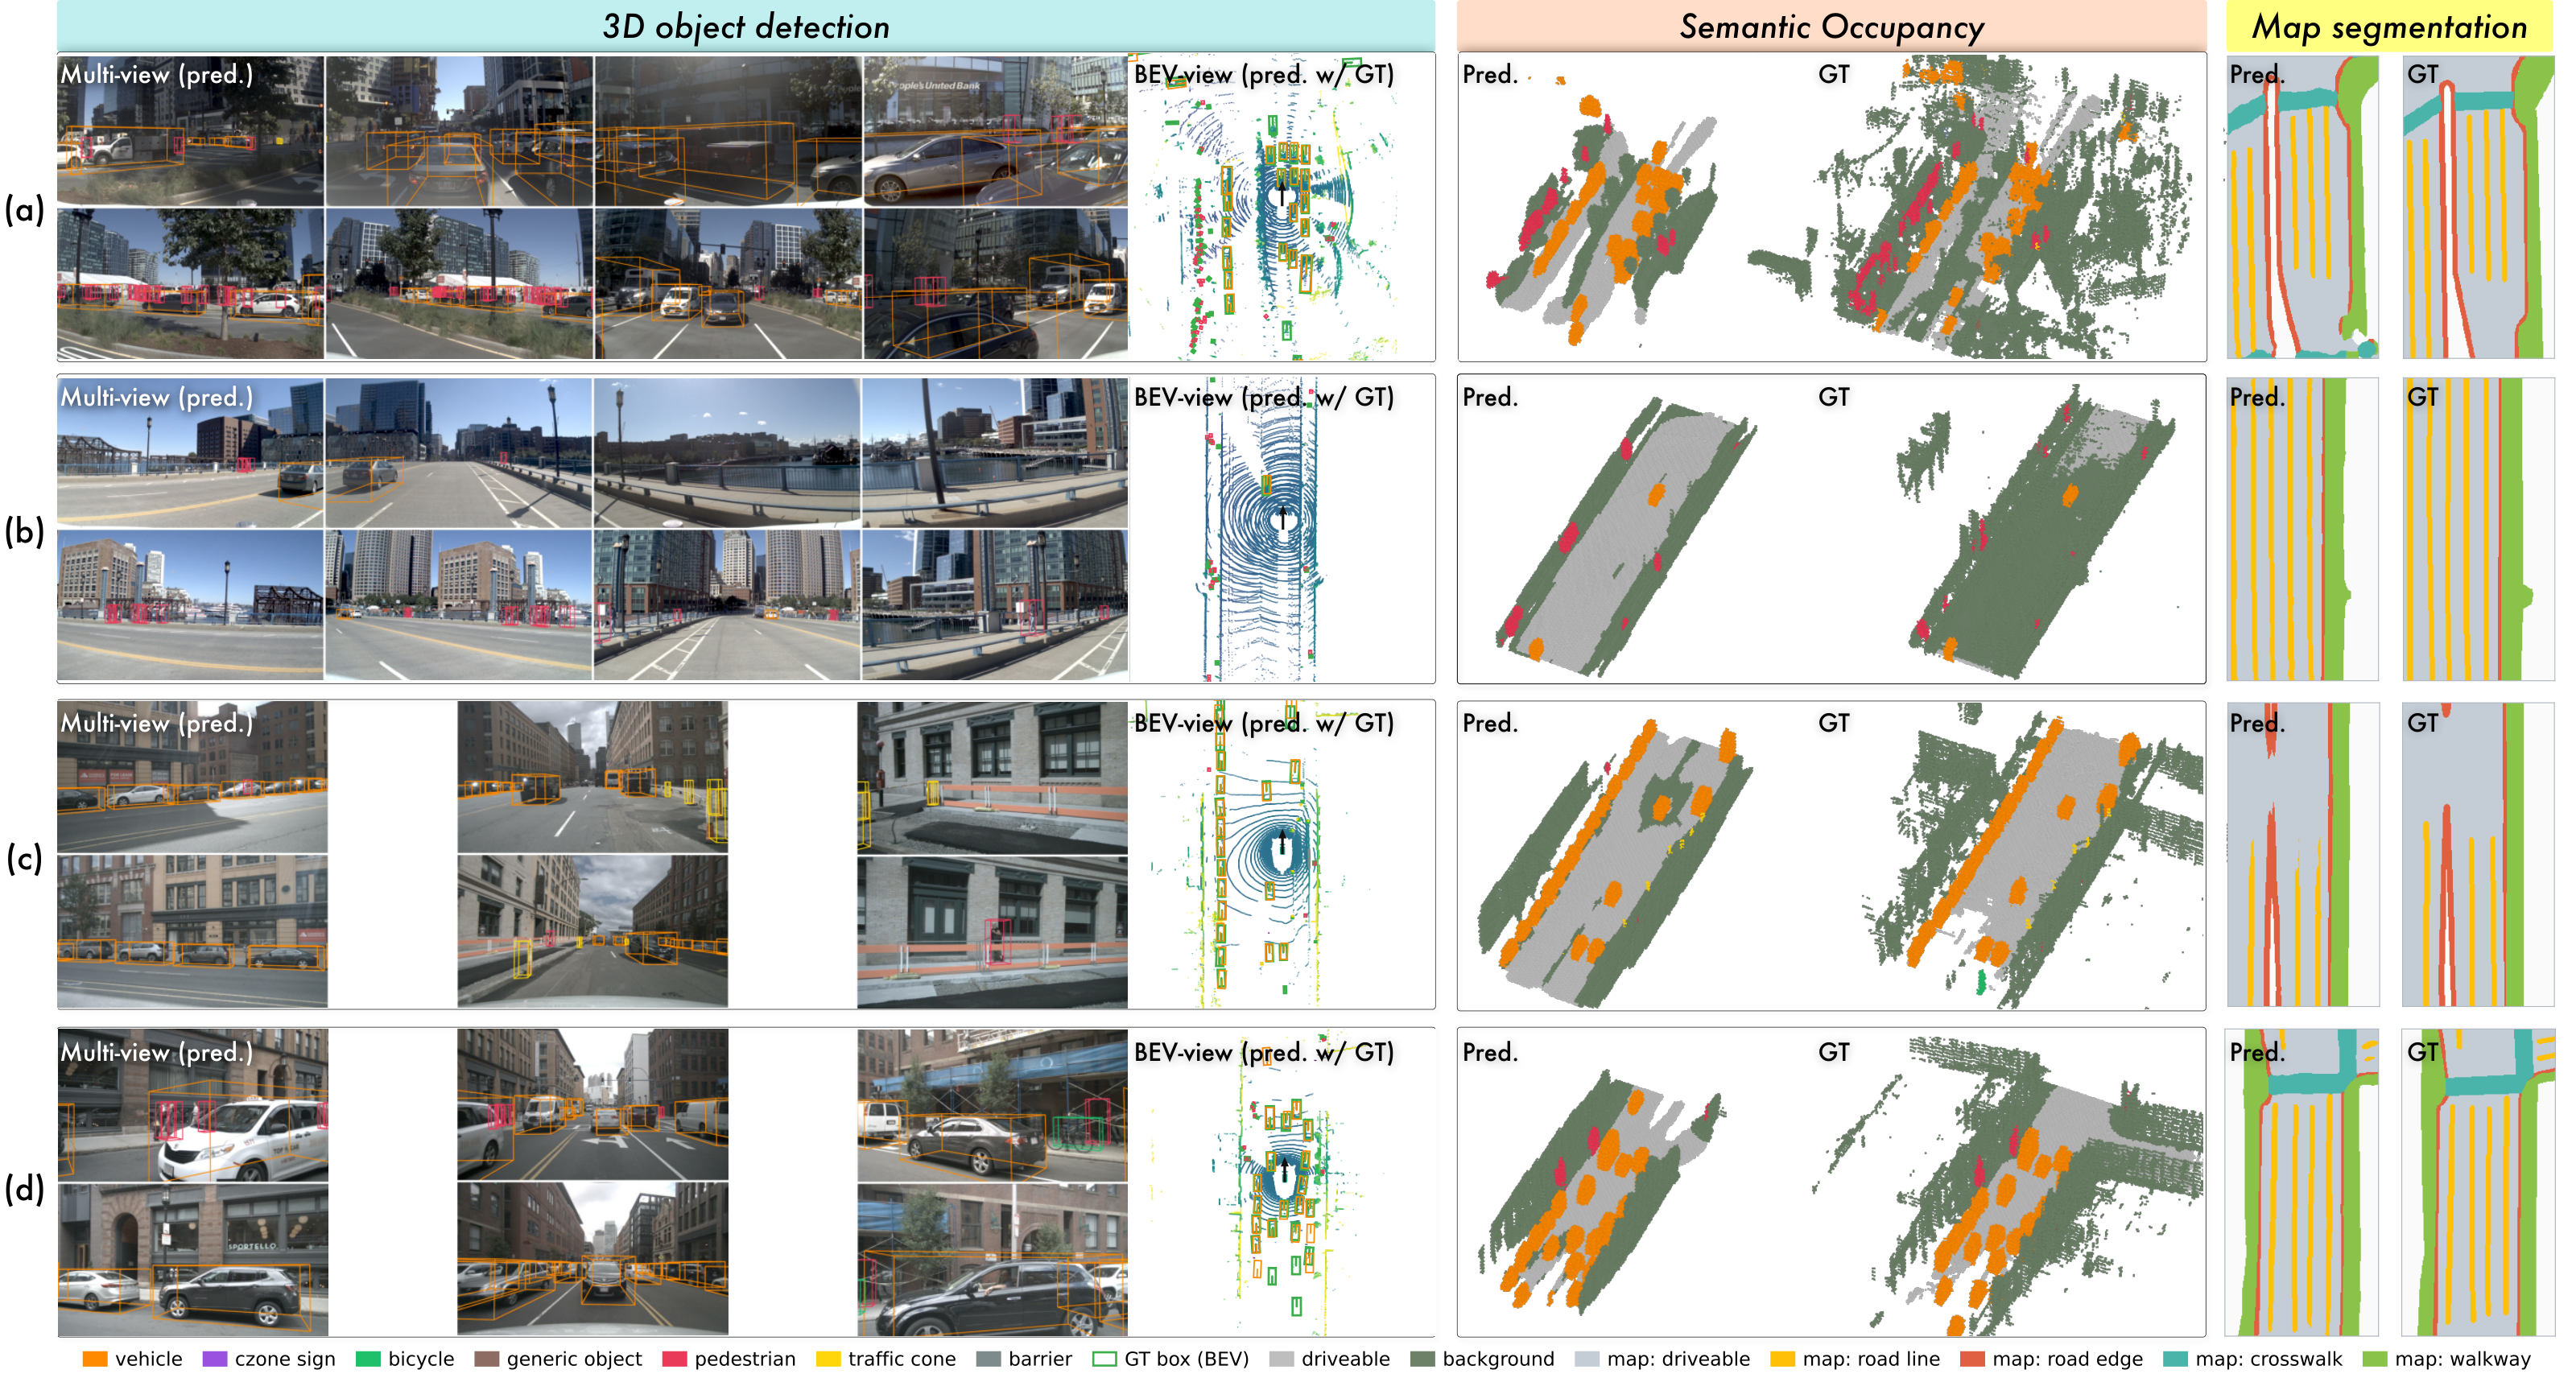
图 5 Qwen-Drive 在 OpenScene 与 nuScenes 上的 3D 检测、语义 Occupancy 和地图分割结果
2. 驾驶问答提升了,通用能力没有完全丢掉
在驾驶场景理解上,Qwen-Drive-1.0-SFT 的 LingoQA 得分为 77.8,高于 Qwen3.5-4B 的 70.4;Ego3D RMSE 从 13.17 降到 7.78;WaymoQA safety 从 62.5 提升到 70.7。
但这里要注意评测口径。论文为所有对比模型统一采用近确定性解码,并用 Qwen-Plus 作为 LingoQA judge;在官方 LingoJudge 协议下,Qwen-Drive 的 LingoScore 是 79.4。因此,横向比较时必须看同一 judge 下的数字,不能把两个协议混用。
在通用视觉语言基准上,模型整体接近 Qwen3.5-4B:有的指标略降,有的上升。更准确的说法是“基本保留通用能力”,而不是“驾驶训练完全没有任何遗忘”。
3. RL 提升了偏好与安全,但不是所有指标都一起变好
Qwen-Drive-1.0-RL 在 NAVSIM v1.1 navtest 上达到 90.7 PDMS;从六条采样轨迹中用真实评分挑最好的一条,可达到 91.4。但这个 best-of-6 使用了 ground truth,是一个 oracle 上界,不是实际部署时可以直接获得的在线选择器。
在 WOD-E2E 测试集上,RL 将 RFS 从 7.78 提升到 7.91;在 AlpaSim 的 916 个闭环场景中,离路率从 SFT 的 24% 降到 12%,at-fault score 从 0.27 提升到 0.37。
代价也很明确:RL 模型在 PAI-AV 开放环位移指标上略差,闭环 progress 从 54% 降到 48%,说明策略变得更安全,也更保守。论文在 AlpaSim 上的 at-fault score 仍低于 Alpamayo-1.5 的 0.45,不能把 90.7 PDMS 直接解读成“整体自动驾驶能力已经全面最强”。
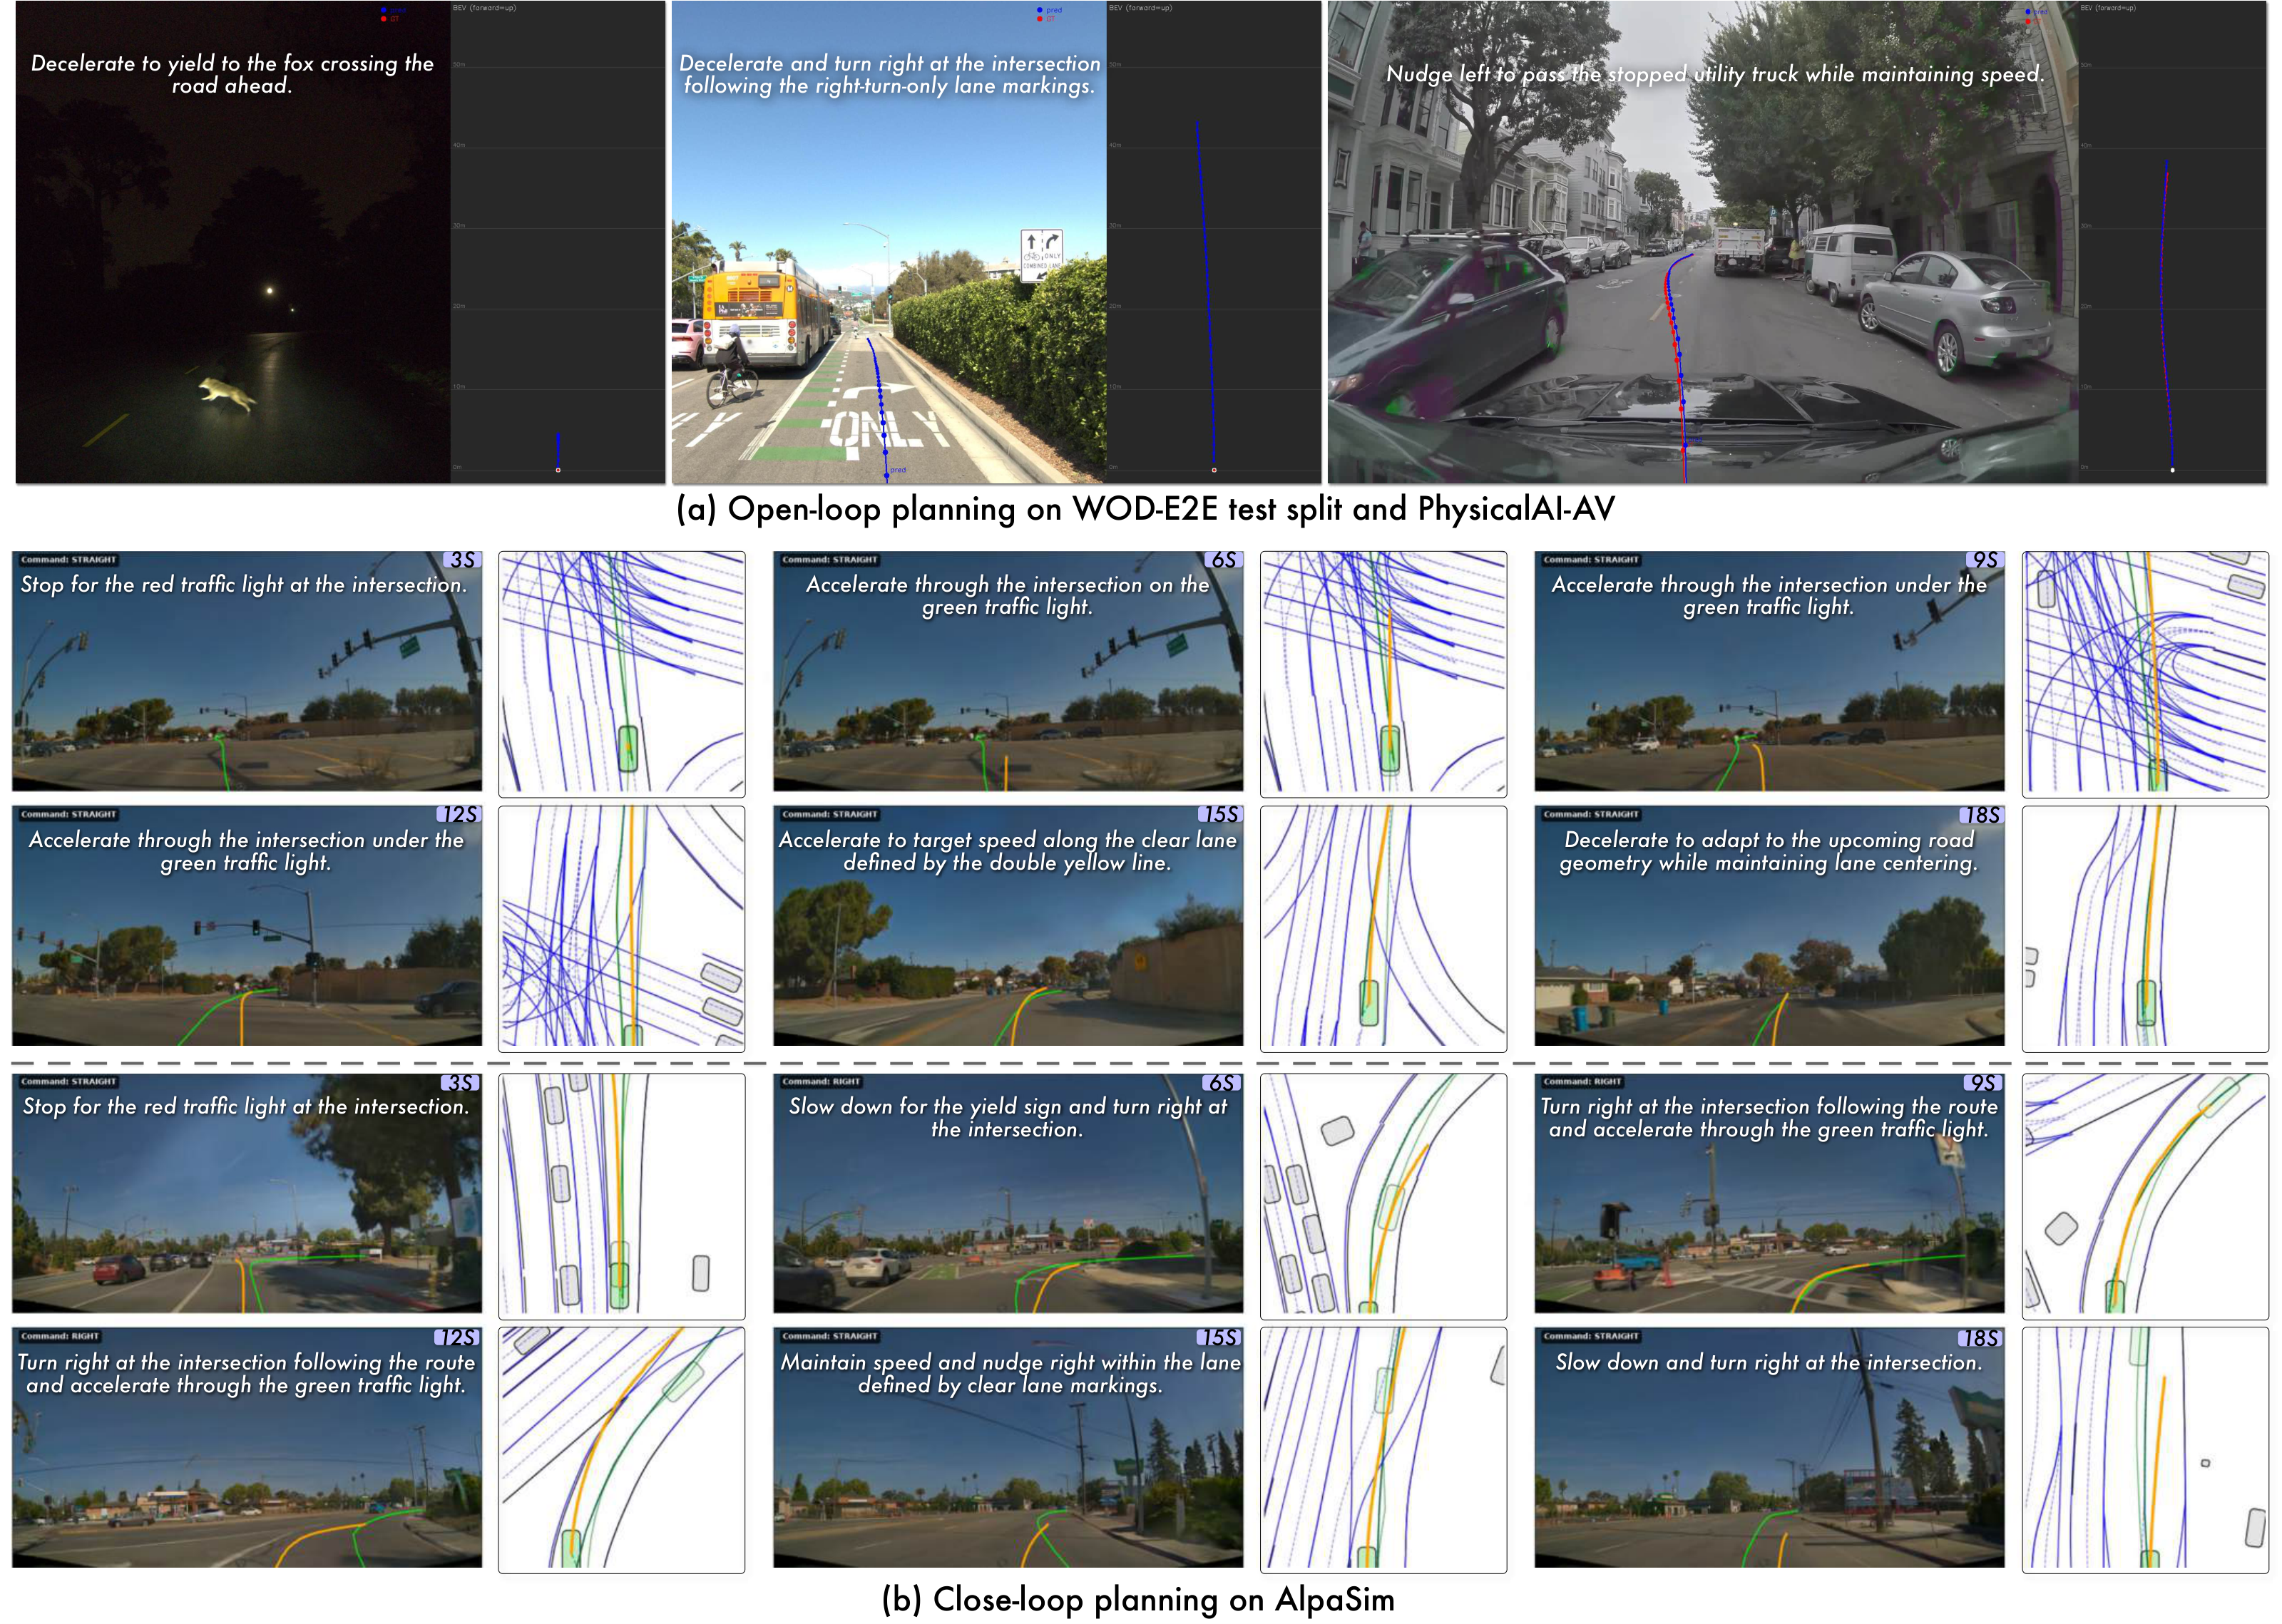
图 6 开放环与闭环规划案例:红/蓝轨迹与道路场景共同展示模型如何根据动物、车道和前车调整计划
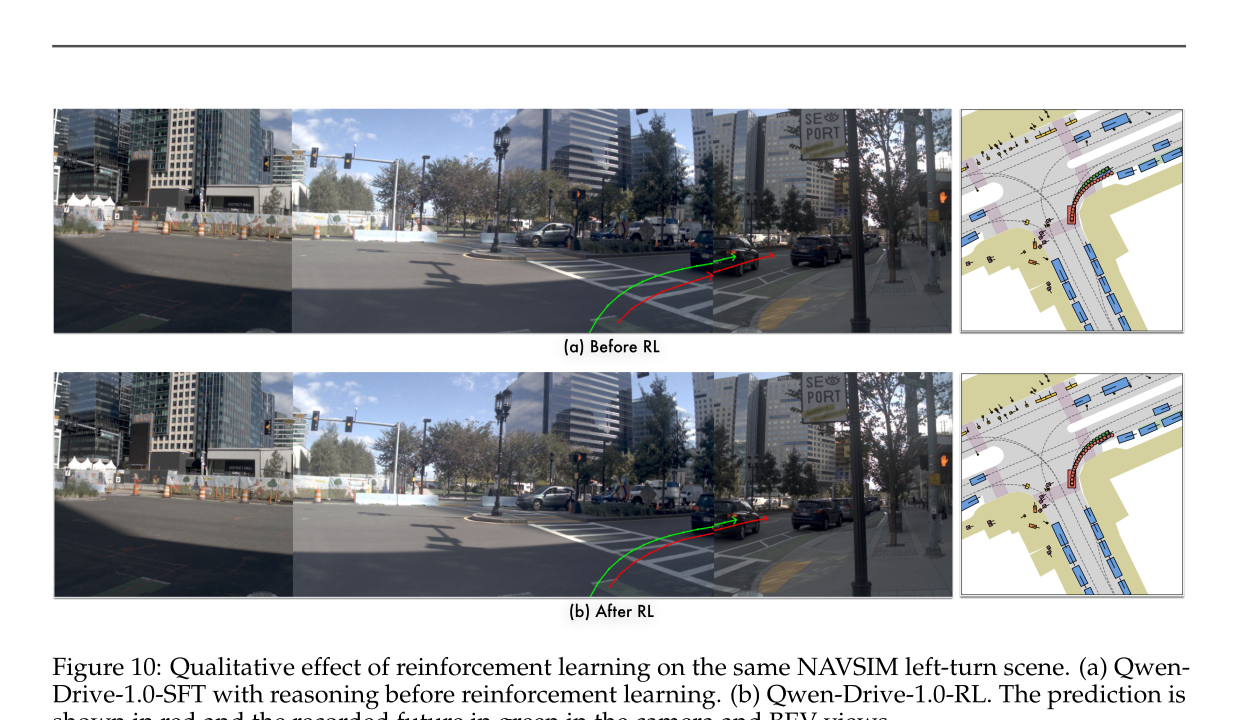
图 7 同一 NAVSIM 左转场景在强化学习前后的轨迹变化,红色为预测、绿色为记录未来
Quick Start:先把官方 Demo 真正跑起来
下面使用官方仓库当前版本的方式,不采用 Hugging Face 页面顶部自动生成的通用图片问答 pipeline 示例。那个示例可以展示标准 VLM 加载,但不能替代 Qwen-Drive 的场景结构、Planning Expert 和 BEV 感知流程。
1. 环境准备
官方建议使用 24 GB 以上显存的 NVIDIA GPU。基础要求为 Python 3.10 及以上;当前仓库依赖 PyTorch 2.8+、Transformers 5.14.x、FlashAttention 2.8+。
git clone https://github.com/QwenLM/Qwen-Drive-1.0.git qwen-drive
cd qwen-drive

conda create -n qwen-drive python=3.10 -y
conda activate qwen-drive

pip install -e . --no-build-isolation
然后下载完整目录。注意不要只下载根目录 VLM,规划与感知任务依赖对应子目录。
hf download Qwen/Qwen-Drive-1.0-4B \
  --local-dir Qwen-Drive-1.0-4B
目录应至少保持为:
Qwen-Drive-1.0-4B/
├── planner-sft/
├── planner-rl/
└── perception/
2. 一条命令运行规划 Demo
仓库已经附带四个 WOD-E2E 规划场景及图像,不需要先下载完整数据集。
export PYTHONPATH=src

python scripts/demo.py \
  --model Qwen-Drive-1.0-4B \
  --planner Qwen-Drive-1.0-4B/planner-rl \
  --scenes data/demo/planning_scenes.jsonl \
  --image-archive data/demo/frames.parquet \
  --plot demo.png
正常运行后,你应该看到三类结果:VQA 文本回答、规划理由、预测轨迹;同时当前目录会生成 demo.png。规划结果的形状为:
(6, 50, 3)
也就是一次采样 6 条轨迹,每条包含未来 50 个 (x, y, heading) 路点。
3. 单独跑 3D 感知 Demo
python scripts/run_perception.py \
  --vlm Qwen-Drive-1.0-4B \
  --model Qwen-Drive-1.0-4B/perception \
  --frames data/demo/perception \
  --output outputs/perception_demo

python scripts/visualize_perception.py \
  --frames data/demo/perception \
  --predictions outputs/perception_demo
输出目录会为每个样本保存包含 3D boxes、scores、labels、Occupancy 和地图栅格的 .npz 结果,随后可生成环视相机与 BEV 的汇总图。
最常见的三个问题
- 显存不足。 24 GB 是官方推荐下限,不代表任意输入配置都一定不会 OOM。先跑单场景、单样本,再增加
num_samples。 - FlashAttention 与 PyTorch/CUDA 不匹配。 仓库采用
--no-build-isolation,就是为了让扩展针对当前 PyTorch 环境编译;混用不同 CUDA 构建很容易在安装或加载时报错。 - 感知模式首次启动失败。 感知代码首次使用会编译两个 CUDA kernel,必须有与 PyTorch 构建匹配的
nvcc,并正确设置CUDA_HOME。只有显卡驱动、没有 CUDA Toolkit 时,规划可能能启动,感知扩展仍会编译失败。
接入自己的项目:真正难的是准备“场景”,不是调用 run()
如果只想做驾驶场景问答,可以直接传图片:
python scripts/run_vqa.py \
  --model Qwen-Drive-1.0-4B \
  --image front.jpg \
  --image front_left.jpg \
  --question "Is it safe to change into the left lane?"
但这个 VQA 接口只看到你传入的图片和问题,不会自动获得车辆历史状态或导航命令。
规划模式要求更完整的 DrivingScene:
- 前、左前、右前三个视角;
- 每个视角四个时间点,即 1.5 秒历史、2 Hz 取样,当前帧放最后;
- 16 个 10 Hz 历史位姿,以及对应速度和加速度;
- 当前自车速度、加速度;
- 驾驶命令和导航命令。
from qwen_drive import CameraFrame, DrivingScene

scene = DrivingScene(
    views={
        "<FRONT VIEW>": [CameraFrame(p) for p in front_paths],
        "<FRONT LEFT VIEW>": [CameraFrame(p) for p in left_paths],
        "<FRONT RIGHT VIEW>": [CameraFrame(p) for p in right_paths],
    },
    history=history_poses,               # [16, 3]
    history_velocity=history_velocity,   # [16, 2] m/s
    history_acceleration=history_accel,  # [16, 2] m/s²
    ego_velocity=(12.4, -0.2),
    ego_acceleration=(0.24, 0.33),
    driving_command=[0, 1, 0, 0],        # 左 / 直 / 右 / 未知
    nav_command=0,                       # 0 直行,1 左转,2 右转
)
批量评测则建议按官方 JSONL scene 格式组织数据。网络存储上的 12 张小图读取会成为瓶颈,官方提供 pack_images.py 将图片预打包成可 memory-map 的 Parquet:
python scripts/pack_images.py \
  --scenes my_scenes.jsonl \
  --image-root /data/my_drive \
  --output archives/my_drive

python scripts/run_planning.py \
  --model Qwen-Drive-1.0-4B \
  --planner Qwen-Drive-1.0-4B/planner-rl \
  --scenes my_scenes.jsonl \
  --image-archive archives/my_drive \
  --output outputs/my_drive/predictions.jsonl \
  --mode reasoning_planning \
  --num-samples 6
如果要接入 ROS 或实际车辆中间件,我建议不要直接让模型输出进入控制器,而是加一层明确的适配与安全边界:
相机同步 + 车辆状态
        ↓
DrivingScene 构造与坐标校验
        ↓
Qwen-Drive 轨迹候选
        ↓
可行驶区 / 碰撞 / 动力学约束检查
        ↓
轨迹选择与平滑
        ↓
传统控制器 MPC / Pure Pursuit
Qwen-Drive 输出的是轨迹候选,不是经过车辆动力学和功能安全验证的底层转向、油门与制动命令。
如果是我,我会怎么把它接进真实项目?
我会按五步走,而不是第一天就尝试“上车闭环”。
- 先跑官方四场景 Demo。 锁定仓库 commit、模型 revision、PyTorch 与 CUDA 版本,保存一份已验证环境。
- 用自己的三相机录制数据做离线规划。 先解决时间同步、坐标系、历史状态和导航命令格式,检查轨迹方向是否正确。
- 建立离线安全 Gate。 对每条轨迹做越界、碰撞、曲率、加速度和 jerk 检查,不合格时回退到传统规划器。
- 影子模式运行。 车辆仍由原系统控制,Qwen-Drive 只旁路预测;对比实际轨迹、原规划器与模型输出,积累失败案例。
- 再进入封闭场地低速测试。 即使指标满意,也应保留独立安全监控与紧急接管机制。
如果目标是端侧部署,还要先补官方没有给出的三项数据:端到端延迟、峰值显存和目标硬件吞吐。当前发布没有提供 Jetson、TensorRT、ONNX 或量化部署路径,也没有给出实车控制频率,所以不能仅凭“4B”就认定它适合 Orin 实时上车。
它适合什么,不适合什么?
适合
- 研究统一驾驶 VLM、显式 3D 表征与轨迹生成;
- 在公开数据集上复现 VQA、感知与规划评测;
- 用统一接口比较直接规划与带推理规划;
- 研究多数据集轨迹统一、Flow Matching 规划和奖励优化;
- 作为离线规划候选器或影子模式原型。
暂时不适合
- 下载后直接接管真实车辆;
- 把它当成已经验证过的实时端到端驾驶系统;
- 在 24 GB 以下设备上默认无优化运行完整规划栈;
- 任意更换相机环视配置后仍期待原始 3D 精度;
- 仅凭公开仓库完整复现四阶段训练,因为当前没有放出训练代码和训练数据构建全流程;
- 把生成的文字理由当成可靠、可审计的因果解释。
论文自己承认的边界,恰好也是落地最该关注的边界
作者在 Limitations 中明确指出两点。
第一,规划理由并不总能准确抓住场景的因果结构,特别是当不同时间尺度的原因同时出现时。例如远处红灯要求提前平缓减速,近处突然出现儿童则要求立刻反应,模型可能无法稳定判断当前 1~2 秒最应该服从哪个原因。
第二,生成轨迹并不总是严格遵守文字理由。带推理的规划表现更好,可能部分来自额外文本为模型提供了内部条件,而不代表理由与动作之间已经建立了可靠因果一致性。
此外,感知、问答和规划当前使用不同图像分辨率、时间上下文和输入格式。它们共享模型,不等于已经形成完全互相促进的统一闭环。
这也是我认为 Qwen-Drive 1.0 最准确的定位:它是一个非常有价值的“初始步骤”,证明了显式 3D 感知、开放式驾驶理解和 Flow Matching 轨迹规划可以接到同一个预训练 VLM 上,并且在多个评测口径下获得有竞争力的结果;但它还不是一套开箱即用的量产自动驾驶方案。
最后:它真正值得关注的不是“又一个驾驶大模型”
Qwen-Drive 1.0 最有意思的地方,是它没有让语言解释替代几何世界,也没有为了 3D 感知和规划彻底重做一个封闭架构。
它选择让通用 VLM 继续负责“看与理解”,再通过 BEV 感知头把空间结构显式化,通过 Planning Expert 把理解转成未来轨迹。这样一来,同一套模型既保留了开放式问答能力,又能输出传统自动驾驶系统更容易检查和接入的几何结果。
从论文角度,它提出了一条统一驾驶基础模型的清晰路线;从工程角度,它已经足够让研究者跑通 Demo、准备自己的场景数据、复现公开评测,并开始搭建离线原型。
至于能不能真正上车,答案不在 90.7 PDMS 或“4B”这两个数字里,而在后续是否补齐实时性、相机迁移、因果一致性、安全约束和真实车辆闭环验证。