
APXinf-robo:把 VLA 推理搬到 Jetson,先跑通构建、测速与机器人接口
机器人项目常有一个断点:在工作站上得到的策略模型,到了 Jetson 上要处理模型加载、图像预处理、量化、推理、动作反归一化和服务通信。APXinf-robo 把这些环节分成两层:Git 子模块 apxinf/ 是推理引擎,这个仓库负责把引擎接到机器人预设、仿真评测和 OpenPI 兼容的 WebSocket 接口。它首先适合做 PI0.5 的端侧推理验证,然后再考虑把自己的机器人观测与动作协议接进来。仓库 README 也列有 PI0-FAST、GR00T N1.7 和 Qwen-Drive 的专项性能结果;它们不能直接套用本文的 PI0.5 命令。
一分钟判断:它解决什么问题
| 关心点 | 当前仓库给出的能力 | 使用前需要确认 |
|---|---|---|
| 运行设备 | Linux + NVIDIA CUDA;README 给出 Jetson AGX Thor、Jetson AGX Orin 与 RTX 4090 测量 | 编译会按可见 GPU 的架构生成内核,优先在目标设备上编译;不能把 AGX 数据推给 Orin NX |
| 精度 | BF16;FP8 限 Thor 且需激活校准;INT8 W8A8 对 Orin/Ada 有优化 | 先用 BF16 跑通,再以同一模型和同一任务验量化精度 |
| 接口 | Python 的 build_robot_policy、load_policy,以及 OpenPI 兼容 WebSocket 服务 |
摄像头顺序、状态编码、动作维度必须与 checkpoint 和机器人预设一致 |
| 模型文件 | 不随包分发 checkpoint | 需要 model.safetensors、config.json、tokenizer 与 normalizer 等资产 |
| 开源许可 | 仓库根目录为 Apache-2.0 | 部署时还应单独核对模型权重与子模块依赖的许可 |
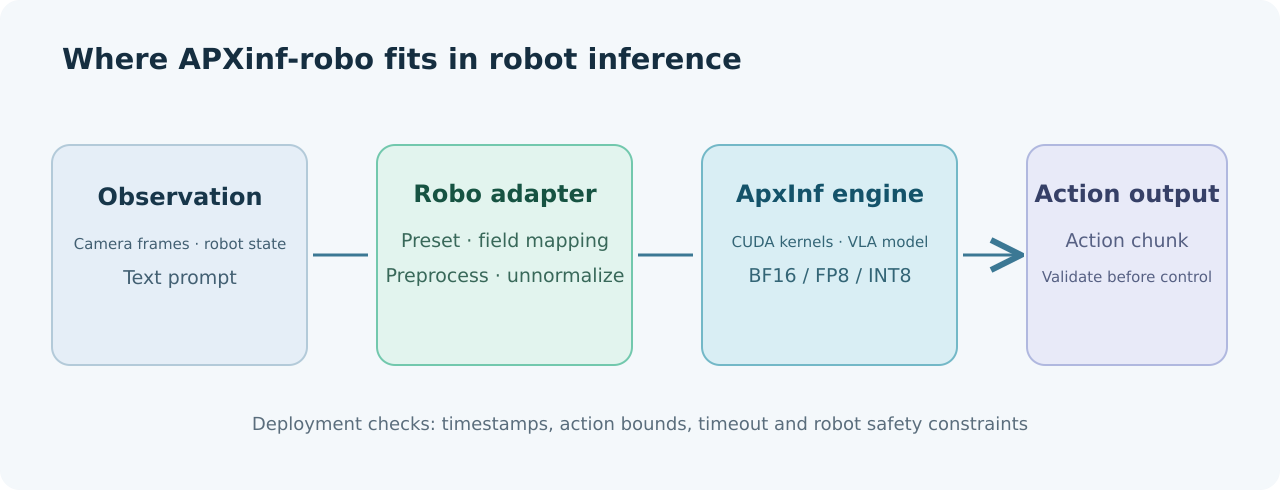
图1|原创理解图。 图中把摄像头、状态、文本输入到机器人动作的路径拆开;真实控制器仍需自行做动作边界、时序和安全处理。输入/输出接口依据仓库 README整理。
这里最值得理解的设计是“机器人预设”。同一组模型权重并不会告诉服务端客户端把相机帧放在 observation/image,还是嵌套在 images/cam_high,也不会自动定义动作截断与关节符号。franka_libero 等预设把这些约定收拢到一个可检查的配置。摄像头键顺序错了,张量形状仍可能正确,却把不同视角送入错误的模型槽位。官方的 Adding an Embodiment 指南对此有明确说明。
Quick Start:先验证编译与推理链路
这一段不下载权重、不接机器人。目标是在目标 Linux/NVIDIA 设备上得到两次成功导入和一条 BF16 随机权重延迟输出。安装前准备 NVIDIA 驱动、CUDA Toolkit(nvcc 可用)、Rust/Cargo、CMake、Python 虚拟环境与编译工具。具体 CUDA、驱动和 Rust 版本应以目标设备的软件栈及构建反馈为准;README 没有给出一个适用于所有设备的统一版本号。
nvcc --version
cargo --version
cmake --version

git clone --recursive https://github.com/RLinf/APXinf-robo.git
cd APXinf-robo
git rev-parse HEAD
git -C apxinf rev-parse HEAD
python3 -m venv .venv
source .venv/bin/activate
pip install maturin
CARGO_TARGET_DIR=target/wheel maturin build --release --features cuda --auditwheel skip -m apxinf/crates/apxinf-py/Cargo.toml
pip install --force-reinstall target/wheel/wheels/apxinf_py-*.whl
pip install -e "./apxinf/python/apxinf[serving]" --config-settings editable_mode=strict
pip install -e ".[libero,serve]"
上面保留官方完整安装命令,安装 Robo 的 libero 与 serve 可选依赖;LIBERO 仿真器本体仍需另装。只做进程内推理时,官方说明可省略引擎的 serving extra;实际依赖组合要随所选功能调整。构建绑定时 --features cuda 不能漏。构建说明
接下来执行官方的最小检查:
python -c 'import apxinf_py; print(apxinf_py.__version__)'
python -c 'import apxinf_robo; print(apxinf_robo.__version__)'
python scripts/bench_pi05.py --random-weights --precision bf16 --layer l1 --samples 5
成功判据:两个 import 都输出版本且不报错;第三条命令完成 GPU 推理并打印延迟统计。这里的 --random-weights 只测运行时和算子路径,不能说明动作质量,更不能据此声称 LIBERO 成功率。l1 测已调整尺寸的 RGB 进入模型到输出的模型层时间,未包含机器人端全链路。官方更完整的随机输入测量还指定两视角、10 个文本 token、动作长度 10、10 个 flow steps、10 次预热与 100 次采样:
python scripts/bench_pi05.py --random-weights --precision bf16 --layer l1 \
  --views 2 --token-count 10 --action-horizon 10 --num-flow-steps 10 \
  --warmup 10 --samples 100 --autotune
在 Orin 上从 BF16 开始;README 明确指出 Orin 不支持该项目的 FP8 路径。编译通常读取当前可见 GPU 的 compute capability。如果在另一台机器代编译,要按官方说明设置目标架构:sm_87 对应 Orin,Thor-U 为 sm_101,Thor 为 sm_110;构建成功后仍应在目标设备运行上述检查。精度与架构说明
第二步:拿真实权重验证策略输出
完成随机权重测试后,准备 PI0.5 的 LIBERO checkpoint。仓库给出 lerobot/pi05_libero_base 的下载方式,并特别指出其归一化统计需另取 OpenPI 的 norm_stats.json。下面将模型目录明确设为本地路径;下载来源与命令见官方 LIBERO evaluation:
export APXINF_MODEL_DIR="$PWD/models/pi05_libero_base"
mkdir -p "$APXINF_MODEL_DIR"
pip install -U huggingface_hub
hf download lerobot/pi05_libero_base --local-dir "$APXINF_MODEL_DIR"
curl -fL https://storage.googleapis.com/openpi-assets/checkpoints/pi05_libero/assets/physical-intelligence/libero/norm_stats.json \
  -o "$APXINF_MODEL_DIR/norm_stats.json"
test -s "$APXINF_MODEL_DIR/model.safetensors"
test -s "$APXINF_MODEL_DIR/config.json"
test -s "$APXINF_MODEL_DIR/norm_stats.json"
如果模型仓库文件名或资产布局在未来版本改变,请以下载后的实际文件与当前 README 核对。有文件也不等于兼容:模型类型、tokenizer、相机数量、状态维度与归一化统计都要匹配。
以下是按官方 Python API 补全的本地“接口冒烟测试”。全零图像只是检查输入字典、推理调用和输出形状,不能用于评价机器人动作:
cat > smoke_policy.py <<'PY'
import os
import numpy as np
from apxinf_robo import build_robot_policy

policy = build_robot_policy(
    "franka_libero", os.environ["APXINF_MODEL_DIR"], precision="bf16"
)
try:
    observation = {
        key: np.zeros((256, 256, 3), np.uint8)
        for key in policy.metadata["image_keys"]
    }
    observation[policy.metadata["prompt_key"]] = "put both moka pots on the stove"
    if state_key := policy.metadata.get("state_key"):
        observation[state_key] = np.zeros(policy.metadata["state_dim"], np.float32)
    result = policy.infer(observation)
    print("actions.shape:", result["actions"].shape)
    print("timing:", result["timing"])
finally:
    policy.close()
PY
python smoke_policy.py
预期能看到 actions.shape 为 (H, policy.action_dim) 对应的二维动作块,timing 中有模型及总耗时;真实值由 checkpoint 与设备决定。build_robot_policy 接受原始相机帧,内部完成缩放、tokenization、归一化和 flow sampler;返回的 actions 已经反归一化。上面的“全零状态”仍可能不符合某个具体 checkpoint 的语义约定,报错时先核对其训练配置。Python API 示例
第三步:接入仿真或现有机器人客户端
路径 A:用 LIBERO 做任务验证。 官方的完整复现是 LIBERO-10 的 10 个任务 × 每任务 50 次,共 500 episodes,默认 seed 7。先安装兼容的 LIBERO/MuJoCo 环境,检查 python -c 'from libero.libero import benchmark' 成功,再从一个任务的一次试跑开始:
mkdir -p devlocal/libero-smoke
apxinf-robo eval-libero --backend in-process \
  --model-dir "$APXINF_MODEL_DIR" \
  --norm-stats "$APXINF_MODEL_DIR/norm_stats.json" \
  --precision bf16 --action-horizon 10 \
  --suite libero_10 --tasks 0 --trials-per-task 1 \
  --results-jsonl devlocal/libero-smoke/results.jsonl \
  --summary-json devlocal/libero-smoke/summary.json
这个 smoke run 的成功判据是 episode 完成,JSONL 和 summary 文件生成;一次试跑的成败没有统计意义。完成环境检查后,去掉 --tasks 0,改 --tasks all --trials-per-task 50 才与官方公布的任务设置一致。官方提醒 LIBERO 的依赖锁定 NumPy 1.22.4,与 Python 3.12 不兼容;建议将仿真环境与推理环境分别管理,尤其是在 Jetson 侧提供服务、工作站侧跑模拟器时。官方评测指南
路径 B:接已有 OpenPI 客户端。 在端侧启动服务,客户端保持原有观察字典的形状和字段,替换服务地址:
apxinf-robo serve --robot franka_libero \
  --model-dir "$APXINF_MODEL_DIR" \
  --norm-stats "$APXINF_MODEL_DIR/norm_stats.json" \
  --precision bf16 --host 0.0.0.0 --port 8000
from openpi_client import websocket_client_policy

client = websocket_client_policy.WebsocketClientPolicy("<Jetson-IP>", 8000)
result = client.infer(observation)  # observation 与所选机器人预设一致
actions = result["actions"]
这里的 observation 应由真实相机和机器人状态生成,示例中的变量不是现成数据。生产系统应在控制器前检查帧时间戳、相机键与顺序、状态维度、动作单位/范围、最大位移和超时退避,再在仿真与低速受控环境验证;不要直接把测试代码的动作块下发给执行器。如果部署 G1 或自定义机体,先确定训练时的相机槽位、状态编码、动作宽度及 delta/absolute 语义,再选择或添加机器人预设。官方接入指南
官方数字应该怎么读
README 的 PI0.5 基准固定为双视角、224×224 NHWC uint8、10 个 flow steps、H=10、batch 1;给出的延迟是稳态 CUDA Graph replay P50。以下只摘同一表中的代表行:Performance 表。
| 设备与精度 | 模型层延迟 | 换算吞吐 | LIBERO-10 成功率 |
|---|---|---|---|
| Jetson AGX Thor / BF16 | 72.45 ms | 13.8 Hz | 464/500,92.8% |
| Jetson AGX Thor / FP8 | 41.16 ms | 24.3 Hz | 461/500,92.2% |
| Jetson AGX Orin / BF16 | 165.67 ms | 6.0 Hz | 460/500,92.0% |
| RTX 4090 / BF16 | 31.38 ms | 31.9 Hz | README 未列同表准确率 |
速度与成功率是不同测量:前者不等于相机采集、网络传输、机器人控制在内的闭环频率;后者依赖 pi05_libero_base 及上述评测协议。README 另列集成 STEP 后的“一步动作生成裁剪”结果,例如 Thor FP8 26.32 ms、Orin BF16 119.05 ms;那是改变生成设置后的另一组实验,不可与常规 10 步延迟混成同一个默认性能。FP8 的校准数据也应来自部署分布。STEP 对应表
常见坑与适用边界
git clone忘了--recursive:apxinf/是子模块,构建路径里的 Rust crate 和 Python 包都在那里。旧 checkout 可执行git submodule update --init --recursive。- 有 CUDA runtime,却没有
nvcc:项目要本机编译 CUDA 绑定;先让nvcc --version、cargo --version、cmake --version都可用。 - 拿随机权重测速当任务评估:它只回答“算子链路是否能跑、延迟大概多少”。任务成功要拿正确 checkpoint、norm stats 和 LIBERO rollout 测。
- 把 Thor FP8 命令照搬到 Orin:官方明确限制;Orin 先跑 BF16,INT8 则单独复核动作质量。
- 相机键、顺序或状态语义不一致:同形状不会自动保证同语义。比对训练配置、
policy.metadata与机器人预设;需要时使用官方的scripts/from_openpi.py对照 checkpoint metadata。 - 精度、输入形状和测量层不同仍横向比较:
l1是模型、l2加通用预后处理、l3包含服务往返;一律注明层级和输入条件。Benchmark 说明
适合:手上有兼容的 VLA checkpoint,正在把 PI0.5 等模型移到 Jetson AGX 或 NVIDIA 工作站;已有 OpenPI 客户端,需要换端侧推理服务;愿意按机器人协议认真核验摄像头、状态与动作的团队。暂不适合:希望仅靠 pip install 在无 NVIDIA/CUDA 的设备运行;没有相应 checkpoint,却想直接得到可靠真机动作;需要根据 AGX Thor 表格推断自己 Orin NX 的频率。项目是很有价值的推理与接入起点,真机安全和任务性能仍要在目标机体上逐项验收。
如果由我落地,会按“目标设备编译 → 随机权重检查 → 真实 checkpoint 的 Python 冒烟测试 → LIBERO 单任务 → 500 次评估 → WebSocket 接原客户端 → 仿真动作边界验证 → 低速真机”推进。每阶段记录代码与子模块 commit、权重来源、设备型号、精度、测量层、任务成功率和失败样例。这样遇到“变快了却抓不准”时,能分清是算子、量化、观察协议,还是控制时序出了问题。
官方资料:APXinf-robo README · Adding an Embodiment · PI0-FAST 专项说明。本文命令是对官方文档的整理;未宣称本地跑出的性能数据。