
强化学习在目标跟踪中的应用
强化学习在目标跟踪中的应用
强化学习讨论的问题是智能体(agent) 如何在一个复杂不确定的环境(environment) 里去最大化它能获得的奖励。今天介绍三篇关于强化学习在目标跟踪中的工作,分别利用强化学习来决策使用的特征,多个跟踪器的切换以及是否更新模板。
论文列表:
Learning Policies for Adaptive Tracking with Deep Feature Cascades
Online Decision Based Visual Tracking via Reinforcement Learning
Fast Template Matching and Update for Video Object Tracking and Segmentation
强化学习包含环境, 动作和奖励三部分, 其本质是 agent 通过与环境的交互, 使得其作出的 action 所得到的总奖励达到最大, 或者说是期望最大。

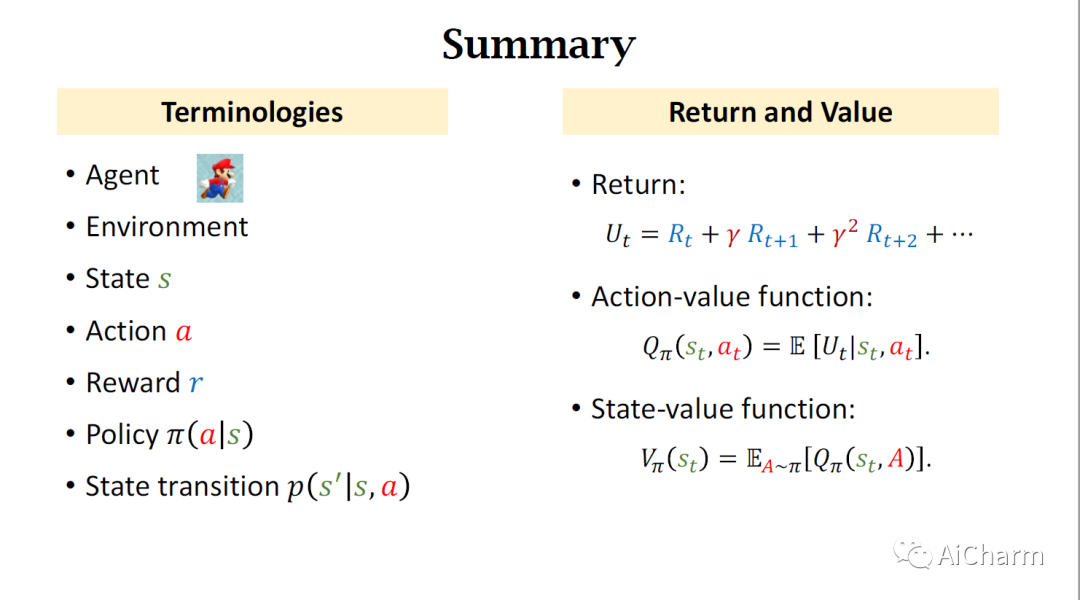
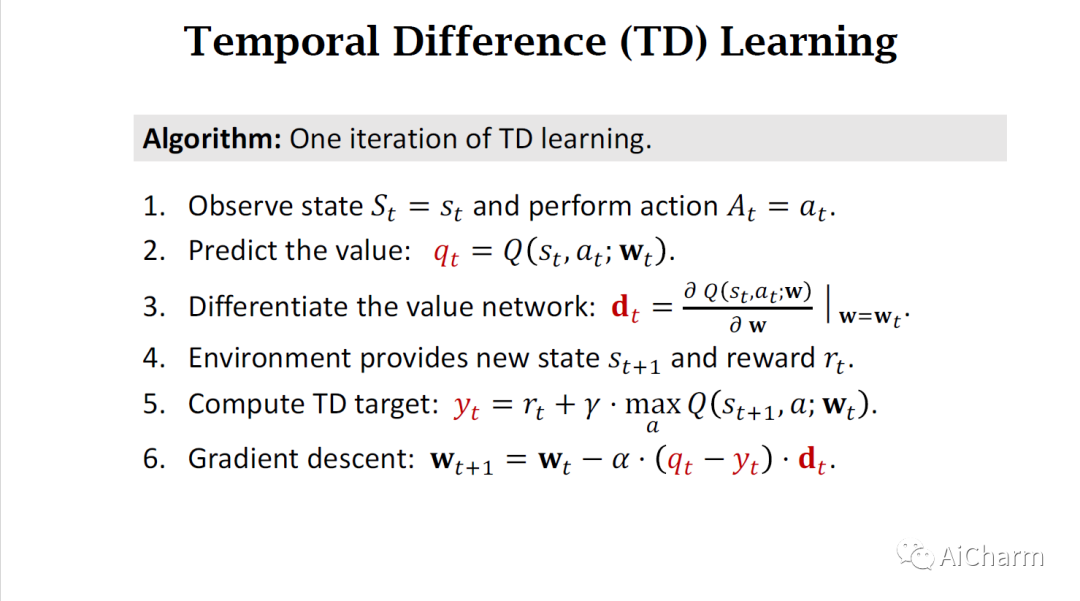
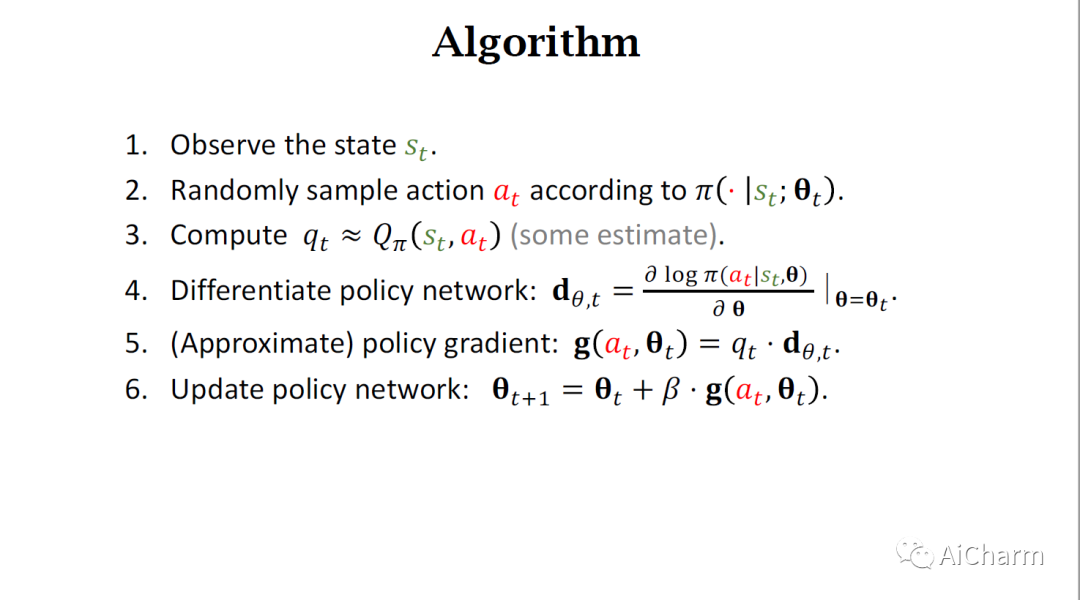
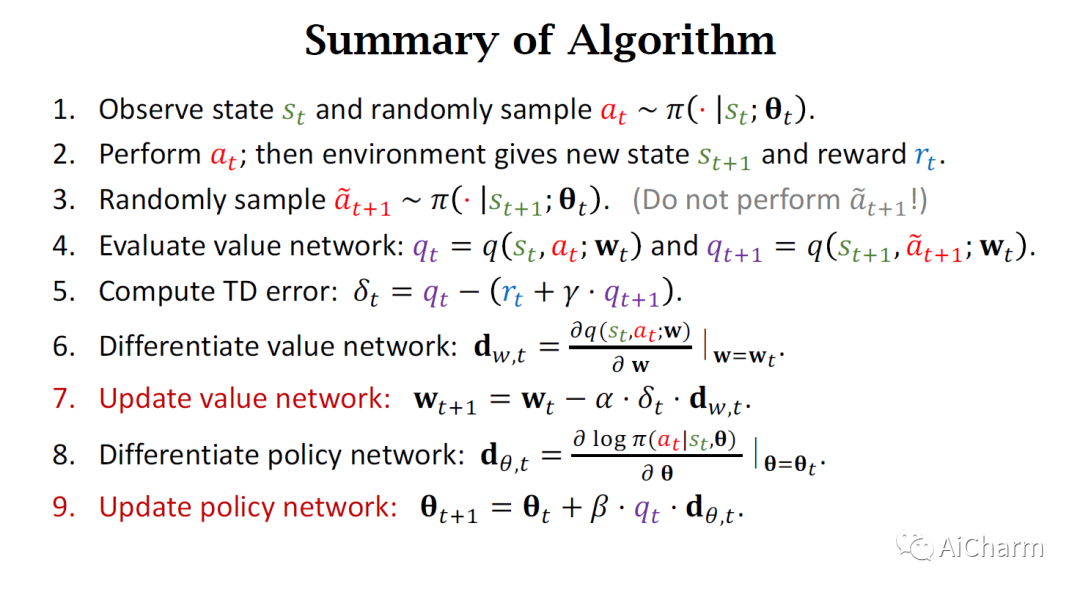
强化学习方法主要可以分为 Value-Based,Policy-Based 以及二者结合的 Actor-Critic 方法。Value-Based 方法通过 Temporal Difference (TD) Learning 学习动作价值函数;Policy-Based 方法通过 Policy Gradient 学习策略函数;而 Actor-Critic 方法将二者结合,actor 学习一个策略来得到尽量高的回报,critic 对当前策略的值函数进行估计,即评估 actor 的好坏。
关于强化学习的更多细节可以参考王树森老师的视频课程【王树森】深度强化学习(DRL) ( https://www.bilibili.com/video/BV12o4y197US )
1
Learning-Policies-for-Adaptive-Tracking-with-Deep-Feature-Cascades
1.1
Motivation
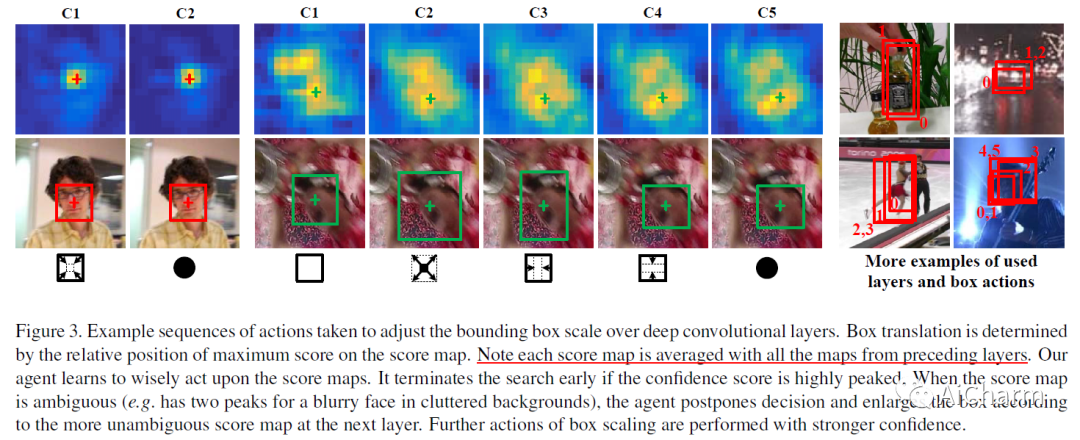
第一篇来自 ICCV2017,出发点是不同复杂程度的跟踪场景对特征的需求是不同的,对于简单场景使用浅层特征(甚至像素特征)就能处理,而对于一些复杂场景才需要具有更强语义信息的深度特征。这个自适应决策的问题可以通过基于 Q-learning 的强化学习完成,如图 1 所示,学习一个 agent 来判断当前特征是否已经可以以较高的置信度定位目标,还是需要继续计算更深层的特征来寻找目标。
这样对简单目标提前终止的策略可以大幅提升推理速度,相比 baseline 平均速度提升了大约 10 倍,GPU 速度 158.9FPS,并且在 cpu 上也能以 23.2FPS 的速度接近实时运行。

1.2
Method
首先定义一些公式符号,孪生网络每一层的互相关层定义:
其中 表示第 层的特征, 表示第 层的互相关结果。
整体框架如图 2 所示,在每一层互相关结果后面接一个 Q-Net,用于判断是否在该层停止,或者调整预测框的形状并继续使用下一层特征。
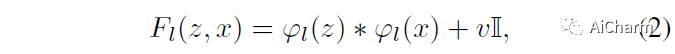

agent 采用强化学习的方式训练,基本元素包括状态(state S) ,动作(action A)和奖励(reward R)。在每一个 step 即第 l 层中,agent 根据当前状态 采取动作来决定是否调整预测框或者在该层停止并输出结果,动作的目的是减少预测的框的不确定性。训练时根据预测框与 GT 的 IOU 给出相应的奖励(有正有负),通过最大化期望奖励,agent 能学到最好的决策来采取行动,在精度和效率上取得平衡。
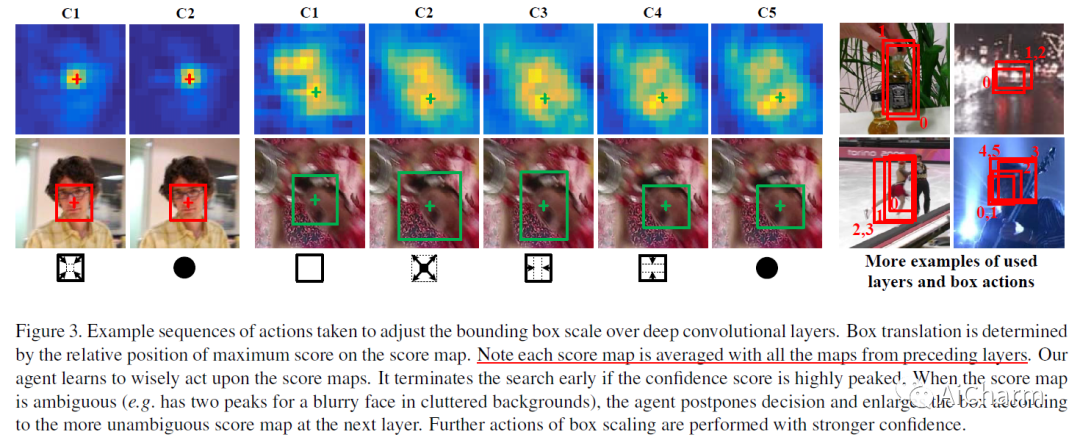
Actions: 包括 7 个各向异性的的尺度变换和一个 stop 动作。7 个尺度变换里包括 2 个全局的缩放和 4 个局部缩放,缩放比例为 0.2。还有一个不缩放(no scaling)的动作,这一操作用于在当前响应图不明确或无法做出决策时推迟决策。
States: 状态是一个包含响应图F’_l和历史动作的二元组 (F’_l,h_l)。F’_l使用的是当前层和之前所有层响应图的平均,相当于结合了浅层的细节和深层的语义。包含历史 4 个动作的向量,每个动作是 8 维的 one-hot 的向量,所以总共是 32 维。
Rewards: 奖励函数反应了采取动作后,从状态到状态的定位精度提升(或下降),精度采用 IOU 衡量,奖励函数计算如下:
当动作不为 stop 时,若该动作能使 IOU 增大,则奖励+1,否则惩罚-1。若采取任何尺度变换都不能进一步提升 IOU 或者已经到达最后一层了,则采取 stop 动作,此时以 IOU 阈值 0.6 来决定奖惩。
Deep Q-learning:本文使用 value-based 的 DQN 来选择动作,该方法需要学习一个动作-价值函数, 选择能够使得 Q 最大的动作 A。Q 函数用网络模拟,如图 2 虚线框所示,包含两个 128 维的 FC 层,输出对应 8 维动作的回报。训练时采用 TD learning 进行迭代。
其中 R 表示当前奖励,Q(S‘,A’)表示未来总的回报,是折扣因子。
测试阶段无需奖励,只根据 Q 函数调整预测框直到输出 stop 动作。作者在 OTB50 上验证平均只需要 2.1 步输出结果,即只需要两层网络,因此可以大幅提速。
此外,这套策略还可以集成一些简单的特征,比如像素特征和 hog 特征,计算更快。
图 3 展示了一些 early stop 的例子,如跟踪清晰的人脸时只需 C1-C2 的特征,但跟踪一个模糊的人脸则需要更深层的 C5 特征。
2
Online Decision Based Visual Tracking via Reinforcement Learning
2.1
Motivation
第二篇来自 NIPS2020。目前主流的跟踪方法有基于检测的和基于模板匹配的,二者各有优劣。基于检测的方法容易受遮挡等影响错误更新网络,但是能适应形变;而基于模板匹配的方法只利用第一帧模板,与上述情况刚好相反。很自然会想到将二者结合,但这是两套完全不同的跟踪原理,直接融合并不能同时收敛到各自的最优解。因此本文提出了一个基于分层强化学习(HRL)的在线决策机制。决策机制实现了一种智能切换策略,其中检测器和模板跟踪器必须相互竞争,以便在它们擅长的不同场景中进行跟踪。
2.2
Method
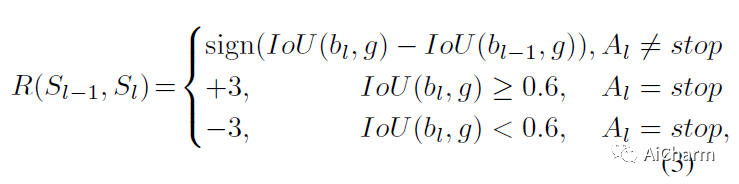
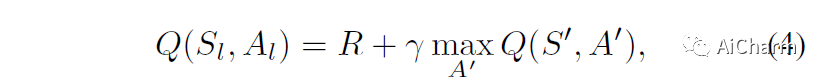
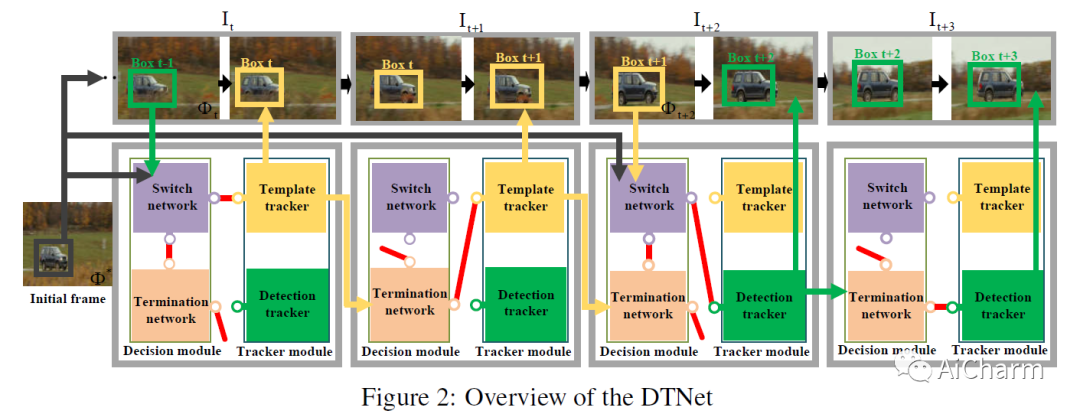
整体框架如图 2 所示,包括决策模块和跟踪模块。决策模块是一个 Actor-Critic(or Option-Critic?)结构,包括 switch network 和 termination network。首先将初始帧模板和上一帧跟踪结果送入 switch network,输出一个二元信号选择跟踪器。跟踪器结果送入 termination network,输出终止当前跟踪器的概率。注意这里终止之后并不一定切换到另一个跟踪器,因为并不能保证另一个就更好,而是要经过 switch network 重新选择。
Decision Module
给定一组状态和动作,马尔可夫选项 包括三部分:intra-option policy , termination condition , initiation set 。当 option 选定后,根据选择相应的动作,直到终止函数 判断终止。
这是一个标准的 Option-Critic 结构,一大堆公式就省略了。但是最后作者却用 Actor-Critic 去解释图 2,即 switch network 是 option-value 函数,作为 Critic 来评价 option,并且为 termination network 提供更新梯度(参考上面 Actor-Critic 的 ppt)。termination network 作为 Actor 评估正在使用的跟踪器性能,以决定它是否应该在当前帧终止。
switch network 的奖励函数定义如下:
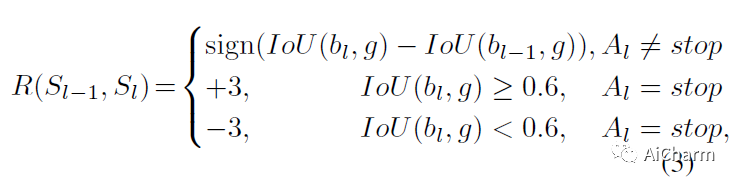

其中表示被选中的跟踪器的跟踪框与 GT 的 IOU,表示未被选中的跟踪器的跟踪框与 GT 的 IOU,表示两者的差。按照公式 7 总共有 3 种情况:一个成功一个失败,两个均成功,两个均失败。
训练按照 Actor-Critic 训练,Critic 使用贝尔曼方程(TD learning)更新,Actor 使用策略梯度更新。
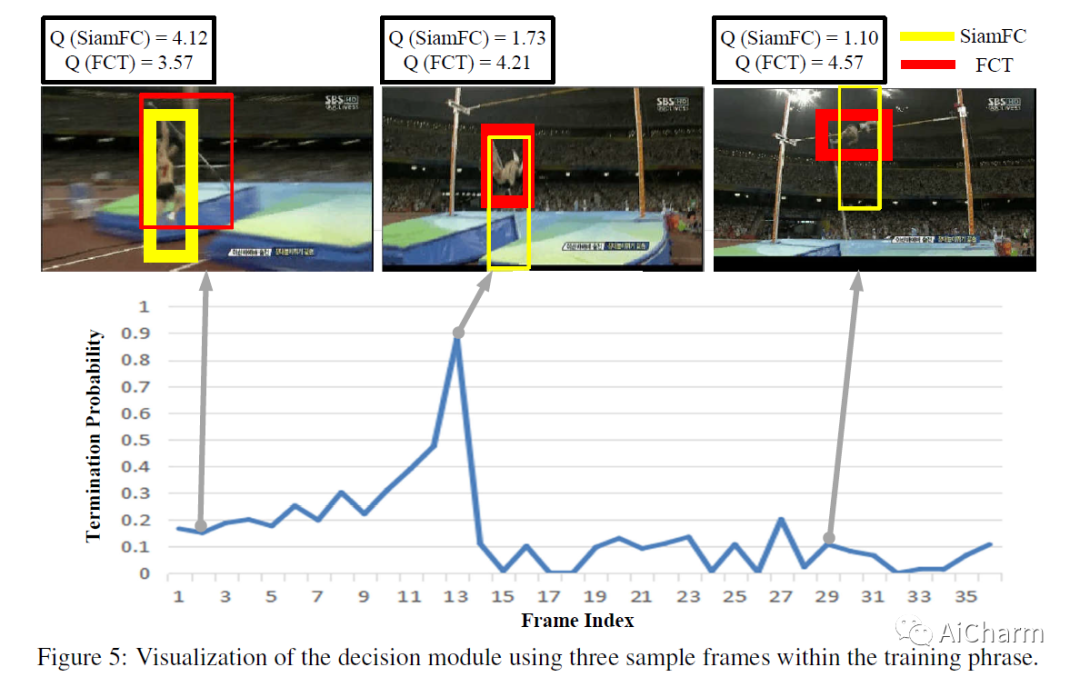
图 5 是一个可视化结果,其中终止概率 1 表示终止,0 表示保持不变。可以看到初始是 SiamFC(黄框)表现较好;当发生形变后,FCT 的价值函数更大,终止概率趋近 1,跟踪器切换;之后一直都是 FCT 表现更好,因此终止概率始终在 0 附近。
3
Fast Template Matching and Update for Video Object Tracking and Segmentation
3.1
Motivation
第三篇来自 CVPR2020。本文针对的任务是多实例半监督视频目标分割(VOS)。基于检测的算法被广泛应用于这一任务,难点在于选择匹配方法来预测结果,以及是否更新目标模板。本文利用强化学习来同时做出这两个决策。具体来说,agent 根据预测结果的质量来决定是否更新目标模板。匹配方法的选择则基于 agent 的动作历史来确定。
目前大部分 VOT 或 VOS 方法主要分为三步:
对当前帧进行实例分割,生成一系列候选 proposal;
将目标模板和所有 proposal 进行匹配,找到正确的 proposal 作为最终结果;
使用当前帧的预测结果替换目标模板。
针对步骤 2,基于外观的匹配方法(siamese)准确但非常耗时,而直接利用候选框与前一帧预测框的 IOU 进行快速匹配只适用于目标缓慢移动或变化。针对步骤 3,现有方法简单地直接用当前结果替换模板,不考虑结果的正确性,会导致误差逐渐累积。因此需要利用强化学习智能切换。
3.2
Method

将上一帧中所有目标框的最小外接矩形 bm 扩大一定倍率得到搜素区域 bs。
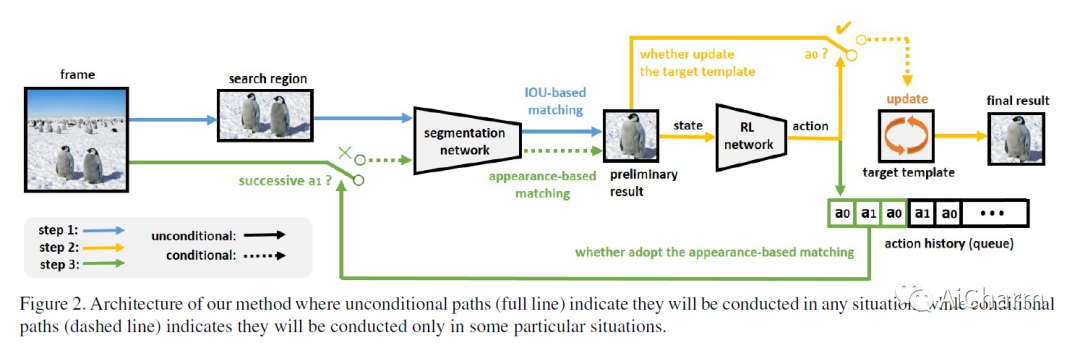
整体方法如图 2 所示,分为三个步骤:
按照图 3 的方式确定目标搜索区域,采用实例分割网络(如 YOLACT, Mask-RCNN)生成候选预测,然后利用基于 IOU 的匹配方法得到初步匹配结果;
通过 agent 判断初步结果的正确性和质量,决定是否更新模板;
确定是否需要切换到基于外观的匹配的方法。若连续 N 帧初步结果都不好(即第二步预测不更新模板),则切换到基于外观的匹配。此时会将整个图像送入网络。
下面介绍将 Actor-Critic 的框架嵌入上述模型
Action
首先定义相关的符号,如图 4 所示,目标模板包括边界框 ,mask ,中的图像内容T’_{box},中的图像内容T’_{mask}。而预测结果则是类似的P_{box}, P_{mask}, P’_{box}, P’_{mask}。
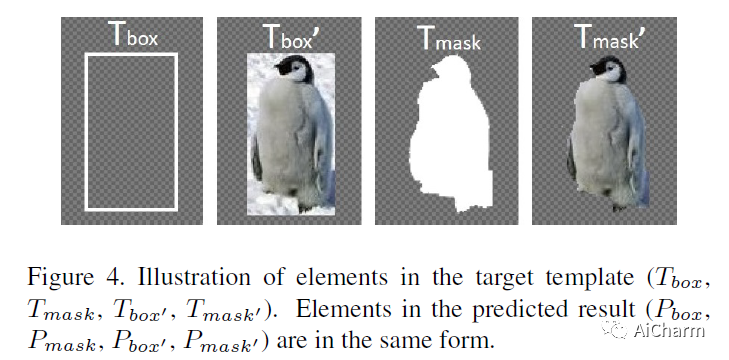
第一个决策是是否更新模板,agent 的动作 有两种情况,表示用当前结果更新模板,表示不更新。
第二个决策是匹配方法选择快速的基于 IOU 匹配还是精确的基于外观匹配,在精度和速度间取得平衡。前者分别计算模板和候选预测的 box IOU 和 mask IOU,选择 IOU 最大的作为匹配结果;后者则是计算模板图像块T’_{box}和候选预测图像块P’_{box}的相似性,选择最像的作为匹配结果。注意这里没有另外增加一个 agent,而是根据第一个 agent 的历史决策来决定。若 agent 连续 N 帧预测,表示目标很可能丢失,此时需要切换到基于外观的匹配方法。
State
输入 agent 的状态包括两部分,如下式。第一部分是模板图像,其中边框T’_{box}之内的内容保持不变,之外的内容填充黑色;第二部分是搜索图像,同样将 mask 之内的内容保持不变,之外的内容填充黑色。提取这两种图像的特征并相加得到输入状态。
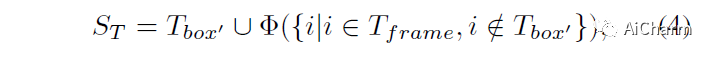
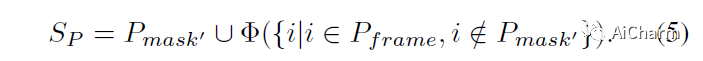
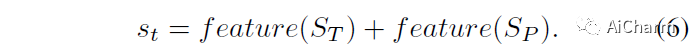
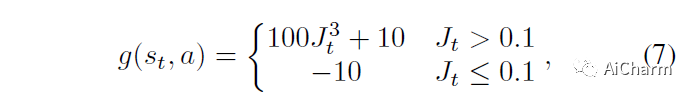
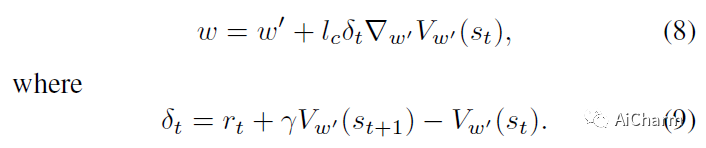
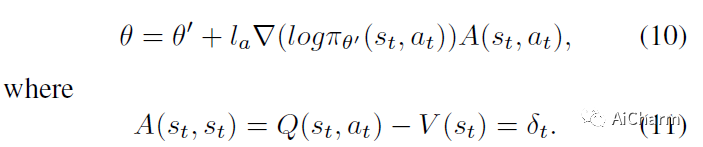
Reward
奖励函数定义:
表示和 GT mask 之间的 IOU。
**Actor-Critic Training
基本元素确定后,按照 Actor-Critic 框架训练。
critic 网络用 value-based 的方式训练:
表示 TD error,公式 8 中梯度下降用加号是因为公式 9 减法顺序和常规的是反过来的。
actor 用 policy-based 方法训练:
公式 11 减表示是带 baseline 的策略梯度。
图 1 和图 6 表面本文的方法在 VOT 和 VOS 任务上均能在速度和精度上取得一个较好的平衡。
4
小结
以上三种方法分别介绍了利用强化学习来决策使用的跟踪特征,多个跟踪器的切换以及是否更新模板。可以发现,应用的方向基本都是把跟踪方法中某些需要启发式设计的模块换成了强化学习进行智能决策。此外,第一篇和第三篇均提到了引入强化学习可以在一定程度上提速,对于某些简单的情况,agent 可以决策使用简单的方法进行跟踪。