
GigaBrain-0.7:37,000 小时数据 + 三系统架构,把世界模型真正接进 VLA 了吗?
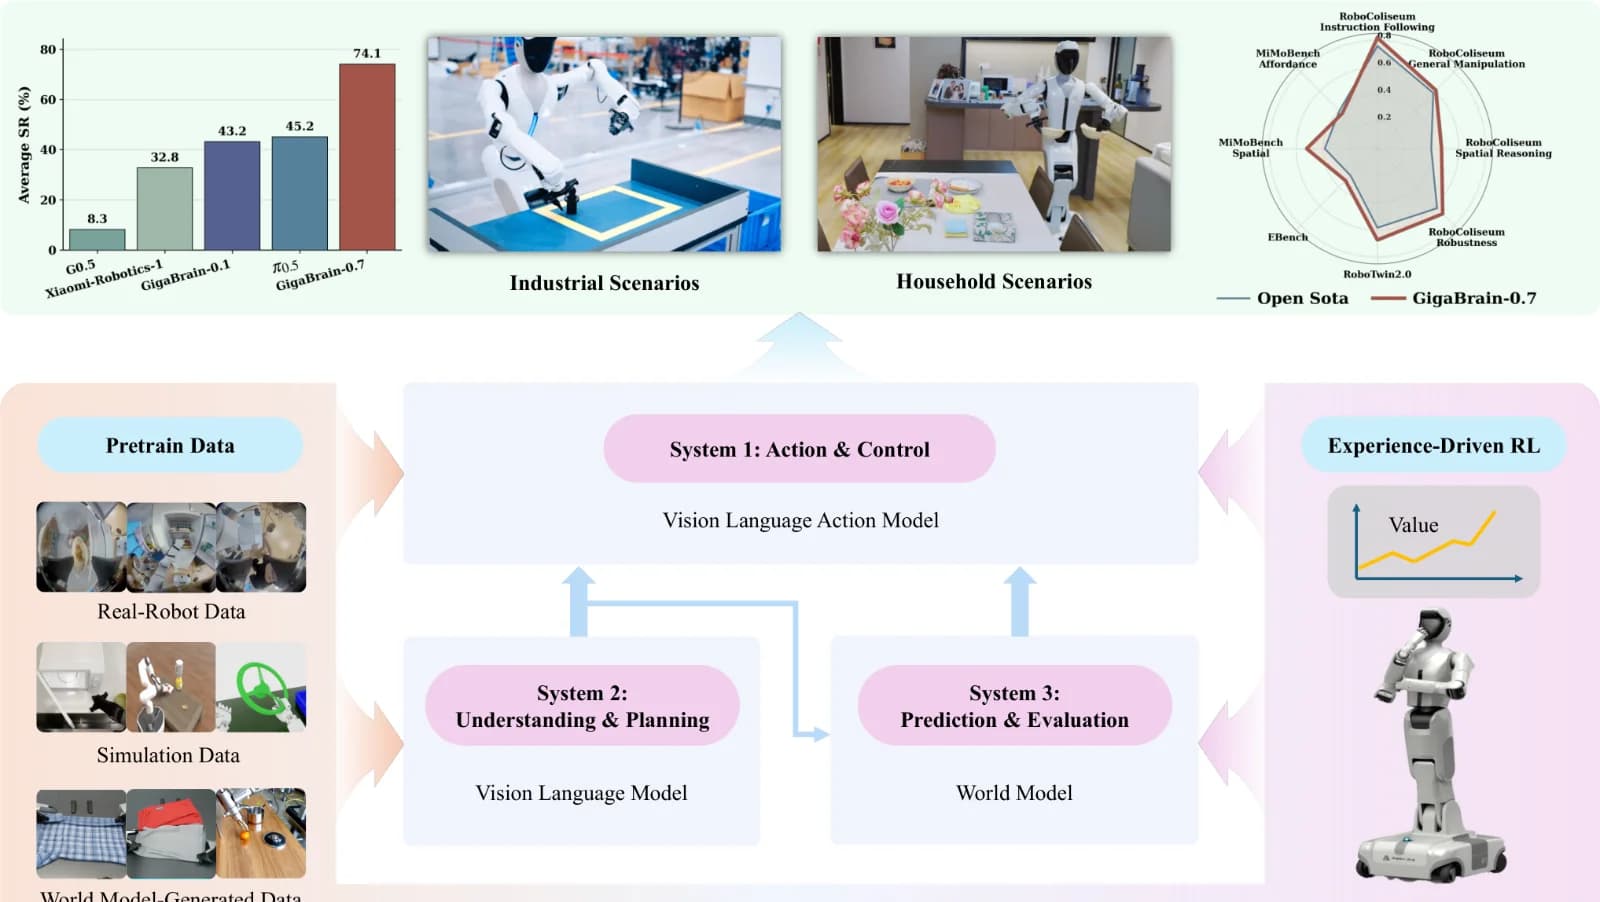
一句话看懂: GigaBrain-0.7 不再只把机器人看成“看图 → 直接出动作”的 VLA,而是把整套系统拆成三层:System-2 负责理解与规划,System-3 负责预测未来并判断任务进度,System-1 负责生成连续动作;再用 3.7 万小时异构具身数据和“监督学习 → 离线经验学习 → 在线强化”的闭环,把模型从会模仿推向会预判、会恢复。
WRC 2026 上,极佳视界把 GigaBrain-0.7 最吸睛的一幕做成了“超 20 分钟、10+ 个任务一镜到底”的长程真机演示。
但如果只记住这个 Demo,其实会错过这篇技术报告真正有意思的地方。
GigaBrain-0.7 想回答的是一个更大的问题:
具身基础模型到底能不能像大语言模型一样 Scale?如果能,应该 Scale 什么数据、什么架构,以及什么样的经验闭环?
论文给出的答案不是单纯“把 VLA 做大”,而是两座同时向上堆叠的金字塔:
- 数据金字塔:互联网视觉语言数据、EGO/UMI 真人数据、仿真和生成数据、真机数据;
- 算法金字塔:System-2 理解规划、System-1 动作生成、System-3 世界预测,再叠加 Experience Reinforcement。
这篇文章不照着发布稿逐条复述,而是从论文机制出发,拆开看它究竟做了什么、哪些结果真正有说服力,以及目前还有哪些关键问题没有回答。
1. 先看全局:GigaBrain-0.7 到底是什么?
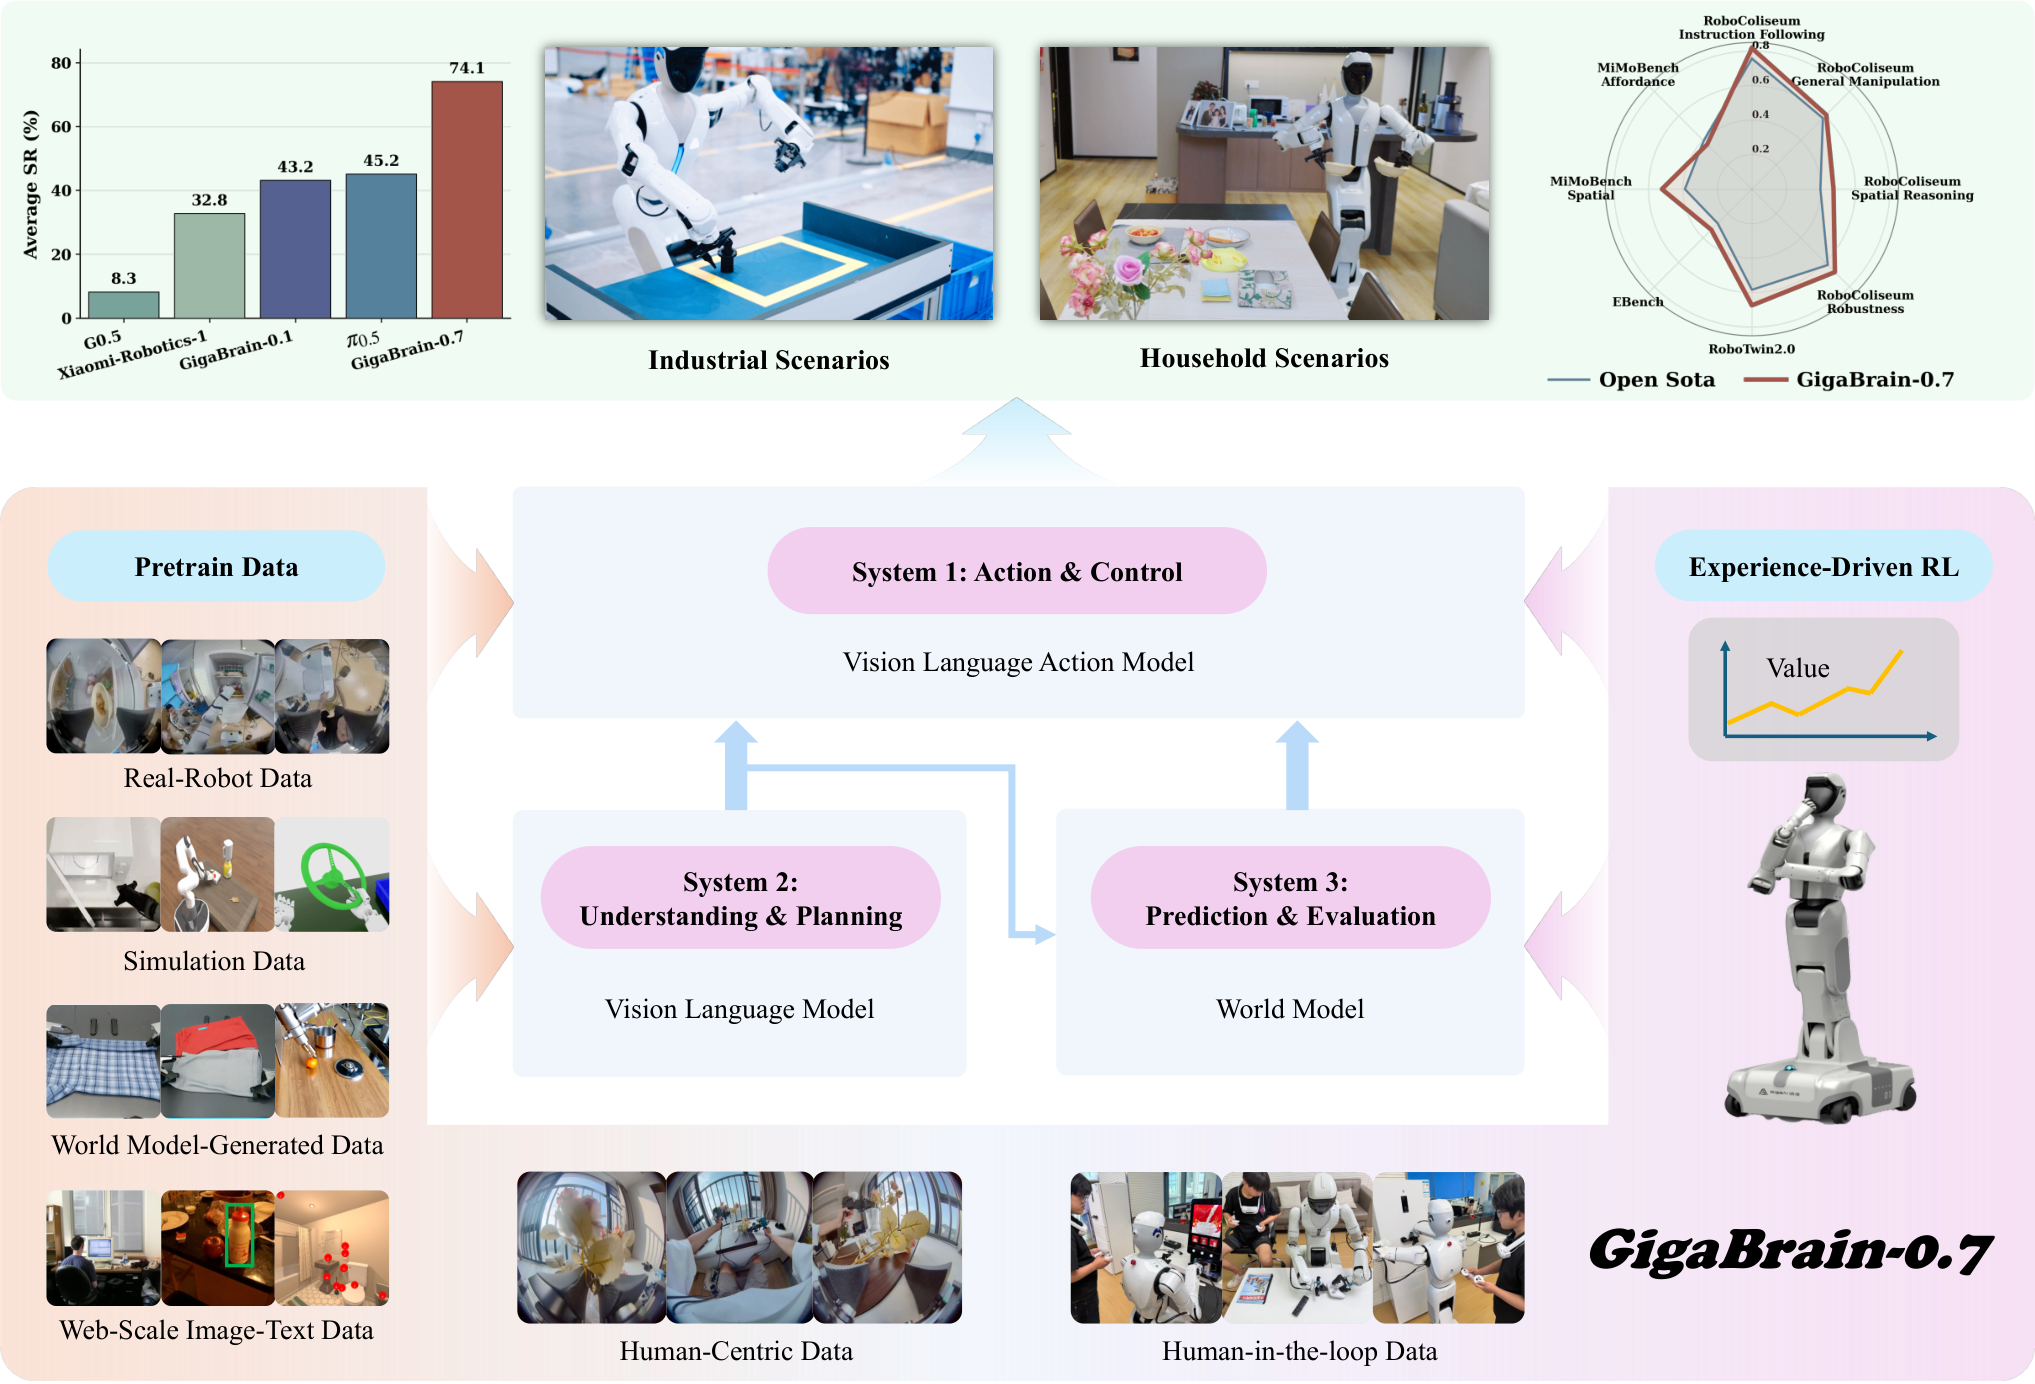
图1| Overview of GigaBrain-0.7.
论文对 GigaBrain-0.7 的总览:左边是跨来源数据,中间是预训练与后训练,右边是真机与仿真能力评测。
如果把传统 VLA 简化成:
图像 + 指令
    ↓
   VLA
    ↓
连续动作
那么 GigaBrain-0.7 想做的是:
                    ┌──────────────────────┐
                    │ System-2:理解与规划 │
                    │ 现在是什么状态?     │
                    │ 下一步应该做什么?   │
                    └──────────┬───────────┘
                               │ subtask / context
                               ▼
图像 + 历史 ───────→ ┌──────────────────────┐
                     │ System-3:世界价值模型│
                     │ 下一阶段可能长什么样?│
                     │ 当前动作是否在推进?  │
                     └──────────┬───────────┘
                                │ future image + value
                                ▼
                     ┌──────────────────────┐
                     │ System-1:动作专家   │
                     │ Flow Matching       │
                     │ 连续动作块生成       │
                     └──────────┬───────────┘
                                ▼
                              机器人
可以把三者理解成一支机器人工作小组:
- System-2 是领班,负责理解任务、拆分子任务;
- System-3 是沙盘推演 + 质检员,告诉策略“如果继续这么干,接下来可能发生什么,以及任务到底有没有在向前推进”;
- System-1 是真正的手脚,负责把高层意图落成连续控制信号。
这里最值得关注的变化,是 World Model 不再只躺在训练数据生成流水线上,而是开始进入策略条件本身。
2. 第一座金字塔:37,256.98 小时,真正 Scale 的不是“真机小时数”
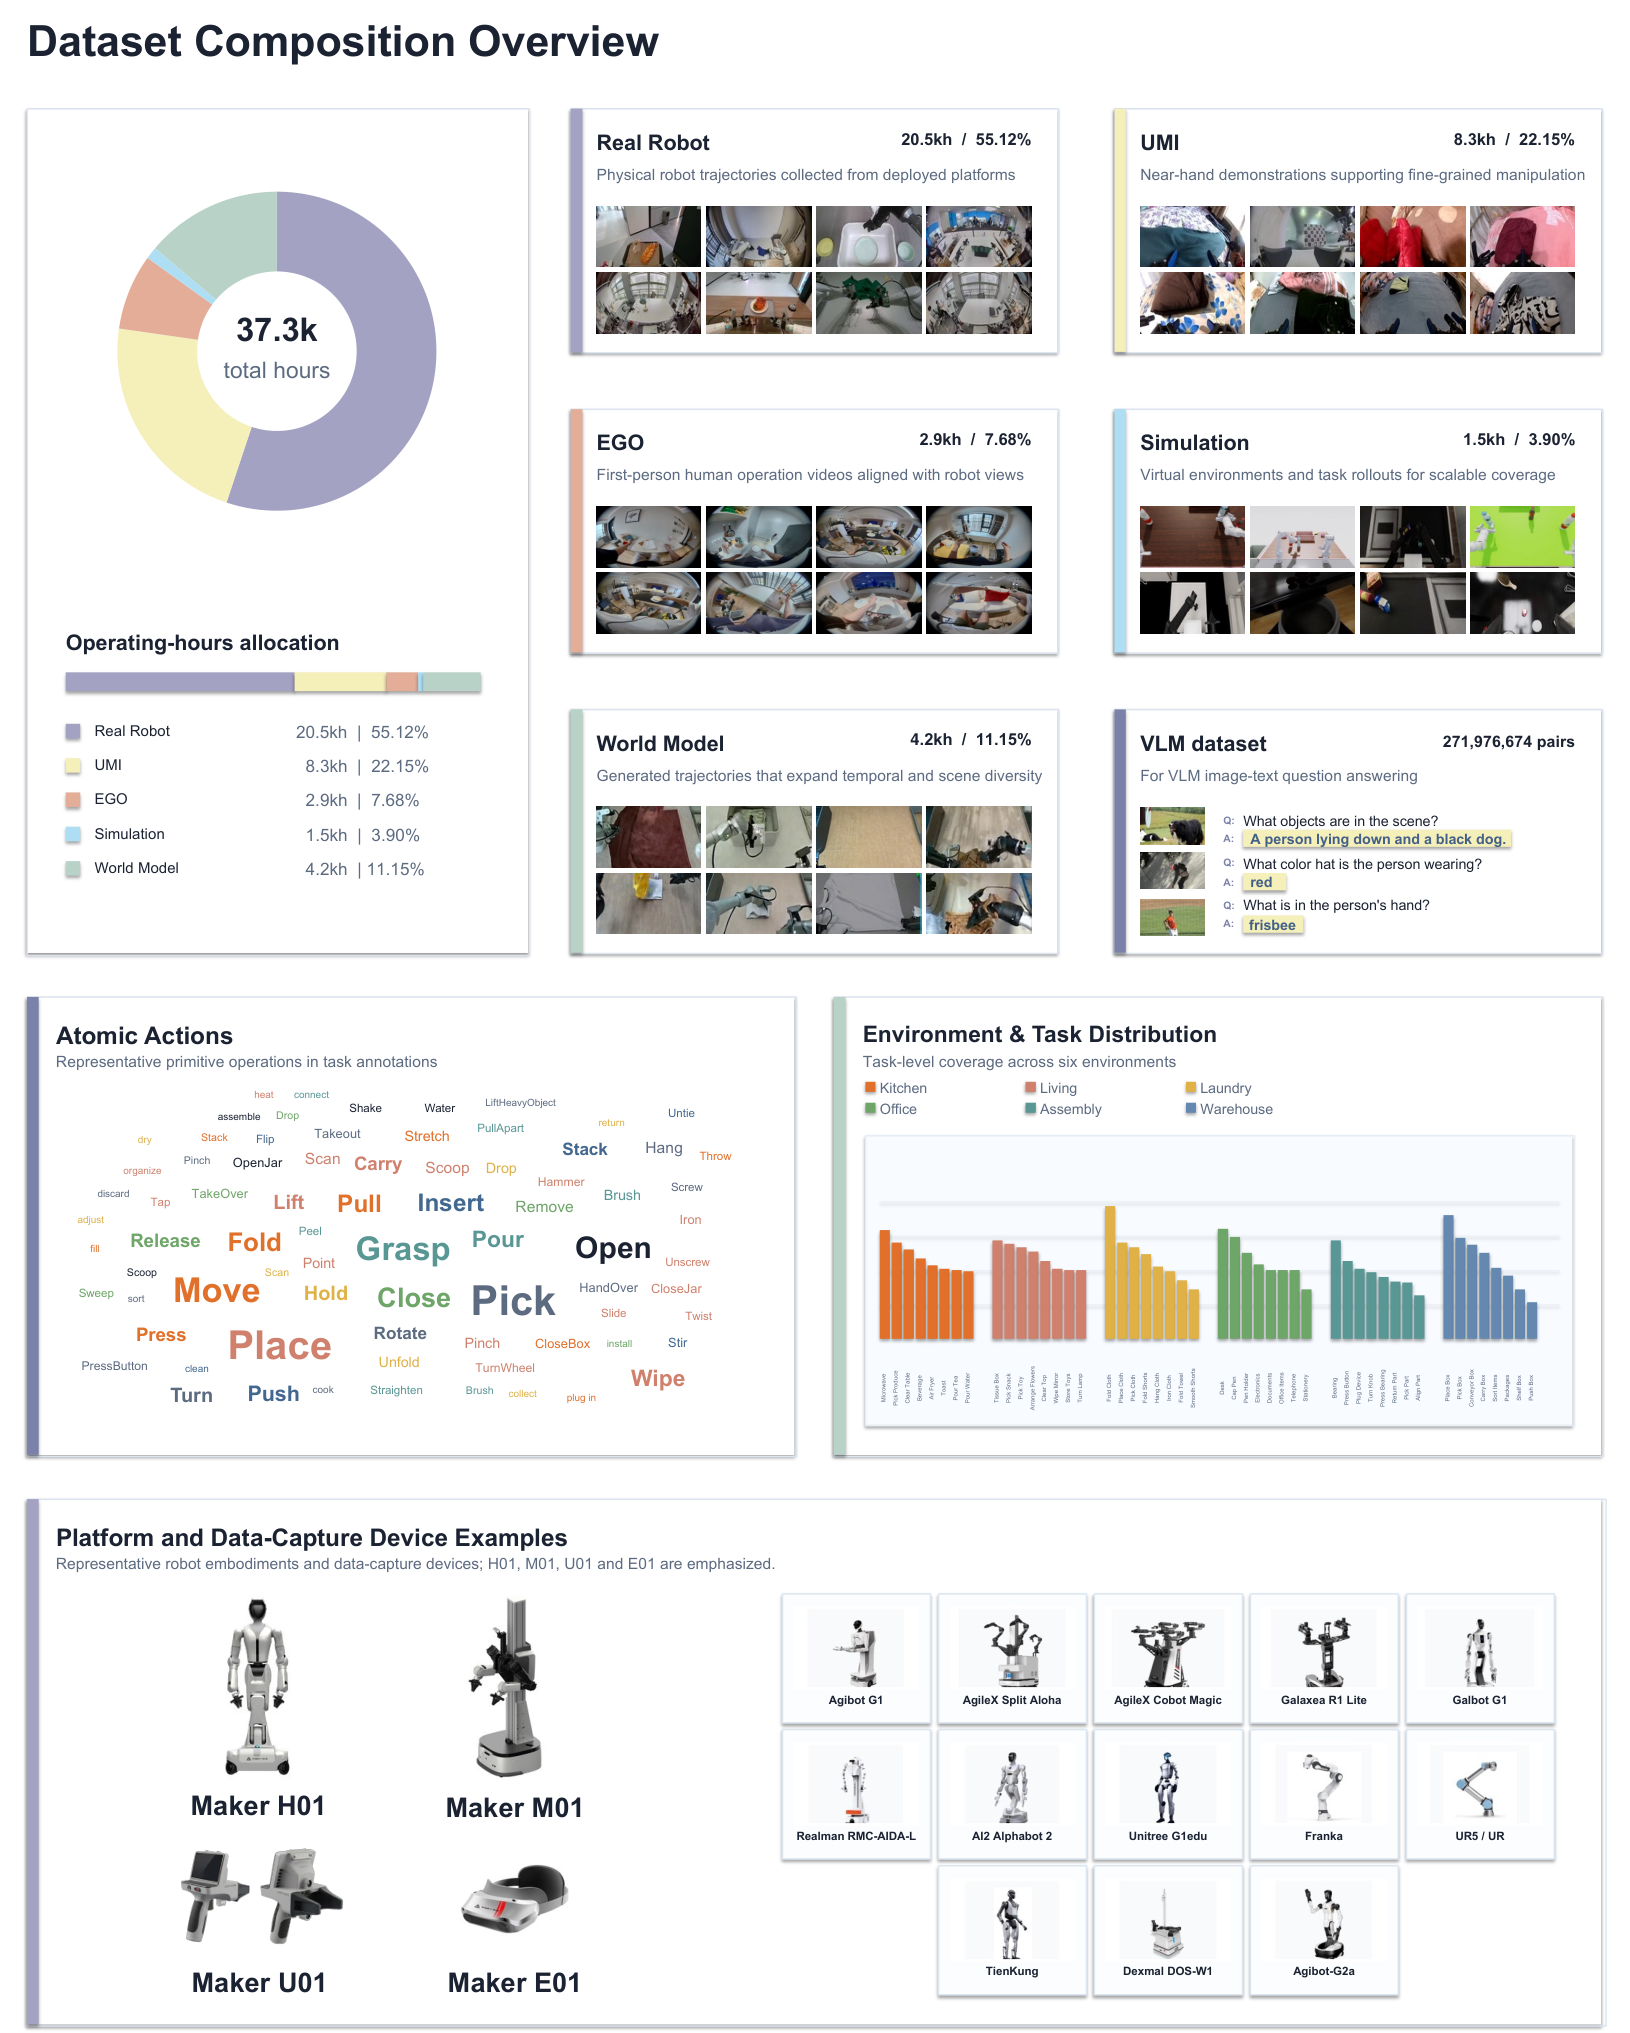
图2|Composition of the GigaBrain-0.7 training corpus.
GigaBrain-0.7 训练轨迹的构成。
论文给出的清洗后具身轨迹总量是:
| 数据来源 | 时长 | 占比 |
|---|---|---|
| Real Robot 真机数据 | 20,535.65 h | 55.12% |
| UMI 真人示教 | 8,251.83 h | 22.15% |
| EGO 第一视角真人数据 | 2,862.36 h | 7.68% |
| Simulation 仿真 | 1,453.92 h | 3.90% |
| World Model 生成数据 | 4,153.22 h | 11.15% |
| 总计 | 37,256.98 h | 100% |
此外,论文还使用了约 2.72 亿条视觉语言图文 / QA 数据来加强视觉语义理解。
这组数字真正有价值的地方,不是“37,000 小时听起来很大”,而是它反映出一个明确的数据观:
具身 Scaling 不应该只靠昂贵的机器人真机轨迹,而要把不同成本、不同物理真实性的数据放进同一套训练体系。
也就是说,真机数据负责“物理落地”,UMI 和 EGO 负责快速扩充人类操作经验,仿真和生成数据负责覆盖危险、稀有和长尾场景,互联网视觉语言数据则负责补充常识、语言和视觉语义。
这和很多早期 VLA “先收一批机器人数据,再针对任务 fine-tune”不是一个路线。
2.1 为什么 UMI/EGO 数据值得单独看?
传统机器人数据的最大问题是贵。
你需要机器人、本体维护、场地、安全员、遥操作员,还可能因为一次碰撞直接把采集暂停。于是“继续扩大数据量”很快会撞上成本天花板。
GigaBrain-0.7 的思路是,把真人采集做成传感器尽量同构、动作可重定向的数据源。
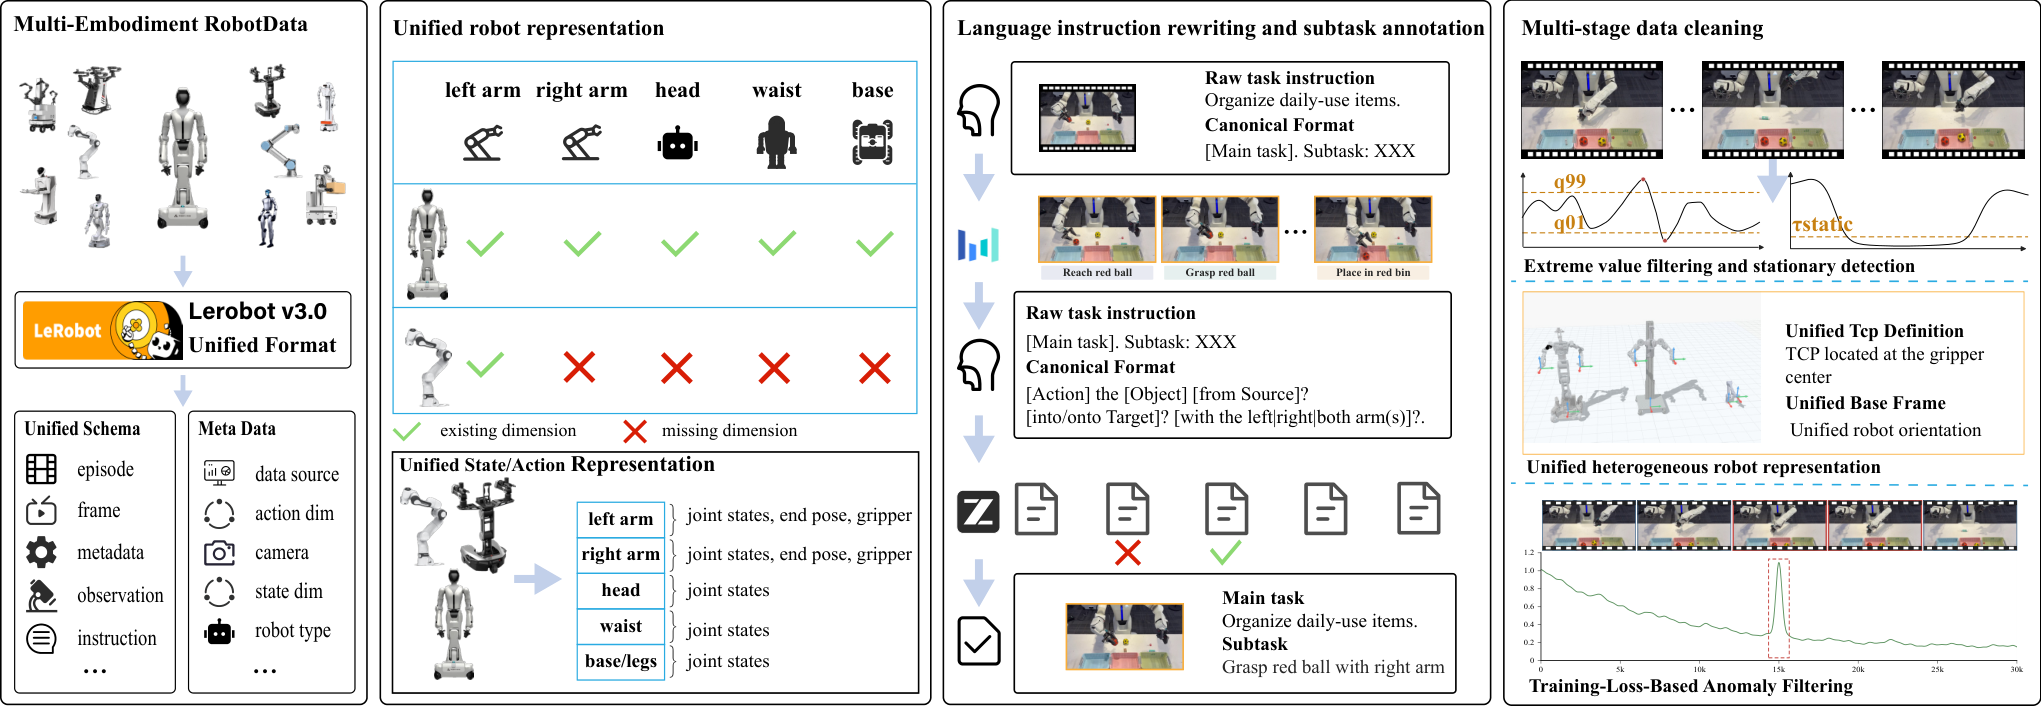
图3| Real-robot data processing pipeline.
论文给出的真机数据处理与标准化流程。
它不是简单把人类视频扔进训练集,而是需要完成:
原始多模态轨迹
  ↓
时间同步 / 标定
  ↓
动作空间转换与机器人统一表示
  ↓
指令改写 + Subtask 标注 + VQA 标注
  ↓
质量筛选
  ↓
统一 LeRobot v3.0 数据格式
这一步非常关键。
对于多本体模型而言,真正困难的从来不只是“数据有没有”,而是:
不同机器人的关节数、控制频率、相机布局、夹爪定义和动作空间都不一样,怎么把它们变成模型可以共享的知识?
GigaBrain-0.7 后面那套 Shared Action Expert,其实和这里的数据统一是互相咬合的。如果输入输出空间完全没有标准化,所谓“跨本体参数共享”很容易只停留在 PPT 上。
3. 论文真的证明了“具身 Scaling Law”吗?
这里需要把发布稿里的措辞稍微收紧。
论文确实展示了三个很清楚的 Scaling trend:
- 随着预训练数据继续增加,验证损失持续下降;
- 增加机器人数据后,真机成功率继续提高,尤其对衣物折叠这类混沌、长程、可变形物体任务更明显;
- 在固定约 3,000 小时机器人数据的基础上加入 UMI、EGO,真机效果继续提升,而 Robot + UMI + EGO 的组合最好。
这说明:
无本体真人数据并不是“只能拿来预训练视觉”,它能够转化为真实机器人操作收益。
但严格说,论文目前展示的是“正向 Scaling 证据”,还不是 LLM 论文里那种经过拟合、具有明确指数关系、可用于预测计算/数据/损失关系的完整 Scaling Law。
所以更准确的说法应该是:
GigaBrain-0.7 给出了具身数据规模扩张有效的实验趋势,而不是已经建立了一条普适的具身 Scaling Law。
这一点看似只是措辞,其实很重要。因为具身数据的“1 小时”并不等价:重复桌面抓取 1 小时,和包含多物体、失败恢复、长程任务的 1 小时,信息密度完全不同。
未来真正有意义的 scaling 研究,恐怕不会只统计小时数,还要统计状态覆盖度、动作多样性、任务熵、失败密度和跨本体分布。
4. System-1:不是每种机器人一个专家,而是“共享大脑 + 少量本体接口”
GigaBrain-0.7 的动作生成模块建立在 Mixture-of-Transformers(MoT)+ Flow Matching 上。
最直观的理解是:
视觉语言 Token ───────┐
                      ├─→ 联合注意力 → Action Expert → 连续动作块
机器人状态 / 噪声动作 ─┘
其中 VLM 和 Action Expert 保留各自的 FFN,但在注意力层中进行信息交互,形成“双流”结构。
动作生成采用 Flow Matching。无需死记公式,可以把它理解成:
随机噪声动作
   ↓
模型学习“动作应该往哪个方向流动”
   ↓
逐渐靠近示范数据中的真实动作分布
   ↓
得到连续 action chunk
相比把机器人控制离散成一个个 token,这种做法天然更适合机械臂连续控制。
4.1 Shared Action Expert:不同机器人到底共享什么?
GigaBrain-0.7 并不是给 AgileX PiPER、Maker H01 等不同机器人各训练一个完整动作模型。
它让不同本体共享 Action Expert 的 Transformer 主干,只通过 Robot ID 路由到对应的状态 / 动作输入输出投影层。
也就是:
PiPER 状态 ─→ PiPER Adapter ─┐
Maker H01 ─→ H01 Adapter ────┼→ Shared Action Expert
Robot C   ─→ C Adapter ──────┘

Shared Action Expert
        ↓
┌───────┼───────────┐
PiPER Head   H01 Head   Robot C Head
这背后的假设很漂亮:
“抓、放、推、插、折叠、避障”这些操作知识具有跨机器人共性,真正需要本体专属处理的只是动作坐标和低层接口。
如果这个假设能够持续扩展,就意味着未来增加一种新机器人,不一定要重新训练一套 VLA,只需要给它接一个新的 embodiment adapter。
4.2 Soft Knowledge Insulation:为什么不能让动作损失随便改 VLM?
多模态大模型的视觉语言能力很宝贵,但动作数据通常更窄、更偏某几个机器人和场景。
如果训练 Action Expert 时,所有梯度都毫无约束地灌回 VLM 主干,很可能发生一个问题:
动作越来越准,但原本通用的视觉、语言、空间理解反而被“训偏”了。
GigaBrain-0.7 因此使用 Soft Knowledge Insulation,对从动作侧回传到 VLM 的知识更新做软隔离。
它不是完全冻结,也不是完全放开,而是在两者之间找平衡:
通用 VLM 能力  ←── 保住
       ↑
  受控的信息交换
       ↓
机器人动作能力 ←── 继续适配
这个设计对于“一个基模服务多机器人、多任务”尤其重要。
4.3 一个反直觉结果:VLM 更大,不代表机器人更会干活
论文还比较了不同视觉语言骨干。
在 Clean Desk、Fruit Picking、Shirt Folding 三项真机任务上,PaliGemma2 3.5B 的结果分别为 50 / 88 / 30;更大的 Qwen3.5 5B 为 60 / 12 / 0;Gemma4 8.5B 则是 100 / 92 / 0*。
最有意思的是 Shirt Folding:只有 PaliGemma2 版本取得了非零成功率。
这说明具身模型的瓶颈不能简单归结为:
“VLM 再大一点就好了。”
语言模型榜单上的能力,并不会无损映射到动作对齐。视觉时序、动作表征、训练稳定性和本体数据匹配往往更关键。
5. System-2:长程任务为什么需要“记住刚才发生了什么”?
GigaBrain-0.7 的 System-2 使用视觉语言模型完成场景理解、Chain-of-Thought 式推理和 Subtask 规划。
这里有一个容易被忽略、但对长程任务非常实用的设计:短时历史视觉上下文。
为什么?
设想机器人正在“把一件衣服折两次”。第一次折叠结束后,当前画面可能和“准备进行第一次折叠”长得很像。
如果模型只看当前单帧:
看见衣服处于某个姿态
→ 判断应该执行“折一下”
→ 折完
→ 又看见近似姿态
→ 再次判断“折一下”
→ 陷入循环
论文的定性案例显示,加入短时历史后,模型能够区分:
“现在这个画面虽然看起来类似,但这是刚刚完成上一阶段之后的状态。”
这看起来不像“超长记忆”那样炫,但对机器人特别重要。
因为真实机器人最怕的往往不是完全看不懂,而是在几个视觉相似的状态之间不断重复同一动作。
长程任务能力,有时并不需要模型记住过去 20 分钟每一帧,而是需要保留足够的信息,让当前状态拥有“任务阶段身份”。
6. System-3:这才是 GigaBrain-0.7 最值得拆开的地方
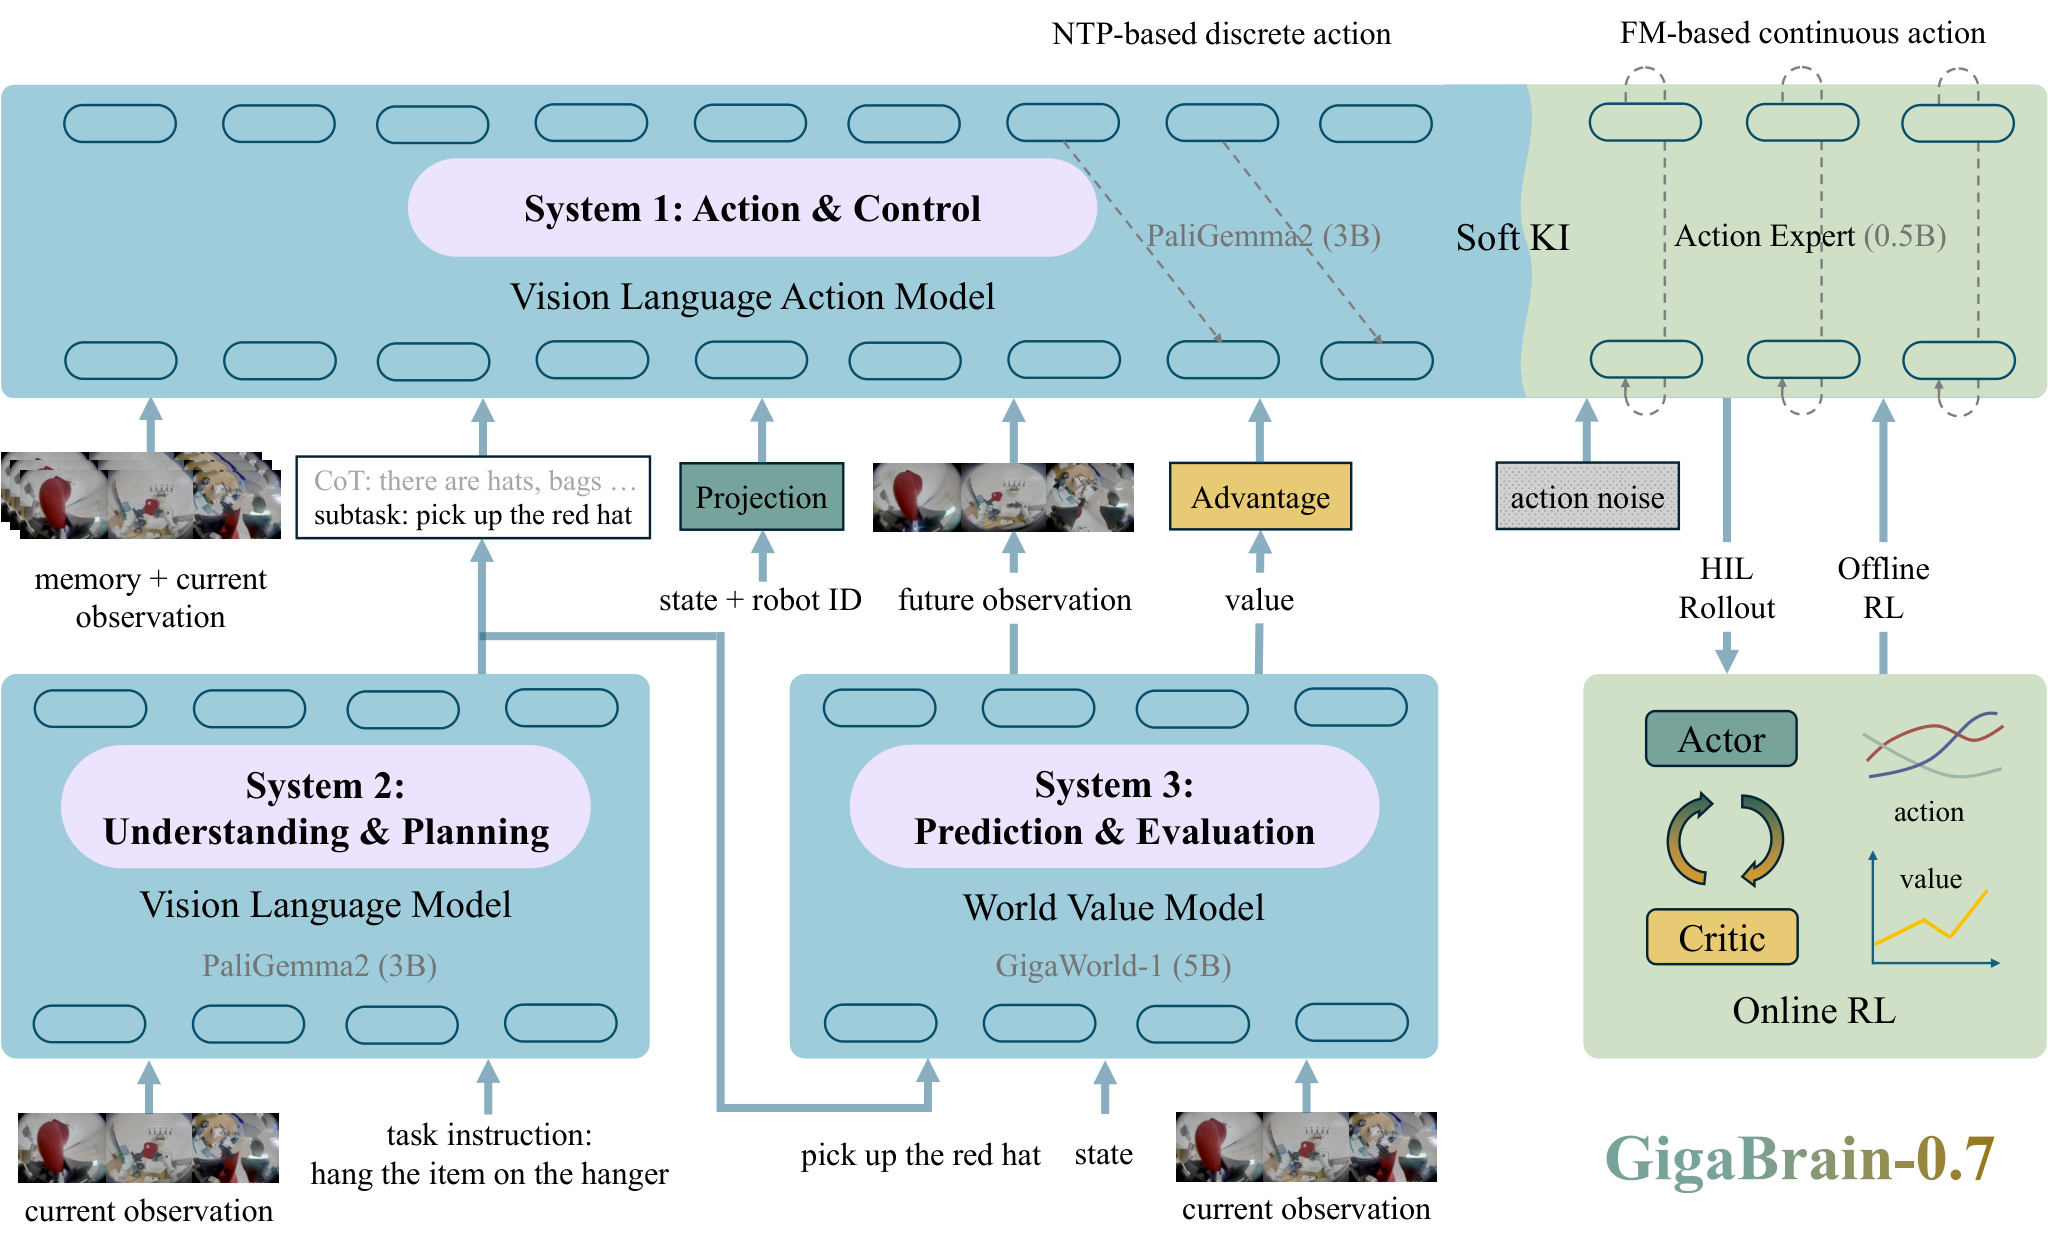
图4|Architecture of GigaBrain-0.7.
三系统架构及 System-3 如何向 System-1 提供未来视觉与价值条件。
发布稿把 System-3 描述成“机器人先预演未来,再执行动作”,这个直觉没有错,但如果想真正理解论文,需要再精确一点。
它不是经典 MPC 那种:生成 N 条候选动作 → 用世界模型滚 N 个未来 → 挑一条最优轨迹。
GigaBrain-0.7 的 World Value Model 主要向策略提供两种条件:
第一种:未来子目标图像 g_t
System-3 根据当前状态和子任务,预测接下来一段时间世界可能如何变化,并把预测视频的最后一帧作为未来子目标图像。
于是 System-1 不再只看到:
“现在长什么样”
还能够看到:
“如果这个子任务顺利推进,接下来大概应该长什么样”
这相当于给动作生成提供了一张视觉版“施工效果图”。
第二种:任务进度 Value V_t
System-3 同时估计任务当前的进度值。
论文进一步构造了一个非常简单的二值进展条件:
[
A_t = \mathbb{1}\left[V_{t+\delta_t}-V_t>0\right]
]
其中:
- (V_t):当前状态的任务进度估计;
- (V_{t+\delta_t}):执行一小段动作后的进度估计;
- (A_t=1):说明这一段行为让任务向前推进;
- (A_t=0):说明没有推进,甚至可能退步。
因此,后训练时 System-1 学到的是:
在“未来目标图像 + 正向进度条件”下,什么样的动作更像是能够继续把任务推进下去的动作。
推理时,策略直接条件在“positive progress”上。
所以 System-3 的作用更接近:
未来视觉提示 + 进度价值提示
            ↓
       条件化动作策略
而不是一个每步穷举动作再打分的在线搜索器。
这一区别很关键,因为两者的推理成本、控制机制和失败模式完全不同。
6.1 世界模型到底真的“看见失败”了吗?
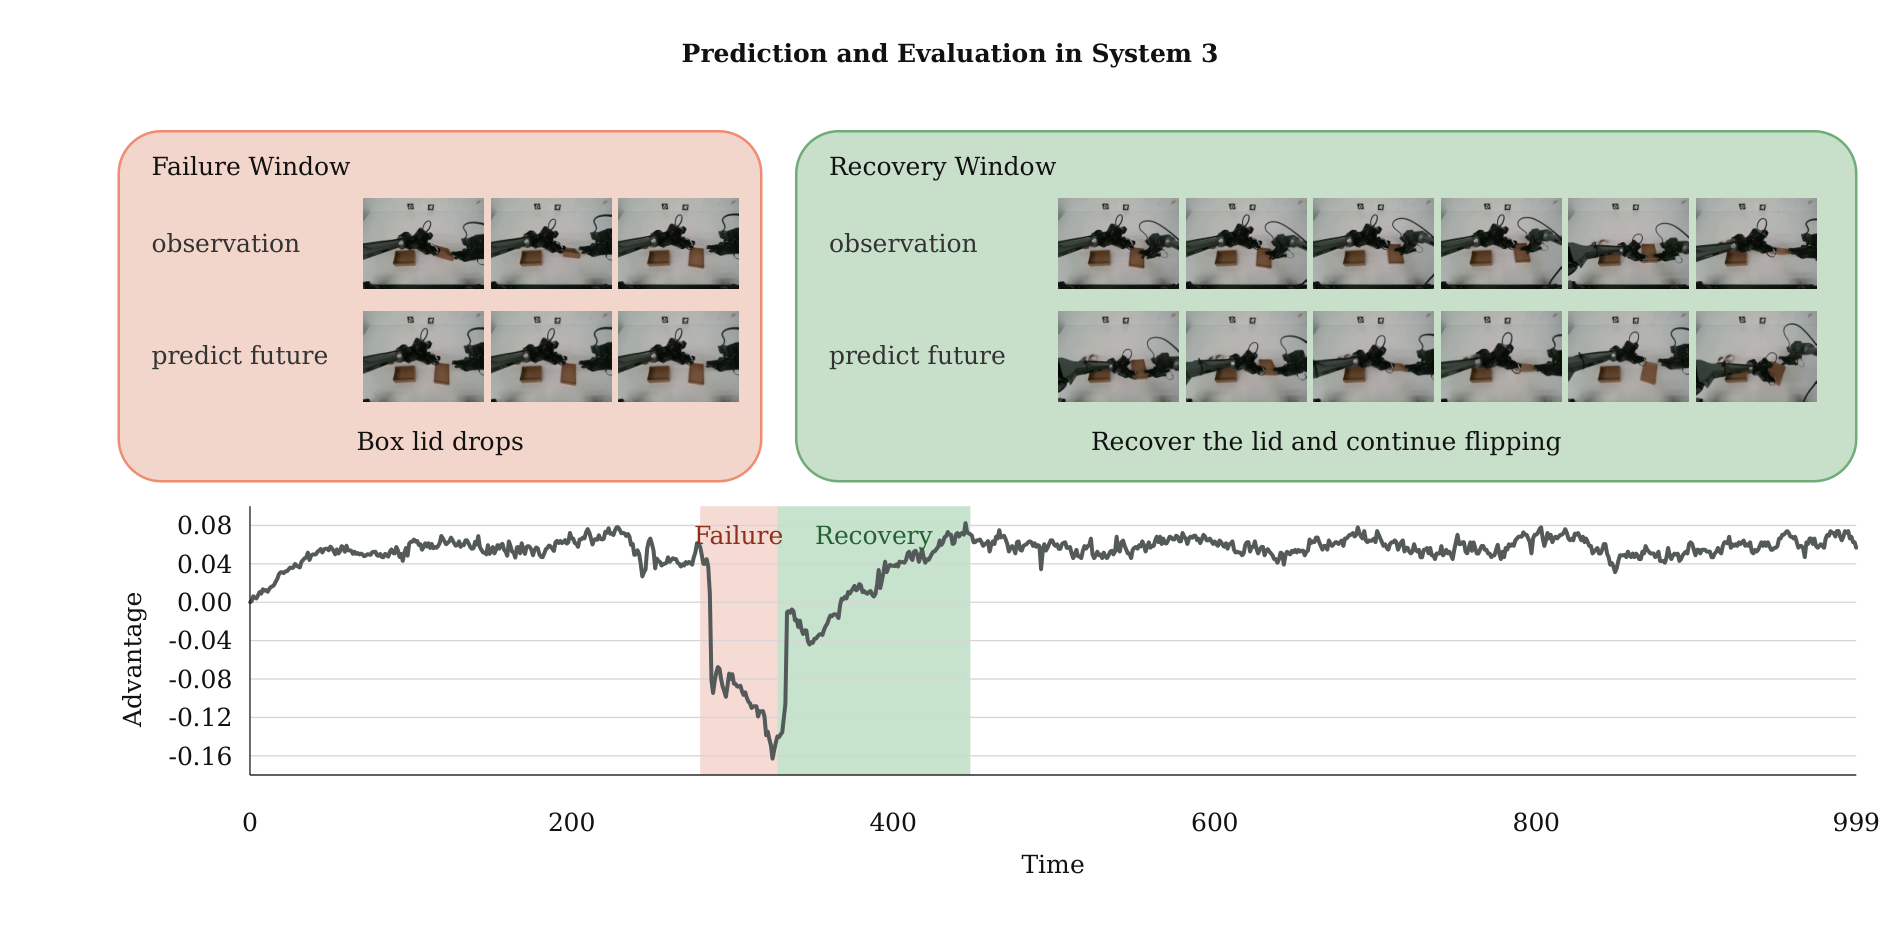
图5 Prediction and evaluation with the World Value Model.
System-3 对未来状态进行预测,并根据未来变化给出任务价值判断。
论文展示了一个很直观的案例:当世界模型预测到盒盖掉落等失败未来时,advantage/value 明显下降;当后续行为把任务拉回正确轨道时,价值又重新上升。
这意味着 World Model 的角色已经不只是:
“生成一段看起来像未来的视频。”
而是进一步被用于回答:
“这个未来对完成任务到底是好还是坏?”
这也是 World Value Model 这个名字里“Value”的真正意义。
7. System-3 到底提升了多少?消融比概念更有说服力
论文在 Clothes Folding、Gift Wrapping、Cube Sorting 三类真机任务上,对四种设置进行了对比:
Base
+ Subgoal Image
+ Value
+ Subgoal Image + Value
其中最典型的是 Gift Wrapping:
| System-3 条件 | 成功率 |
|---|---|
| Base | 0% |
| + Subgoal Image | 20% |
| + Value | 60% |
| + Subgoal Image + Value | 80% |
而 Clothes Folding 中,四种设置成功率都已经达到 100%,这时二元成功率看不出差别,但任务完成质量和速度仍持续改善:
- Base 平均任务得分约 68.3;
- 完整 System-3 提升到约 88.3;
- 完成时间从约 107 s 降到 75 s。
这个结果其实比“成功率又涨几个点”更有意思。
它说明 System-3 的作用不只是在失败任务上“救回来”,还可能在已经能完成的任务上,让行为更完整、更利落、更少绕路。
另一个值得注意的现象是:多个任务里 Value 单独加入的效果往往比 Subgoal Image 单独加入更强,但两者一起通常最好。
这提示我们:对于机器人而言,“知道未来应该长什么样”固然重要,但“知道自己有没有真正往任务目标前进”可能更加直接。
8. Experience Reinforcement:真正的闭环不是收更多专家数据,而是让失败变成训练数据
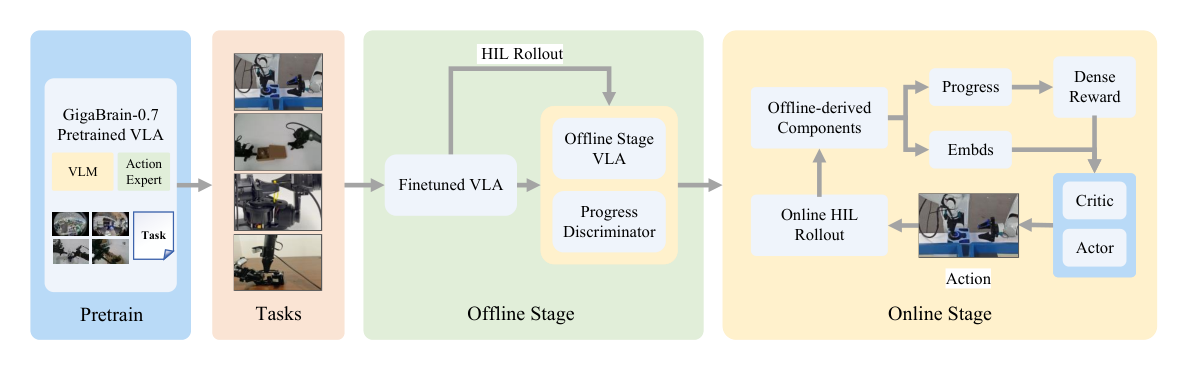
图6| Experience Reinforcement Pipeline.
从 SFT 到 Offline RL,再到带人类干预的 Online RL。
如果只靠行为克隆,机器人会遇到一个经典问题:
专家数据里几乎都是“正确状态”,但机器人一旦自己犯错,就会跑进训练集没有覆盖过的状态分布。
于是一个小误差可能像雪球一样越滚越大。
GigaBrain-0.7 的 Experience Reinforcement 用三步处理:
第一步:SFT
用少量专家轨迹让模型先获得基本任务能力。
第二步:Offline Experience Learning
让当前策略自己 rollout,收集:
- 成功轨迹;
- 失败轨迹;
- 进度快 / 慢;
- 完成质量高 / 低;
- 人类在环修正数据。
然后利用 progress/value 估计和类似 Advantage-Weighted Regression 的目标,让更优的片段得到更高权重。
这一步最重要的收益不是“把专家轨迹再学一遍”,而是把模型自己的失败状态重新灌回训练分布,从而训练错误恢复。
第三步:Online Reinforcement
对于插线、轴承安装、扎线带这类精细操作,再通过在线 actor-critic 和人类纠偏持续更新。
论文的四个代表性任务结果非常醒目:
| 任务 | SFT | Offline RL | Online RL |
|---|---|---|---|
| Link Installation | 20% | 40% | 100% |
| Gift Box Packing | 80% | 90% | 100% |
| Cable Tie Insertion & Tying | 0% | 40% | 100% |
| Bearing Installation | 20% | 60% | 100% |
| 平均 | 30.0% | 57.5% | 100% |
但这里同样需要克制理解:
“Online RL 达到 100%”是这 4 个选定高难任务上的结果,并不意味着 GigaBrain-0.7 在任意机器人任务上都已经稳定 100%。
而且技术报告也明确表示,更完整的人类干预协议和在线 RL 细节将留待后续报告。
因此这部分目前更像是一个强有力的 proof-of-concept,而不是已经完全可复现的 RL recipe。
9. “One Model, Many Tasks”:开箱即用到底到了什么程度?
论文把 foundation model 本身直接放到两个差异明显的机器人上:
- AgileX PiPER 双臂机器人;
- Maker H01 人形机器人。
并测试域内 / 域外物体、未知摆放、未知服装实例、不同初始状态等条件。
这个实验最值得看的不是“有没有成功案例”,而是:同一个预训练策略不做每个任务单独适配时,是否仍然保留基础操作能力。
论文观察到了明显的 OOD 泛化,但作者同样承认 ID → OOD 仍存在性能下降。
所以“开箱即用”更准确的理解是:
模型已经表现出跨任务、跨实例、跨本体的 foundation capability,但还没有达到真正开放世界、任意任务零样本可靠执行。
这其实已经很不容易了。机器人世界里的 OOD,不只是换个颜色,它可能同时意味着:物体几何不同、接触动力学不同、相机视角不同、本体动作空间不同。
10. 横向 Benchmark:真正值得看的是 Maker H01 上的差距
在任务级后训练后的真机对比中,GigaBrain-0.7 和 π0.5 等模型进行了统一协议下的比较。
几个核心平均值如下:
| 评测 | π0.5 | GigaBrain-0.7 |
|---|---|---|
| PiPER:语言跟随 | 88.8 | 91.5 |
| Maker H01:语言跟随 | 75.2 | 84.2 |
| PiPER:复杂操作 | 76.6 | 84.9 |
| Maker H01:复杂操作 | 45.2 | 74.1 |
其中 Maker H01 复杂操作从 45.2 拉到 74.1,确实是非常大的差距。
不过这组结果也要带着一个背景来看:Maker H01 是极佳视界自研本体,其采集硬件、数据体系和模型动作接口天然有更深的协同优化空间。
所以这组结果能够证明:
GigaBrain-0.7 在自己的完整“数据 + 本体 + 模型”栈上非常强。
但它不能单独证明:
换到任意第三方机器人上都会保持同样幅度的领先。
这也正是为什么 PiPER 结果同样重要:它至少给了一个第三方机器人上的横向参照。
11. 仿真 Benchmark:RoboTwin、EBench、RoboColiseum 都拿到了领先结果
论文还给出多套仿真 / 统一 benchmark:
RoboTwin 2.0
GigaBrain-0.7 总体得分 67.35,π0.5 为 58.35,在参与比较的模型中排名第一。
EBench
GigaBrain-0.7:
- Success Rate:33.30
- Score:46.1
π0.5 分别为 28.08 / 42.0。
RoboColiseum
在论文统计时点的四个维度中,GigaBrain-0.7 均为第一:
| 维度 | GigaBrain-0.7 |
|---|---|
| Instruction Following | 0.8166 |
| Spatial Reasoning | 0.4729 |
| Robustness | 0.6800 |
| General Manipulation | 0.6092 |
这也就是发布稿所说“4 个分项全部第一”的来源。
不过 leaderboard 是动态的。更严谨的写法应该是:
在论文所记录的 2026 年 8 月榜单快照和对比模型集合中,GigaBrain-0.7 四项均居首。
还有一个非常值得表扬的细节:论文在 MiMo benchmark 中明确区分了“MiMo 数据还没进训练集时的 held-out 测试”和“把 MiMo 数据继续预训练之后的诊断结果”。后者虽然更高,但作者没有把它包装成严格 held-out benchmark。
这比单纯扔一个最高分出来要可信得多。
12. 那个“超 20 分钟一镜到底”,到底意味着什么?
项目发布现场最抓眼球的,是机器人连续超过 20 分钟、完成 10 个以上任务的一镜到底演示。
这类 Demo 的价值,主要体现在三个地方:
1)长时间闭环稳定性
机器人单任务成功一次,并不难等价成连续工作 20 分钟。
只要每个动作块有一点点误差,经过数百个闭环周期后都可能累积成灾难。能够不中断完成连续任务,至少说明系统在状态跟踪、动作衔接、错误恢复和策略稳定性上已经跨过了一个更高门槛。
2)任务切换
10+ 任务连续完成意味着模型不是只围着一个固定操作脚本打磨,而需要频繁切换目标和子任务。
这与 System-2 的 subtask planning、System-3 的 progress conditioning,以及 history context 是彼此对应的。
3)失败恢复
长程任务真正危险的不是“大失败”,而是杯子偏两厘米、衣服褶皱了、夹爪第一次没夹正这种小偏差。
Experience Reinforcement 和 World Value Model 都在针对这类问题发力。
但是也要明确:
“20 分钟一镜到底”目前更接近系统 Demo 指标,而不是技术报告中定义严格、可由第三方重复执行的 benchmark。
技术报告没有给出这段 Demo 的标准化任务清单、随机种子、重复次数、置信区间以及与其他模型同协议的 20 分钟长程比较。
所以它很适合证明“系统已经能做到什么”,不应该单独拿来证明“长程任务 SOTA”。
13. 我认为 GigaBrain-0.7 真正值得关注的,不是某一个 SOTA 数字
看完整篇报告,我认为有四个点比“又刷新了一个榜单”更值得长期关注。
第一,Scale 的单位从“机器人轨迹”变成了“异构物理经验”
真机、UMI、EGO、仿真、World Model 生成数据不是互相替代,而是不同成本和真实性的数据层级。
这很可能才是具身数据真正可扩张的路径。
第二,World Model 开始从“训练辅助工具”走进策略本身
过去很多 World Model 的作用是:
生成数据 → 训练 policy
GigaBrain-0.7 则进一步变成:
当前状态
  ↓
World Model 预测未来 + 判断进度
  ↓
作为条件继续影响 policy
如果这条路线成立,未来 VLA 可能不再只是“反应式动作生成器”,而会逐渐拥有显式的未来表征。
第三,多本体不是简单把数据混在一起,而是同时改数据接口和模型接口
统一机器人表示、Robot ID、本体专属投影、Shared Action Expert、Soft Knowledge Insulation 是一整套协同设计。
这比一句“支持多机器人”更有工程含量。
第四,训练闭环开始覆盖“模型自己的错误状态”
从 SFT → offline rollout → online correction,本质上是在解决 imitation learning 最古老的问题:distribution shift。
真正能够长期工作的机器人,不可能永远待在专家示范覆盖的“干净状态”里。
14. 但这篇报告还有几个很关键的问题没有回答
GigaBrain-0.7 的结果很强,但距离“具身 GPT-3 时刻”还有几块硬骨头。
14.1 System-3 的真实在线代价是多少?
论文明确给出了 System-1 不同架构的训练 / 推理耗时比较,例如 Dual-Stream 版本单次推理约 0.221 s。
但完整系统还叠加了一个基于 GigaWorld-1 的约 5B World Value Model。
论文目前没有给出:
- System-3 单次预测延迟;
- 完整 System-1 + System-2 + System-3 的端到端延迟;
- 真机运行硬件;
- 控制频率;
- World Model 是否异步运行;
- 视频预测多久更新一次。
因此,“System-3 进入实时决策回路”作为架构思想已经成立,但它的实时工程账本还没有完全公开。
14.2 世界模型预测错了怎么办?
如果 subgoal image 幻觉出了错误物体位置,或者 value 对进度判断失真,会不会反过来把 System-1 带偏?
论文使用条件 dropout 来提高模型对缺失 / 不稳定条件的鲁棒性,这是很合理的一步,但还没有系统展示 World Model prediction error 和 policy degradation 的定量关系。
14.3 37,000 小时 ≠ 37,000 小时独立知识
机器人数据高度时序相关。
同一个场景连续采集 10 小时和 10 个完全不同任务各 1 小时,信息量显然不同。
未来如果要真正研究 embodied scaling,更值得看的可能是“有效状态覆盖”和“任务多样性”,而不是单一小时数。
14.4 Online RL 还缺完整可复现 recipe
四个高难任务全部做到 100% 很有冲击力,但论文目前还没有公开完整的人类纠偏协议、奖励构造细节和在线训练基础设施。
这部分很可能会决定后续开源版本到底能不能被社区复制。
14.5 代码和 GigaBrain-0.7 权重目前还没有真正放出来
截至 2026 年 8 月 21 日,公开 GitHub 仓库仍主要是此前的 GigaBrain-0,README 对 0.7 的状态写的是 “will be released soon”;Hugging Face 的 open-gigaai 模型列表也尚未出现 GigaBrain-0.7 权重。
因此这篇现阶段应该按“论文 / 技术报告解读”来读,而不是按“开源工程部署教程”来写。
等权重和代码真正发布后,最值得补测的反而不是再看一遍官方 benchmark,而是:
1. 单卡显存到底需要多少?
2. System-3 是否独立常驻?
3. 真实 action chunk 频率是多少?
4. World Model 更新频率是多少?
5. 第三方机器人新增 embodiment adapter 要多少数据?
6. 关掉 System-3 后端到端速度能差多少?
7. 真机失败恢复能否被独立复现?
这些问题,会决定 GigaBrain-0.7 是“很强的内部全栈系统”,还是能够真正外溢成社区级具身基础模型。
15. 最后,用一张逻辑链把 GigaBrain-0.7 串起来
如果只用一条链路记住这篇论文,我会这样概括:
              【数据金字塔】
互联网 VLM 数据 + UMI/EGO + 仿真/生成 + 真机
                    ↓
        统一表示 + 统一数据管线
                    ↓
             37,256.98 h
                    ↓
              【预训练】
     System-2:理解 / 规划 / 历史上下文
                    ↓
     System-1:Shared Action Expert
            MoT + Flow Matching
                    ↓
              【System-3】
   预测未来子目标图像 + 判断任务进度 Value
                    ↓
     给 System-1 一个“未来应该怎样”的条件
                    ↓
            【经验强化闭环】
       SFT → Offline RL → Online RL
                    ↓
     把成功、失败、恢复都重新变成经验
                    ↓
      One Model, Many Tasks / 长程执行
GigaBrain-0.7 最值得关注的,并不是它给 VLA 又加了一个更大的模块。
真正的变化是:它试图把理解、预测、动作、经验四件过去经常分开研究的事情,接进同一套具身基础模型生产线里。
过去的 VLA 更像:
“我看到了什么,所以我下一步应该怎么动。”
GigaBrain-0.7 想向前迈一步:
“我知道现在在做什么,也大致知道做下去会发生什么;如果结果不对,我还要能够从自己的失败里继续学。”
这可能才是 System-3 比“又一个 World Model”更值得讨论的地方。
至于它是不是已经跨过了具身智能的 GPT-3 时刻,现在下结论还太早。
但至少从这篇技术报告可以看到一个越来越清晰的方向:
下一代具身基础模型的竞争,可能不再只是 VLA 主干谁更大,而是谁能把高质量异构数据、未来预测、跨本体动作对齐和真实世界经验闭环一起 Scale 起来。
参考资料
- GigaBrain-0.7 项目主页:
https://gigaai.cc/blog/gigabrain07 - 技术报告:
https://arxiv.org/abs/2608.15875 - GitHub:
https://github.com/open-gigaai/giga-brain-0 - Hugging Face:
https://huggingface.co/open-gigaai/models
注:本文区分“技术报告中的可核验实验结果”和“项目发布 / 演示层面的宣传表述”。“超 20 分钟、10+ 任务一镜到底”属于项目发布演示亮点;本文没有将其当作标准化 benchmark 指标使用。
好长的文,他们是用自己的臂吗