
Spark-X2.5:1.7B/4B 小模型也能跑 Agent?从下载到本地 API 接入的工程实践
Spark-X2.5 不是一篇只适合“看指标”的模型介绍,而是一套已经把模型权重、推理框架、OpenAI 兼容接口和 Agent 工具调用路径放到一起的开源工程方案。
很多本地模型都会遇到一个现实问题:
能聊天,不等于能稳定做 Agent;能做 Agent,也不等于能在普通工作站或边缘设备上长期运行。
Spark-X2.5 的定位比较明确:用 1.7B 和 4B 两个紧凑规格,覆盖对话、写作、翻译、推理、代码、工具调用和 Agent 工作流,同时把长上下文和多种本地推理路径一起开放出来。
本文不把它写成模型卡翻译,而是按照一个工程师真正接项目时会问的问题展开:它是什么、应该下载哪个版本、怎么最快跑起来、怎么接入自己的 Agent、什么时候用 MaaS、以及哪些宣传数字不能直接当成部署承诺。
先给结论:它适合谁
如果你只想快速判断 Spark-X2.5 值不值得试,可以先看下面这张表。
| 你的目标 | 建议路径 | 理由 |
|---|---|---|
| 本地搭一个 OpenAI 兼容模型服务 | SGLang + Spark-X2.5-4B | 官方 README 给出了带 spark25 工具调用解析器的启动方式 |
| 显存和功耗更紧张,希望响应更快 | Spark-X2.5-1.7B | 参数规模更小,适合作为轻量 Agent 或端侧候选 |
| 想接入 Ollama、LM Studio 或桌面应用 | GGUF + XHToken/llama.cpp | 官方 GGUF 模型卡提供了 llama.cpp、Ollama、LM Studio 路径 |
| Apple Silicon、Linux CPU 或 CUDA 环境 | Spark-MLX-LLM | 官方 README 明确提供 Apple silicon、Linux CPU、CUDA 12/13 安装分支 |
| 不想维护本地 GPU 服务 | 讯飞星辰 MaaS | 直接在平台侧选择模型和接口,不需要自己部署权重 |
我的判断是:4B 更适合先验证 Agent 质量,1.7B 更适合验证低成本和低延迟。但不要把“1M 上下文”理解成任何设备都能无条件塞入 100 万 token;官方模型卡也提示,1,048,576 token 的服务配置需要足够设备内存,内存不够就应降低上下文长度。
Spark-X2.5 到底是什么
Spark-X2.5 是 XHToken / SparkLLM 发布的紧凑型通用语言模型系列。当前公开的主线模型包括:
Spark-X2.5-1.7BSpark-X2.5-4B
官方模型卡将它们标为 Text Generation 模型,能力范围包括对话、写作、翻译、推理、代码、工具使用和 Agent 工作流。也就是说,当前公开模型的主定位是文本生成与 Agent,不要把它误读成视觉语言模型或图像理解模型。
它的工程价值不只是参数量小,而是从一开始就围绕下面这条链路组织:
模型权重
  ↓
推理后端:SGLang / vLLM / llama.cpp / MLX
  ↓
OpenAI-compatible API
  ↓
Agent、IDE、业务服务或边缘设备
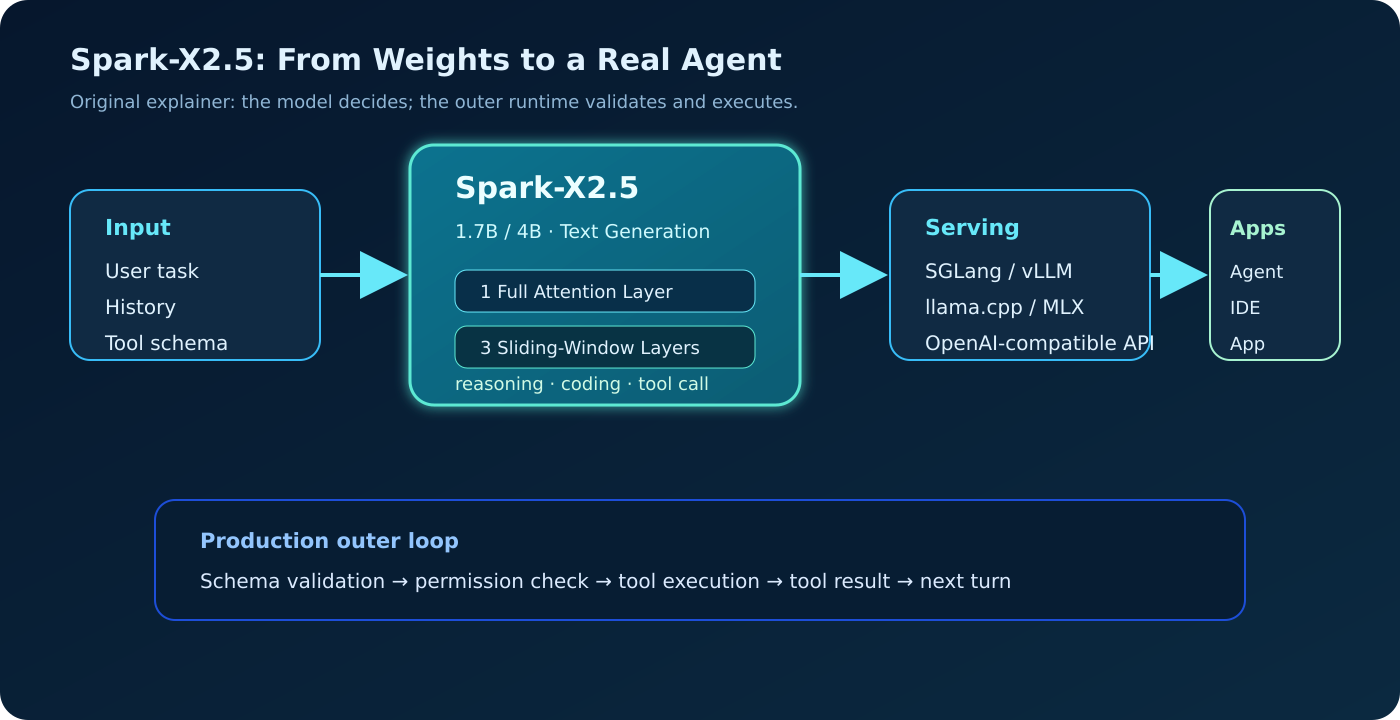
图1 Spark-X2.5 从模型权重到真实 Agent 的工程链路
注意图中的最后一层:Spark-X2.5 只负责根据上下文决定“下一步想做什么”,真正的工具执行、权限判断、结果校验和错误恢复仍然属于外层 Agent Runtime。一个能输出 tool call 的模型,不等于一个完整的 Agent 系统。
模型怎么选:标准模型、Base 模型和 GGUF 不要混
Hugging Face 的 Spark-X2.5 collection 当前同时列出了标准模型、Base 模型和 GGUF 版本。可以先按下表理解:
| 模型条目 | 主要用途 | 工程建议 |
|---|---|---|
Spark-X2.5-1.7B |
后训练模型 | 轻量对话、简单工具调用、端侧候选 |
Spark-X2.5-4B |
后训练模型 | 默认优先验证复杂一点的代码和 Agent 任务 |
Spark-X2.5-1.7B-Base |
Base 模型 | 继续训练、领域适配或研究,不是首选聊天入口 |
Spark-X2.5-4B-Base |
Base 模型 | 继续训练、领域适配或研究 |
Spark-X2.5-1.7B-GGUF |
GGUF 转换版本 | llama.cpp、Ollama、LM Studio 等本地应用 |
Spark-X2.5-4B-GGUF |
GGUF 转换版本 | 桌面端或 llama.cpp 生态 |
还有一个容易误解的点:官方 GGUF 模型卡写的是 BF16 GGUF conversion。因此,“GGUF”首先表示模型文件格式和运行生态,不等于自动就是 Q4/Q5 等低比特量化。真正下载前要看文件名、量化标签和文件大小,不能只看扩展名就估算显存。
为什么它能把长上下文做得更轻
Spark-X2.5 使用的是混合注意力结构:
- 一层 Full Attention:让模型保留跨远距离 token 的全局关联;
- 三层 Sliding-Window Attention:主要处理局部窗口,减少长序列计算和 KV cache 压力。
直观地说,它不是让每一层都完整回看整段历史,而是让少数层负责“看全局”,多数层负责“看附近”。这样可以在长上下文、推理速度和缓存占用之间做折中。
这里要注意两点:
- “原生支持最多 1M token”描述的是模型和架构能力,不是你的 GPU 一定能承受 1M token。
- 实际速度仍取决于推理框架、数据类型、并发数、输入长度、输出长度和硬件型号。
训练方法:只讲够用的部分
官方模型卡披露的训练路线包括:
- 约 20 万亿 token 的预训练数据,覆盖网页、书籍、学术文本、代码和百科内容;
- 单独的长上下文训练阶段,序列长度扩展到 1M token;
- 监督微调,建立指令跟随、结构化生成和任务完成能力;
- 面向语言理解、推理、编程、工具增强 Agent 行为和指令跟随的大规模强化学习;
- 通过 MOPD 将多个领域教师策略的能力合并到一个可部署模型中。
对工程使用者来说,最重要的结论不是记住这些训练名词,而是理解为什么它不只适合闲聊:模型训练目标明确覆盖了结构化输出、代码、工具增强行为和长上下文任务。
Quick Start:先用 SGLang 跑出 OpenAI 兼容接口
下面这条路径最适合第一次验证:模型放在本地,SGLang 起服务,客户端通过 /v1/chat/completions 调用。
1. 环境准备
官方给出的 SGLang 路径使用 NVIDIA GPU 和一个针对 Spark-X2.5 的预构建镜像。建议准备:
- Linux + NVIDIA GPU;
- 已能工作的 Docker 与 NVIDIA Container Toolkit;
- 足够的本地磁盘保存模型权重和缓存;
- 先用较短上下文做冒烟测试,再逐步增大上下文。
如果只是想先验证接口是否可用,可以选择 1.7B;如果重点是代码和 Agent 质量,建议先从 4B 开始。
2. 获取模型
模型可以从 Hugging Face Spark-X2.5 collection 或 ModelScope Spark-X2.5 collection 获取。
以 Hugging Face CLI 为例,下载到本地目录后设置:
python -m pip install -U "huggingface_hub[cli]"
hf download XHToken/Spark-X2.5-4B \
  --local-dir ./Spark-X2.5-4B

export MODEL_PATH="$(pwd)/Spark-X2.5-4B"
如果所在网络访问 Hugging Face 不稳定,可以直接在 ModelScope 页面下载对应模型。不要把标准 Transformers 目录和 GGUF 文件混放到同一个模型目录里,后面的启动参数必须和模型格式匹配。
3. 启动 SGLang 服务
官方 README 当前给出的 Spark-X2.5 SGLang 镜像是:
docker pull lmsysorg/sglang:nightly-dev-cu13-20260827-20621aa1
使用 4B 模型启动一个单卡、OpenAI 兼容服务:
docker run --rm -it \
  --gpus '"device=0"' \
  --ipc=host \
  -p 30000:30000 \
  -v "$MODEL_PATH:/root/Spark-X2.5-4B:ro" \
  lmsysorg/sglang:nightly-dev-cu13-20260827-20621aa1 \
  python -m sglang.launch_server \
    --model-path /root/Spark-X2.5-4B \
    --served-model-name spark2.5 \
    --tool-call-parser spark25 \
    --reasoning-parser qwen3 \
    --tp-size 1 \
    --mem-fraction-static 0.8 \
    --context-length 1048576 \
    --chat-template /root/Spark-X2.5-4B/chat_template.jinja \
    --host 0.0.0.0 \
    --port 30000
第一次跑不建议直接把 --context-length 设为 1048576。官方示例这么写是为了展示最大上下文配置,但实际机器如果内存不够,应先改成 32768 或 131072,确认服务能正常加载,再做长上下文压力测试。
4. 用 curl 验证
另开一个终端:
curl -s http://127.0.0.1:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "spark2.5",
    "messages": [
      {"role": "user", "content": "请用三句话解释什么是滑动窗口注意力。"}
    ],
    "max_tokens": 512,
    "temperature": 1.0,
    "top_k": -1,
    "top_p": 0.95,
    "repetition_penalty": 1,
    "presence_penalty": 0,
    "frequency_penalty": 0
  }'
正常情况下,你应该看到 JSON 响应,其中包含 choices[0].message。官方推荐的采样参数是 temperature=1.0、top_p=0.95、top_k=-1;本文的冒烟测试把 max_tokens 降到 512,是为了先快速确认链路。
5. 关闭 thinking
官方 SGLang 示例默认打开 thinking。对需要直接回答的简单请求,可以在请求中加入:
{
  "chat_template_kwargs": {
    "enable_thinking": false
  }
}
经验上可以这样分流:
- 简单分类、短问答、固定格式抽取:关闭 thinking,减少不必要的输出;
- 代码分析、复杂规划、工具链任务:先保持 thinking 开启,再根据延迟和成本测试是否关闭。
用 Python 接入:本地服务和 MaaS 只差三个变量
只要服务端提供 OpenAI 兼容接口,业务侧不需要绑定 SGLang 的内部 API。
pip install -U openai
本地服务的最小调用:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("SPARK_API_KEY", "EMPTY"),
    base_url=os.getenv("SPARK_BASE_URL", "http://127.0.0.1:30000/v1"),
)

response = client.chat.completions.create(
    model=os.getenv("SPARK_MODEL", "spark2.5"),
    messages=[
        {"role": "user", "content": "写一个 Python 函数,判断字符串是否为回文。"}
    ],
    temperature=1.0,
    top_p=0.95,
    extra_body={
        "top_k": -1,
        "chat_template_kwargs": {"enable_thinking": False},
    },
)

print(response.choices[0].message.content)
这段代码的价值在于:后续切换到 vLLM、本地 llama.cpp 或 MaaS 时,业务层只需要替换 base_url、api_key 和 model,不必重写 Agent 主循环。
真正接入 Agent:工具调用不是“让模型自己执行命令”
Spark-X2.5 的 Agent 能力应该按下面的安全链路接入:
用户任务
  ↓
模型生成普通回答或 tool call
  ↓
结构校验 / 参数校验
  ↓
权限检查、风险判断
  ↓
外部工具执行
  ↓
把 tool result 放回对话
  ↓
模型生成最终结果或下一步动作
SGLang 启动时的 --tool-call-parser spark25 很关键,它告诉服务端如何解析 Spark-X2.5 的工具调用格式。一个最小的工具声明可以写成:
tools = [
    {
        "type": "function",
        "function": {
            "name": "get_project_status",
            "description": "查询项目的当前状态",
            "parameters": {
                "type": "object",
                "properties": {
                    "project_id": {
                        "type": "string",
                        "description": "项目编号"
                    }
                },
                "required": ["project_id"]
            }
        }
    }
]

response = client.chat.completions.create(
    model="spark2.5",
    messages=[
        {"role": "user", "content": "查询项目 P-001 的状态。"}
    ],
    tools=tools,
)

message = response.choices[0].message
if message.tool_calls:
    call = message.tool_calls[0]
    # 生产环境:先校验 call.function.arguments,再决定是否执行。
    print(call.function.name)
    print(call.function.arguments)
这里故意没有把“删除文件、发消息、转账”之类高风险动作直接接上。工程上至少要补齐:JSON schema 校验、工具白名单、超时、重试、审计日志和人工确认。模型给出动作建议,外层系统才拥有执行权。
vLLM 路径:适合已有 vLLM 服务体系的团队
官方 README 的 vLLM 路径不是只安装一个 vllm 就结束,而是要求先安装 Spark plugin:
pip install uv
uv venv ~/spark2_5
source ~/spark2_5/bin/activate

git clone https://github.com/XHToken/Spark-plugin.git
cd Spark-plugin
uv pip install .
之后可以启动 OpenAI 兼容服务:
vllm serve ./Spark-X2.5-4B \
  --port 30000 \
  --trust-remote-code \
  --served-model-name spark25 \
  --tensor-parallel-size 1 \
  --gpu-memory-utilization 0.7 \
  --enable-prefix-caching \
  --chat-template Spark-X2.5-4B/chat_template.jinja
这里的 --trust-remote-code 意味着允许加载模型仓库中的自定义代码。个人实验可以按官方示例使用;生产环境建议固定模型版本、审核依赖和自定义代码,并把模型服务放在受控网络中。
如果团队已经统一使用 vLLM,直接沿用现有监控、网关和限流体系会更顺手;如果你只是第一次跑 Spark-X2.5,SGLang 的官方专用镜像和 spark25 parser 路径更适合做首轮验证。
低门槛本地路径:llama.cpp、GGUF 和 MLX
llama.cpp
官方 GGUF 模型卡提供了当前 llama.cpp 的快速入口:
curl -LsSf https://llama.app/install.sh | sh

llama serve -hf XHToken/Spark-X2.5-1.7B-GGUF
这会启动一个带 Web UI 的本地服务。想直接在终端运行则使用:
llama cli -hf XHToken/Spark-X2.5-1.7B-GGUF
Windows 也可以通过 WinGet 安装 llama.cpp;如果使用官方预编译二进制,需要确认该二进制包含 Spark-X2.5 所需的支持。
Ollama 和 LM Studio
Spark-X2.5 的 GGUF 模型卡列出了 Ollama 与 LM Studio,但同时强调 Spark 支持来自 XHToken 的 llama.cpp 分支。因此不能默认认为“任意旧版 llama.cpp / Ollama 就一定可以加载”。
官方给出的 Ollama 路径需要:
- 编译
XHToken/llama.cpp; - 编译 Ollama 并指定该 llama.cpp 源码;
- 用
Modelfile指向 GGUF 文件; - 启动
ollama serve后创建并运行模型。
LM Studio 路径则需要先编译兼容的 llama.cpp runtime,再备份并替换 LM Studio 选中的 runtime 目录。这个方案适合桌面端体验,不适合直接复制到生产服务器。
MLX
如果使用 Apple Silicon,或者需要在 Linux CPU / CUDA 环境中尝试 MLX 路径,可以使用官方 Spark-MLX-LLM:
git clone https://github.com/XHToken/Spark-MLX-LLM.git
cd Spark-MLX-LLM

python3 -m venv .venv
source .venv/bin/activate

# Apple silicon
python -m pip install -e .

# Linux CPU
# python -m pip install -e '.[cpu]'

# Linux CUDA 12 / CUDA 13
# python -m pip install -e '.[cuda12]'
# python -m pip install -e '.[cuda13]'

spark-mlx-generate \
  --device gpu \
  --dtype bfloat16 \
  --model XHToken/Spark-X2.5-1.7B \
  --prompt "请解释什么是 KV cache。" \
  --max-tokens 512 \
  --temp 0
MLX 路径的特点是可以直接使用原始 Hugging Face checkpoint,不需要先转换为 GGUF;但它与 SGLang/vLLM 的服务化参数和性能表现不能直接横向等同。
MaaS 接入:不要把本地模型名当成云端 model ID
如果目标是快速把 Spark-X2.5 接到现有业务,而不是自己维护 GPU,用户提供的 讯飞星辰 MaaS 模型广场 是另一条路径。
推荐按以下步骤操作:
- 在模型广场搜索并确认当前上架的 Spark-X2.5 具体条目;
- 查看平台给出的 API 协议、Base URL、模型 ID、上下文上限、计费和限流;
- 创建 API Key,并把 Key 放在环境变量或密钥管理系统中;
- 继续复用上面的 Python OpenAI 客户端,只替换三个变量:
export SPARK_BASE_URL="<MaaS 控制台显示的 OpenAI-compatible base URL>"
export SPARK_API_KEY="<MaaS API Key>"
export SPARK_MODEL="<MaaS 控制台显示的 model ID>"
最重要的提醒是:
XHToken/Spark-X2.5-4B是 Hugging Face 模型仓库名;MaaS 的model ID由平台定义,两者不能凭名字猜测相同。
由于 MaaS 模型广场是动态页面,本文不硬编码当前价格、配额和 model ID。上线前应以控制台当前显示值为准,并单独做一次流式输出、工具调用、超时和错误码验证。
Benchmark:数字说明了什么,不能说明什么
官方 README 给出的评测覆盖 Agent、代码、数学、通用能力与知识。所有评测都在 thinking mode 下进行,推荐采样参数为 temperature=1.0、top_p=0.95、top_k=-1。
下面只摘录几项比较能体现其定位的结果:
| Benchmark | Spark-X2.5-4B | Spark-X2.5-1.7B | 官方表中的部分同规模参考 |
|---|---|---|---|
| τ³-bench | 30.4 | 20.1 | Qwen3.5-4B:6.7;Gemma4-E4B:10.1 |
| MCP-Atlas | 54.6 | 23.4 | Qwen3.5-4B:40.8;Gemma4-E4B:15.0 |
| BrowseComp | 40.9 | 29.7 | Qwen3.5-4B:14.3;Gemma4-E4B:8.3 |
| SWE-Bench Pro | 44.4 | 10.4 | Qwen3.5-4B:29.4;Gemma4-E4B:4.0 |
| AIME 2026 | 90.7 | 69.4 | Qwen3.5-4B:83.0;Gemma4-E4B:42.5 |
| IFBench | 75.0 | 66.3 | Qwen3.5-4B:59.2;Gemma4-E4B:44.0 |
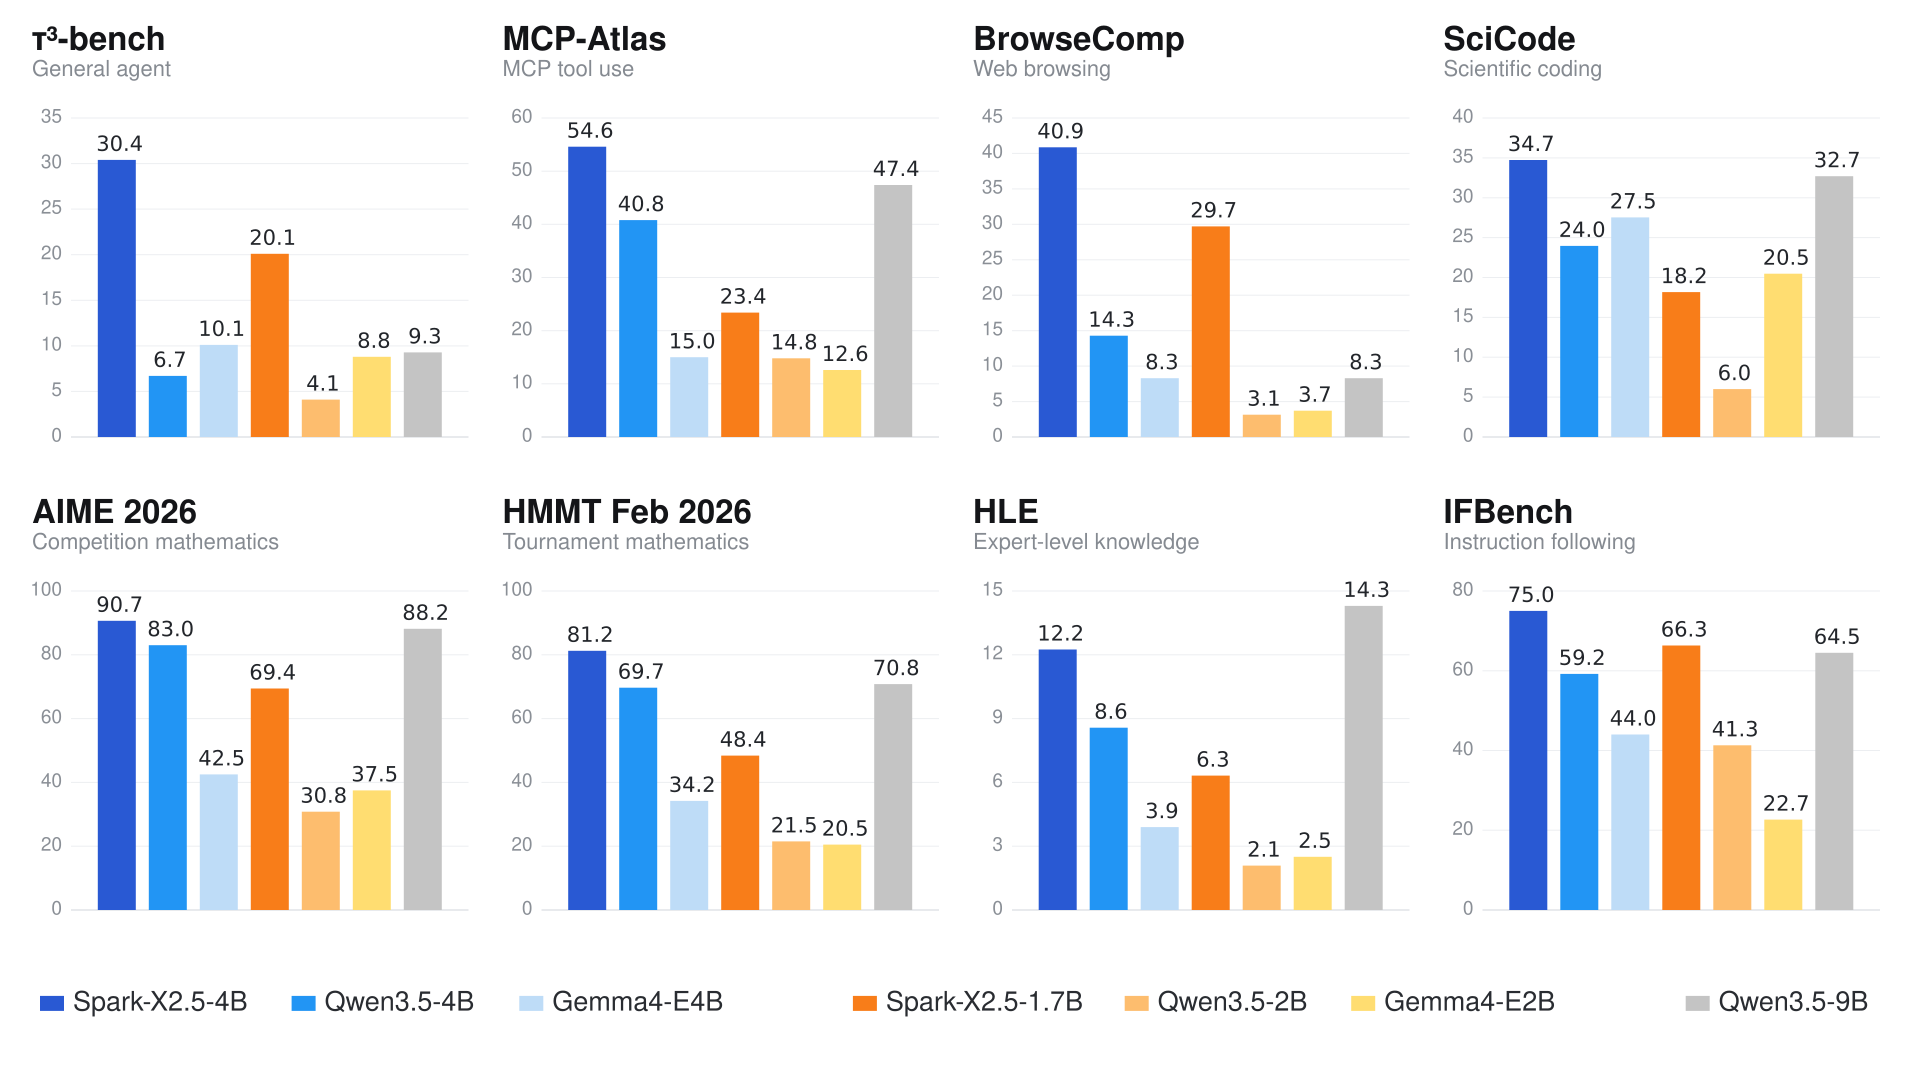
图2 Spark-X2.5 官方 benchmark 可视化图(对应官方 README 的 assets/benchmark.svg;来源:XHToken/Spark-X2.5 GitHub)
这张表能支持三个判断:
- Spark-X2.5 的卖点确实集中在 Agent、工具使用、浏览和代码,而不是只有闲聊;
- 4B 和 1.7B 之间存在明显能力差异,不能只看“都是小模型”;
- 官方结果是能力评测,不是你的部署吞吐量。它没有替你回答显存、并发、TTFT、每秒输出 token 和长上下文稳定性问题。
还要注意官方表中的 *:README 说明带星号的部分是来自公开模型卡或论文的结果。因此做正式横向对比时,仍应记录模型版本、推理框架、采样参数和评测来源,不能把表格当成完全同条件的独立复现实验。
常见坑与容易误解的地方
1. 1M context 不等于 1M context 随便跑
长上下文会明显增加内存和延迟压力。建议先用 32K 或 128K 验证服务,再根据显存、KV cache 和并发逐步提高。
2. thinking 默认开启,会让简单请求变慢
短问答、结构化抽取和简单分类可以关闭 thinking;复杂规划和代码任务不要一开始就关闭,应该用你的真实任务测效果。
3. SGLang 的 tool parser 不能漏
如果要做工具调用,优先使用官方示例中的 --tool-call-parser spark25。没有正确解析器时,模型可能把工具调用写成普通文本,业务层就无法可靠执行。
4. vLLM 不是安装后就一定能跑
官方路径要求额外安装 Spark-plugin,还使用 --trust-remote-code 和 Spark 专用 chat template。少掉其中任意一项,都可能出现模型加载或输出格式问题。
5. GGUF 不代表已经低比特量化
官方公开的 GGUF 模型卡描述为 BF16 GGUF conversion。下载前看具体文件和量化标签,不要只根据“GGUF”估算显存。
6. Base 模型不是普通聊天模型的替代品
如果你的目标是聊天、代码助手或 Agent,优先从后训练模型开始;Base 版本更适合继续训练和研究实验。
7. 本地模型仓库名和 MaaS model ID 不能混用
本地调用使用 spark2.5 或具体本地服务名,MaaS 则使用平台控制台给出的 model ID。不要因为名字相似就直接复制。
8. 端口能访问,不等于 Agent 已经安全
生产环境至少需要反向代理鉴权、请求限流、工具白名单、参数 schema 校验、超时、日志和人工确认策略。尤其不要把一个带文件写入、命令执行或消息发送能力的工具直接暴露给模型。
适合什么,不适合什么
适合
- 本地代码助手和轻量级编程 Agent;
- 需要私有化、低成本、可控数据边界的内部工具;
- 低并发的知识问答、文本处理和结构化抽取;
- 需要工具调用但不想部署几十亿到数百亿参数模型的原型项目;
- Apple Silicon、NVIDIA GPU 或 CPU 环境中的多后端实验。
不适合
- 直接替代大参数模型处理所有复杂开放域任务;
- 把 1M context 当作低内存设备的默认配置;
- 没有外层校验就让模型自动执行高风险工具;
- 需要视觉输入、图片理解或视频理解的任务——当前公开模型卡的定位是 Text Generation;
- 需要高并发、严格 SLA 和稳定吞吐,却没有做真实硬件压测的生产服务。
如果是我,我会怎么上这个项目
我会按五个阶段推进:
1.7B / 4B 单轮冒烟
        ↓
OpenAI-compatible API
        ↓
真实业务 prompt 与长上下文
        ↓
工具调用 + schema/权限/日志
        ↓
并发、故障恢复、目标硬件压测
具体选择上:
- 先用 4B + SGLang 验证任务质量和工具调用格式;
- 再用 1.7B 测试简单任务能否降本和提速;
- 对桌面端或低门槛用户,额外准备 GGUF + llama.cpp;
- 如果业务不想维护 GPU,就把同一套 OpenAI 客户端切到 MaaS;
- 最后才决定要不要做微调、量化或端侧编译。
不要一上来就测“最大上下文”和“最高并发”。对于 Agent,真正影响体验的往往是:工具调用是否格式稳定、失败后能否恢复、模型是否会重复调用工具,以及真实业务输入变长后延迟如何变化。
总结
Spark-X2.5 的价值可以概括成一句话:
它试图把“小参数模型的可部署性”和“Agent 所需的代码、推理、工具调用能力”放到同一条工程链路里。
从 1.7B/4B 模型,到混合注意力和 1M 上下文,再到 SGLang、vLLM、llama.cpp、MLX、Ollama、LM Studio 与 MaaS 接入,Spark-X2.5 更像一个可被不同运行时承载的开放模型系列,而不是只在网页聊天框里体验的单一产品。
但它最终是否适合你的项目,不能只看 benchmark。最可靠的判断方式仍然是:用你的 prompt、你的工具 schema、你的上下文长度、你的硬件和你的并发量,完整跑一遍真实链路。