
AeroGS:面向无位姿动态无人机场景重建的尺度感知高斯泼溅
🚀引言
如何从单目视频中恢复动态三维场景,一直是三维视觉中的重要问题,也关系到虚拟现实、机器人感知和自主系统等应用。无人机拥有俯视视角和大范围的优势,也放大了单目重建的欠约束性:没有同步多视角或者激光雷达的时候,深度和几何就很容易出现歧义;行人的移动、车流的流动等等运动体在高空的画面里只占少量像素,而在低空近景则包含了更多细节的运动,形成了明显的尺度变化;另外低纹理区域、长基线、滚动快门和平台抖动也会让SfM/SLAM产生漂移甚至是失效。更重要的是,像素里的表观运动同时包含相机自运动与目标独立运动,如果两者被混淆,则错误的位姿会影响几何的学习,错误的几何又会反过来影响位姿估计。
现有的方法一般可以分成三类。第一种是无位姿高斯泼溅,它们能联合估计相机位姿和静态几何,但是默认了场景是刚性的,往往会把动态的目标当成异常点;第二种是动态重建的方法,这些方法能细致地表示形变,但是需要准确的SfM/SLAM位姿;第三种是动态SLAM,它能在线跟踪并分离出运动,但是通常依赖于短基线特征匹配或RGB-D或者其他传感器先验,在大尺度低纹理航拍上很难兼顾轨迹的稳健性和渲染的质量。因此,问题的关键在于能否从未知位姿的长序列无人机视频里,同时恢复相机轨迹、静态背景以及刚性和非刚性动态目标?
本文提出了AeroGS,用尺度感知时空锚点 S²A-Anchors作为基本表示,把相机自运动、目标运动和场景尺度显式的拆开来处理。本文的框架逐帧增量处理输入视频,在局部滑动窗口内联合优化轨迹和锚点表示并在所有的帧都处理完后做一次全局细化。其中静态锚点主要是给位姿估计提供了稳定的几何约束,而动态锚点则是在自监督三维流指导下的运动建模;并且锚点会随着空间尺度来改变其形变容量,使远距离粗尺度结构倾向于采用更平滑、轻量的形变建模,近处细尺度区域获得更强的运动表达能力,从而降低粗尺度过拟合风险。
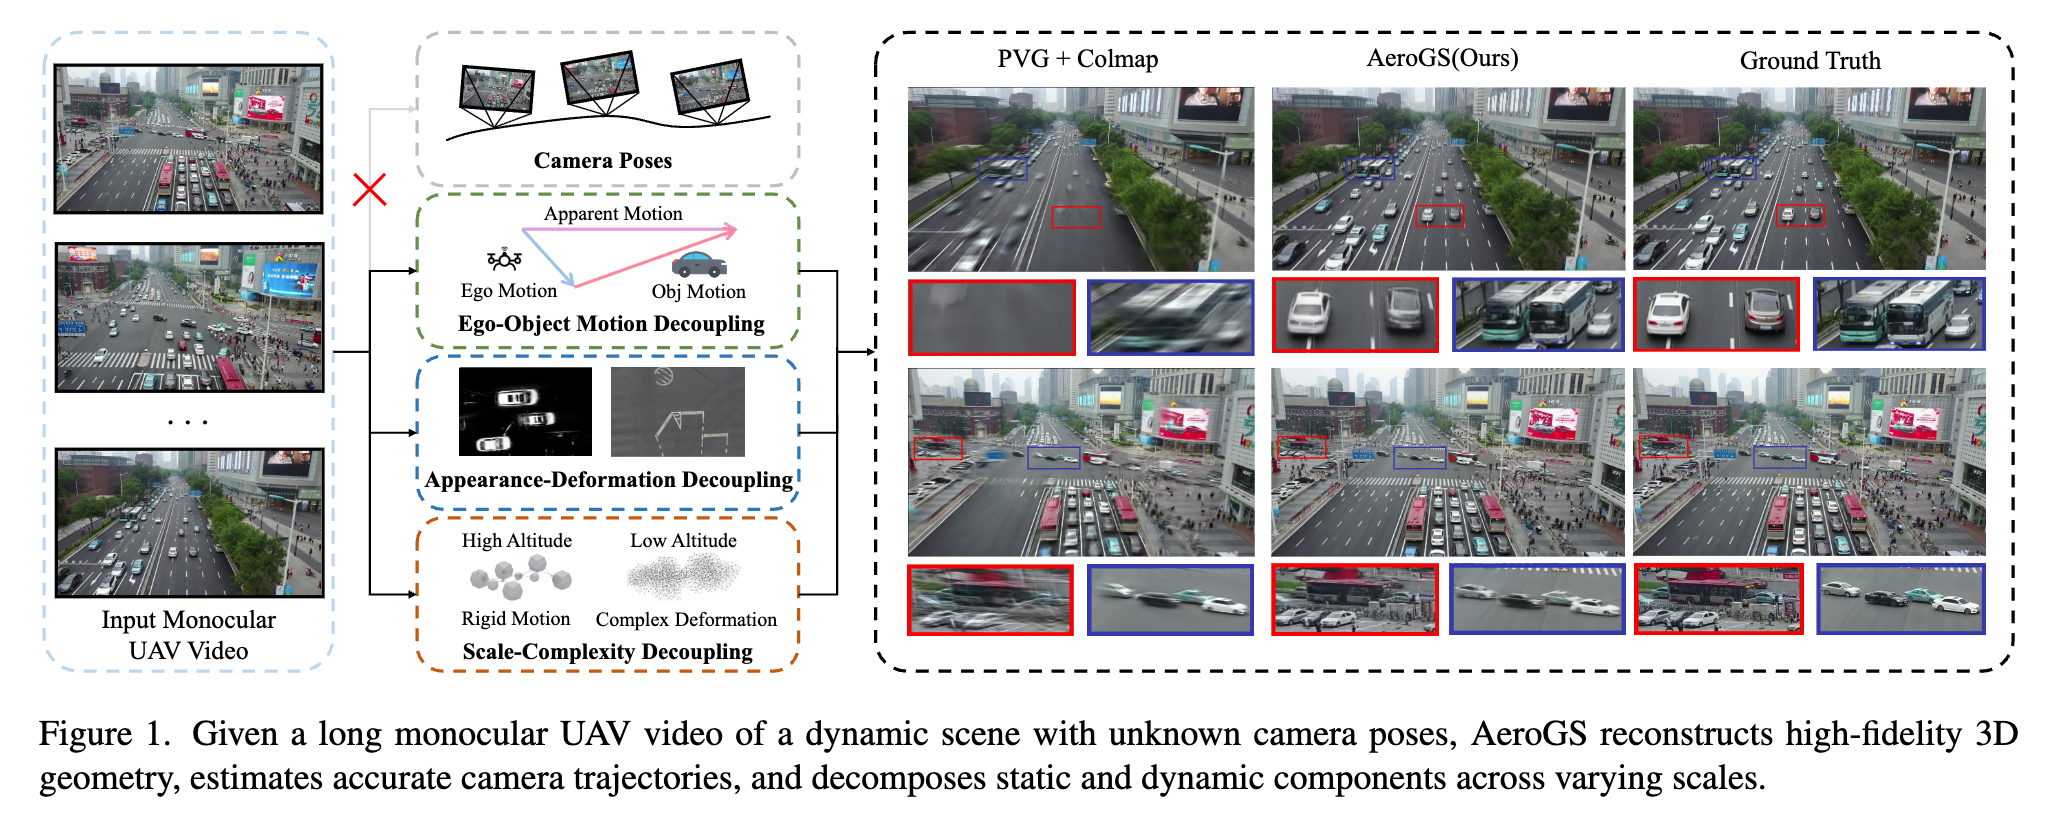
图 1 给定一段相机位姿未知的长单目无人机动态场景视频,AeroGS重建高保真三维几何、估计准确相机轨迹,并在不同尺度下分解静态与动态成分
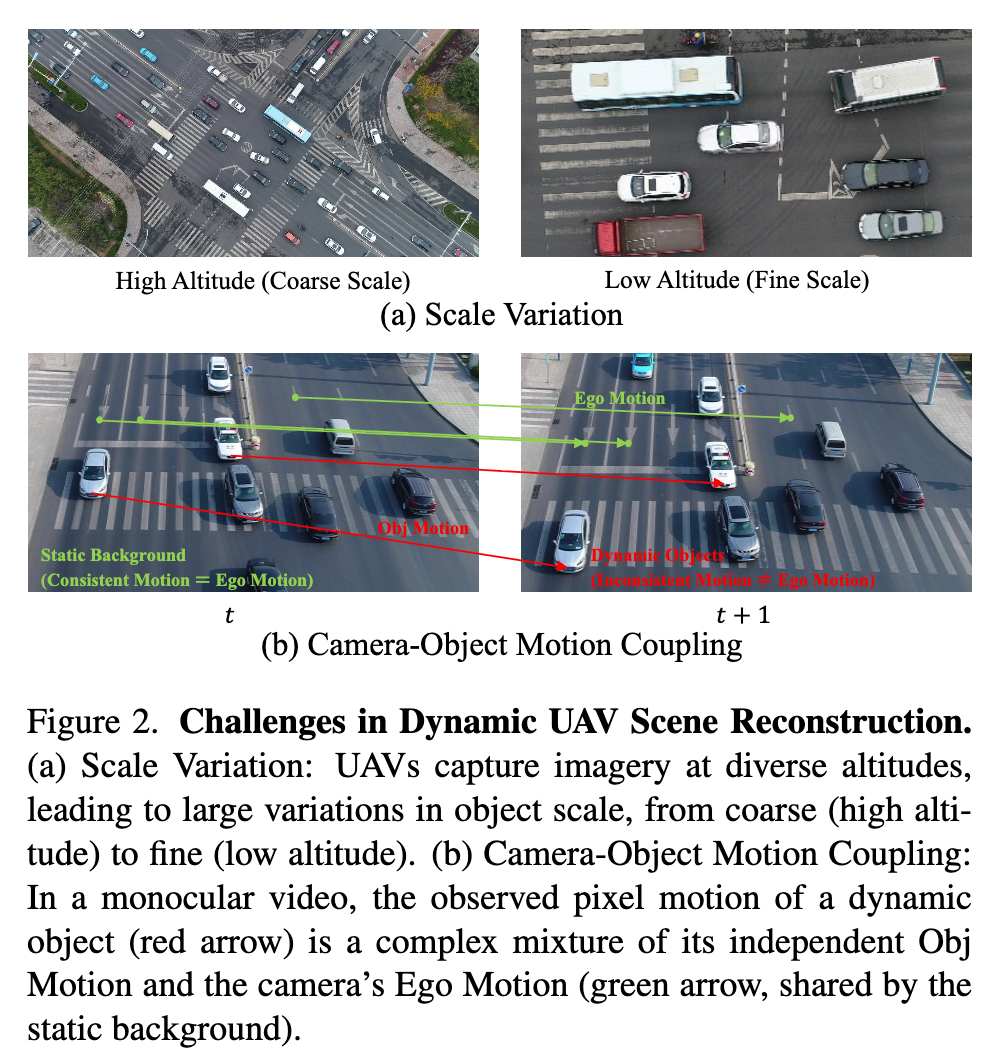
图 2 动态无人机场景重建的挑战:(a) 尺度变化,无人机在不同高度采集图像,使目标尺度从高空粗尺度到低空细尺度发生较大变化;(b) 相机与目标运动耦合,单目视频中动态目标的观测像素运动由其独立目标运动与相机自运动共同组成,其中相机自运动也由静态背景共享
本文主要围绕以下三方面展开:
**核心痛点:**未知位姿的单目无人机长视频中,相机运动和目标运动在图像平面上互相耦合;且由于飞行高度的变化使得小目标和近景目标跨越了多个尺度,在位姿估计、静态几何和动态形变之间很难在一个优化里稳定收敛;
**目前局限:**无位姿的方法一般都假定了静态场景,而动态方法则需要已知位姿,动态SLAM又较依赖传感器和短基线匹配。把现成的无位姿重建和4D重建简单串联起来并不能自动解决位姿——动态之间的相互污染问题;
解决路径:AeroGS在增量八叉树锚点上引入静态置信度和软梯度路由,分开监督相机位姿和目标运动;使用分层时空形变模块来分别学习外观和时间形变;最后用尺度条件控制和复杂度感知加密按照场景尺度和运动难度分配模型容量。
🔍核心创新
整个过程分为初始化、增量处理和全局细化三部分。初始化时使用MASt3R估计出前3帧的相机位姿,并利用点云和深度先验建立了八叉树锚点;对于之后每帧,首先通过PnP-RANSAC得到一个初步的位姿,然后做光度细化和锚点扩展并在可见性自适应的局部滑动窗口内联合优化场景和轨迹;当所有的帧都被处理完后进入最终细化阶段,对所有位姿和锚点进行全局优化从而减少累积漂移提高一致性。
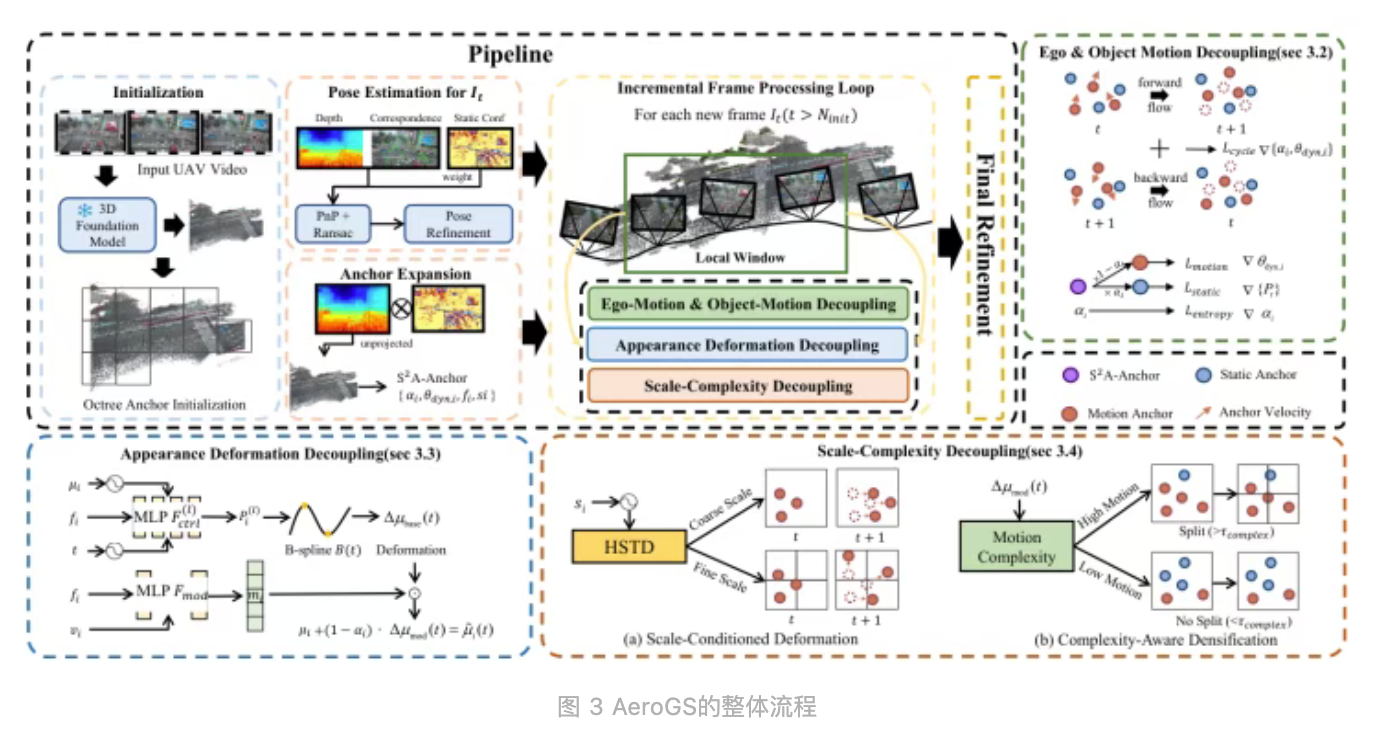
图 3 AeroGS的整体流程
1. 相机自运动与目标运动解耦
像素位移并不能直接说明是来自于相机还是物体。AeroGS给每一个 S²A-Anchor 都预测了一个静态置信度 αᵢ:具有较高置信度的锚点更有可能属于静态背景,而较低置信度的锚点更可能是动态区域。这个置信度是由轻量 Anchor Filter 根据规范特征、空间位置以及时间编码产生的并用熵正则来推动它形成更加清晰的静态/动态分配。
在优化的时候使用了软梯度路由,在相机位姿上,大部分梯度都来源于有较大 αᵢ 的静态锚点,这有助于减少运动目标对相机轨迹优化的干扰;动态锚点会利用前向——后向三维流的周期一致性来进行自监督以约束运动在相邻时间上的连贯性和将动态运动梯度从位姿变量中分离开来。相比于硬掩膜来说,这样的连续权重使得不确定区域可以在训练的过程中逐渐地被确定下来。
2. 外观与形变解耦
传统的动态表示很容易把静态外观和时间的变化混在一起同一特征里,导致形变噪音污染颜色和几何。AeroGS 将每个锚点的**时间不变规范特征 fᵢ 与时间形变 Δμᵢ (t) **分开:规范特征通过轻量解码器生成颜色、透明度、尺度和旋转等高斯属性,所有的关于时间的相关变化都是由形变场完成的。
为了表达复杂的非刚性运动,本文设计了分层时空形变模块 HSTD。它使用 B 样条作为时间基函数,并且在多个尺度上预测控制点然后插值得到基础形变;接着用锚点的速度先验来调制高频形变从而减少没有约束的形变过拟合风险。最后位置通过一个静态置信度门控得到:静态锚点基本上保持其规范位置,动态锚点则充分利用形变之后的位置,从表示层实现了静态和动态的分离。
3. 尺度与复杂度解耦
无人机从高空到低空拍摄的时候,同一个类别的目标像素尺度可能会相差很大。固定的容量的形变网络在粗尺度区域会很容易地把噪声拟合成非刚性运动,在细尺度区域又不能很好地表达局部形变。因此 AeroGS 把八叉树层级对应空间尺度编码输入 HSTD 控制点网络中,使得网络可以学习尺度相关的形变行为:粗尺度倾向于更加平滑、轻量的运动,细尺度允许更多的形变。
在同一尺度下,不同的区域运动也并不一样复杂。框架以时间形变方差定义运动复杂度,如果复杂度过高,则把父锚点分裂成 8 个子锚点,子锚点继承外观特征和静态置信度但是重新初始化动态参数用来学习更细的残差运动。尺度条件控制是从上至下的容量约束,复杂度加密则是从下至上资源分配,它们都让静态区域保持稀疏,让复杂运动区域拥有更高的分辨率。
最后的目标函数包括了静态重建损失、动态周期一致性损失以及静态置信度熵正则和动态锚点稀疏正则。它的作用并不是简单地添加一个损失项,而是让这三组解耦机制都在同一增量优化过程中各司其职——静态区域稳定轨迹,动态区域表达运动,尺度和复杂度决定了需要多少容量。
📊实验结果
AeroGS 采用面向单个输入序列的场景级增量优化,而不是统一的预训练—验证—测试流程。实验中使用的数据涵盖了无人机场景、车载动态场景和消融场景:VisDrone, UAVDT 被用来进行场景重建和新视角合成评估,KITTI Odometry 被用来进行轨迹精度和渲染质量评估,Au-air 被用来进行损失函数和核心模块消融。图像的质量主要是通过 PSNR、SSIM 和 LPIPS 来衡量,而轨迹精度则使用了 ATE 与 RPE 进行衡量。
其中对比的方法被分为了两类,第一种是一些需要外部相机位姿的动态重建方法(如 4DGS、Grid4D、Deform-GS、S3Gaussian、PVG、DeGauss、AD-GS 和 DeSiRe-GS),第二种是没有位姿或者联合位姿估计的方法( CF-3DGS , HT-3DGS , LongSplat )及 CF-3DGS+4DGS。这样的设置能够同时检验 AeroGS 的渲染质量、轨迹恢复能力以及在动态无人机场景中的综合稳定性。
1. 定量分析
定量分析主要回答两个问题:第一,在未知相机位姿的条件下,AeroGS 的重建和新视角合成质量是否能够超过依赖外部位姿的动态重建方法;第二,联合优化得到的相机轨迹是否足够准确,能否支撑后续动态场景渲染。
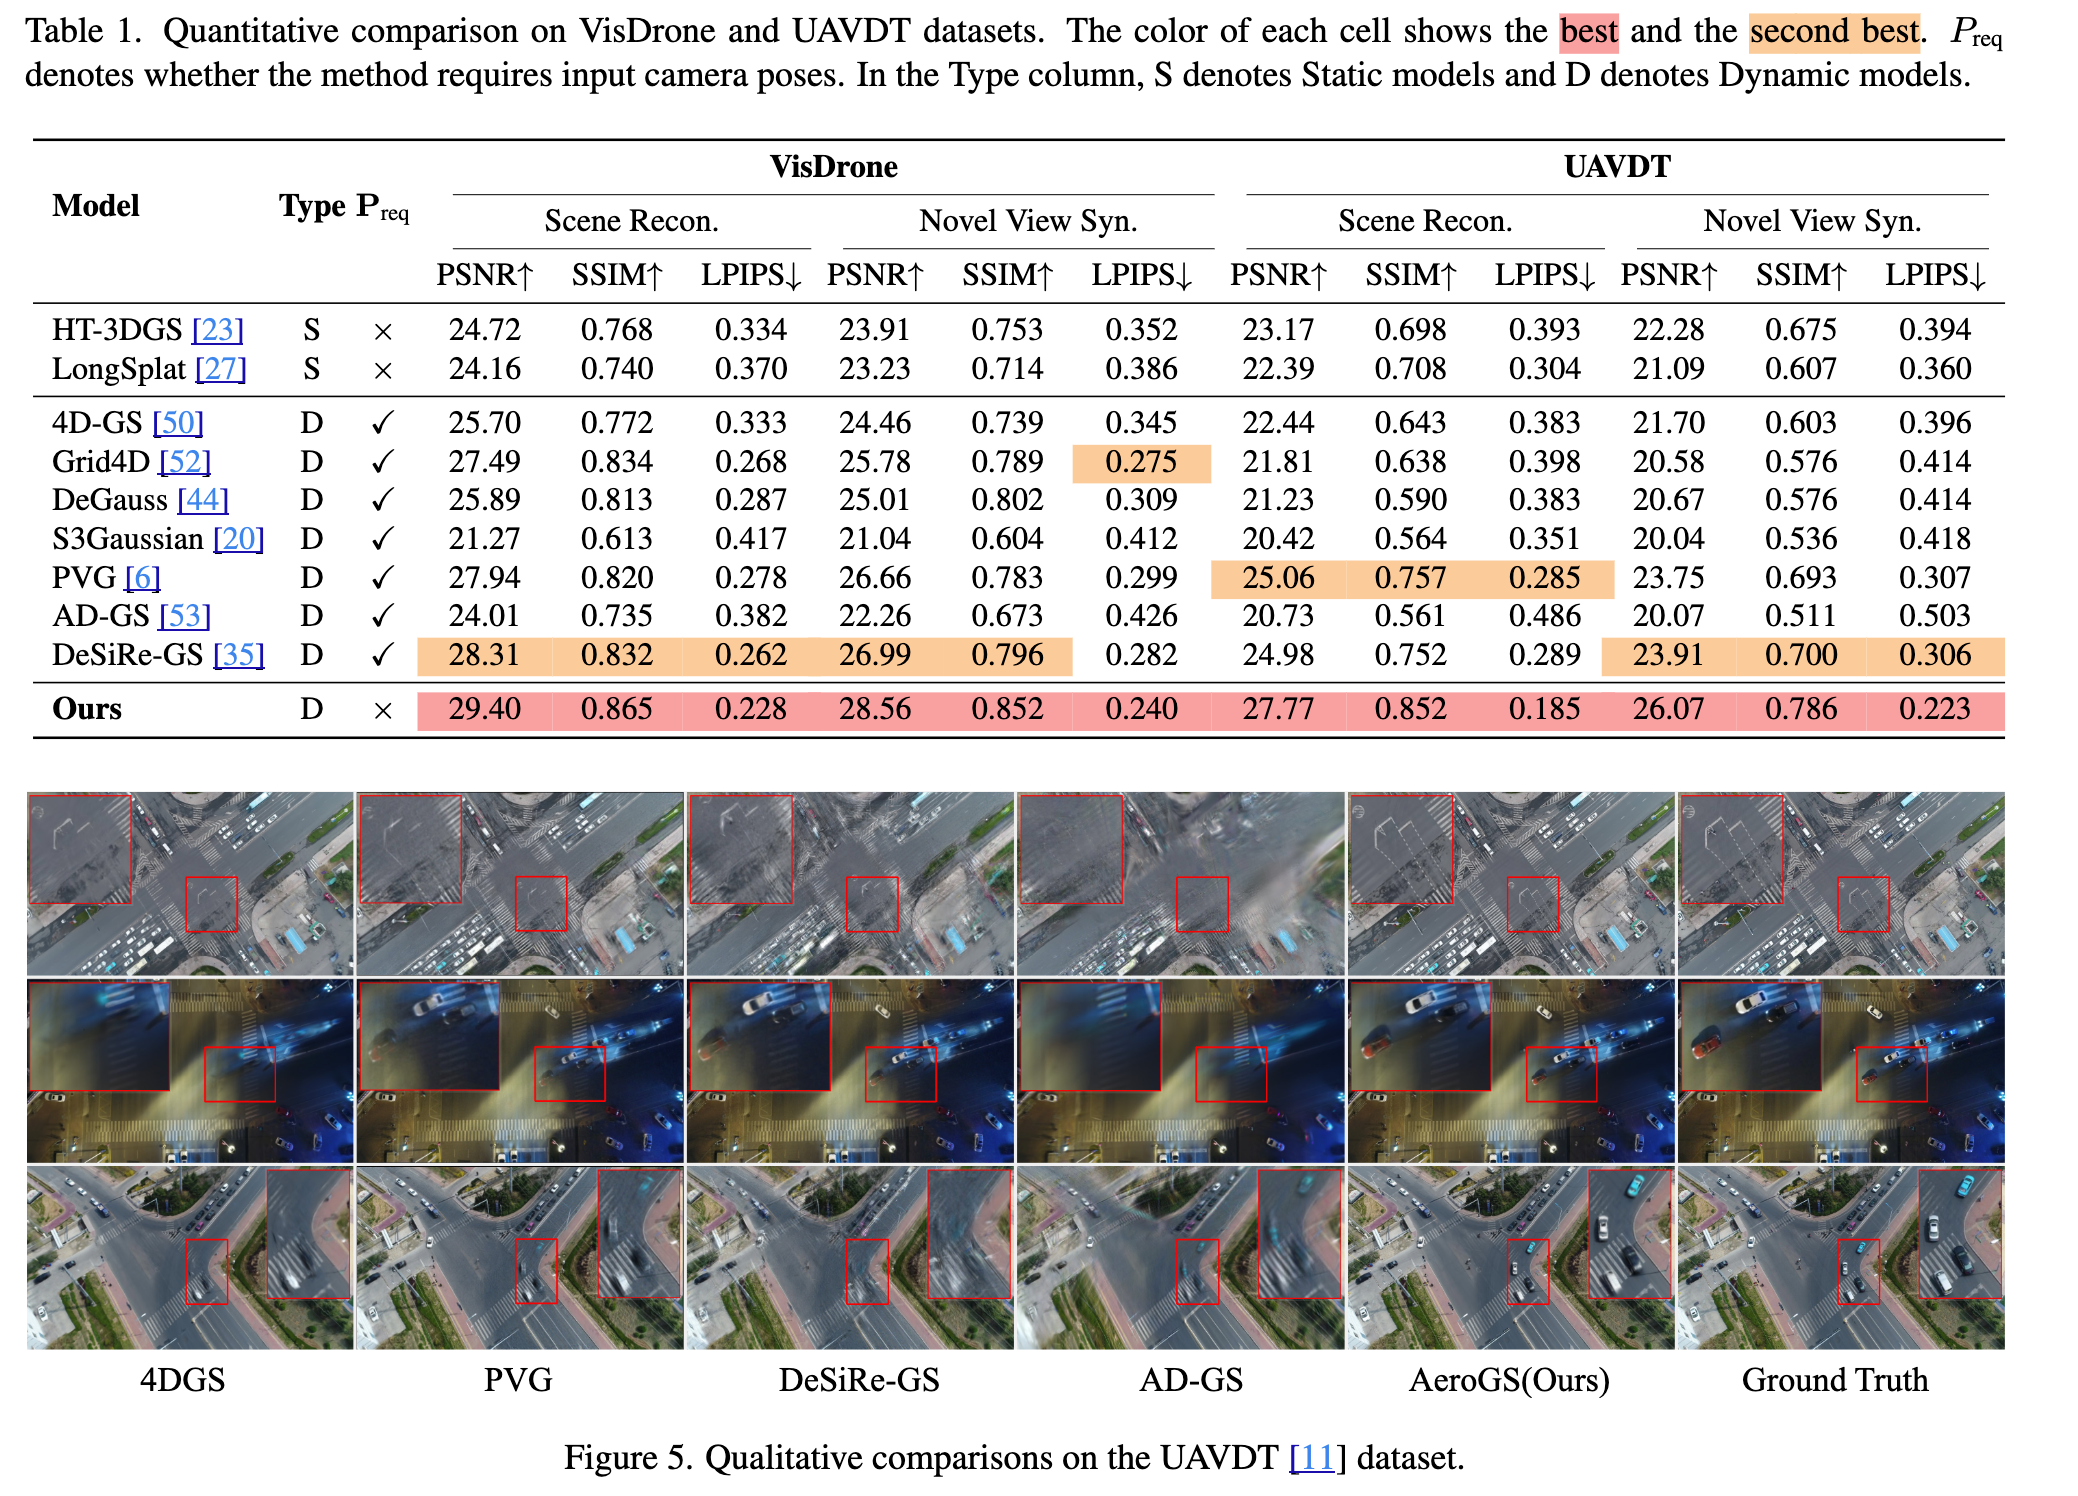
表 1 VisDrone和UAVDT数据集上的定量比较,单元格颜色表示最优和次优结果,P_req表示方法是否需要输入相机位姿,Type列中S表示静态模型,D表示动态模型
从表 1 中可以看出在没有输入相机位姿情况下 AeroGS 在 VisDrone 和 UAVDT 这两个无人机数据集中均获得了表内的最佳结果或者最具有竞争力的性能:在 VisDrone 场景重建中,AeroGS 的 PSNR 是 29.40dB 比 DeSiRe-GS 高了 1.09dB, SSIM 是 0.865 比 Grid4D 高了 0.031,LPIPS 是 0.228 比 DeSiRe-GS 降低了 0.034;在 VisDrone 新视角合成中,AeroGS 的 PSNR 相比于 DeSiRe-GS 提高了 1.57dB、LPIPS 相比于 Grid4D 降低了 0.035。
UAVDT 的尺度变化和动态目标更复杂,因此更能体现方法对尺度与运动耦合问题的处理能力。在 UAVDT 场景重建中,AeroGS 的 PSNR 达到 27.77 dB,比 PVG 高 2.71 dB;SSIM 为 0.852,比 PVG 高 0.095;LPIPS 为 0.185,比 PVG 低 0.100。在 UAVDT 新视角合成中,AeroGS 的 PSNR 为 26.07 dB,比 DeSiRe-GS 高 2.16 dB。结果说明,联合位姿—动态优化并不必然弱于外部位姿驱动的方法,关键在于能否有效分离相机自运动、目标运动和尺度变化带来的干扰。
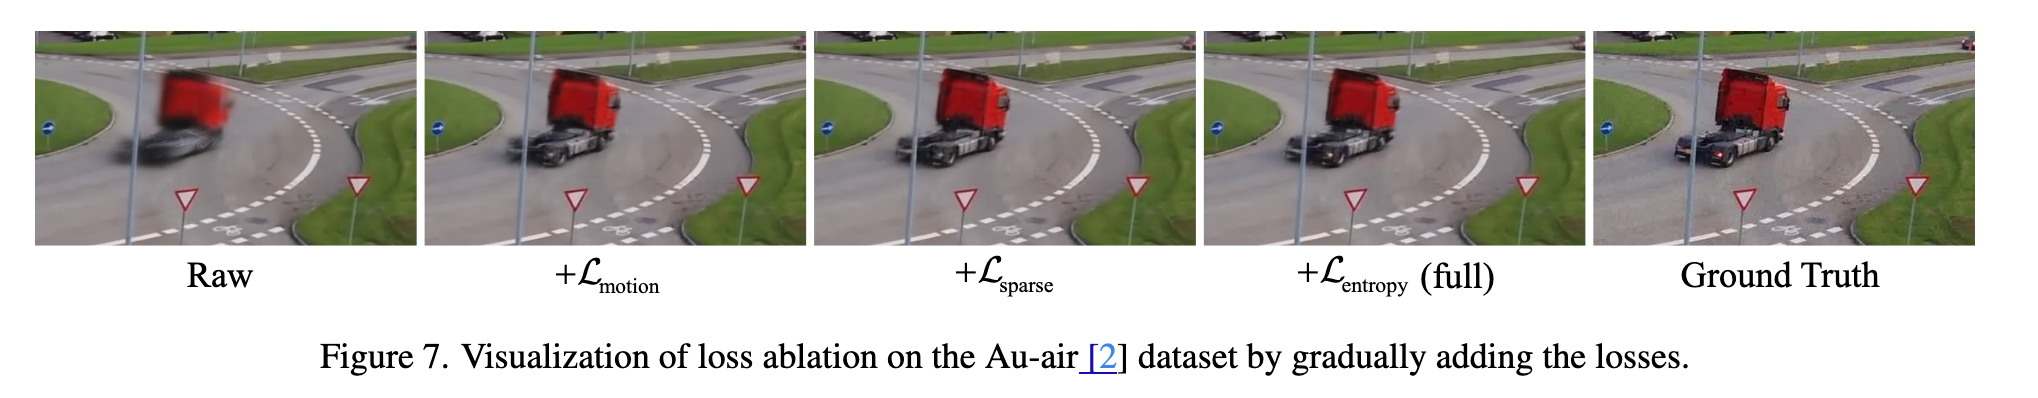
表 2 KITTI数据集上的定量评估
在 KITTI 动态驾驶序列上,AeroGS 同时表现出较好的渲染质量和轨迹恢复精度,取得 PSNR=26.10 dB、SSIM=0.878、LPIPS=0.139、RPE_t=0.143、RPE_r=0.292、ATE=0.006。相比 LongSplat, ATE 下降了约 57%,由 0.014 降到 0.006; RPE_t 下降了约 72%,由 0.512 降到 0.143 ; PSNR 提高 2.67dB。而简单的串联 CF-3DGS 的位姿估计和 4DGS 动态重建时,PSNR 只有 19.03 dB , Ate 上升到 0.060 ,说明将位姿估计和动态建模机械拼接不能代替面向耦合问题的统一优化。
2. 定性分析
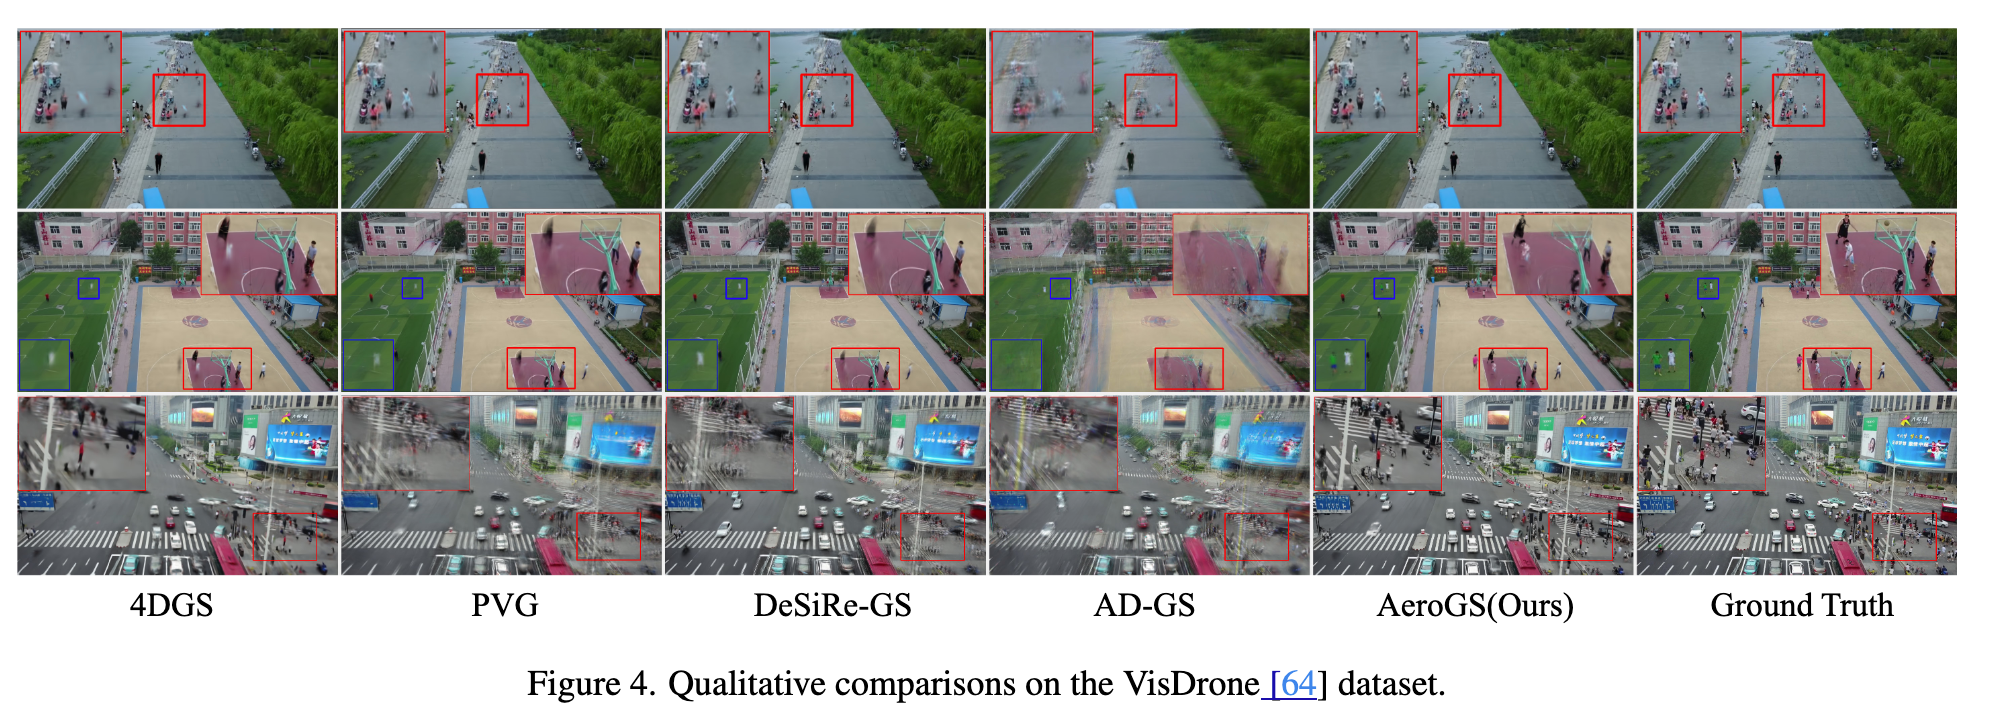
定性方面主要是通过视觉来观察重建细节、动态目标边界、背景稳定性及新视角下几何的一致性等。相比于单纯的数值指标来说,可视化的结果更能直观反映出方法是否真的减少动态目标残影、道路纹理拖影以及背景-前景之间互相污染等问题。
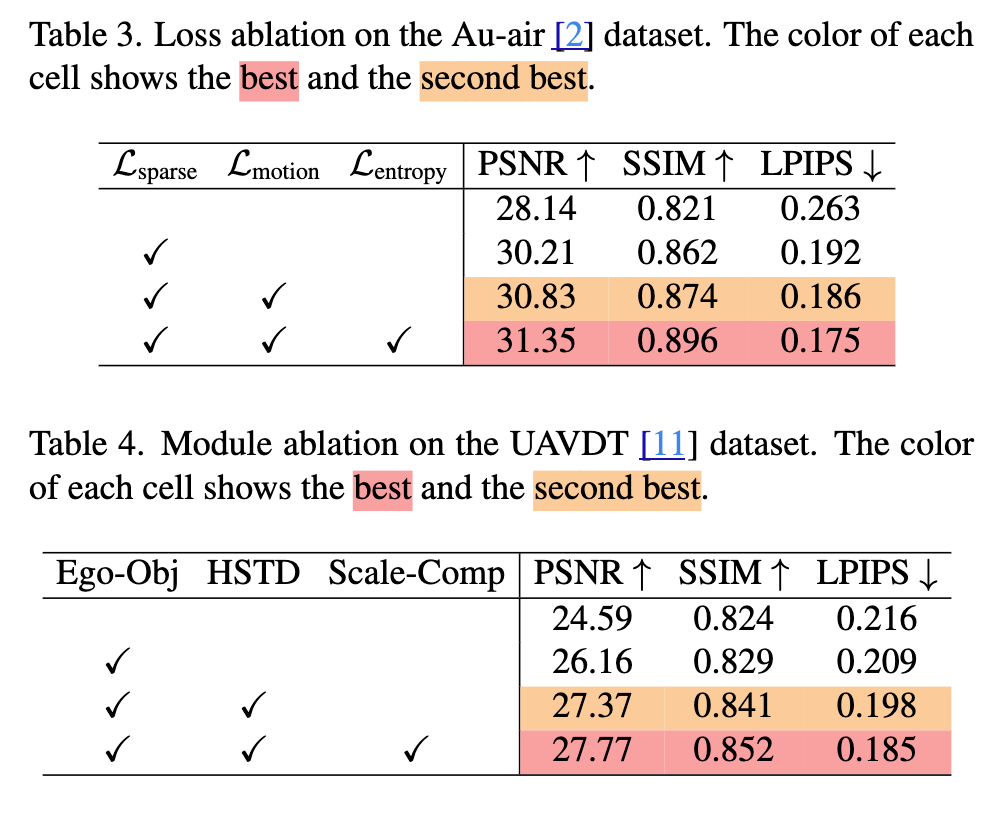
图 4 VisDrone数据集上的定性比较
在 VisDrone 数据集中,对比方法普遍存在着远距离行人的模糊问题、车辆边缘拖影以及道路和植被区域不稳定的结构;而 AeroGS 在小尺度运动目标边缘上表现更清晰,并且在大面积低纹理的道路和植被区域也有着更为稳定的背景几何,说明尺度条件形变和静态梯度路由可以缓解小目标运动与相机运动之间的混淆。
UAVDT 是高空交通场景数据集,对比方法在车辆轮廓、局部道路标线和阴影区域容易产生模糊或者重影现象,AeroGS 能够在红框中的放大区域保留更多的小目标结构并且背景与动态目标之间的污染更少,这也符合表 1 中 UAVDT 数据集上 PSNR, SSIM 和 LPIPS 提升的趋势。
新的视角合成的结果进一步表明 AeroGS 并非只在训练帧上取得较好外观拟合,其学习到的相机轨迹和动态表示能够支持未观测视角下更稳定的渲染。如图 6 所示,AeroGS 在路口、车辆和建筑边缘上的几何对齐更稳定,未观测视角下的结构连贯性更好。
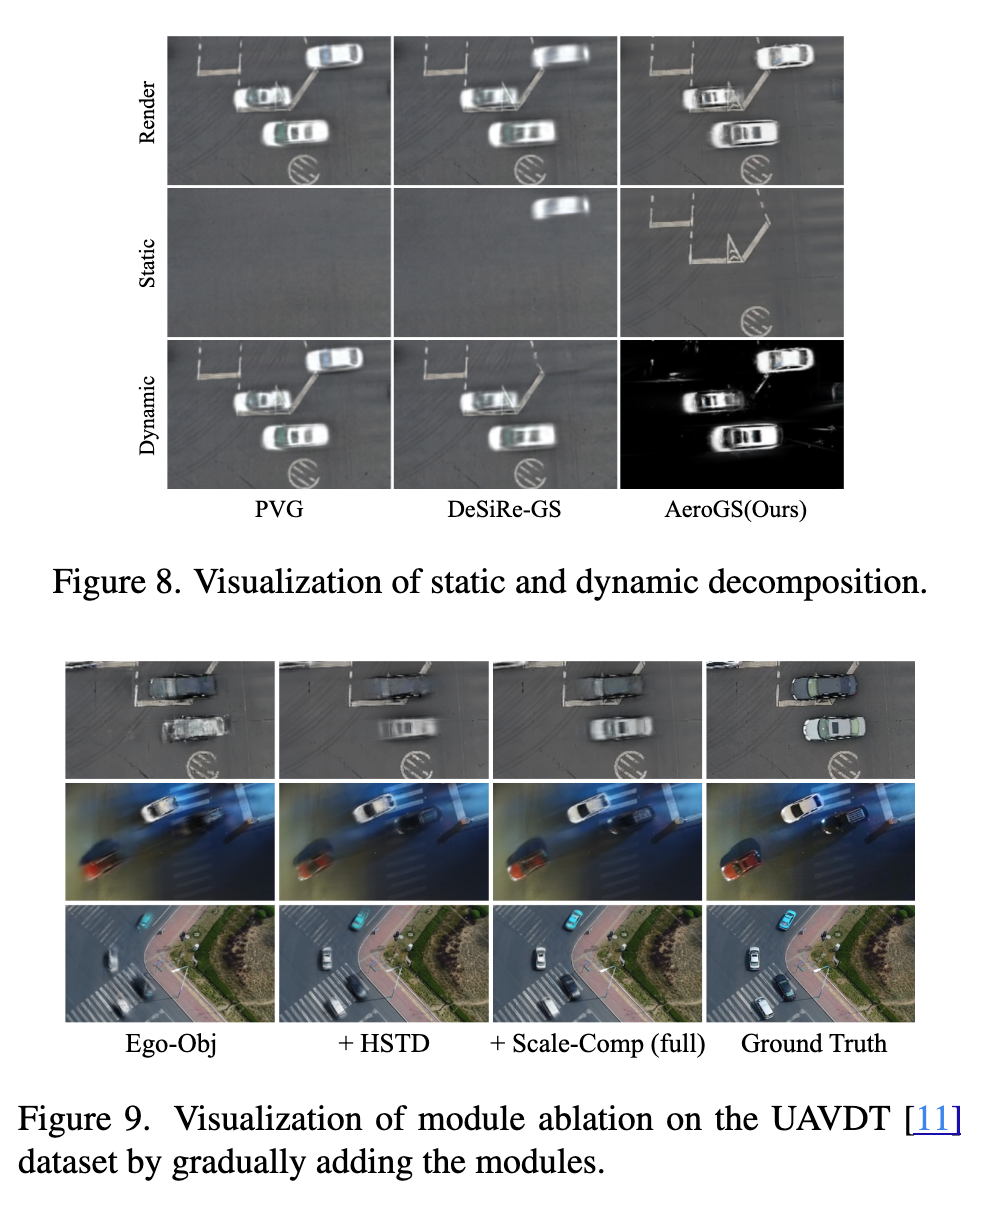
静态—动态分解可视化用于观察相机自运动与目标运动的解耦效果,在 PVG 和 DeSiRe-GS 中仍然可以看到车辆残影在静态层,并且有停车线等静态结构出现在动态层之中,而在 AeroGS 静态层主要是背景结构,动态层集中在运动汽车上。这说明静态置信度和软梯度路由可以减少动态内容对于位姿估计和背景几何的污染。
3. 核心模块消融实验与复杂度分析
核心模块消融用来检验每一个设计是否真的带来了性能上的提高。这里主要包括两种类型的实验,一种是损失函数消融来分析运动周期一致性、静态置信度熵正则和动态锚点稀疏正则的作用,另一种则是模块消融来分析相机自运动—目标运动解耦、HSTD 分层时空形变模块以及尺度—复杂度解耦模块的递进作用。
从损失函数消融的结果中可以发现,在逐渐添加各个约束后,模型的表现越来越好;PSNR 从基本设置时的 28.14 增加到了完整的损失下 31.35, SSIM 从 0.821 增加到了 0.896,LPIPS 从 0.263 减少到了 0.175; 运动周期的一致性给动态锚点带来了时间上的连续性约束、熵正则使得 Anchor Filter 更有明确地做出静态和动态的判断、稀疏正则能够防止太多锚点被误判为动态区域导致过拟合的风险。在图 7 中可以看到目标轮廓随着约束的加入变得越来越完整清晰,并且这也符合定量指标的变化情况。
模块消融进一步说明三组机制之间的递进和互补的关系:从没有解耦的基本设置开始 PSNR 是 24.59dB; 加入相机自运动—目标运动解耦之后,PSNR 提高到了 26.16dB, 继续加入 HSTD 的时候,PSNR 提高到 27.37dB, 最终加入完整的尺度—复杂度解耦的时候,PSNR 到达 27.77dB, SSIM 达到 0.852,LPIPS 降低到 0.185。如图 9 所示,在单独使用运动解耦的情况下,车辆轮廓仍然是比较模糊的,加入了 HSTD 后几何细节得到了改善,而尺度—复杂度模块则继续加强了对小目标、局部复杂运动的表达能力。
从复杂度的角度来看,AeroGS的主要计算开销来自于增量锚点优化、可见性自适应局部滑动窗口、HSTD多尺度控制点预测以及最后的全局细化。而尺度条件控制和复杂度感知加密,并不是简单的增加模型容量,而是根据空间尺度和运动复杂度来分配资源,在粗尺度上更加平滑且更轻量地表达形变,在细尺度和高运动复杂度的地方通过锚点分裂得到更强的残差运动建模的能力;所以这种策略不仅提升了细节表达,还尽量避免了静态区域和粗尺度区域的冗余计算。
🌟结论
AeroGS针对无位姿单目无人机动态场景重建最难处理的三种耦合关系,提出了一个统一的尺度感知高斯泼溅框架。S²A-Anchors用静态置信度来连接位姿优化和动态建模,HSTD把规范外观和时间形变分开,而尺度条件控制和复杂度感知加密则是根据场景难度分配表示容量。实验结果表明,该方法在VisDrone、UAVDT和KITTI评估中取得了更优或有竞争力的重建质量、感知指标和轨迹误差;消融实验与静态—动态可视化也支持了各模块的有效性。
📢实际应用与意义
直接价值:减少对外部相机位姿和额外传感器的依赖,在低纹理、有动态干扰条件下实现对无人机长航迹视频进行轨迹恢复以及动态三维重建一体化解决方案。
应用前景:可以为低空交通观测、城市道路建模、无人机巡检、灾害航拍、施工记录和生态监测等提供方法参考,尤其是对于只有单目视频且没有可靠的位姿的情况。
目前局限:论文明确指出,该方法假定运动是相对平滑的,在极高速动态或者高度拥挤的情况下可能会有性能上的下降;高斯泼溅的计算开销仍然很大,这会限制其在实时处理和超大规模中的使用。未来的研究还需要对快速运动建模、遮挡与重现、在线优化效率及长时间序列的内存与计算进行更多的考虑。