
Robot到底记住了什么?——MEMOBench为什么要把机器人Memory拆开来测
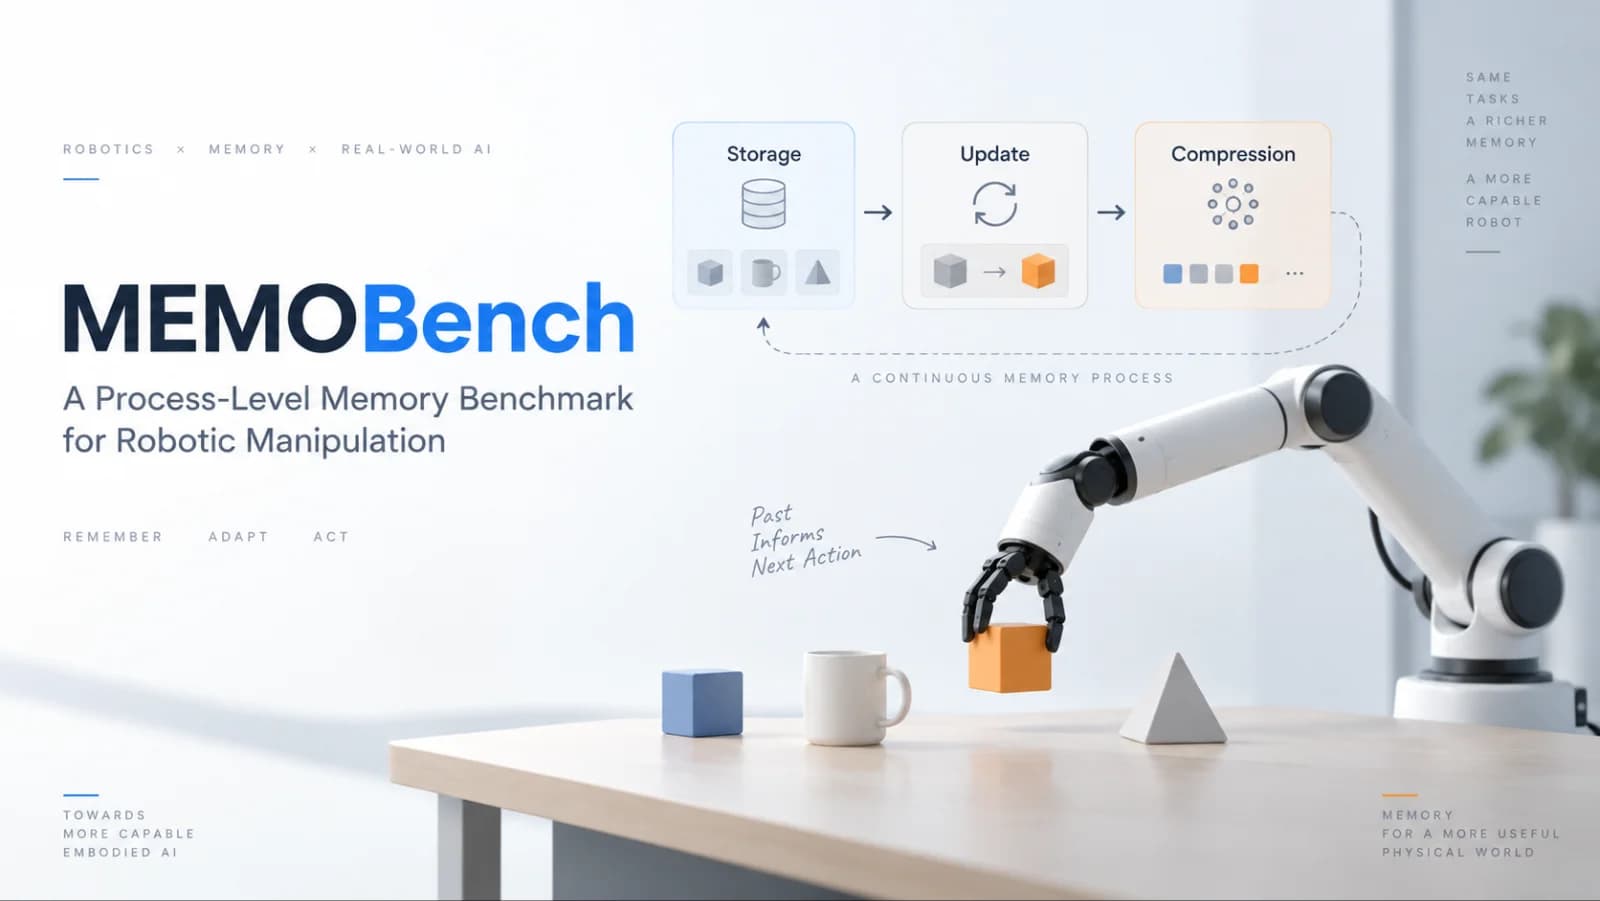
如果最近在看 VLA、long-horizon manipulation 或者带 memory module 的机器人工作,会发现一个挺有意思的问题:现在很多模型都开始说自己“有记忆”了,但我们其实很难判断它到底记住了什么。
一个机器人把杯子放错地方,最后任务失败,我们通常只能得到一个非常简单的结果:
***Success = 0***
但这个 0 到底意味着什么?
可能机器人压根没有记住杯子原来在哪里;也可能它一开始记住了,但后来环境变化以后没有更新;也可能它记住了前面十几步发生过什么,却没办法把这些历史信息压缩成一个对当前动作有用的状态;甚至还有一种可能——模型其实什么都记对了,只是最后抓取的时候手滑了一下。
这几种失败,在传统 benchmark 里最后往往都会变成同一个结果:
**任务失败**
而 MEMOBench 这篇工作的核心,其实就是觉得这件事情不太合理。
它不是在问:
“机器人有没有 Memory?”
而是在问一个更细的问题:
机器人在执行任务的过程中,Memory 到底在哪一步出了问题?
这也是我觉得这篇论文最值得看的地方。
现在很多 VLA,本质上仍然非常接近这样一个过程:
也就是看到当前 observation,再看一下语言指令,然后预测下一步 action。
只要当前画面本身包含足够信息,这种方法其实很好用。
比如桌面上摆着一个红杯子,指令是“抓起红杯子”,机器人完全不需要记住十秒钟以前发生了什么,它看现在这一帧就够了。
但现实中的很多任务不是这样。
比如机器人先看到:
番茄放进了上层抽屉。
然后抽屉关上。
过了一会儿指令让机器人:
把刚才的番茄拿出来。
这时候当前画面里已经看不见番茄了。
机器人必须依赖:
而不是只依赖:
同样,如果炉子刚刚打开,过了一段时间又被关闭,那么机器人不能一直记着:
stove = on。
它必须把旧状态修改成:
stove = off。
再比如让机器人观察一个操作:
先把 A 移开,把 B 放进去,再把 A 放回来。
之后要求它复现。
这时候问题又不只是记住一个物体的位置,而是需要把一整段 history 变成某种可以执行的 procedure。
从这个角度来说,所谓机器人 Memory 并不是一个东西。
MEMOBench 做的第一件事,就是先把“记忆”拆成两层来看。
第一层比较直观:机器人到底在记什么。
论文沿用了现在机器人 memory benchmark 里比较常见的划分,把任务分成 Temporal、Spatial、Object 和 Procedural 四类。Temporal Memory 主要关心事件顺序、次数和状态变化;Spatial Memory 是记东西在哪里;Object Memory 是记“刚才说的那个东西到底是哪一个”;Procedural Memory 则是记一段动作模式或者操作流程。
这一层其实不算特别新。
像 RoboMME、MIKASA-Robo、RoboMemArena 等工作已经开始从不同维度研究机器人记忆。MEMOBench 自己也承认,它不是第一个提出 memory-dependent manipulation 的 benchmark。
它真正比较特别的是第二层:
不是只问“记的是什么”,而是问“Memory 正在做什么操作”。
作者把 memory operation 分成了三个阶段:
Storage、Update 和 Compression。
Storage 很容易理解。
机器人第一次看到:
番茄在上层抽屉。
那么 memory 就经历:
也就是原本不知道,现在把这条信息存进去。
但存进去只是最简单的一步。
如果过一会儿番茄从上层抽屉被移动到了下层抽屉,那么正确的 memory 不应该变成:
上层有番茄,下层也有番茄。
而应该经历:
把旧状态更新成新状态。
这就是 Update。
第三种 Compression 更有意思。
假设机器人刚刚经历了:
打开抽屉
拿出苹果
把杯子放进去
关上抽屉
再把苹果放到桌子上
如果每执行一个动作就无脑保存整段 RGB history,那么所谓“Memory”很快就会变成一个越来越大的视频缓存。
但真正有用的记忆,通常应该逐渐变成类似:
杯子现在在抽屉里,苹果在桌上。
也就是说,过去的大量 observation 被压缩成一个更紧凑、和任务相关的状态:
MEMOBench 把这个过程叫做 Compression。
这个划分看起来很朴素,但其实一下把问题变得清楚了很多。
因为以前我们说:
“这个模型 memory 不好。”
这句话信息量其实很低。
MEMOBench 希望以后能够说得更具体:
这个模型 Storage 很好,但是 Update 很差。
或者:
它能记住单个 referent,但历史一长以后 Compression 崩掉。
我觉得这是这篇论文最大的价值。
它把原来一个非常模糊的模型能力,拆成了几个至少可以被实验区分的 failure mode。
为此,作者没有只重新设计任务,而是在任务过程中插入了大量 Memory Checkpoint。
MEMOBench 一共有 30 个 history-dependent manipulation tasks,建立在 LIBERO/robosuite 上,每个任务有 50 条 expert demonstration,总共 1,500 条 demonstration,涉及 29 类 object 和 5 类 fixture。平均 trajectory 长度大约 618 个 control step,最长达到 2,012 step。
但真正关键的不是这 1,500 条 trajectory,而是里面额外标出的 84 类 checkpoint template。
展开到所有 demonstration 后,一共有:
4,200 个 process-level checkpoint。
其中默认粒度下包括 1,750 个 Storage、1,600 个 Update,以及 850 个 Compression instance。
每个 checkpoint 不只是简单写一句“这里应该记一下”。
它包含三样东西。
首先是一个语言描述,例如很简单的:
put tomato in
也可以逐渐变成更具体的:
put the tomato into the top drawer of the cabinet。
其次,它会告诉 benchmark:
这一步属于 Storage、Update 还是 Compression。
第三,也是最重要的,是它有一个可以直接在 simulator 里验证的 predicate。
所以 MEMOBench 并不需要打开模型脑子,看 Transformer hidden state 里到底存了什么。
它采用的是一种更加行为主义的评价方式:
如果你真的记住了正确的信息,那么到了这个 checkpoint,你应该能够让环境满足相应条件。
比如任务要求机器人记住 tomato 在 top drawer,那么后面发生 retrieval 时,机器人是不是最终去了正确的 drawer,可以直接从 simulator state 判断。
这是一个很聪明的设计,因为“Memory”本身其实非常难定义。
不同模型可能完全不一样。
有的模型保存历史图像;
有的保存 feature token;
有的做 recurrent hidden state;
有的做 text summary;
有的可能什么显式 memory module 都没有,只是 Transformer context 足够长。
MEMOBench 并不要求这些模型内部结构统一。
它只问:
在需要使用某条历史信息的时候,你有没有表现得像是正确保存、更新或者压缩了它?
于是除了传统的 Task Success Rate,也就是 SR 之外,MEMOBench 又定义了三个指标:
Memory Storage Rate,MSR;
Memory Update Rate,MUR;
Memory Compression Rate,MCR。
形式上其实非常简单。
对于某一种 operation,把所有对应 checkpoint 拿出来,看机器人满足了多少个 predicate:
当
时就是 MSR,Update 对应 MUR,Compression 对应 MCR。
但这三个数和 SR 放在一起之后,解释能力就完全不一样了。
比如:
SR 低,MSR 也低。
那很可能模型从一开始就没记住。
如果:
SR 低,但 MSR 很高,MUR 很低。
那问题可能不是不会记,而是:
记住以后不会改。
如果:
MSR、MUR 都不错,但最终 SR 仍然很低,
那么我们就要开始怀疑:
memory 已经完成了它的工作,但 perception、planning 或 manipulation execution 本身可能是瓶颈。
这就是论文标题里所谓的:
Process Level Memory Benchmark。
它想看的不是最后有没有做成,而是任务执行过程中 memory 状态到底在哪一步开始脱轨。
这听起来像一个 benchmark 设计上的小改动,但实验结果实际上挺有意思。
作者测试了 π0、π0.5、OpenVLA-OFT,也测试了明确为 memory 设计的 MemoryVLA、HiF-VLA,以及给 跑π0.5 接上 RoboMME memory module 的版本。所有主要模型都在 MEMOBench 上 fine-tune。
同时,他们还故意改变 action replanning frequency。
模型每次会预测 50 个 action,但不一定一次执行完。
实验分别执行:
5、20、35 或 50 个 action,
然后再重新观察环境、重新规划。
这个设计其实也很重要。
因为机器人 Memory 不只是“记得久不久”,它和闭环控制的频率也耦合。
如果每 5 step 就重新看一次世界,很多错误可能还有机会被 correction。
如果一次开环执行 50 step,之前一个很小的 stale memory 或 control error 都可能被不断放大。
最终最强的普通 memory-module baseline,是:
在 replan step = 5 时,平均成功率也只有:
31.9%。
标准 π0.5 是:
30.4%。
也就是说,加了一个 memory module,并没有让最终 task success 突然发生质变。
表面上看,这甚至可能让人觉得:
“那 Memory Module 好像也没什么用。”
但一旦把 process metric 展开,事情就有意思了。
以 step = 5 的 (\pi_{0.5}) 为例。
它在 Temporal Memory 任务上的最终 SR 只有:
2.2%。
非常差。
但是它的 Temporal MSR,也就是 Storage,却有:
67.6%。
MUR 只有:
18.4%。
MCR 更只有:
2.0%。
换句话说,这个模型并不是完全“没有 Memory”。
相反:
它经常能把第一件事记下来。
真正的问题是:
后面的世界已经变了,它脑子里的那条信息没有跟着变。
这可能是整篇 MEMOBench 最值得记住的发现。
作者专门分析了一个 stove task。
这个任务里机器人需要处理炉子的状态变化。
总共 150 次 rollout,最后只有 10 次真正完成。
140 次失败里,有 36 次一开始 Storage 就失败了。
但更大的失败来源是:
63 次在第一次 state update 后还保留 stale memory。
另外还有 41 次虽然走到了更晚的 checkpoint,但依然在使用过期状态。
这个例子非常形象。
机器人可能完全记得:
“炉子开着。”
问题在于后来有人把炉子关了。
它还是坚定地记得:
“炉子开着。”
所以所谓更好的机器人 memory,未来可能并不是:
给 Transformer 再塞更多历史帧。
而是:
什么时候应该相信旧记忆,什么时候必须把旧记忆覆盖掉。
这一点我觉得特别重要。
因为现在很多所谓 memory augmentation,最直接的方法其实就是扩大 history window。
比如保留最近 32 帧、64 帧,把视觉 feature 全放到 context 里。
但从 MEMOBench 的结果来看,“历史越多”并不能直接解决问题。
真正困难的是:
What is still valid?
也就是:
历史信息里哪些现在依然是真的?
这已经开始接近 world state estimation,而不仅仅是 sequence modeling。
Spatial Memory 的结果甚至更夸张。
标准 π0.5在 step = 5 时 Spatial SR 是:
0%。
Spatial MUR 只有:
0.3%。
也就是说,一旦空间位置发生变化、物体被放进抽屉、遮挡或者重新组织,当前 VLA 很容易彻底失去对隐藏状态的追踪能力。
但另一方面,Object Memory 又几乎是天花板。
同样的 π0.5,Object Memory SR:
99.6%。
MSR:
99.6%。
这组对比很有意思。
它说明我们平时说“VLA 有/没有 Memory”,其实过于粗暴。
至少在 MEMOBench 里:
记住“刚才说的是哪个东西”已经相对容易。
真正困难的是:
这个东西后来发生了什么。
也就是说,静态 referential memory 和动态 state tracking,可能完全不是一个难度等级的问题。
这也是为什么我觉得这篇 benchmark 对 world model 方向的人也挺值得看。
因为它实际上把 Memory 和 World State 联系起来了。
一个理想机器人不是简单保存:
而应该逐渐维护某种:
这个
代表:
我目前相信世界是什么状态。
然后新 observation 来的时候:
如果这样理解,MEMOBench 的 Storage、Update、Compression 其实刚好对应一种非常直觉的 state estimator。
Storage:
新状态第一次进入 belief。
Update:
旧 belief 被新证据修正。
Compression:
一大串 observation 被整合成一个更紧凑的 state。
这和前面 ZimaBlue 那类 World Model 工作其实能形成一个挺有趣的对应。
ZimaBlue 在讨论:
机器人怎样学习世界如何变化。
MEMOBench 则是在追问:
当世界已经发生变化以后,机器人有没有正确维护自己对世界的记忆。
前者更多是 dynamics。
后者更多是 belief state。
如果未来真正要做 long-horizon embodied agent,这两个东西大概率最后一定会碰到一起。
当然,MEMOBench 自己也知道一个非常严重的问题:
一个 checkpoint 失败,并不一定百分之百等于 memory 错了。
比如模型明明知道番茄在上层抽屉,但机械臂抓抽屉把手失败,那么 simulator predicate 最终还是不满足。
所以作者又做了一个我觉得很重要的 Oracle Memory Experiment。
方法很直接:
他们直接把 ground-truth memory text 加到 (\pi_{0.5}) 的 prompt 里。
相当于作弊告诉机器人:
别猜了,我直接告诉你现在真正应该记住什么。
然后看性能能恢复多少。
结果非常明显。
Temporal SR:
Spatial SR:
Temporal MUR:
Spatial MUR:
Compression 也出现了非常明显的恢复。
这个实验很关键。
因为它至少说明:
MEMOBench 里面大量 Temporal / Spatial failure 并不是单纯因为机械臂“手残”。
当你把正确 memory 直接喂给同一个 policy以后,它真的能恢复很大一部分 performance。
所以这里确实存在一个独立于低层控制之外的 memory bottleneck。
但 Oracle 也没有把所有问题都解决。
平均 SR 从:
30.4%
提升到:
51.9%
仍然远没有到 100%。
这反而让结果更可信一点。
它说明:
Memory 是瓶颈之一,但不是唯一瓶颈。
一个机器人即使“脑子里知道正确答案”,仍然可能因为 planning、vision 或 manipulation control 做不出来。
这正是 Process-Level Evaluation 真正有意义的地方。
它让:
Memory failure和Action failure
至少开始可以被分开讨论。
论文还做了一个 shuffled memory experiment。
他们故意把 memory subgoal 的时间顺序打乱。
结果模型在最开始的 Storage checkpoint 上甚至还能做到不错,但一旦任务进入依赖 state update 的阶段,性能立刻掉下去。
正常时间顺序下,三个 checkpoint 的 prefix completion 大约是:
76%、52%、8%。
把 memory subgoal 顺序打乱以后:
90%、24%、2%。
这也是一个挺漂亮的小实验。
因为它说明模型不是只需要看到“相关信息集合”。
顺序本身就是 Memory 的一部分。
换句话说:
和:
对于机器人来说完全不是一回事。
MEMOBench 还有一个我觉得比较有潜力的设计,就是这些 checkpoint annotation 不只是拿来 evaluation。
作者同时尝试把它拿来训练 memory。
他们做了三种 alignment。
一种是 Semantic Memory Alignment。
简单来说,让模型当前的 memory representation 和对应的 checkpoint text 在 embedding space 里接近。
第二种是 Contrastive Memory Alignment。
也就是不只让正确 memory-text pair 接近,还让不同 subgoal 在 embedding space 里更容易区分。
第三种是 Framewise Memory Alignment。
它尽量保留不同历史 frame 的时间结构,让具体历史帧和对应时间段的 checkpoint text 做对齐。
最终 loss 都可以简单理解成:
也就是在正常学 action 的同时,顺便逼 memory representation 更接近人类定义的“这一阶段应该记住什么”。
效果有,但不算巨大。
例如 step = 5 时,原始 memory module 的平均 SR:
31.9%。
加入 Contrastive Memory Alignment 后:
34.7%。
Temporal SR:
Procedural SR:
而 Framewise Alignment 在 replan 比较稀疏,也就是 step = 50 时,相比原始 baseline 更稳定。
我觉得这里没必要把这篇论文理解成:
“作者已经提出了一套最优 Memory Training Method。”
显然还没有。
这些 alignment 更像 proof of concept。
它想证明的是:
如果 benchmark 已经标出了‘这一刻机器人应该记住什么’,这些 annotation 就不只是用来打分,还可以反过来作为训练 supervision。
这个方向其实挺有价值。
因为很多 benchmark 只负责告诉我们模型哪里错了,但 MEMOBench 希望进一步让这些 process annotation 可以直接变成 learning signal。
不过这篇论文也有几个很明显的局限。
最直接的一点:
完全是 Simulation。
所有任务都在 LIBERO/robosuite 上完成。
真实机器人里的 camera noise、遮挡、接触误差、物体位姿 drift、操作失败和视觉 domain shift 都没有进入 benchmark。作者自己也明确把 real-world transfer 列为核心 limitation。
而 Memory 在真实机器人上其实可能比 simulation 难得多。
仿真里:
番茄已经进入抽屉。
这个 state 非常干净。
真实环境里却可能是:
番茄掉进去了没有?
是不是卡在抽屉边缘?
相机没看见,是因为真的进去了还是因为被手挡住了?
这时候 Update 本身就和 uncertainty estimation 强耦合。
所以 MEMOBench 更适合被理解成:
把问题拆干净的实验室 benchmark,
而不是:
真实世界机器人 Memory 已经被完整建模。
第二个问题是它对于 Memory operation 的划分仍然带有人为定义。
Storage 和 Update 通常还比较直观。
但 Update 和 Compression 的边界并不是永远清楚。
作者做了三个 independent annotator 的 blind relabeling,Fleiss’ (\kappa=0.799),84 个 template 中有 70 个得到三人完全一致的标签,总体算不错,但分歧主要正好集中在 Update 和 Compression 的边界。
所以这些概念不是自然界里自动存在的三个离散类别。
它们是一个有用的工程 taxonomy。
这一点最好区分开。
第三个问题是 model coverage 还有限。
论文主要测试的是几类现有 VLA 和 memory-augmented architecture,对 state-space model、显式 symbolic world state、图结构 memory、episodic retrieval 系统等路线覆盖还不够。作者也明确承认这一点。
换句话说,目前 MEMOBench 证明的是:
这些当前主流 VLA / memory module 在这些 memory operation 上还有明显问题。
还不能直接扩展成:
所有可能的 embodied memory architecture 都一定表现类似。
但从 benchmark 的角度来说,我觉得它已经足够有价值。
尤其有一点是我比较喜欢的:
它没有试图把 Memory 神秘化。
没有说:
“我们发现机器人缺少人类般长期记忆。”
而是非常工程化地说:
你先告诉我:
第一次信息有没有存进去?
世界改变以后:
有没有改掉旧信息?
历史越来越长:
有没有把它整理成一个还能用的表示?
最后:
记对以后,你到底有没有把任务做出来?
这套拆法不完美,但非常容易做实验。
而且当前结果其实已经暴露出一个值得关注的现象:
现代 VLA 也许没有我们想象中那么“健忘”,但它们非常容易“记死”。
它可能记得第一条信息,却不知道什么时候这条信息应该失效。
这个区别很重要。
因为如果问题只是 Storage,我们最直觉的解决办法是:
更长 context。
更多 history frame。
更大的 memory buffer。
但如果真正的瓶颈是 Update,那么继续堆 history 甚至可能把问题变严重。
模型会同时看到:
stove is on。
和:
stove is off。
这时候真正需要解决的不是容量,而是:
which information is currently valid?
同样,如果瓶颈是 Compression,那么问题也不是“保存得不够多”。
而可能恰恰相反:
保存得太多了,却不知道应该留下什么。
所以 MEMOBench 最终指出的其实是一种不同的机器人 Memory 研究方向。
不是:
而是:
这两个东西差别非常大。
一个理想的 embodied agent,未来可能不会一直背着过去一分钟所有 RGB frame 到处走。
它更可能维护一个不断变化的 task-relevant belief:
杯子在抽屉里。
炉子现在已经关闭。
我已经做过两次这个动作。
下一步应该执行演示里的第三个阶段。
而这种 belief 本身必须不断经历:
Storage → Update → Compression → 再 Update。
如果从这个角度理解,MEMOBench 实际上并不只是一个“机器人记忆 benchmark”。
它碰到了一个更大的问题:
Embodied Agent 到底应该怎样维护一个随着世界变化而持续更新的内部状态。
如果你正在研究 VLA、long-horizon manipulation、memory-augmented policy、world model,或者对机器人从 reactive policy 往真正持续运行的 agent 演化感兴趣,我觉得这篇论文值得看。
但和 ZimaBlue 一样,也没必要第一次就从 appendix 里的所有 loss 开始啃。
最值得优先看的其实是它的 taxonomy、checkpoint design、Table 2 的主实验,以及 Oracle Memory Decomposition。
尤其是 Oracle 那组:
我觉得基本已经把这篇论文为什么存在讲清楚了。
很多 VLA 失败,并不只是因为动作做不好。它真的忘了,或者更准确地说,它没有把自己的 Memory 随着世界一起更新。
如果你现在主要做短 horizon grasping、单步 manipulation,当前 observation 基本足够决定 action,那么 MEMOBench 和你的直接关系可能没有那么大。
但如果你的机器人需要工作几十秒、几分钟,甚至更长时间,需要记住:
“刚才发生过什么”
“什么东西现在已经不一样了”
“哪些信息可以扔掉”
“哪些信息之后还会重新用到”
那么我觉得 MEMOBench 非常值得知道。
因为我们过去经常把机器人长期任务失败统称为:
long-horizon reasoning 不行。
这个词太大了。
MEMOBench 至少把其中一部分问题拆得更具体:
机器人也许不是不会 reasoning。
它可能只是一直拿着一个过期的世界状态在 reasoning。
而如果一定要把这篇论文压缩成一句话,我会这样概括:
MEMOBench 的价值不是证明机器人“没有记忆”,而是第一次比较系统地让我们看到:机器人究竟是没有把信息存进去,还是没有在世界变化以后改掉旧记忆,又或者没有把越来越长的历史整理成真正可用的状态。
这三个问题一旦分开,未来讨论机器人 Memory,就终于不必只盯着一个最终 Success Rate 了。
论文地址:https://arxiv.org/abs/2609.07047
另外一个实际层面也比 ZimaBlue 更友好:截至目前,MEMOBench 的 GitHub 已经公开了 evaluation code 和 task config,Hugging Face 也提供了数据与额外 assets;当前发布的数据卡显示数据总量约 107 GB,GitHub README 给出了 LIBERO 环境和 evaluation server 的使用流程。
所以它并不只是一个“可以看看思想”的 benchmark。
如果你自己正在做 VLA memory 或 long-horizon manipulation,这个东西其实已经可以直接拿来测。
而我觉得它真正值得继续追踪的问题,反而是下一步:
当机器人 Memory 从“保存历史”真正变成“维护世界状态”以后,它和 World Model 还会不会继续是两个独立模块?
还是说以后所谓 World Model,本身就应该同时承担:
预测未来,
维护 belief,
修正 stale state,
以及决定什么历史值得继续保留。
如果是后者,那么 MEMOBench 这类工作今天看起来只是一个 benchmark,未来可能测的其实是 embodied intelligence 里非常核心的一块能力:
机器人能不能在一个不断变化的世界里,持续知道“现在究竟发生到哪了”。