
Agent软件中可观测性设计:维度与基数
Agent软件中可观测性设计:维度与基数
很多团队第一次给 Agent 做可观测性,通常会从几个指标开始:请求量、响应时间、错误率、Token 消耗。它们当然有用,但真正遇到问题时,往往不够用。
用户说“这个 Agent 最近变笨了”,我们需要知道:是模型换了?提示词变了?工具响应变慢了?规划步骤增加了?还是某一类任务本身就更复杂?
要回答这些问题,关键不只是采集更多数据,而是设计好数据的两个基本属性:维度和基数。
一、Agent为什么比普通服务更难观测
普通 Web 服务的一次请求,通常可以概括为:
请求 → 服务处理 → 返回响应
而 Agent 的一次运行更像一条不断展开的链路:
一次看似简单的提问,可能经历多轮模型调用、多个工具调用和若干次重试。最终答案出了问题,原因可能不在最后一次生成,而在更早的一步规划,或者某个工具返回了不完整的数据。
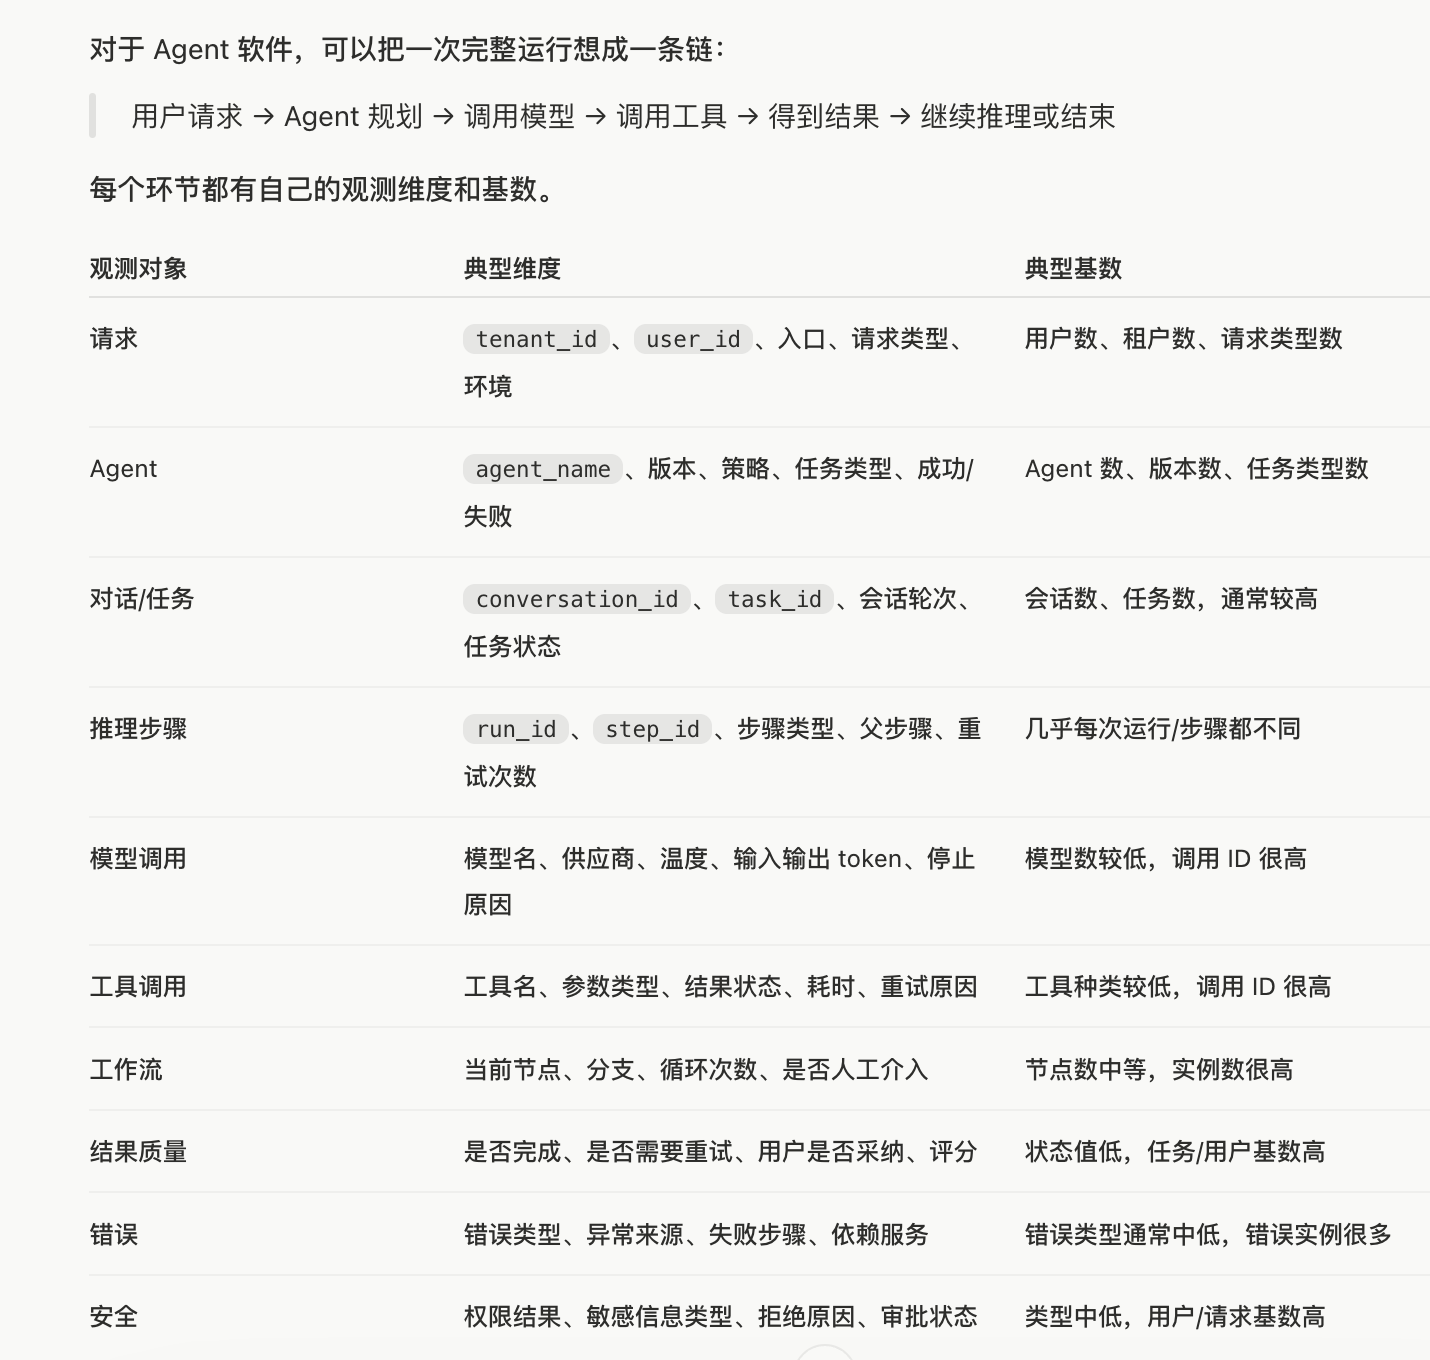
因此,Agent 的可观测性不能只看“这次请求成功还是失败”,还要看:
- 它为什么这样规划;
- 它经过了哪些步骤;
- 调用了哪些模型和工具;
- 哪一步耗时最长;
- 哪一步发生了重试;
- 最终是否真正解决了用户问题。
这就要求我们给每一条观测数据附加足够丰富的描述信息,也就是维度。
二、什么是维度
维度可以理解为观察数据的角度,或者切分数据的字段。
比如一条工具调用记录:
{
  "event": "tool_call",
  "agent_name": "research-agent",
  "tool_name": "search",
  "environment": "production",
  "status": "success",
  "latency_ms": 820
}
其中,agent_name、tool_name、environment、status 都是维度。
有了这些维度,我们可以提出不同的问题:
- 哪个 Agent 的工具调用最慢?
- 生产环境和测试环境的失败率是否不同?
- 哪个工具最容易超时?
- 某个版本发布后,失败率是否上升?
没有维度,数据只能告诉我们“出了问题”;有了维度,数据才开始解释“问题发生在哪里”。
对于 Agent,常见维度可以分为几类。
1. 请求维度
描述请求从哪里来、属于什么类型:
- 用户或租户;
- 请求入口;
- 任务类型;
- 产品模块;
- 环境;
- 地区;
- 客户端版本。
2. Agent维度
描述是哪一个 Agent 在工作:
- Agent 名称;
- Agent 版本;
- 编排策略版本;
- 提示词版本;
- 工作流版本;
- 是否启用了实验功能。
3. 执行维度
描述 Agent 如何完成任务:
- 当前步骤类型;
- 父步骤;
- 规划节点;
- 循环次数;
- 重试次数;
- 是否人工介入;
- 当前状态。
4. 模型维度
描述模型调用情况:
- 模型名称;
- 模型供应商;
- 模型版本;
- 输入 Token 数;
- 输出 Token 数;
- 停止原因;
- 是否触发上下文截断。
5. 工具维度
描述外部能力的调用:
- 工具名称;
- 工具版本;
- 参数类型;
- 依赖服务;
- 返回状态;
- 超时原因;
- 结果大小。
6. 结果维度
描述任务最后是否达成目标:
- 是否完成;
- 是否需要重试;
- 是否转人工;
- 用户是否采纳;
- 质量评分;
- 是否产生副作用;
- 是否触发安全拦截。
这些维度共同构成了 Agent 的“观察坐标系”。坐标越丰富,越容易从不同角度还原一次运行。
三、什么是基数
基数指一个维度中不同取值的数量。
例如:
status只有success、failed、timeout三种取值,属于低基数;tool_name可能有几十种取值,属于中等基数;user_id可能有几百万个取值,属于高基数;task_id、step_id、trace_id几乎每次都不同,属于极高基数。
可以把它理解成:
维度是“从哪个角度看”,基数是“这个角度有多少种具体情况”。
在 Agent 中,基数还会发生组合。假设系统中有:
- 8 个 Agent;
- 10 个工具;
- 5 个环境;
- 20 个任务类型;
- 100 个版本组合。
理论上,这些维度组合就可能产生:
8 × 10 × 5 × 20 × 100 = 800,000
种不同情况。
实际数量未必会达到这个上限,但随着维度增加,组合空间会迅速扩大。这也是 Agent 可观测性中经常出现“基数爆炸”的原因。
四、高基数不是坏事
在传统监控系统中,高基数往往被视为危险信号。因为很多指标系统会把每个标签组合存成一条时间序列,标签取值越多,时间序列数量就越大。
例如下面这个指标:
agent_requests_total{
  agent_name="research-agent",
  user_id="u_839201",
  task_id="task_abc123"
}
如果每个用户和每个任务都进入指标标签,系统很快就会产生海量时间序列,查询、索引和存储成本都会上升。
但这并不意味着高基数数据没有价值。恰恰相反,排查 Agent 的单次异常时,task_id、run_id、step_id 和 tool_call_id 往往是最重要的信息。
问题不在于“要不要高基数”,而在于“把高基数数据放在哪里”。
比较稳妥的做法是:
- 低基数维度放进指标,便于聚合和告警;
- 高基数维度放进事件和 Trace,便于定位单次运行;
- 原始输入、输出和工具参数放在受控的详细记录中;
- 对敏感信息进行脱敏、截断或哈希处理。
可以做一个简单区分:
| 数据类型 | 适合的维度 | 主要用途 |
|---|---|---|
| 指标 | Agent 名称、环境、状态、工具名 | 趋势、告警、容量分析 |
| Trace | 任务 ID、运行 ID、步骤 ID | 还原一次完整执行 |
| 结构化事件 | 规划节点、工具参数类型、错误原因 | 分析行为模式 |
| 详细记录 | 输入输出、检索结果、模型响应 | 质量分析和问题复盘 |
五、Agent中最值得保留的高基数维度
1. task_id和run_id
task_id 表示一个用户任务,run_id 表示一次具体执行。
当任务失败后,工程师可以沿着这两个 ID 查看完整过程:
task_id
  └── run_id
        ├── planner step
        ├── model call
        ├── search tool
        ├── retry
        └── final response
如果没有这两个标识,所有步骤只能混在一起,很难判断它们是否属于同一次运行。
2. step_id和parent_step_id
Agent 经常会出现嵌套调用和分支执行。step_id 可以标识当前步骤,parent_step_id 可以还原步骤之间的关系。
这对于分析以下问题非常有用:
- 哪个规划节点引发了大量工具调用?
- 哪个分支最容易失败?
- 为什么某次任务出现无限循环?
- 某个步骤是否重复执行?
3. tool_call_id
同一个工具可能在一次任务中被调用多次。仅记录工具名是不够的,还需要记录每次具体调用的 ID、开始时间、结束时间和结果状态。
4. prompt_version和model_version
Agent 的行为变化,经常来自提示词或模型版本的变化,而不是业务代码变化。
因此,提示词版本、模型版本和工具版本应该成为稳定的观测维度。否则出现质量下降时,只能凭感觉猜测。
六、如何避免维度设计失控
维度不是越多越好。每增加一个维度,都会带来采集、存储、查询和治理成本。
设计时可以遵循三个原则。
第一,先问这个维度能帮助回答什么问题。
如果一个字段从来不会参与筛选、聚合或定位,就不一定要把它放进所有指标中。
第二,区分“分类字段”和“唯一标识”。
tool_name 适合用于聚合:“哪个工具失败最多?”
tool_call_id 适合用于定位:“这一次调用为什么失败?”
两者都要保留,但不应该用同一种方式处理。
第三,控制敏感信息。
用户输入、邮箱、手机号、内部文档内容和工具原始参数,可能同时具有极高基数和较高敏感性。它们不能简单地全部塞进日志。
更合理的方式是:
- 保存必要的摘要;
- 对敏感字段脱敏;
- 对长文本设置长度上限;
- 对原始内容设置访问权限;
- 明确保存期限;
- 记录数据采集目的。
七、一个实用的观测模型
可以把 Agent 的观测数据设计成三层。
第一层是服务指标,用来回答“系统整体怎么样”:
agent_run_total
agent_run_failure_rate
agent_run_latency
agent_token_usage
tool_call_failure_rate
第二层是执行 Trace,用来回答“这一次发生了什么”:
trace_id
task_id
run_id
step_id
parent_step_id
agent_version
prompt_version
model_name
tool_name
第三层是结构化事件,用来回答“为什么会这样”:
plan_created
model_called
tool_selected
tool_returned
guardrail_triggered
step_retried
human_handoff
task_completed
三层数据配合起来,才能同时满足监控、排障和质量分析。
结语
Agent 的可观测性,本质上是在记录它如何理解任务、如何做出选择,以及如何一步步完成工作。
维度让我们拥有观察角度,基数决定这些角度有多细。
低基数维度适合做整体统计,高基数维度适合还原单次过程。
真正成熟的Observability设计,不是把所有字段都放进指标,也不是为了控制成本而丢掉细节,而是根据不同数据类型安排合适的承载方式。
对于 Agent 来说,最重要的观测对象往往不是“请求成功率”本身,而是:
一次任务由谁发起
经过了哪些步骤
调用了哪些模型和工具
在哪一步发生了偏差
最终是否真正解决了问题
当这些信息能够被可靠地串联起来,Agent 才不再是一个只能“看结果、猜过程”的黑盒。
Agent 的开发流程有 3 个大步骤:设计、开发、eval,一个好的 Agent 的标准就是通过并验证 eval
可观测性,是指你在软件中建立一种能力,通过指标、日志、轨迹,你可以理解和解释系统可能进入的任何状态——无论它多么新奇或奇怪。这是将「黑盒」转换成「白盒」的基础。不可观测的系统,就是不可控的系统。系统的鲁棒性,很大一部分源于他的可观测程度。