
从 World Model 到 World Action Model:具身智能正在进入“先想象,再行动”的时代(续集)

4. MuZero:世界模型不一定要“还原世界”
如果说 Dreamer 的思路是:
在一个压缩的 latent 世界里模拟未来,
那么 MuZero 又往前推了一步。
它问了一个很狠的问题:
做决策时,我们真的需要把整个世界预测出来吗?
很多时候,其实不需要。
比如一个智能体在玩棋类游戏。
它并不需要生成一张高清的“未来棋盘图片”,也不需要完整重建每一个视觉细节。
它真正关心的是:
- 这个状态值多少钱;
- 执行某个动作之后 reward 怎么变;
- 接下来哪些动作更有希望。
所以 MuZero 并不强调恢复真实观测,而是学习一个对决策有用的隐空间动力学。
可以粗略理解成:
当前观测
   |
   v
Representation Network
   |
   v
Latent State
   |
   + action
   |
   v
Dynamics Network
   |
   +----> Reward
   |
   +----> Next Latent State
   |
   v
Prediction Network
   |
   +----> Value
   |
   +----> 策略先验
这件事对后来 World Model 的影响非常大。
因为它提醒大家:
“预测得像不像”不一定等于“对控制有没有用”。
一个模型可以生成非常漂亮的视频,但如果它对接触、力学、可执行性判断错误,那对机器人控制来说价值有限。
反过来,一个 latent model 可能根本没法把预测结果画出来,但只要它能稳定预测任务进展、可达性和动作后果,它就可能非常有用。
所以从这里开始,World Model 慢慢分成两种审美:
第一种更关注:
世界未来看起来是什么样。
第二种更关注:
哪些未来信息对决策真正有用。
这个分歧,到今天依然存在。
5. JEPA:也许我们根本不该预测像素
沿着第二种思路继续往下,就会碰到 JEPA。
JEPA,全称 Joint-Embedding Predictive Architecture。
它背后的想法其实很直白:
真实世界里,大量像素细节和智能决策没有直接关系。
假设一个机械臂正在把金属插销装进孔位。
真正决定任务成败的变量,可能是:
- 插销和孔的位置关系;
- 姿态误差;
- 接触状态;
- 插入深度;
- 当前是否卡住。
但像素空间还包含一堆东西:
- 金属表面高光;
- 背景颜色;
- 旁边工作人员衣服的颜色;
- 相机噪声;
- 灯光阴影。
如果一个模型花大量容量,把这些视觉细节都预测得非常精确,它未必学到了真正有用的物理结构。
于是 JEPA 的思路是:
过去的观测
    |
    v
Context Encoder
    |
    v
抽象表征
    |
    v
Predictor
    |
    v
未来表征
它不一定要求:
未来 RGB 像素
而是要求:
未来 observation 的 representation
和真实未来观测编码后的 representation 对齐。
这其实是一种很“老哥式”的工程思路:
既然最终是为了决策,那就别逼模型把所有不重要的东西都画出来。
因此,今天讲 World Model,千万不要把它和视频生成模型画等号。
视频生成只是其中一条路线。
World Model 更本质的问题是:
模型有没有学到“世界如何演化”。
至于这个“世界”究竟表示成 RGB、latent、3D geometry、occupancy、object graph,还是某种抽象特征,是另外一回事。
你上传的第二篇材料也采用了类似的区分:它把今天的 World Model 分成视频生成、latent prediction、结构化 dynamics、3D world 和物理引擎等多条路线,而不是简单把 World Model 等同于视频生成。
6. 为什么这两年 World Model 突然又火了?
World Model 不是新概念。
Dreamer 也不是 2025 年才出现。
为什么偏偏到了 2024~2026 年,World Model 突然又成了“显学”?
我觉得主要有三个原因。
6.1 第一件事:视频生成能力跨过了一个坎
以前做视频预测,最大的问题是:
预测出来的东西很快就崩。
短时间还能看。
一旦多步预测序列拉长:
- 物体消失;
- 形状漂移;
- 空间关系错乱;
- 动作和视觉不同步。
所以很长时间里,“用视频生成模型做 World Model”听起来挺酷,但真正拿去做控制的人并不多。
后来 Transformer、Diffusion、DiT、Flow Matching 这些技术成熟之后,视频模型的时空建模能力上了一个台阶。
于是产业界开始认真问:
如果视频模型已经能学会这么多视觉动态,那它是不是也在学某种粗粒度物理规律?
这也是 Genie、Cosmos 等路线重要的地方。
它们把 World Model 从:
小规模 RL 环境里的 dynamics model
慢慢推到了:
大规模 World Foundation Model。
第二篇材料就把这条线总结成:
小规模 latent dynamics
      ->
model-based RL
      ->
Transformer / diffusion 视频世界模型
      ->
JEPA
      ->
foundation world model
      ->
robot world model / WAM
6.2 第二件事:机器人真的太缺数据了
大模型时代有一个很残酷的现实:
语言模型的数据来自互联网。
视觉模型的数据也能来自互联网。
但是机器人动作数据没法靠爬网页获得。
你想获得一条高质量机器人轨迹,通常意味着:
机器人硬件
+
真实场景
+
遥操作人员
+
标定
+
动作同步
+
失败恢复
+
人工维护
成本完全不是一个量级。
这也是为什么机器人领域一直在研究:
- Open X-Embodiment;
- 多机器人数据混合;
- 仿真数据;
- 人类第一视角视频;
- play data;
- synthetic trajectory。
World Model 在这里提供了一个很有吸引力的切入点。
因为它不一定要求所有数据都有机器人动作标签。
特别是如果模型的世界预测部分可以先从:
- 人类视频;
- 网络视频;
- egocentric video;
- simulation video
里面学到“世界怎么变化”,那么后续再用少量机器人数据对动作进行对齐,理论上就能大幅降低机器人动作数据的压力。
这也是为什么在 WAM 里,人类视频和无动作标签视频的重要性被抬得很高。
你上传的 WAM 调研材料把数据来源分成四类:
- 机器人遥操作;
- 便携式人类示范;
- 仿真;
- 互联网级 / 第一视角人类视频。
其中后两类尤其重要,因为它们规模大,而且可以提供大量“世界如何变化”的先验。
6.3 第三件事:VLA 开始碰到“反应式策略”的天花板
过去几年的 VLA 路线已经非常清楚了:
Image / Video
+
Language
+
Robot State
      |
      v
     VLA
      |
      v
   Action
这条路线很有效。
问题是:
它天然更偏向直接策略映射。
也就是:
observation -> action
这并不是说 VLA 完全没有世界知识。
大模型当然可以通过视觉预训练、语言预训练、轨迹数据获得大量隐式先验。
但从建模目标上看,大量 VLA 并没有明确要求模型回答:
如果执行这个动作,未来世界究竟会怎样?
这正是 World Model / WAM 阵营针对 VLA 最核心的批评之一。
WAM 综述里的表述非常直接:
传统 VLA 学习的是一种反应式 observation-to-action mapping,而没有显式建模“物理世界在干预后如何变化”。
这句话基本把 WAM 为什么会出现讲透了。
7. 一个更实际的例子:装配机器人为什么需要 World Model?
为了避免一直拿抓杯子举例,我们换一个更实际的场景。
假设工厂里有一个双臂机器人,需要完成:
把一个软排线插进连接器,然后压下锁止结构。
这个任务看起来不复杂。
但真正做过机器人装配的人都知道,这里面坑很多。
机器人第一步可能是:
抓住排线
第二步:
调整排线姿态
第三步:
插入连接器
第四步:
压下锁止结构
一个纯 策略模型 模型可能每一步都局部预测动作。
问题是:
第一步抓的位置稍微偏一点,第三步可能就永远对不准。
或者:
插入角度偏了 2°,继续往下压可能会损坏接口。
这时候一个拥有 world prediction 能力的模型可以在执行前想象:
候选动作 A:
继续向前推进 3 mm

预测结果:
排线边缘与连接器发生干涉
失败风险高
再看:
候选动作 B:
先向上抬 1 mm
再旋转 1.5°
然后插入

预测结果:
连接器切入点对齐
后续可执行
这就是 World Model 的价值。
关键不是“生成一段排线插进去的视频”。
关键是:
预测不同动作之后的状态变化。
如果这个预测还能直接和动作生成统一起来,那么就进一步进入 WAM。
8. 从 World Model 到 World Action Model
现在终于可以讲 WAM 了。
World Action Model,简称 WAM。
如果用一句话概括:
WAM 就是把“未来世界”和“未来动作”放进一个统一建模框架里。
传统 World Model 更像:
当前状态 + 动作
        |
        v
     未来状态
也就是:
s_t + a_t -> s_{t+1}
VLA 则更像:
当前观测 + 语言
        |
        v
       动作
而 WAM 想做的是:
当前观测 + 语言
         |
         v
未来状态 + 未来动作
更正式一点说,就是从:
p(a | o, l)
扩展到:
p(o', a | o, l)
也就是同时建模:
- future observation / future state;
- action。
WAM 综述给出的定义非常明确:
WAM 是统一 predictive state modeling 和 action generation 的具身基础模型,其目标是未来状态和动作的联合分布,而不仅仅是动作。
这个定义我觉得非常关键。
因为它把 WAM 和“有 World Model 模块的机器人系统”区分开了。
9. World Model + 策略模型和 WAM 有什么区别?
这里很容易混。
一种经典系统是:
World Model
     |
     v
 Planner
     |
     v
 策略模型
例如:
World Model 负责预测未来。
Planner 负责选方案。
策略模型 负责执行。
这是:
策略模型使用 world model。
而 WAM 更进一步。
它希望:
世界预测和动作生成本身就是统一模型的一部分。
例如:
Observation
+
Language
       |
       v
Unified Model
       |
       +------> Future State
       |
       +------> Action
甚至:
video token
action token
latent state
直接进入同一个 Transformer / DiT。
这意味着“想象”和“行动”不再是两个完全独立模块。
这也是第二篇材料对最近趋势的总结:
过去:
策略模型使用 world model

现在:
world model 和 策略模型 联合建模

未来:
agent 的“想象”和“行动”
可能只是同一个模型的不同推理模式
我个人觉得,这其实是理解 WAM 最好的角度。
10. WAM 并不是只有一种做法
看到这里容易产生一个误解:
是不是所有 WAM 都是:
先生成未来视频,再从视频里面推出动作?
不是。
这是其中一种。
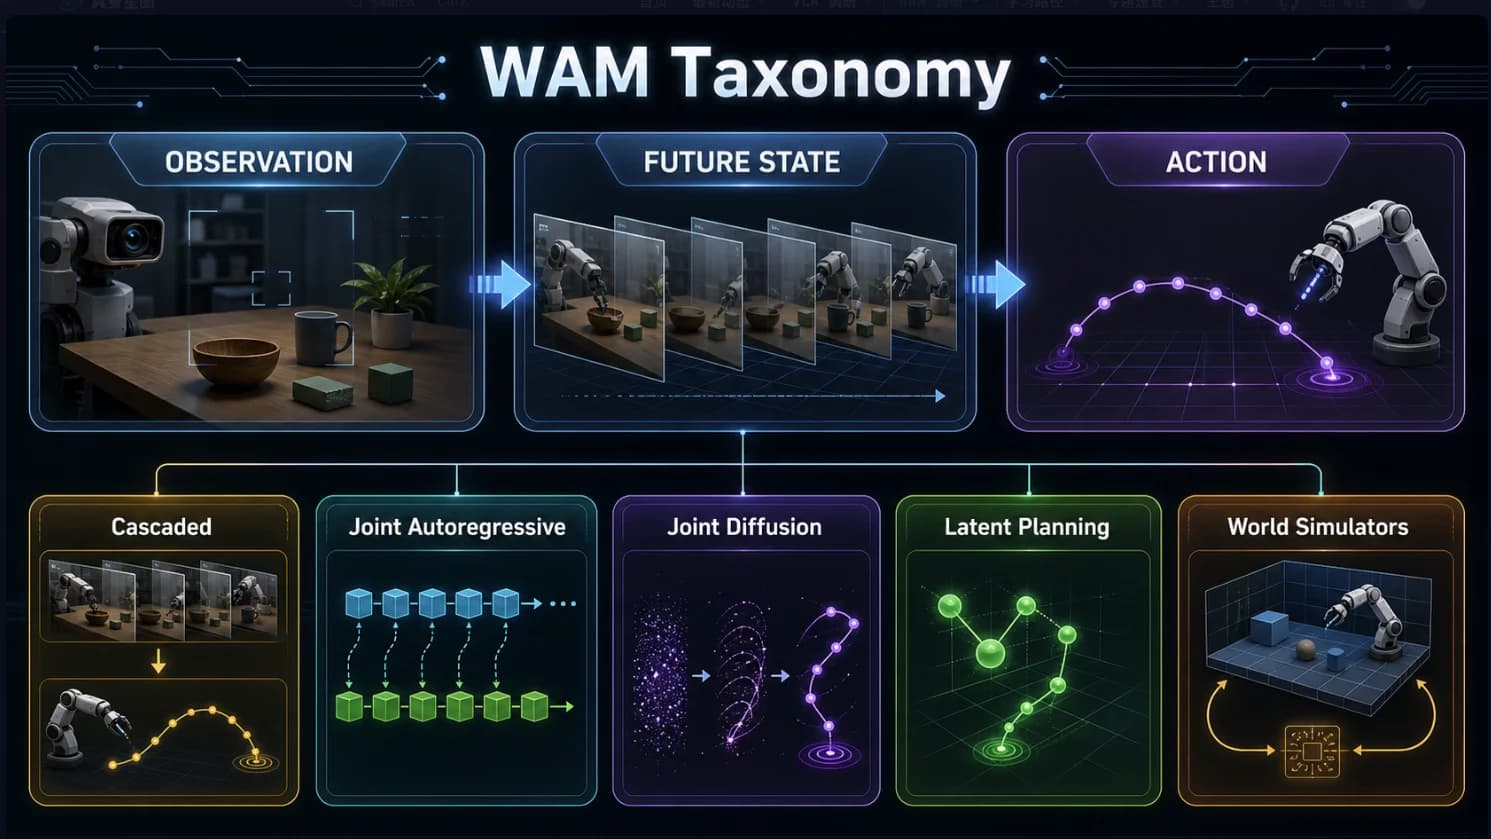
WAM 综述把现有路线先分成两大类:
WAM

├── Cascaded
│
└── Joint
也就是:
- 级联式;
- 联合式。
这是理解当前 WAM 论文最重要的一张地图。
11. Cascaded WAM:先想未来,再决定怎么做
Cascaded 是最直观的一类。
逻辑就是:
当前观测
   |
   v
预测未来状态
   |
   v
从未来状态反推动作
也可以写成:
p(o', a | o, l)

=

p(o' | o, l)
×
p(a | o', o, l)
直觉上就是:
先想象任务完成之后应该长什么样,再算怎么做到。
这条路线和早期很多视频规划工作很像。
11.1 显式 Cascaded:真的把未来“画出来”
第一种方案最暴力:
直接生成未来图像或者视频。
比如家庭机器人收到任务:
“把客厅里的折叠椅收起来,给扫地机器人腾出通道。”
模型可以先生成一个目标未来:
当前:
折叠椅挡在过道中央

未来:
折叠椅靠墙收好
过道清空
然后通过:
- optical flow;
- pose tracking;
- keypoint;
- inverse dynamics;
- geometry;
把这个视觉变化转换成机器人动作。
这类方法的好处是特别直观。
你可以直接看:
模型到底想实现一个什么未来。
而且因为未来目标通常是视觉/几何空间的,它对具体机器人的动作空间依赖相对没那么强。
同一个目标未来:
“椅子最终靠墙”
可以由:
- 单臂机器人;
- 双臂机器人;
- 人形机器人
用不同方式执行。
这就是显式 future generation 很吸引人的地方。
WAM 调研里把 UniPi、Gen2Act 等工作放在这一类,同时也把 π0.7 归入 Cascaded·Explicit 这一格。
11.2 但显式生成未来有一个致命问题:慢
机器人控制和视频生成有一个天然矛盾:
视频模型喜欢:
大模型
多步 diffusion
高分辨率
长序列
机器人喜欢:
低 latency
高频控制
稳定闭环
两者几乎反着来。
如果每执行一个动作之前,都要:
生成未来 16 帧视频
↓
分析视频
↓
再推出动作
控制频率很容易直接崩掉。
于是大家自然想到:
既然最终需要的是“未来信息”,为什么一定要把 RGB 真正生成出来?
这就有了 latent planning。
12. 隐式 Cascaded:别画视频,在 latent 里想
隐式 Cascaded 的逻辑和前面一样:
先预测未来
再生成动作
但未来不是 RGB。
而是:
latent state
例如:
current observation
       |
       v
video encoder
       |
       v
latent z_t
       |
       v
future latent z_{t+k}
       |
       v
策略模型
       |
       v
action
优点非常明显:
- 不需要完整视频解码;
- 计算成本低;
- 更容易做到实时;
- 可以过滤大量无关的像素细节。
WAM 综述把 VPP、LAPA 等放在这一类。
从工程角度看,这条路线其实很有竞争力。
因为真实机器人最终需要的不是:
每次决策都生成一部电影。
而是:
一个可靠、快速、足够预测后果的内部状态。
13. Cascaded 最大的问题:误差会一层层传下去
级联系统最大的问题也很经典。
假设:
World Model
预测错了。
那么:
Action Model
会基于错误未来做决策。
例如机械臂准备将一个柔性软管穿过支架。
World Model 预测:
软管会从支架左侧自然下垂
但真实情况由于摩擦:
软管卡在右侧边缘
后续 action decoder 如果完全相信预测未来,就可能输出一串完全错误的动作。
这就是 cascaded pipeline 的问题:
World Prediction Error
       ↓
Action Extraction Error
       ↓
Execution Error
所以后来越来越多工作开始做:
Joint Modeling。
14. Joint WAM:世界预测和动作一起学
Joint WAM 的核心不是:
先预测
再行动
而是:
世界状态
+
动作

在同一个模型里联合生成
也就是说直接学习:
p(o', a | o, l)
而不是拆成两个模型。
从结构上可以想成:
Observation Tokens
Language Tokens
Future Tokens
Action Tokens

        ↓

Shared Transformer / DiT

        ↓

Future State + Action
这带来一个很重要的变化:
动作生成可以直接看到 world prediction 的内部特征。
世界建模也可以受到 action supervision 的影响。
两个任务不是简单串联,而是:
互相约束。
这和我们人类的认知其实也比较像。
我们并不是:
完整模拟整个世界
↓
模拟结束
↓
再单独计算动作
很多时候,“我准备怎么做”和“我觉得会发生什么”本来就是一起变化的。
15. Joint WAM 又分两条主线
目前比较主流的两种技术基底是:
Joint WAM

├── Autoregressive
│
└── Diffusion / Flow Matching
也就是:
- 自回归;
- 扩散 / 流匹配。
16. 自回归 WAM:把世界和动作都 token 化
自回归路线很好理解。
既然 LLM 可以:
token -> token -> token
那是不是可以把:
视觉
动作
世界状态
也全部变成 token?
然后统一做:
next-token prediction
例如一个序列可能类似:
[OBS]
视觉 token

[LANG]
任务 token

[ACT]
动作 token

[FUTURE]
未来视觉 token

[ACT]
下一段动作 token
这样一个 Transformer 理论上就能同时:
- 理解任务;
- 预测世界;
- 生成动作。
WAM 综述把 GR-1、WorldVLA、RynnVLA-002 等归在 Joint·Autoregressive 路线中。
16.1 Autoregressive 最大优势:统一
它很适合做“大一统模型”。
因为只要能 token 化,就可以塞进一套序列建模框架。
例如:
language token
+
image token
+
action token
+
future token
对大模型团队来说,这种统一性很有吸引力。
16.2 最大问题:串行生成太慢
Autoregressive 的老问题也很明显:
token 1
↓
token 2
↓
token 3
↓
token 4
机器人控制非常讨厌这种串行 latency。
特别是视觉 token 很多的时候。
另外一个问题是:
如果早期生成了错误 future token,后面的 action token 可能跟着一起错。
也就是:
视觉幻觉
↓
未来状态错误
↓
动作错误
所以扩散路线开始变得越来越重要。
17. Diffusion WAM:世界和动作一起“去噪”
Diffusion / Flow Matching 路线最近非常火。
原因之一就是:
动作本身非常适合连续生成。
机器人动作通常是:
x, y, z
roll, pitch, yaw
gripper
joint state
本质上都是连续值。
Diffusion 策略模型 已经证明:
diffusion 对多模态连续动作分布非常适合。
于是一个很自然的想法就是:
既然视频可以 diffusion,
action 也可以 diffusion,
那能不能:
video + action 一起 diffusion?
于是出现:
Future Video Noise
+
Action Noise

       ↓

Shared DiT

       ↓

Future Video
+
Action
这就是不少 Joint WAM 的基本思路。
18. Unified-Stream:同一个 DiT 同时生成世界和动作
一种很激进的结构叫:
Unified-Stream。
世界变量和动作变量都进入同一个网络。
例如:
current observation
language
noisy future video
noisy action

        ↓

      DiT

        ↓

denoised future
+
denoised action
它的好处是:
世界和动作天然共享 attention。
动作可以看到视觉未来的信息。
视觉未来也可以受到动作约束。
WAM 综述把 UWM、DreamZero、X-WAM 等放在 Joint diffusion 这一大脉络下。
19. Multi-Stream:视频和动作各走各的,但中间交流
另外一种更工程化的方案是:
Video Branch
      |
      | Cross Attention
      |
Action Branch
或者:
Shared Encoder

  /       \
 /         \
Video       Action
Decoder     Decoder
这样做的好处是:
两个模态可以拥有不同的计算预算。
因为机器人实际有个很现实的问题:
视频生成不需要 50 Hz,但动作可能需要。
如果所有东西都强制同步,就很浪费。
所以多流架构可以做:
video:
慢一点
高质量

action:
快一点
低 latency
这也直接引出了 X-WAM 这类工作的核心动机。
20. 代表模型一:UWM,开始真正把 Video 和 Action Diffusion 耦合起来
UWM,全称 Unified World Models。
它属于比较早的一批:
Joint Video-Action Diffusion。
核心思想不是:
video model
+
单独 action head
而是:
把视频扩散和动作扩散真正耦合起来。
从 WAM 的发展史上看,UWM 很重要。
因为它把一个问题正式摆到桌面上:
世界生成和动作生成到底是不是应该分开训练?
WAM 后来的很多工作,都在回答这个问题。
X-WAM 也明确把 UWM 作为前序路线进行讨论,并批评它主要停留在 2D pixel-space 世界建模。
换句话说:
UWM 更像是:
“Video + Action 一起 diffusion”这条线的重要起点。
21. 代表模型二:DreamZero,把 World Model 直接做成 策略模型
DreamZero 是最近这条路线里特别值得注意的一篇。
论文标题直接叫:
World Action Models are Zero-shot Policies
这标题已经把态度写脸上了。
过去 World Model 的角色通常是:
World Model
    ↓
辅助 策略模型
DreamZero 想说的是:
World Action Model
      =
    策略模型
世界预测不是旁路任务。
而是动作能力本身的一部分。
21.1 DreamZero 为什么重要?
它背后的核心假设是:
视频模型里面已经包含大量关于运动、物体变化和物理交互的先验。
那就没必要从零训练一个机器人 策略模型。
可以直接在:
pretrained video diffusion backbone
上长出 action capability。
也就是:
大量视频知识
      |
      v
Video Diffusion Backbone
      |
      +---- Future World
      |
      +---- Robot Action
这样一来,人类视频和互联网视频就有机会真正成为机器人预训练数据。
21.2 一个更直观的例子
假设任务是:
人形机器人把地上的长电缆收好,然后挂到墙上的挂钩上。
这个任务有很多物理细节:
- 电缆是柔性的;
- 拿起一端之后另一端会拖动;
- 电缆可能打结;
- 摆动会影响最终抓取;
- 挂钩需要特定空间姿态。
传统 VLA 看到当前画面后,可以输出下一段动作。
而 WAM 路线希望模型内部先形成类似:
如果先抓中间:
电缆两端会拖地
后续整理困难

如果先抓插头端:
电缆可能整体被拉直
更容易后续盘绕
然后动作和未来变化一起生成。
这里真正有价值的不是视频好不好看。
而是:
world prediction 给 action prediction 提供了物理上下文。
21.3 DreamZero 的数字为什么引起关注?
你给的材料里提到,DreamZero 报告了几个很醒目的结果:
- 新任务 / 新环境泛化相对 SOTA VLA 有超过 2× 的提升;
- 将 14B 级视频扩散模型优化到 7Hz 闭环控制;
- 用 10–20 分钟 video-only 数据做跨本体 / 人机迁移;
- 用 30 分钟 play data 做新 embodiment 适配。
这些都属于论文作者自评,不是统一第三方复现结果,所以应该谨慎看。
但它背后的趋势值得重视:
WAM 阵营正在尝试证明,视频先验真的能减少机器人动作数据需求。
这是一个比单纯 benchmark 提高几个点更重要的问题。
22. 代表模型三:X-WAM,开始认真解决“动作要快,世界要精细”的矛盾
X-WAM 这篇我觉得工程味很浓。
它关注一个非常现实的问题:
如果把未来视频和动作完全同步 diffusion:
视频需要很多去噪步
动作也被迫等很多步
那机器人怎么实时?
于是 X-WAM 提出了:
Asynchronous Noise Sampling,ANS。
直觉上就是:
Action:
少几步
先出来
尽快执行

Video:
多几步
慢慢生成
保持质量
也就是让:
“行动”和“想象”使用不同节奏。
这个设计其实非常符合机器人系统需求。
因为人类本身也不是每 20ms 都做一次高清世界模拟。
很多低层动作可以快速执行。
只有高层规划需要更完整的未来预测。
22.1 X-WAM 还做了 4D world modeling
它另外一个明显方向是:
不满足于 2D RGB。
而是预测:
multi-view RGB-D
也就是把未来世界往:
4D world
推进。
这里的 4D 可以粗略理解为:
3D 空间
+
时间变化
为什么重要?
因为机器人真正操作的是三维世界。
如果只预测单视角 RGB,很容易出现:
画面看起来合理
但几何不一致
例如:
机械臂绕到物体背面时,模型发现:
原来物体背面结构根本没建对。
这对生成视频可能还能糊弄。
对机器人抓取就不行了。
所以 WAM 后续一个很可能的重要方向就是:
2D video prediction
       ↓
3D / 4D world prediction
你提供的材料里,X-WAM 报告了在 RoboCasa 和 RoboTwin 2.0 上的成功率,以及超过 5800 小时机器人数据预训练,但同样属于作者自评,应当和第三方 benchmark 区分开看。
23. GR00T N2:工业界已经开始把 WAM 当下一代机器人架构讲了
NVIDIA 这边也很有意思。
GR00T N1 / N1.5 / N1.7 更偏 VLA 谱系。
而你提供的 WAM 调研材料里提到:
GR00T N2 被 NVIDIA 描述为 built on a world action model architecture。
这件事本身比具体 benchmark 更值得看。
因为它说明:
WAM 已经不是纯学术圈里的 taxonomy。
大厂开始主动用这个词重新定义下一代机器人 foundation model。
NVIDIA 对 WAM 的工程描述里有一个点我非常喜欢:
不一定需要生成完整未来图像,而是预测一个压缩的 intended transition representation,然后直接从这个表征推出机器人动作。
这其实再次印证了前面的观点:
World Model 不等于高清未来视频。
工业系统最后大概率会越来越 latent。
因为控制环对 latency 太敏感。
24. 所以 WAM 真正想解决什么?
讲了这么多模型,其实可以把 WAM 的野心压缩成一句话:
让机器人的动作生成建立在“对动作后果的预测”上。
传统 VLA:
我看到这个状态
所以我输出这个动作
WAM:
我看到这个状态

我知道几种动作分别可能导致什么未来

因此我选择这个动作
这两个范式看起来只多了一步。
但其实差很多。
因为第二种开始具备:
- counterfactual reasoning;
- planning;
- failure anticipation;
- recovery;
- uncertainty-aware control;
这些能力的基础。
25. 数据问题:为什么 WAM 特别喜欢视频?
WAM 和 VLA 最大的数据差异之一,是:
WAM 对无动作标签视频更有兴趣。
传统 imitation 策略模型 最喜欢的是:
observation
+
language
+
expert action
因为它要学:
这个状态下应该怎么做
而 World Model 想学的是:
世界是怎么变化的
所以即便没有机器人 action label,大规模视频仍然有价值。
26. WAM 的四类数据来源
按照你提供的 WAM 调研材料,可以把数据大体分成四种。
26.1 Robot Teleoperation
最标准的数据:
image
state
action
language
优点:
动作标签完整。
缺点:
贵。
这类数据最适合训练:
action generation
inverse dynamics
robot-specific dynamics
26.2 Human Demonstration
例如:
- UMI;
- 第一视角操作;
- 手持设备采集。
它们的优势是:
比机器人遥操作便宜很多。
但问题:
人类动作和机器人动作空间完全不一样。
所以通常需要:
retargeting
latent action
inverse dynamics
进行桥接。
26.3 Simulation
仿真数据是 World Model 天然喜欢的数据。
因为:
state
action
future state
physics
全都有。
而且可以疯狂收集:
success
failure
collision
recovery
random exploration
尤其对于 world model 来说:
失败数据其实很有价值。
因为它需要学:
什么动作会导致坏结果。
而不只是模仿成功答案。
26.4 Internet / Egocentric Video
这是最有想象空间的一类。
比如:
一个人收纳折叠桌。
视频里面没有机器人动作标签。
但它包含大量信息:
- 桌子铰链怎么运动;
- 什么部位可以抓;
- 折叠之后几何怎么变化;
- 人如何处理卡住的问题。
这些都是:
世界动态。
如果模型能从视频中抽取 latent action 或运动表征,就可以把这些视频纳入 world pretraining。
这也是 WAM 相比纯 VLA 最吸引人的地方之一:
它试图把互联网规模的“世界变化数据”转成机器人先验。
27. 为什么 Play Data 可能比纯 Expert Demo 更适合 World Model?
这是一个非常容易被忽略的点。
假设我们要训练机器人打开一个很重的工业箱门。
Expert Demo 可能长这样:
抓住把手
稳定拉开
任务完成
非常干净。
但 World Model 真正需要知道的是:
抓偏会怎样?
力量不足会怎样?
门卡住会怎样?
拉得太快会怎样?
中途松手会怎样?
这些内容通常不会出现在漂亮的专家轨迹里。
所以对于 world model:
失败
试探
随机动作
恢复
反而很有价值。
可以把二者理解成:
Expert Demo:
告诉模型“正确答案是什么”

Play Data:
告诉模型“这个世界的规律是什么”
第二篇材料也用了一个很形象的说法:
expert demo 更像答案,play data 更像物理实验记录。
这个比喻我觉得非常准确。
28. 评测:一个 World Model 看起来真实,不代表它能控制机器人
这是 World Model 最容易掉进去的坑。
做视频生成的人喜欢看:
- FVD;
- LPIPS;
- PSNR;
- SSIM。
问题是:
视频长得漂亮,
不等于:
物理正确。
更不等于:
动作可执行。
例如机器人要把一块金属板插入狭窄卡槽。
模型生成的视频非常丝滑:
金属板顺利插入
但真实几何里:
厚度比卡槽宽 2 mm
这个未来视频再漂亮也没意义。
所以 WAM 的评测必须比普通视频生成更严格。
29. WAM 的三维评测思路
你提供的 WAM 综述把评测拆成三个维度:
Visual Fidelity

Physical Commonsense

Action Plausibility
我觉得这三个维度非常合理。
29.1 Visual Fidelity
先问:
看起来像不像真的?
例如:
- 物体有没有突然消失;
- 图像有没有糊掉;
- 长时序有没有崩;
- 多视角是否一致。
这是传统生成模型最熟悉的一层。
29.2 Physical Commonsense
再问:
物理上成立吗?
比如:
机器人把一大摞箱子推倒。
视频生成看起来很真实。
但如果箱子:
穿过地面
那就明显不行。
机器人 World Model 最终需要学习:
- 接触;
- 重力;
- 摩擦;
- 遮挡;
- 刚体;
- 柔性体;
- 工具交互。
这其实比视觉 realism 难得多。
29.3 Action Plausibility
最后问:
这个动作真的能执行吗?
有些生成模型可能预测:
机械臂下一帧已经移动到目标位置
视觉上完全没问题。
但机械臂:
关节速度不允许
或者:
路径穿过障碍物
那就是 action implausible。
所以机器人 World Model 最终不能只是“未来视频生成器”。
它必须理解:
embodiment constraints。
30. 成功率还重要吗?
当然重要。
最终机器人还是要:
任务成功
所以:
- LIBERO;
- CALVIN;
- RoboCasa;
- RoboTwin;
- ManiSkill;
这些传统 success rate benchmark 仍然非常重要。
但 WAM 多了一个要求:
不能只看最终结果。
还要看:
模型为什么认为这个动作会成功?
因为它有一个显式或隐式世界预测过程。
这带来一个很有意思的可能性:
未来机器人 failure analysis 不只是:
任务失败
而可以进一步拆:
世界预测错了?

还是动作解码错了?

还是执行控制错了?
这是 WAM 一个潜在的可解释性优势。
31. WAM 当前最大的几个问题
说了这么多优点,下面该泼点冷水了。
WAM 现在离“统一解决机器人问题”还远。
几个问题都挺硬。
32. 问题一:实时性
这是最直接的。
视频模型:
越大
越慢
机器人:
越慢
越容易出事
Manipulation 有些任务:
5 Hz
10 Hz
还能接受。
Locomotion:
可能需要:
50 Hz
100 Hz
你不可能每次都跑一个几十亿参数的视频 diffusion。
所以未来很可能是:
大 World Model
      ↓
高层规划
      ↓
轻量策略模型
      ↓
快速低层控制
或者:
World Model
训练时用

策略模型
推理时用
这也是为什么像 RynnVLA 那种:
训练阶段用未来预测塑造表征,推理阶段不真正展开未来状态预测
的思路,也非常有竞争力。
你提供的 WAM 调研也专门强调了这种对比:
预测当训练先验

vs

预测当策略主体
这可能是未来几年非常关键的一条分岔路。
33. 问题二:World Model 会幻觉
语言模型会幻觉。
视频模型一样会。
而 World Model 幻觉比语言模型更危险。
语言模型说错一句话:
可能只是答案错。
机器人 World Model 如果“想象错未来”:
错误未来
↓
错误动作
↓
真实硬件执行
可能直接造成碰撞。
所以 WAM 最终一定要解决:
- uncertainty;
- confidence estimation;
- out-of-distribution detection;
- safety filter。
这不是锦上添花。
这是部署必需品。
34. 问题三:长时序预测很难
短期预测和长期规划完全不是一个难度。
预测:
200 ms 后
很容易。
预测:
20 秒之后
就难很多。
尤其多步骤任务:
打开柜子
↓
取出工具
↓
关柜子
↓
移动到工作台
↓
安装零件
前面一个错误可能影响后面所有状态。
这也是 World Model 长期存在的问题:
compounding error。
未来可能需要:
- hierarchical planning;
- subgoal;
- periodic re-planning;
- memory;
- closed-loop correction;
而不是一次性把未来预测到任务结束。
35. 问题四:RGB 远远不够
目前很多 World Model / WAM 强烈依赖视觉。
但真正精细的机器人操作,需要:
- proprioception;
- force;
- tactile;
- torque;
- depth;
- audio。
例如机器人拧紧螺丝。
光靠视觉很难知道:
到底有没有拧紧。
真正决定结果的可能是:
torque curve
再比如:
插孔任务。
视觉上看已经插进去了。
但触觉告诉你:
其实卡在边缘
所以未来 WAM 很可能要从:
Vision-Action Model
变成:
Multimodal World-Action Model
WAM 综述也明确指出,目前的路线整体仍然过度 RGB-centric,而触觉、力觉、本体感知等模态仍然不足。
36. 问题五:跨 Embodiment 真的能统一吗?
这是 WAM 最诱人的梦想之一。
如果模型学到的是:
世界变化规律,
那它应该比纯 action 策略模型 更容易跨机器人。
例如任务:
把一个长纸箱从地面移动到货架。
不同 embodiment:
双臂机器人
人形机器人
移动机械臂
动作空间完全不同。
但是世界结果是类似的:
箱子从地面
移动到货架
这也是视频 / world representation 的优势。
因为:
goal world state
比:
joint action
更加 embodiment-agnostic。
所以很多 WAM 工作都喜欢强调:
- human-to-robot;
- robot-to-robot;
- cross embodiment。
但这件事现在更多还是论文自评。
离真正“一个模型控制所有机器人”还有很大距离。
37. WAM 会取代 VLA 吗?
这是我觉得现在最容易被标题党带偏的问题。
我的判断是:
不会简单取代,更可能是融合。
原因很简单。
WAM 自己也需要输出动作。
所以它没有理由把 VLA 的能力扔掉。
更现实的演化是:
VLA
+
World Prediction
+
Memory
+
Planning
最后融合成更强的 Embodied Foundation Model。
你可以把今天很多技术看成:
VLA:
负责行动能力

World Model:
负责未来预测能力

LLM / VLM:
负责语义和任务理解

Memory:
负责长期状态

RL:
负责在线优化
最终它们可能全部融合在一起。
WAM 只是其中一个非常重要的融合方向。
你给出的 WAM 调研最后也做出了类似判断:
WAM 更可能是 VLA 的扩展与吸收,而不是简单取代。
这个判断我基本同意。
38. 我更看好的最终系统:分层,而不是一个模型全包
虽然现在“大统一模型”很性感,但如果让我猜真实机器人最终工程架构,我反而更看好分层。
可能长这样:
Language / VLM
      |
      v
Task Reasoning
      |
      v
World Model / WAM
      |
      v
Future Prediction
+
High-Level Action
      |
      v
快速机器人策略
      |
      v
Low-Level Controller
      |
      v
Motor
也就是:
高层
负责:
- 任务理解;
- 长期规划;
- 世界想象;
- subgoal。
频率可能:
0.5 ~ 5 Hz
中层
负责:
- manipulation skill;
- trajectory;
- action chunk。
频率可能:
5 ~ 20 Hz
低层
负责:
- force control;
- impedance;
- locomotion;
- safety。
频率可能:
50 ~ 1000 Hz
这种架构更符合机器人本身的多时间尺度特性。
并不是所有决策都需要一个 14B World Model。
39. 一个我觉得特别重要的趋势:World Model 正在从 simulator 变成 策略模型
如果把过去十年的路线连起来,会发现一个特别有意思的变化。
最早:
World Model
是 策略模型 旁边的模拟器。
后来:
策略模型
开始在 World Model 里训练。
现在:
World Model + 策略模型
开始合并。
可以粗略画成:
2018

World Model
    ↓
Dream
    ↓
Controller
然后:
2020+

World Model
    ↓
想象式多步预测
    ↓
Actor-Critic
再到:
2025+

World Model
+
Action Model
        ↓
      WAM
也就是说:
“理解世界”和“行动”正在从两个模块,逐渐变成一个统一建模问题。
这也是为什么 WAM 值得关注。
它可能不是最后答案。
但它很可能代表一个非常重要的趋势。
40. 真正的长期目标:Agent 要拥有 Counterfactual World
如果继续往远看,我觉得 World Model 最终最重要的能力不是:
视频生成。
也不是:
next frame prediction。
而是:
counterfactual reasoning。
也就是:
如果我这么做,会怎样?

如果换一个动作呢?

如果失败了呢?

如果环境突然变化呢?

如果另一个 Agent 介入呢?
一个真正强的机器人应该可以:
生成多个可能未来
↓
比较风险
↓
选择行为
↓
观察真实结果
↓
更新内部世界
这时候它才真正拥有一个:
“可交互的内部世界”。
41. World Model、VLA、WAM,到底怎么记?
如果看到这里已经开始概念混乱,可以记一个最简单的版本。
VLA
问:
我现在应该做什么?
Observation + Language
        ↓
      Action
World Model
问:
我这样做以后会发生什么?
Observation + Action
        ↓
   Future State
WAM
问:
未来会怎样,以及我应该怎么做?
Observation + Language
        ↓
Future State + Action
就这么简单。
42. World Model 的几条路线,可以怎么选?
如果你是做研究,其实没必要被“World Model”这个大词吓住。
它下面至少有几条完全不同的路线。
路线一:Video World Model
关注:
未来世界长什么样?
适合:
- 视频生成;
- simulator;
- robot data generation;
- high-level planning。
路线二:Latent World Model
关注:
未来状态 representation 如何变化?
适合:
- 高效 planning;
- control;
- representation learning。
路线三:State Dynamics
关注:
物理状态如何变化?
适合:
- locomotion;
- manipulation;
- model-based RL;
- MPC。
路线四:3D / 4D World Model
关注:
空间几何如何长期一致?
适合:
- robot manipulation;
- navigation;
- digital twin;
- spatial intelligence。
路线五:World Action Model
关注:
世界变化和动作能不能一起建模?
适合:
- robot foundation model;
- 零样本策略;
- cross-embodiment learning。
43. 如果现在入坑,我会怎么学?
如果是刚开始接触这个方向,我不建议第一天就研究 DreamZero 这种十几 B 的 WAM。
那样大概率会:
看论文觉得很牛,代码完全跑不动,最后只剩下读摘要
更合理的路线是:
Dreamer
↓
TD-MPC
↓
简单 Action-Conditioned Dynamics
↓
Video Prediction
↓
VLA
↓
WAM
先真正理解:
state
action
next state
这三个东西之间的关系。
然后再研究:
video token
latent action
joint diffusion
会容易很多。
第二篇材料同样建议新手先从 DreamerV3、TD-MPC2、小规模 action-conditioned dynamics 和 VLA baseline 开始,再读 DreamZero、Motus、DreamDojo 等 foundation-scale 工作。
44. 最后一个问题:WAM 会不会只是又一个新名字?
这个问题其实挺合理。
AI 圈特别喜欢重新命名。
比如:
Dynamics Model
World Model
World Foundation Model
Action World Model
World Action Model
Video Action Model
有时候确实只是 taxonomy 越来越复杂。
但我觉得 WAM 背后有一个真正值得注意的变化:
机器人基础模型的训练目标正在发生变化。
以前:
预测动作
现在开始加入:
预测未来状态
+
预测动作
也就是从:
What should I do?
变成:
What will happen,
and what should I do?
这个变化是真实存在的。
至于最后行业会不会继续叫 WAM,其实没那么重要。
46. 总结
如果把整篇文章压缩成几个核心观点,大概是下面这些。
World Model 最早来自 Model-Based RL。
它解决的问题一直是:
能不能让 Agent 在真实行动之前预测未来?
Dreamer 让智能体在 latent space 中 imagination。
MuZero 告诉我们:
世界模型不一定需要重建真实世界,只要对决策有用。
JEPA 又进一步强调:
与其预测所有像素,不如预测更抽象的未来表征。
后来视频生成模型快速发展,大规模视频开始成为一种新的“世界动态数据”。
与此同时,机器人领域的 VLA 已经证明:
Vision + Language -> Action
是一条有效路线。
但 VLA 的短板也越来越明显:
它更擅长“看到以后做什么”,而不是“做了以后会发生什么”。
于是 World Action Model 开始出现。
它试图把:
World Modeling
+
Action Generation
统一起来。
最终学习:
future world
+
future action
的联合分布。
这也是 DreamZero、UWM、X-WAM、GR00T N2 等最近工作背后的共同方向。
如果说 VLA 给机器人的是:
反应能力。
那么 WAM 想补上的,是:
想象能力。
而一个真正强的物理世界 Agent,最终很可能同时需要:
感知
+
语言理解
+
世界模型
+
记忆
+
规划
+
动作
+
反馈
所以我并不认为未来一定是:
WAM 替代 VLA
更可能是:
VLA
      +
World Model
      +
Planning / Memory / RL

          ↓

更完整的 Embodied Foundation Model
再往后,模型内部也许不会再严格区分:
哪部分是 world model,哪部分是 策略模型。
“想象未来”和“选择动作”可能只是同一个模型的两种推理模式。
到那时候,机器人行为链路可能不再只是:
看到
↓
行动
而是:
看到
↓
理解
↓
想象多个未来
↓
判断后果
↓
选择行动
↓
观察真实结果
↓
修正内部世界
这大概也是 World Model 最值得期待的地方。
它并不是为了让机器人生成一段更漂亮的视频。
而是为了让机器人在真正接触物理世界之前,
先在自己的内部世界里试一次。
延伸阅读
如果希望继续深入,可以优先关注以下几条论文脉络:
- Ha & Schmidhuber — World Models
- PlaNet / Dreamer 系列
- MuZero
- I-JEPA / V-JEPA / V-JEPA 2
- Genie / Genie 2
- NVIDIA Cosmos
- Unified World Models(UWM)
- DreamZero
- X-WAM
- World Action Models: The Next Frontier in Embodied AI
很赞,是WM/WAM入门地图
@NOTA6 感谢,是的,参考了很多很多资料