
可观测性工程概要:从系统输出理解内部状态
01|可观测性到底是什么:从系统输出理解内部状态
系统报错时,我们常说“先看日志”。如果日志里没有答案,就继续看指标、查链路,甚至临时修改代码再发布一次。这种排查方式有个明显的问题:我们只能回答系统提前准备好回答的问题。
可观测性试图改变这件事。
一个容易误解的词
可观测性最早来自控制理论,指根据系统外部输出推断内部状态的能力。放到软件工程中,可以把它理解为:
不需要重新修改和发布代码,仅凭系统已经产生的数据,就能调查此前没有预料到的问题。
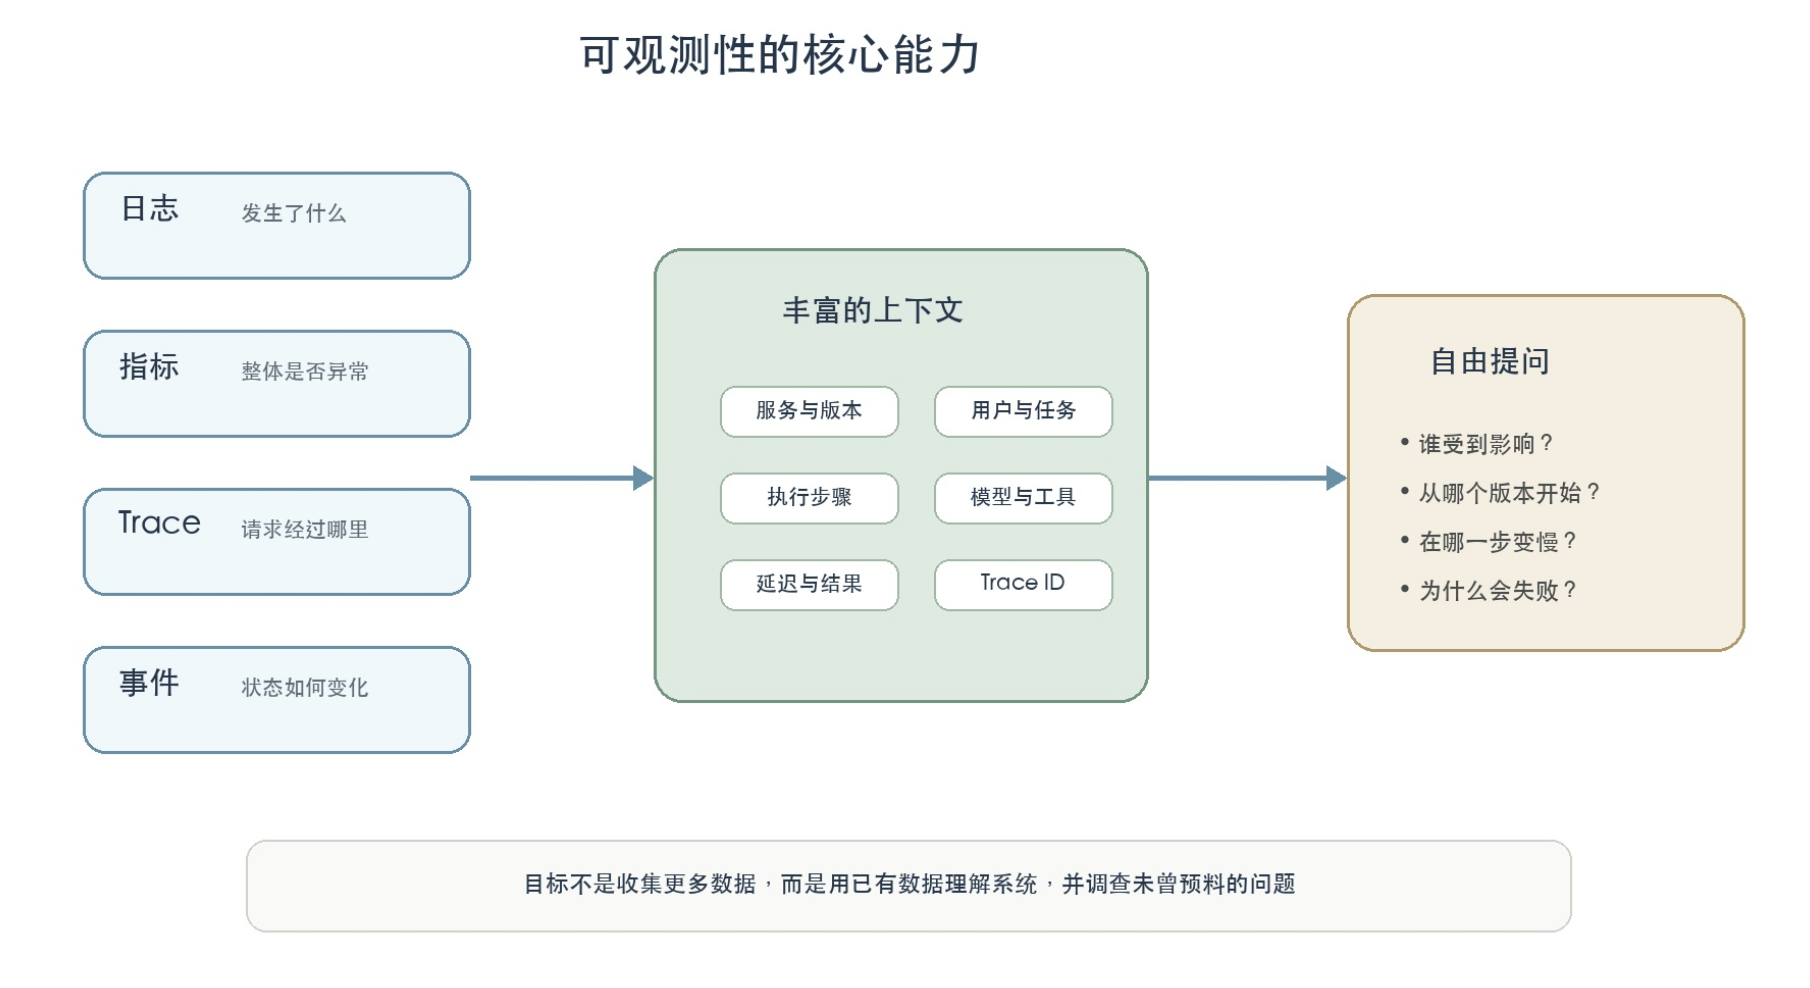
目标不是“收集数据”,而是理解系统。日志很多、仪表盘很漂亮,并不代表系统具有良好的可观测性。如果只能查询预先设计好的几个指标,我们看到的仍然只是有限的窗口。
一个简单案例
假设一个 Agent 的平均响应时间从 5 秒升到 12 秒。一个普通仪表盘可以确认延迟变高,却未必能解释原因。
具备可观测性的系统应该允许我们继续切分数据:
- 哪一种任务最慢?
- 是否只影响某个 Agent 版本?
- 延迟发生在模型调用还是工具调用?
- 是否只有使用某个模型的任务受到影响?
- 重试次数和上下文长度有没有变化?
这些问题通常无法在故障前完整列出。因此,系统不能只保存平均值,还要保留足够细的事件和上下文。
现实挑战:延迟升高到底是谁的问题
模型变慢、Harness 重试、工具超时、上下文增长和 Memory 检索都可能造成相同现象。
现象—假设—证据—判断
现象:Agent 延迟从 5 秒升到 12 秒。假设包括模型退化、工具变慢、重试增加。证据显示模型单次耗时没有变化,但失败任务平均调用模型三次,且都发生在 Memory 返回空结果之后。判断:主要问题是检索失败触发了 Harness 重试,而不是模型接口变慢。
修复后还要验证检索命中率、重试次数和最终任务成功率是否同时恢复。
维度与基数决定调查能力
一次 Agent 运行可以记录任务类型、模型版本、工具名称、执行步骤、用户类型、延迟、Token 数和结果状态。每一个字段都是观察系统的维度。
字段越丰富,我们切分数据的角度越多。task_id、user_id 和 trace_id 这类字段取值很多,属于高基数数据。它们不适合直接成为传统指标标签,却对定位单次异常非常重要。
所以,可观测性工程不是简单追求“更多数据”,而是在调查能力、成本和隐私之间做设计:
低基数字段 → 指标聚合与告警
高基数字段 → Trace 与结构化事件
敏感原文   → 受控保存或不采集
可观测性是一种系统能力
日志、指标和链路追踪只是数据形态,不是最终目标。真正重要的是它们能否关联起来。
收到一次失败告警后,我们应该能找到受影响的任务,再沿着同一个 Trace 查看它经过的步骤,最后定位到具体模型、工具或依赖服务。数据如果彼此割裂,再多的工具也只能让工程师在不同页面之间来回猜测。
因此,可观测性需要同时考虑遥测生成、上下文传播、数据处理、关联查询,以及调查结果如何反馈到开发流程。
对 Agent 软件意味着什么
Agent 的结果具有不确定性,同一个输入可能因为模型、上下文、工具状态和规划路径不同而产生不同结果。只看成功与失败,很难解释它为什么这样行动。
我们需要观察的不是一个孤立请求,而是一段执行过程:
任务 → 规划 → 模型调用 → 工具调用 → 重试 → 最终结果
每一步都应该能够回答三个问题:做了什么、用了多长时间、结果如何。必要时,还要知道它属于哪个任务、由哪一步触发、使用了哪个版本。
小结
可观测性不是某个产品,也不是日志、指标和 Trace 的简单组合。它是一种从系统输出理解内部状态,并能够调查未知问题的工程能力。
判断系统是否真正具备可观测性,可以问自己一句:
当一个从未见过的问题发生时,我们能否用现有数据还原过程并解释原因?
如果答案是否定的,下一步不是盲目增加仪表盘,而是重新检查遥测数据是否保留了足够的上下文。