
LLM 大语言模型AI Agent理解与问答测评与对齐推理优化
Agent可观测性参考架构
09|Agent可观测性参考架构:把方法、规范与诊断连接起来
学完概念和规范,最后要回答一个实际问题:怎样让 Agent 的每次任务都可关联、可调查,同时控制性能、成本和隐私?
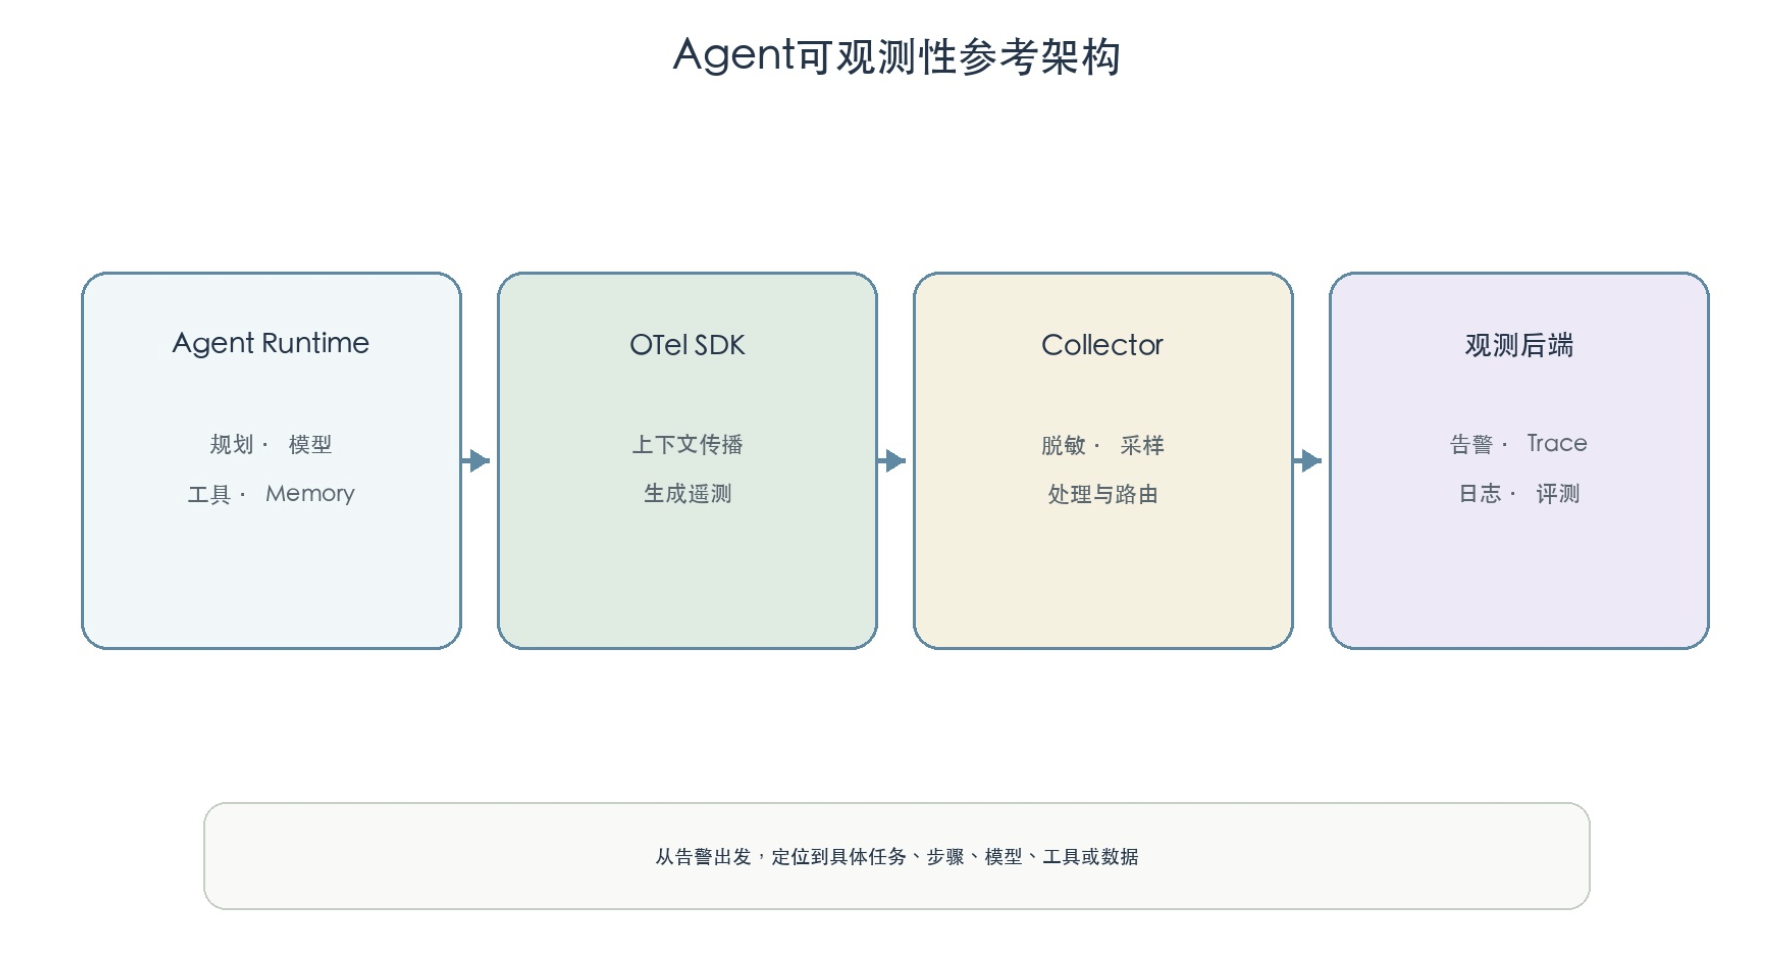
架构分成四层
Agent Runtime
  ↓ OTel API / SDK
OTLP
  ↓
Collector:批处理、脱敏、采样、路由
  ↓
Metrics / Traces / Logs / Evaluation Backend
运行层记录任务、规划、模型、工具、Memory 和评测;SDK 负责上下文传播与导出;Collector 统一处理;后端分别承担告警、单次调查和质量分析。
一个简单案例
报告 Agent 出现“偶发漏掉关键数据”。监控先发现完成率下降;通过 task_id 找到失败 Trace;Trace 显示搜索工具返回成功,但 Harness 的 Schema 校验事件失败;对应日志给出缺失字段;版本属性表明问题只发生在工具 v2。
这条链路完成了从整体趋势到单次根因的收敛。
现实挑战:每一层都可能制造假象
模型输出错误可能是上游 Memory 召回了错误信息;工具失败可能是 LLM 接口适配层丢失参数;Trace 缺失可能是 Collector 过载;质量下降也可能只是评测规则改变。
现象—假设—证据—判断
现象:新模型上线后任务完成率下降。假设包括模型退化、Prompt 不兼容、工具协议差异、评测版本变化。证据显示离线回放中两种模型结果接近,线上失败集中在流式工具调用,适配层没有合并分片参数。判断:主要原因是 LLM 接口适配,而不是新模型能力下降。
上线前检查清单
- 是否用
task_id、run_id和 Trace ID 串联任务; - 是否记录 Agent、Prompt、模型、工具和评测版本;
- 工具是否有 Schema、版本和标准错误结构;
- 是否观测上下文 Token、截断和 Memory 候选;
- Collector 是否有队列、重试、丢弃和容量告警;
- 是否区分技术成功与任务成功;
- 是否有脱敏、采样和保留期限。
小结
好的架构不是收集最多数据,而是让团队能够沿着证据逐层缩小范围。最终目标是:从一个告警出发,定位到具体任务、步骤、模型、工具或数据,并用对照实验确认根因。
点赞收藏