
CoorDex: Coordinating Body and Hand Priors for Continuous Dexterous Humanoid Loco-Manipulation阅读分析
一、整个工作的总体框架
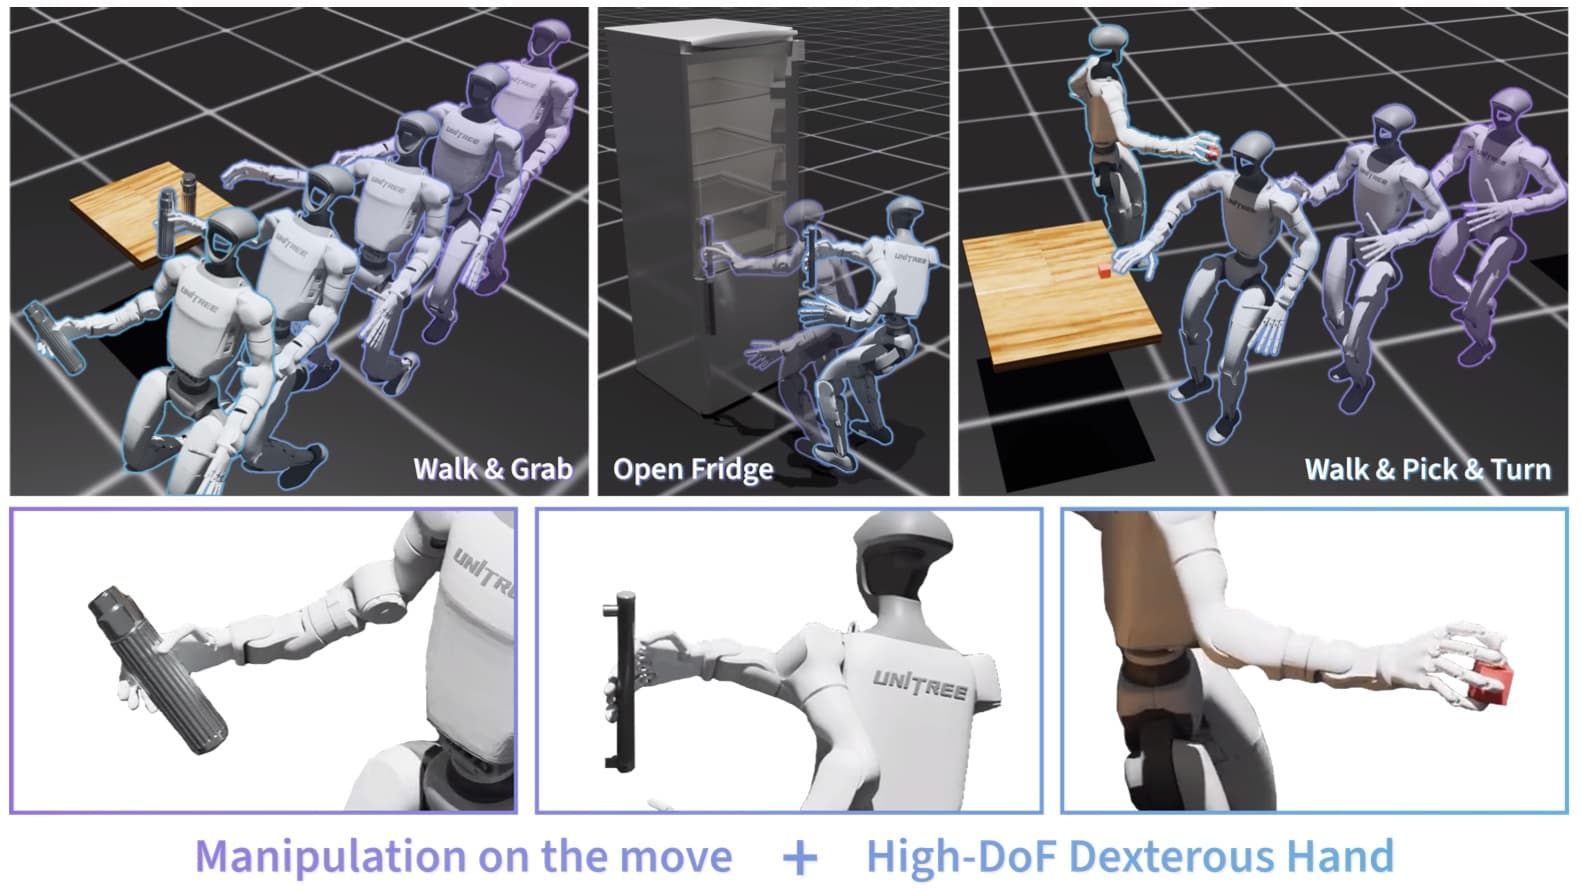
这篇论文关注的是人形机器人在持续移动过程中完成灵巧操作的问题。传统的人形移动操作通常会把任务拆成“走到目标前、停下来操作、操作完成后再继续走”三个阶段。CoorDex 希望把这三个阶段真正连起来,让机器人在前进、后退或转身的同时完成抓取、开门和搬运。
这类任务的难点并不只是关节数量多。机器人一边走路一边抓物体时,脚步、骨盆、躯干、手臂、手腕和手指需要在同一时刻配合。手腕的位置由全身运动共同决定,手指又需要对物体形成精细接触。如果直接让一个 PPO 同时探索 G1 的 29 个身体关节和 WUJI 手的 20 个手指关节,策略很容易学会走到物体附近,却很难形成可靠抓取,或者干脆减速停下来,把问题退化成静态操作。
论文的基本解决思路是先把“身体怎么自然运动”和“手指怎么自然配合”分别学出来,再让下游策略只负责根据具体任务对这两类基础能力做修正。身体与手部在表示层面分开,在任务决策层面共享信息,最终通过两个独立的 residual head 分别修正身体 latent 和手部 latent。
1.1 四个阶段的工作关系
| 阶段 | 主要工作 | 输入 | 给下一阶段的内容 | 实现目标 |
|---|---|---|---|---|
| 第一阶段:动作收集 | 在仿真中收集全身移动操作参考动作和手部抓取动作 | 遥操作指令、行走控制器、人手与机器人模型 | 身体参考轨迹、手部参考轨迹 | 准备可被跟踪和蒸馏的动作数据 |
| 第二阶段:Teacher 训练 | 分别训练 Body Teacher 和 Hand Teacher 跟踪参考动作 | 当前状态、参考目标、训练阶段特权信息 | 能够输出高质量身体或手指关节目标的 Teacher | 先得到稳定、准确的动作专家 |
| 第三阶段:先验蒸馏 | 用 Encoder、Prior 和 Decoder 压缩 Teacher 的动作能力 | Teacher 动作、参考目标、本体感知 | Body Prior、Body Decoder、Hand Prior、Hand Decoder | 形成低维、可部署、可复用的 latent 动作空间 |
| 第四阶段:下游 Policy 训练 | 用 residual PPO 在两个先验上学习任务修正 | 本体感知、物体状态、接触状态、两个 prior mean | 身体 latent residual、手部 latent residual | 在保留自然动作的基础上完成具体移动操作任务 |
1.2 整体信息流
1. 先通过仿真遥操作和已有控制器生成身体、手腕和手指的参考动作。
2. 分别训练身体 Teacher 和手部 Teacher,使两个专家能够准确跟踪各自的参考动作。
3. 将两个 Teacher 的动作能力分别压缩到低维 latent 空间,并训练只依赖本体感知的 Prior 与把 latent 还原成关节动作的 Decoder。
4. 冻结两个 Prior 和两个 Decoder,训练下游 Actor-Critic PPO。Actor 不直接输出关节位置,而是输出身体和手部两个 latent residual。
5. 将 residual 加到 Prior 给出的默认 latent 上,再经过对应 Decoder,得到最终身体关节位置目标和手指关节位置目标,最后交给 PD 控制器执行。
| 核心分工 |
|---|
| Prior 负责提供自然动作的基础,PPO 负责根据目标与接触状态做任务修正,Decoder 负责把修正后的 latent 还原为可执行的关节位置目标。 |
二、第一阶段:收集身体与手部动作
CoorDex 没有从零开始让 PPO 随机探索所有身体和手指动作,而是先准备具有明确结构的参考轨迹。这里的数据收集分成全身动作和灵巧手动作两条线。这样做的原因是两类动作的动力学职责不同:身体负责稳定移动、伸手和放置手腕,手部负责形成手型、闭合手指和维持接触。
2.1 全身参考动作的收集
全身动作在 Isaac Lab 中通过仿真遥操作生成。下肢行走由基于 AGILE 的 locomotion controller 提供,操作者通过 Apple Vision Pro 输入右手腕和手部动作。人手的腕部目标先转换为机器人末端目标,再通过 Pink 逆运动学求解器转换成 G1 的手臂和全身关节姿态。
这条数据链最终不仅记录手臂动作,还记录与手腕放置相关的下肢、骨盆和躯干运动。因为在人形机器人上,手腕是否能准确到达物体附近,往往取决于脚步时序、身体朝向、躯干前倾和手臂伸展的共同作用。
· 下肢部分:由稳定的行走控制器生成连续移动。
· 腕部部分:由操作者通过 XR 设备给出目标位姿。
· 手臂与全身部分:通过逆运动学将腕部目标转换为机器人可执行姿态。
· 最终输出:与目标机器人形态匹配的全身关节轨迹和身体关键部位轨迹。
2.2 手部参考动作的收集
手部参考动作采用 ManipTrans 风格的手—物体数据。人手动作先表示为 MANO 关键点和关节运动,再通过优化式 dex-retargeting 转换到 WUJI 灵巧手。这个过程得到的是与具体物体交互相关的手指运动,例如张手、预抓取、拇指对掌、其他手指闭合和维持抓取。
手部动作收集阶段有一个重要处理:手腕运动不交给 Hand Teacher 学习。训练时,参考手腕位置和速度被直接写入仿真,Hand Teacher 只控制 20 个主动手指关节。这样可以避免手部 latent 的表示能力被六维手腕运动占用,使它更集中地表达手指之间的协同关系。
2.3 第一阶段向后续提供什么
第一阶段最终提供两类参考数据。第一类是身体参考轨迹,包含行走、躯干、手臂和手腕放置;第二类是手部参考轨迹,重点描述在已知手腕运动条件下的手指关键点和关节动作。下一阶段不直接把这些轨迹作为最终策略,而是用它们分别训练两个能够稳定跟踪动作的 Teacher。
三、第二阶段:训练 Body Teacher 与 Hand Teacher
Teacher 的作用是先把参考动作变成稳定、可执行的机器人控制能力。它们不是最后部署的策略,而是后续蒸馏阶段的动作专家。两个 Teacher 都使用 PPO Actor-Critic 训练,但训练环境、输入信息和输出关节不同。
3.1 Body Teacher
Body Teacher 负责 G1 的 29 个身体关节,覆盖下肢、躯干、手臂和手腕相关关节,不控制手指。它要回答的问题是:在当前身体状态下,为了跟踪给定的全身参考动作,下一步各个身体关节应该到什么位置。
Actor 的输入主要包括当前身体本体感知和参考动作目标。本体感知包含基座角速度、身体关节位置、身体关节速度和上一时刻动作,并使用多帧历史帮助网络判断步态相位和动作趋势。参考目标包含当前需要跟踪的身体姿态、关键部位位置、姿态和速度等信息。
Critic 在训练阶段还可以看到更完整的跟踪误差和参考状态,因此能够更准确地判断当前状态价值。Teacher 的输出是 29 维归一化关节位置目标,经过动作缩放后由底层位置控制器执行。
· 输入:身体本体感知历史、参考动作目标、训练阶段辅助信息。
· 输出:29 个身体关节的位置目标。
· 训练目标:稳定跟踪行走、躯干、手臂和手腕参考动作,同时避免摔倒、异常接触和动作抖动。
· 向下一阶段提供:高质量 Body Teacher action。
3.2 Hand Teacher
Hand Teacher 在 floating-hand 环境中训练。手腕由参考轨迹直接驱动,因此 Teacher 不需要解决手腕到达问题,只需要专注于手指关键点和关节动作。它回答的问题是:在当前手指状态和给定参考手型下,20 个手指关节下一步应该如何运动。
Hand Teacher 的输入由参考手部目标、手部本体感知和上一时刻动作组成。参考目标包括 MANO 关键点位置和速度,以及相对手腕的参考信息。本体感知包括手腕坐标系下的线速度和角速度、手指关节位置、手指关节速度。Critic 还可以看到更完整的关键点误差。
Hand Teacher 的输出是 20 个主动手指关节的位置目标。训练奖励强调指尖关键点跟踪,并提高指尖权重,同时约束关节功率和动作变化。如果关键点误差过大或状态异常,episode 会提前终止。
· 输入:参考手指关键点、手腕运动信息、手指关节状态、上一动作。
· 输出:20 个手指关节的位置目标。
· 训练目标:在手腕已知的条件下准确重现手指预成形、闭合和抓取动作。
· 向下一阶段提供:高质量 Hand Teacher action。
3.3 两个 Teacher 的关系
两个 Teacher 是分开训练的。Body Teacher 学习“如何把手腕送到合适位置”,Hand Teacher 学习“手腕到位后,手指如何形成合适接触”。这种不对称分工是后续先验组合的基础。它不是简单地按机器人模型把身体和手切开,而是按照实际控制职责,把腕部放置归到身体侧,把多指接触归到手部侧。
四、第三阶段:蒸馏 Teacher,构造两个 latent 先验
Teacher 虽然能准确跟踪参考动作,但它依赖参考目标和训练阶段的完整信息,不能直接作为下游任务的通用动作接口。论文因此将每个 Teacher 蒸馏成三个网络:Encoder、Prior 和 Decoder。Body 与 Hand 使用相同的蒸馏逻辑,但各自拥有独立网络和 latent 空间。
4.1 Encoder:有参考目标的动作编码器
Encoder 的输入包含本体感知和当前参考目标。它看到的信息最完整,因此能够判断当前参考动作应该被编码成哪个 latent。Encoder 不直接输出关节动作,而是输出 latent 高斯分布的参数,包括均值和不确定性。训练时从这个分布中取样 latent,再交给 Decoder 重建 Teacher 动作。
从功能上看,Encoder 负责把不同动作组织到低维技能空间。例如不同的步态相位、手臂伸展和抓取手型会落在 latent 空间的不同区域。它的优势是能够利用参考目标准确区分动作,但缺点是部署时没有这些参考目标,因此它只在蒸馏训练阶段使用。
4.2 Prior:只依赖本体感知的 latent 预测网络
Prior 从网络形式上也可以看成一个 encoder,但它只接收部署时能够获得的本体感知。它输出与 Encoder 相同格式、相同维度的 latent 分布。Body Prior 根据多帧身体状态预测 16 维身体 latent,Hand Prior 根据手腕速度和手指状态预测 12 维手部 latent。
Prior 回答的问题是:不再提供参考动作时,仅根据机器人当前状态,一个合理、自然的默认动作 latent 应该是什么。它不负责理解瓶子、门把手或者任务目标,只负责维持从 Teacher 中继承的基础运动模式。
4.3 Decoder:把 latent 还原成 Teacher action
Decoder 接收本体感知和 latent,输出与 Teacher 相同格式的关节位置目标。Body Decoder 输出 29 维身体动作,Hand Decoder 输出 20 维手指动作。Decoder 学到的是 latent 与整组关节协调动作之间的对应关系。
这一点决定了下游策略可以在低维 latent 空间探索。PPO 不再需要分别尝试每个关节,而是修改一个已经包含关节协同关系的 latent,再由 Decoder 生成完整动作。
4.4 三个网络在蒸馏阶段的配合
1. Teacher 根据当前参考动作产生关节位置目标,作为蒸馏的监督信号。
2. Encoder 读取本体感知和参考目标,输出较准确的 latent 分布。
3. Prior 只读取本体感知,输出另一个同维度 latent 分布。
4. 训练时从 Encoder 分布得到 latent,并与本体感知一起送入 Decoder。
5. Decoder 输出动作,要求尽量重建 Teacher action。
6. 同时约束 Encoder 和 Prior 的分布接近,使训练结束后可以用 Prior 替代 Encoder。
五、蒸馏阶段的 Loss 与最终保留内容
蒸馏阶段主要包含三类 Loss。它们分别解决动作重建、时间连续性和训练信息与部署信息不一致的问题。
5.1 Action Reconstruction Loss
这一项要求 Decoder 输出接近 Teacher 的动作。它回答的问题是:低维 latent 加上本体感知,能不能恢复出原来 Teacher 的高维关节目标。
如果这一项学不好,latent 虽然维度低,但无法保留 Teacher 的动作能力,下游策略即使找到合适 latent,也不能得到正确关节动作。因此它是保证先验动作质量的基础。
5.2 Temporal Smoothness Loss
这一项约束相邻时刻的 Encoder latent 均值不要突然跳变。它回答的问题是:连续动作在 latent 空间中是否也保持连续。
机器人动作本身是时间连续的,如果相邻状态被编码到相距很远的 latent 区域,Decoder 输出容易抖动,下游 residual policy 也难以学习稳定修正。平滑约束使动作阶段在 latent 空间中形成连续轨迹。
5.3 KL Loss
KL Loss 用来让 Encoder 根据完整参考目标得到的 latent 分布,接近 Prior 只根据本体感知预测的 latent 分布。它解决的是训练与部署信息不一致的问题。
如果没有这一项,Encoder 可以依赖参考目标形成一套 Prior 无法预测的编码方式,Decoder 在训练时仍然能很好地重建动作,但部署时换成 Prior 后,latent 会落到 Decoder 不熟悉的位置,动作质量会明显下降。KL 约束要求 Encoder 不要使用 Prior 无法复现的任意表示,同时推动 Prior 学会从本体状态预测 Encoder 使用的 latent 空间。
5.4 蒸馏完成后留下什么
蒸馏完成后,Encoder 的任务已经结束,因为下游任务不再提供原始参考动作目标。论文保留并冻结以下内容:
· Body Prior:根据身体本体感知历史输出默认身体 latent mean。
· Body Decoder:将修正后的身体 latent 解码为 29 维身体关节位置目标。
· Hand Prior:根据手腕速度和手指状态输出默认手部 latent mean。
· Hand Decoder:将修正后的手部 latent 解码为 20 维手指关节位置目标。
· 观测归一化参数:保证下游使用的本体感知与蒸馏训练时保持一致。
Encoder、Teacher 和蒸馏阶段的参考目标不会进入下游 PPO 的实际控制链。下游使用的是已经冻结的 Prior 和 Decoder。
六、第四阶段:训练 Coordinated Latent Residual Policy
第四阶段才开始学习具体的 walk-grasp、open-fridge 和 walk-pick-turn 任务。此时身体与手部的基础动作能力已经存在,下游 PPO 的任务是根据物体、目标和接触状态,决定要在两个默认 latent 上分别修改多少。
6.1 PPO Actor 的输入
Actor 的 observation 由本体感知、先验状态和任务信息组成。不同任务的物体项略有变化,但主体结构一致。
· 身体本体感知历史:基座角速度、29 个身体关节位置、关节速度和上一时刻身体动作,多帧堆叠用于判断步态相位和运动趋势。
· 手部本体感知:手腕坐标系下的线速度和角速度、20 个手指关节位置、关节速度和上一时刻手部动作。
· 两个 Prior 的 latent mean:告诉 PPO 当前两个先验默认准备执行什么动作。
· 上一时刻的 latent residual:帮助策略保持时间连续,并判断上一帧已经做过哪些修正。
· 任务状态:当前任务阶段、目标位置、目标朝向、projected gravity 等。
· 物体相对几何:物体相对机器人根部、相对手掌的位置和姿态,以及桌子、门和把手等状态。
· 指尖接触信息:五个指尖与目标物体或把手的接触力。
这些输入使 PPO 能够同时回答两个问题:身体是否需要改变步态、躯干和手腕放置;手指是否需要改变预成形、闭合程度和接触保持。
6.2 Actor 为什么输出两个 residual latent
Actor 实际输出的是一个 28 维动作,但结构上分成 16 维身体 residual latent 和 12 维手部 residual latent。它不是直接输出两个完整 latent,更不是直接输出 49 个关节位置。
之所以分成两部分,是因为前面已经建立了两个不同的 latent 空间和两个不同的 Decoder。身体 latent 表达步态、躯干、手臂和手腕放置,手部 latent 表达多指预成形、闭合和接触。这两类动作需要共享任务判断,但不适合强行通过一个完全混合的输出路径。
网络先用 shared coordination trunk 处理所有任务信息,得到统一的协调特征,再通过 Body Head 和 Hand Head 分别输出两个 residual。这样身体和手部知道自己处于同一任务阶段,但仍保留各自的控制权限。
6.3 Prior 怎么产生,Policy 怎么修正
每个控制周期,冻结的 Body Prior 和 Hand Prior 先读取当前本体感知,分别给出一个默认 latent mean。这个默认值可以理解为当前状态下最符合 Teacher 动作分布的基础动作。
PPO Actor 看到物体位置、目标状态、接触信息和两个 prior mean 后,输出身体和手部的 latent 修正量。最终送入 Decoder 的不是单独的 Prior,也不是单独的 residual,而是默认 latent 与 residual 的组合。
例如在边走边抓瓶子的过程中,Body Prior 负责维持自然前进,Body residual 让躯干和手腕向瓶子做小幅调整;Hand Prior 提供自然手型变化,Hand residual 根据瓶子相对手掌的位置和指尖接触情况完成预抓取与闭合。
6.4 Critic 的作用
阶段四仍然是标准 Actor-Critic PPO。Actor 输出两个 latent residual,Critic 输入当前观测并估计状态价值。Critic 不生成动作,也不直接修改 latent,它通过评价当前状态未来可能获得的累计奖励,为 Actor 提供 advantage 信号。
如果某次 residual 使机器人在保持平衡和前进的同时形成了更稳定的接触,实际回报会高于预期,这类动作概率会被提高;如果 residual 导致手腕偏离、物体掉落或机器人失衡,这类动作会受到抑制。
6.5 各个模块根本上回答什么问题
| 模块 | 根本上回答的问题 | 实际作用 |
|---|---|---|
| Body Prior | 按当前身体状态,正常情况下身体应该怎么继续运动? | 提供自然步态、躯干、手臂和手腕运动的默认 latent |
| Hand Prior | 按当前手腕和手指状态,正常情况下手指应该怎么继续运动? | 提供多指协同的默认 hand latent |
| Coordination Trunk | 身体和手现在共同处于什么任务阶段,应如何配合? | 融合目标、物体、接触、状态与 prior 信息 |
| Body Residual Head | 为了完成当前任务,身体和手腕需要在默认动作上改多少? | 输出 16 维 body latent residual |
| Hand Residual Head | 为了形成或保持接触,手指需要在默认动作上改多少? | 输出 12 维 hand latent residual |
| Body Decoder | 修正后的身体 latent 对应哪些身体关节位置? | 输出 29 维 body joint target |
| Hand Decoder | 修正后的手部 latent 对应哪些手指关节位置? | 输出 20 维 hand joint target |
| Critic | 当前状态以及 Actor 的行为是否有利于未来完成任务? | 估计状态价值,辅助 PPO 更新 Actor |
6.6 最终 body pos 和 hand pos 是怎么得到的
1. Body Prior 根据身体本体感知输出 16 维默认身体 latent mean。
2. Hand Prior 根据手部本体感知输出 12 维默认手部 latent mean。
3. Actor 分别输出 16 维身体 residual 和 12 维手部 residual。
4. 将身体 residual 加到身体 prior mean,将手部 residual 加到手部 prior mean。
5. Body Decoder 接收身体本体感知和修正后的身体 latent,输出 29 个身体关节位置目标。
6. Hand Decoder 接收手部本体感知和修正后的手部 latent,输出 20 个手指关节位置目标。
7. 两部分关节目标插入统一动作向量,手部动作再经过平滑处理,最后交给 Isaac Lab 的 joint-position action 和底层 PD 控制器执行。
冻结关系:阶段四只更新下游 PPO 的 Actor 和 Critic。两个 Prior、两个 Decoder 以及观测归一化参数保持冻结,避免下游任务训练破坏已经学到的身体运动和手指协调能力。
七、论文最有价值的内容
7.1 按控制职责拆分身体与手部
论文最重要的不是简单地把 49 维动作降成 28 维,而是重新定义了身体与手部的职责边界。手腕位置由全身运动产生,因此交给 Body Prior;Hand Prior 只处理手指。这个划分减少了手部 latent 对腕部六维运动的负担,使它更专注于指间协调和接触。
7.2 用先验把高维随机探索变成有结构的动作探索
直接关节空间 PPO 需要从大量无意义关节组合中碰到有效抓取。CoorDex 先用 Teacher 数据学习 Decoder,使 latent 的变化对应整组协调关节动作。下游 PPO 探索的是“动作模式的修正”,而不是单个关节的随机变化,因此高自由度灵巧操作变得可训练。
7.3 共享协调、独立输出
身体和手不能完全独立,因为它们需要对同一个目标和接触状态作出一致判断;也不能完全混合,因为步态和手指接触的控制特点不同。Shared trunk 加 separate heads 的结构正好处在两者之间:高层共享任务理解,低层分别控制身体和手。
7.4 Residual 方式保留基础能力
下游 Policy 不是重新生成整套动作,而是在 Prior 的默认 latent 上做修正。这样训练初期即使 residual 很小,机器人也能保持较自然的动作;PPO 只需要学习物体与任务带来的增量变化,降低了破坏步态和手型先验的风险。
7.5 对长时序任务的训练启发
论文在 walk-pick-turn 中使用 NoDemoRSI,把策略自己到达的阶段状态保存下来,再从这些状态继续训练。这说明对于需要连续完成多个子目标的任务,除了网络结构,还需要解决后半段长期得不到训练信号的问题。它提供了一种不依赖专家中间状态的课程学习思路。
八、总结
CoorDex 的完整工作逻辑是:先收集身体和手部参考动作,再分别训练两个 tracking Teacher;随后通过 Encoder、Prior 和 Decoder 将两个 Teacher 的动作能力压缩为低维先验;最后冻结两个 Prior 和两个 Decoder,用 Actor-Critic PPO 根据任务状态输出身体与手部 latent residual,并将修正后的 latent 解码为最终身体和手指关节位置目标。
论文真正解决的是高自由度身体与灵巧手联合控制的可训练性问题。它不是让一个网络从零生成全部动作,而是把自然运动、手指协同和任务修正分配给不同模块。最值得借鉴的是手腕与手指的职责划分、先验动作空间、共享协调与独立 residual head,以及用下游 residual 学习具体目标的思路。
参考文献:CoorDex: Coordinating Body and Hand Priors for Continuous Dexterous Humanoid Loco-Manipulation