
DAJI:不再让控制器被动补救,用可执行的运动意图驱动人形机器人
自然语言正在成为人形机器人最直观的交互方式。
一句"向前走,然后右转挥手",听起来只是一个简单指令,但在真正的闭环控制里,这句话背后藏着非常复杂的身体准备逻辑:
- 什么时候开始转移重心?
- 哪只脚先成为支撑脚?
- 转身之前角动量如何调整?
- 新指令切换时,上一段动作留下的姿态和速度又怎么"接上"?
这些问题都不是"当前这一帧该摆成什么姿势"就能回答的。也正因为如此,语言到人形机器人控制的关键,不只是生成一个看起来合理的动作,而是要找到一个能同时连接语言、生成模型与闭环控制器的中间接口。

来自香港科技大学(广州)、LimX Dynamics、山东大学等机构的团队提出了 DAJI(Dynamics-Aligned Joint Intent) 框架来回答这个问题。它的核心主张很简单:不要只生成需要被追踪器"修补"的外部参考,而是生成可执行、可预判的 joint-intent latent。
**论文链接:https://arxiv.org/abs/2605.14417 **
**项目链接:https://hxxxz0.github.io/DAJI_PAGE/ **
项目代码:https://github.com/Hxxxz0/DAJI
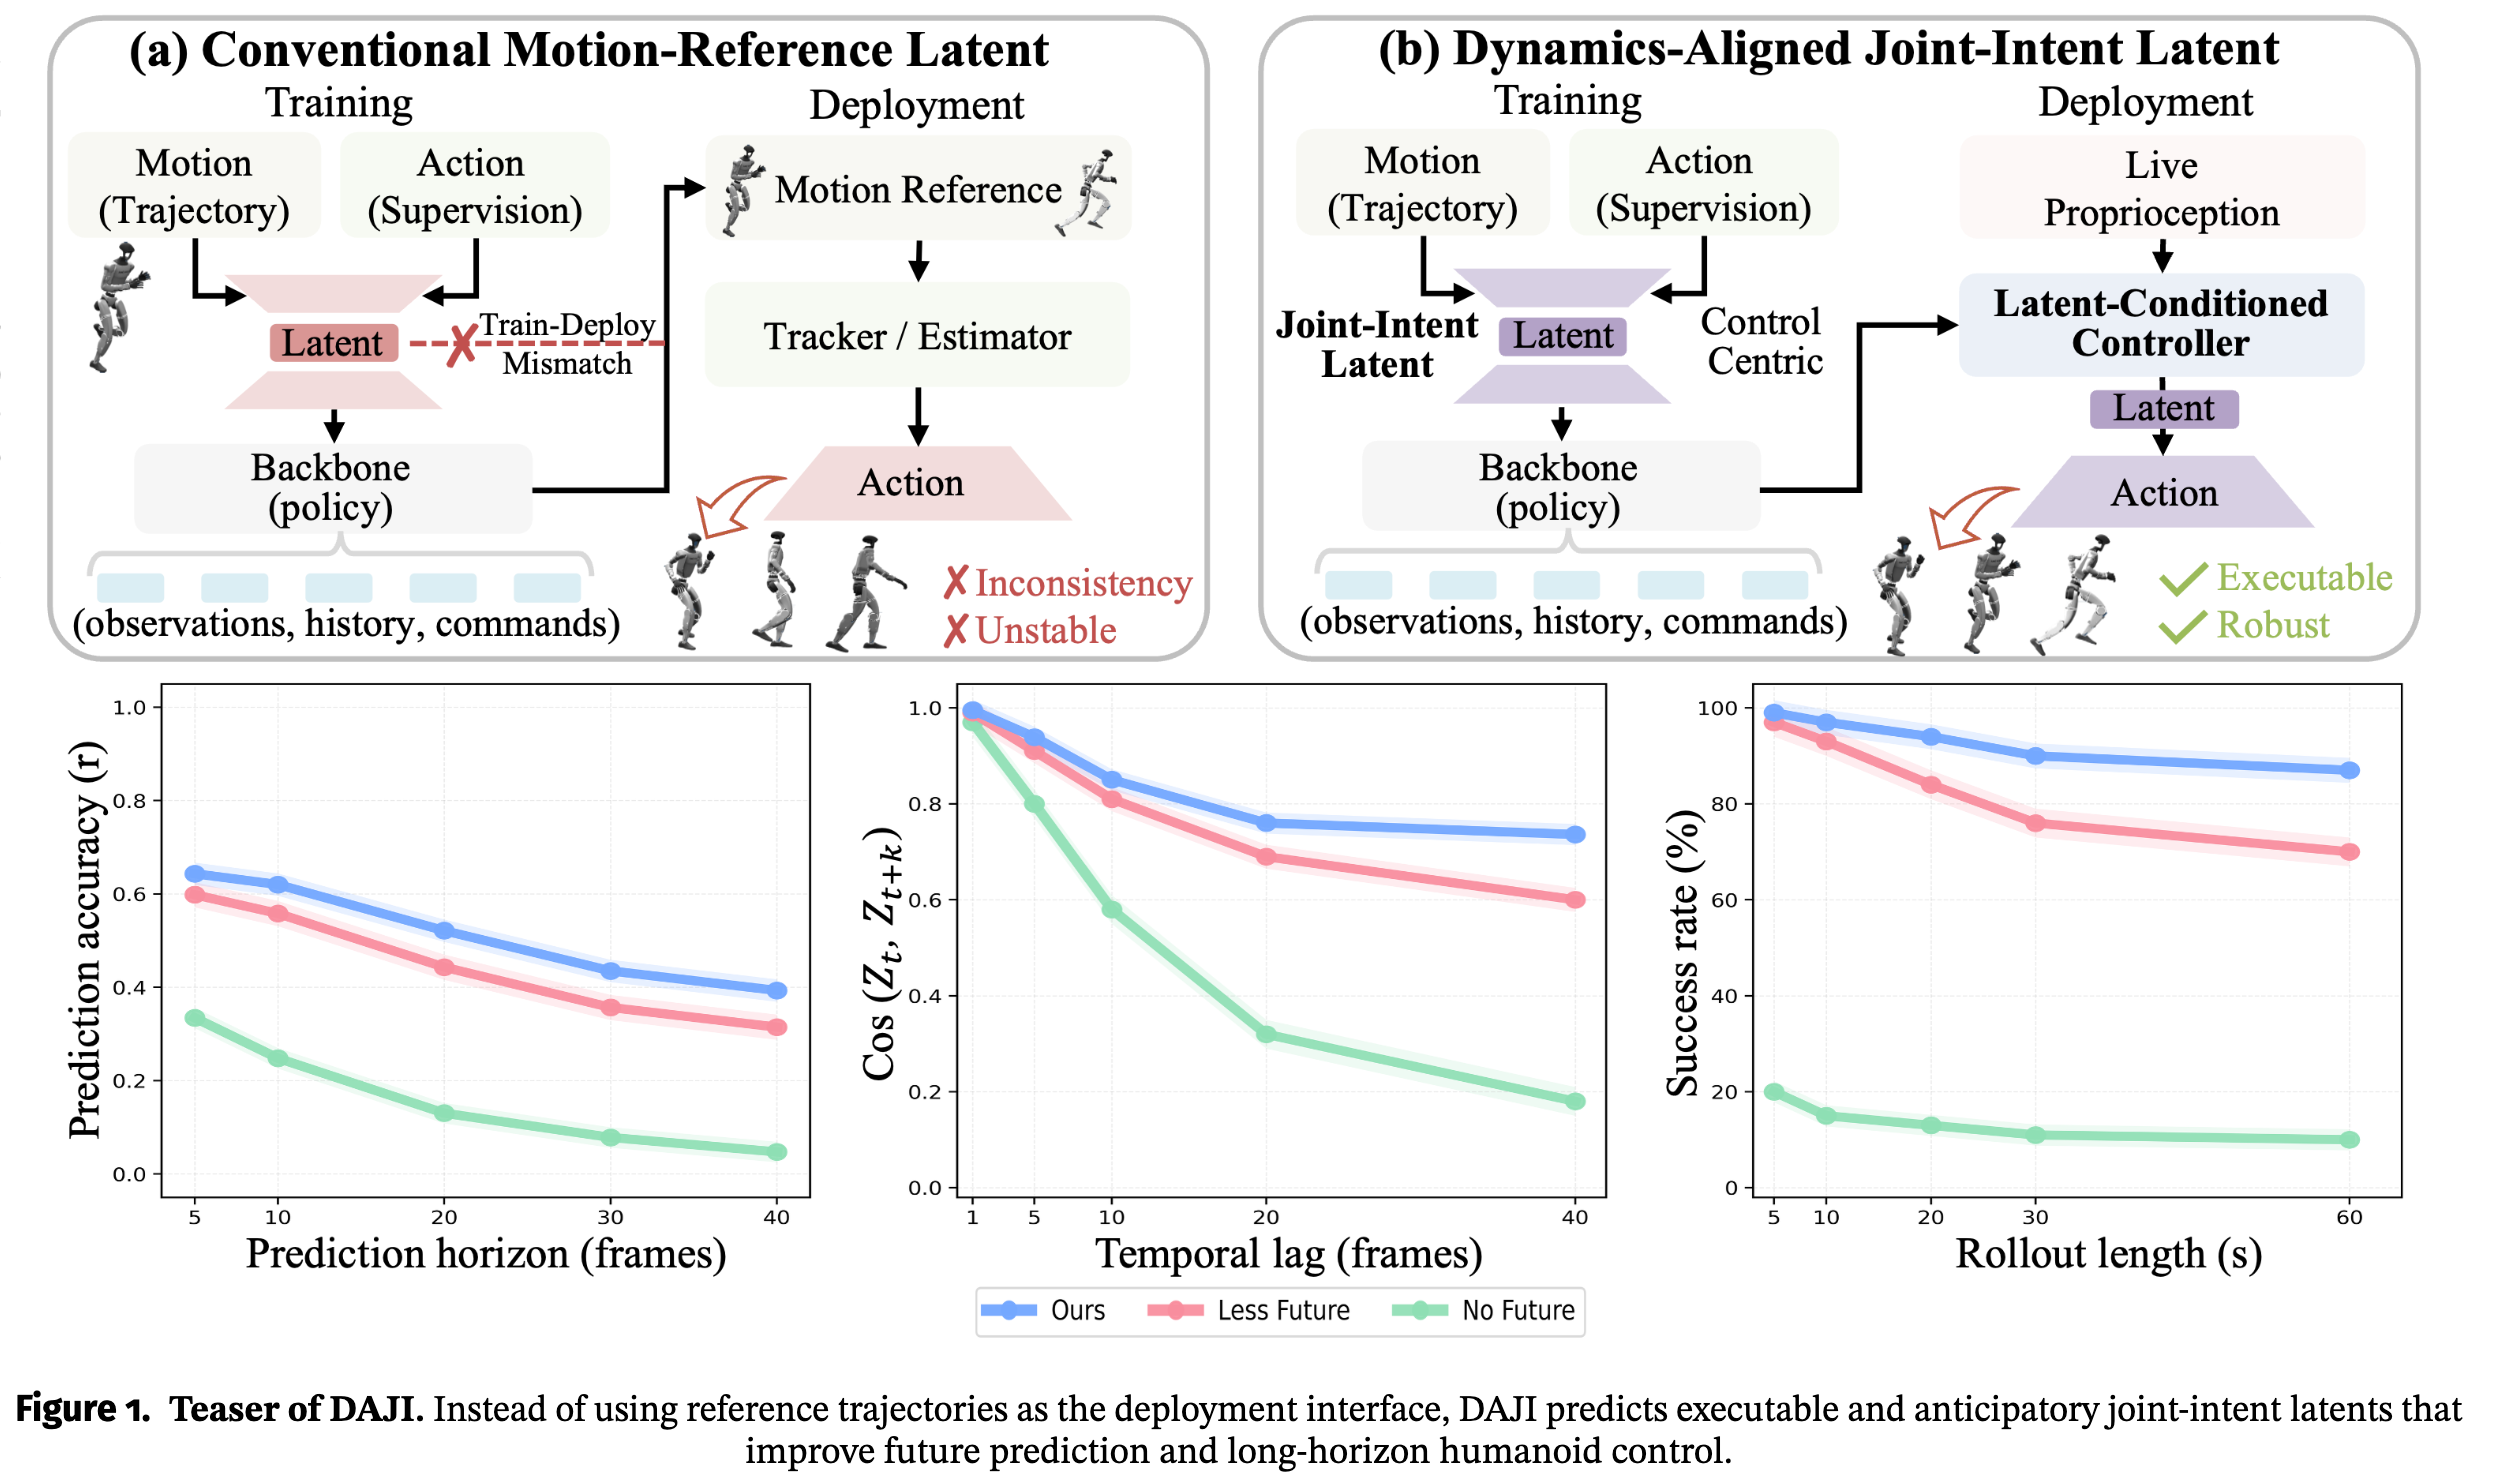
图 1:DAJI 的核心观点:不要只生成需要被追踪器“修补”的外部参考,而是生成可执行、可预判的 joint-intent latent。
现有方法卡在哪里
过去几年,文本到动作生成和人形机器人运动控制都进步很快。
主流做法是一套很自然的模块化流程:先由语言条件生成模型产生运动参考,再由低层 tracking policy 把这段参考跟踪到具体机器人上,如果参考与当前机器人状态不一致,控制器就在执行时尽量"修补"。
这套流程做出了很多令人印象深刻的结果,但它有一个根本性的隐患——**生成模型输出的是"想要的外部轨迹",而控制器真正需要的是"当前身体状态下可执行、且为未来过渡做准备的运动意图"。**两者之间存在天然的接口鸿沟。
在短动作里这个问题可能还不明显,但一旦进入长时序的 streaming 设置,问题会被持续放大。因为每一段动作的执行,都会改变机器人的接触状态、身体姿态、速度和重心。下一段动作不是从"干净的初始状态"开始的,而是从上一段真实执行之后的身体状态继续的。
DAJI 想补上的,正是 generation 与 execution 之间这条被长期忽视的裂缝。
关键在于换一个输出
DAJI 想回答的问题不是"怎样让文本生成的动作更像人",而是一个更基础的问题:语言生成模型到底应该输出什么,才能被人形机器人在闭环动力学中稳定执行?
答案是把 generator 的输出从外部 motion reference 替换为 joint-intent latent。这个 latent 需要同时满足两件事:
一是能被低层控制器结合实时本体感觉马上解码成稳定的关节动作;
二是不只描述当前动作,还要编码接下来可能发生的接触切换、支撑转移和身体过渡。
这与人类运动中的预期性姿态调整有些类似。人起跳前会先下蹲,转身前会提前调整支撑脚——真正的动作出现之前,身体其实已经开始为下一步做准备。DAJI 希望机器人也能学会这种"提前量"。
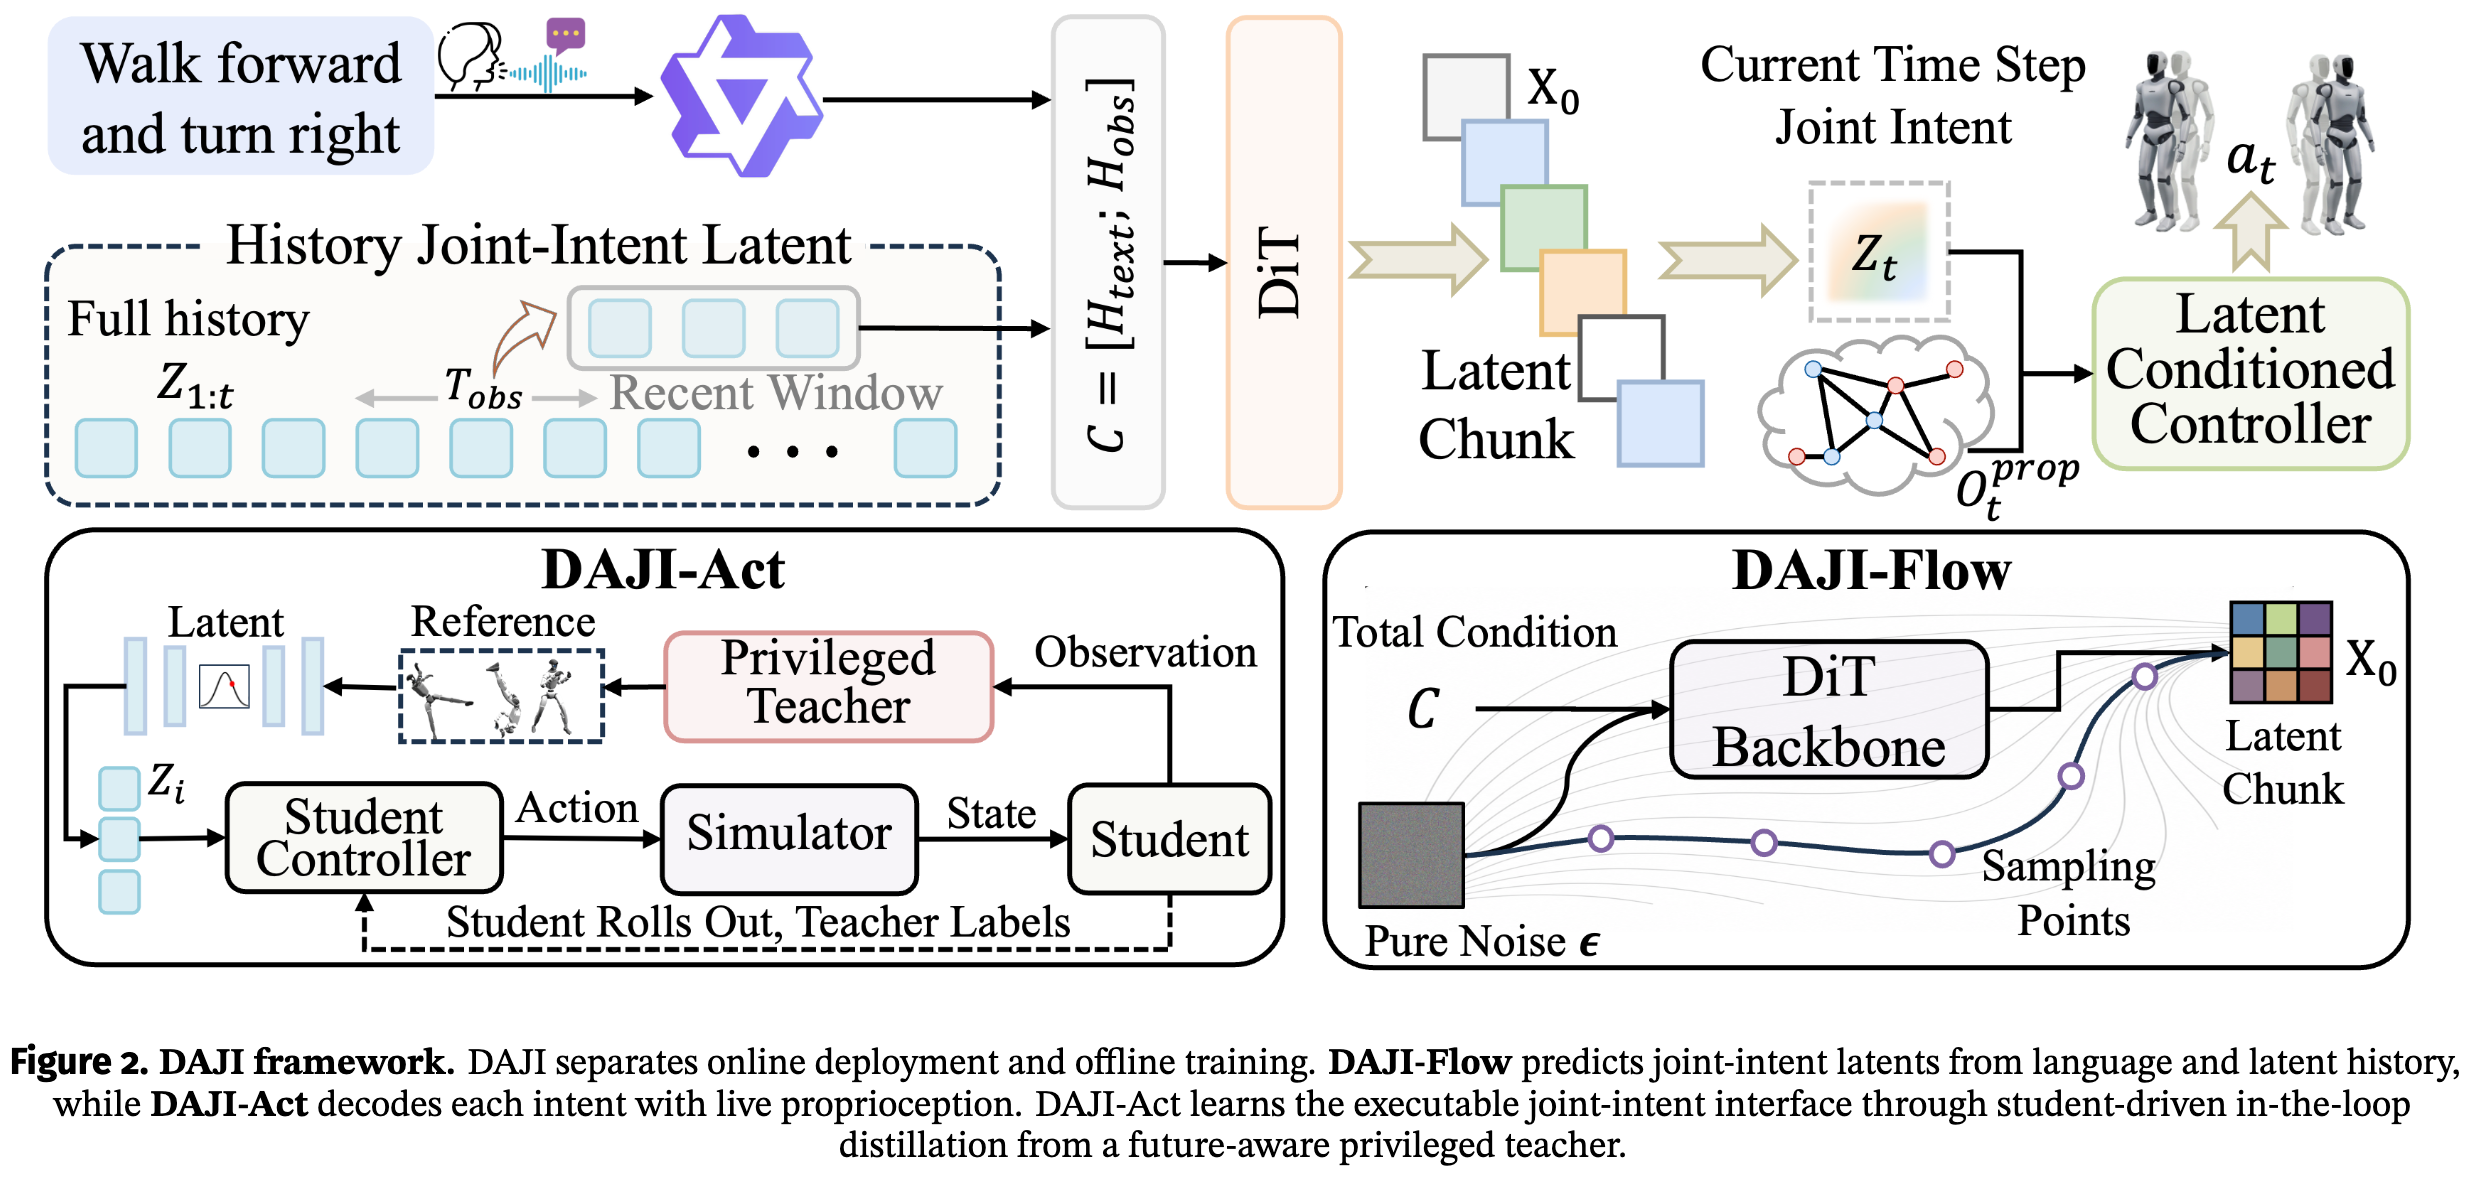
图 2:DAJI 框架。DAJI-Flow 低频生成 future joint-intent chunks;DAJI-Act 在控制频率下结合 live proprioception 将 latent 解码为关节动作。
三个设计,一套新框架
第一,把"运动参考"换成 dynamics-aligned joint intent。
DAJI 里的语言生成模型不再输出需要被 tracker 追踪的姿态序列,而是输出一段通过控制器交互学习出来的 joint-intent latent。
它对生成模型来说足够紧凑,可以被 flow matching 模型连续预测;对控制器来说又足够具体,可以和实时本体感觉一起解码成动作;对长时序执行来说,它还携带了未来转移所需的 anticipatory 信息,而不是只描述当前状态。
第二,DAJI-Act 通过 future-aware teacher 学会"可执行的意图"。
DAJI-Act 是负责将 joint-intent latent 解码为关节动作的低层执行模块。
它先训练一个 future-aware privileged teacher,让 teacher 在训练阶段可以看到多时间尺度的未来参考帧,相当于一个"知道未来要发生什么"的控制专家。然后通过 student-driven in-loop distillation 让 DAJI-Act 学习这种未来感知行为——训练时让 student policy 自己驱动 simulator,再由 frozen teacher 在同一个状态上给出目标动作。
这意味着 DAJI-Act 学到的 intent interface 是在自己的闭环 rollout 分布上训练出来的,而不是只在理想 reference 分布上拟合出来的。
第三,DAJI-Flow 用 flow matching 生成可连续执行的 intent chunks。
有了可执行的 joint-intent space 之后,语言条件运动生成就变成了一个更适合 streaming control 的问题:
给定语言指令和最近已经执行过的 intent history,预测下一段 future intent chunk。
DAJI-Flow 采用 language-conditioned flow matching DiT,以自回归方式不断预测未来的 latent chunks,每个 chunk 对应 50Hz 控制频率下的 0.3 秒,形成"低频生成意图、高频解码动作"的双层控制结构。为了让 generator 更早适应自己的历史分布,DAJI 还引入了 scheduled self-conditioning,从而在指令切换和长时序延展中保持更好的连贯性。
实验结果
DAJI 的实验并不只看离线文本-动作指标,因为对人形机器人来说,一个生成结果如果不能被闭环控制器稳定执行,再好看也没有意义。
所以实验关注三个问题:
- joint-intent latent 本身是不是一个可部署的 execution interface?
- future-aware latent 是否真的比 reactive/state-like latent 更有用?
- 在单指令生成和长时序 streaming instruction following 中,DAJI 是否同时提升语义对齐、连续性和成功率?
表 1:HumanML3D-style 单指令机器人动作生成主结果
| Method | MM-D↓ | R@1↑ | R@2↑ | R@3↑ | FID↓ | Div↔ | MM↑ | Succ.(%)↑ |
|---|---|---|---|---|---|---|---|---|
| GT | 0.968 | 0.720 | 0.878 | 0.919 | 0.000 | 1.372 | -- | 100.00 |
| GT (Sim) | 1.002 | 0.687 | 0.847 | 0.900 | 0.059 | 1.320 | -- | 94.50 |
| TextOp | 1.175 | 0.425 | 0.595 | 0.698 | 0.225 | 1.228 | 0.628 | 90.00 |
| DAJI | 1.093 | 0.549 | 0.711 | 0.796 | 0.147 | 1.291 | 0.847 | 94.42 |
在 HumanML3D-style 单指令生成上,DAJI 达到 94.42% rollout success,并取得 0.147 FID。这里的重点不是只在 text-motion metric 上更好,而是生成结果经过机器人执行链路后依然保持较高成功率。
表 2:BABEL 长时序 streaming instruction following
| Method | Subseq R@3↑ | Subseq FID↓ | Subseq Div↔ | MM-D↓ | Trans FID↓ | Trans Div↔ | PJ↓ | MJ↓ |
|---|---|---|---|---|---|---|---|---|
| GT | 0.654 | 0.000 | 1.299 | 1.299 | 0.000 | 1.182 | 0.043 | 0.015 |
| GT (Sim) | 0.625 | 0.059 | 1.287 | 1.157 | 0.054 | 1.153 | 0.090 | 0.022 |
| TextOp | 0.287 | 0.538 | 0.985 | 1.514 | 0.594 | 0.784 | 0.231 | 0.156 |
| DAJI | 0.443 | 0.152 | 1.219 | 1.237 | 0.236 | 1.033 | 0.115 | 0.054 |
在 BABEL 长时序场景里,优势更加明显。
因为这里不只是生成一个独立动作片段,而是要从自己之前生成并执行过的 latent history 继续往下走,同时在 segment boundary 适应新的语言指令。
**DAJI 的 subsequence FID 达到 0.152,transition FID 和 jerk 指标也明显优于 TextOp。**这说明 anticipatory joint intent 不只是让动作“看起来更像”,也让指令切换时的身体过渡更平滑。
表 3:Future-aware latent 的作用:没有未来信息会显著破坏长时序执行
| Variant | Probe@40↑ | Corr.@40↑ | Succ.@20s(%)↑ | Succ.@60s(%)↑ |
|---|---|---|---|---|
| No-Future | 0.047 | 0.180 | 13 | 10 |
| Short-Future | 0.315 | 0.600 | 84 | 70 |
| Full DAJI | 0.393 | 0.736 | 94 | 87 |
ablation 很关键:如果去掉 future-aware latent,60 秒闭环成功率从 87% 掉到 10%。这说明 DAJI 的收益并不是来自“latent 维度比较大”或者“模型更复杂”,而是来自 latent 里确实编码了未来过渡所需的 anticipatory structure。
图 3:真实人形机器人上的定性部署结果。DAJI 可以在 streaming instruction switches 和 single-instruction generation 下产生可执行动作。
图 4:模拟环境中的 tracker-level rollout。DAJI 将生成的 joint-intent latents 解码为连续的全身人形机器人运动。
更多模拟动作案例
下面是论文附录中的 representative text-conditioned execution examples,覆盖从简单手势到动态全身动作的多种生成结果。
图 5:“A person flies kick.”
图6:“The person is throwing a baseball.”
还没解决的部分
DAJI 目前的大规模定量实验主要在仿真环境中完成,真实硬件部分主要用于定性展示。
此外,涉及物体相关的 prompt 主要被当作身体运动描述来解释,并不建模真实物体状态或操作结果。
所以它不是一个完整的"语言到开放世界任务执行"系统,而是聚焦在一个更基础的问题上:如何让语言条件生成结果,成为人形机器人闭环控制中可执行、可延展、可预判的运动接口。
从这个意义上说,DAJI 更像是在为下一代 language-conditioned humanoid control 搭一个新的中间层。
为什么这件事值得关注
很多文本到动作的工作关心的是"语言能不能生成好看的 motion",DAJI 关心的是另一个问题:
motion representation 能不能直接进入人形机器人的闭环执行系统?
generation 和 control 之间的接口,不是工程细节,而是决定整个系统能不能稳定运行的核心。
如果生成模型只输出"看起来正确的动作",却不知道当前身体是否准备好了、下一步支撑要如何切换、指令切换时姿态如何过渡,那它在长时序闭环执行里就很难真正稳定。
这个问题在整个领域里目前还处于比较早期的阶段——大家对生成质量的关注远多于对接口设计的关注。随着人形机器人从实验室走向更复杂的真实环境,更长的指令序列、更不可预测的物理扰动、更开放的任务场景,都会持续对这个接口施压。
DAJI 是一次具体的尝试,但显然不是终点。