
Microduck 深拆:399 美元的开源鸭子,把 sim2real 的 RL 闭环做成了产品
一句话:Microduck 在算法上没有提出任何新范式——PPO 不新,域随机化不新,ONNX 端上推理也不新。它做对的是交付方式:把训练环境、执行器模型、观测契约、导出脚本、机身运行时和策略分发通道,打包成一个 399 美元、任何人都能上手的完整闭环。
本文按"硬件 → 训练 → sim2real → 契约 → 运行时 → 开源边界 → 它没解决的问题"的顺序拆一遍,重点放在哪些工程决策是可以直接抄回自己项目里的。
2026 年 8 月 27 日,Hugging Face 旗下的 Pollen Robotics 开启了 Microduck 的预售:25 厘米高、不到 800 克的双足机器鸭,399 美元,圣诞节前发货。社交媒体上传播最广的是它被推倒后自己爬起来的片段,但对腿足从业者来说,那段视频只是最上镜的一个输出。真正值得花时间的,是它背后那套被完整开源出来的训练与运行时代码:
pollen-robotics/microduck—— 机身控制栈,Rust 编写,Apache-2.0pollen-robotics/microduck_rl—— 训练环境、奖励与导出管线,Apache-2.0(约 1.9k star、367 fork,develop 分支已有 1200+ commit)
下面进入正题。
1. 先看全局:Microduck 到底是什么
用一句话定位:它是一台把"训练一个新动作"这件事开放给用户的双足机器人。
大多数消费级机器人产品的技能是封闭的:厂商预置了什么,你就只能用什么,最多在 App 里编排一下顺序。Microduck 的做法相反——它把机器人出厂时那七个动作背后的完整训练管线一并开源,包括仿真环境、执行器模型、奖励函数、导出脚本和发布通道。你可以在自己的显卡上训一个它原本不会的动作,导成 ONNX,装回机器人,然后把它发布到 Hugging Face Hub 给别人用。
这个定位决定了它所有的工程取舍。后面每一节讨论的设计,几乎都可以回溯到同一个问题:要让一个非机器人专业的用户能独立跑通 sim2real 闭环,系统需要长成什么样?
2. 硬件:一份被刻意压到极限的规格表
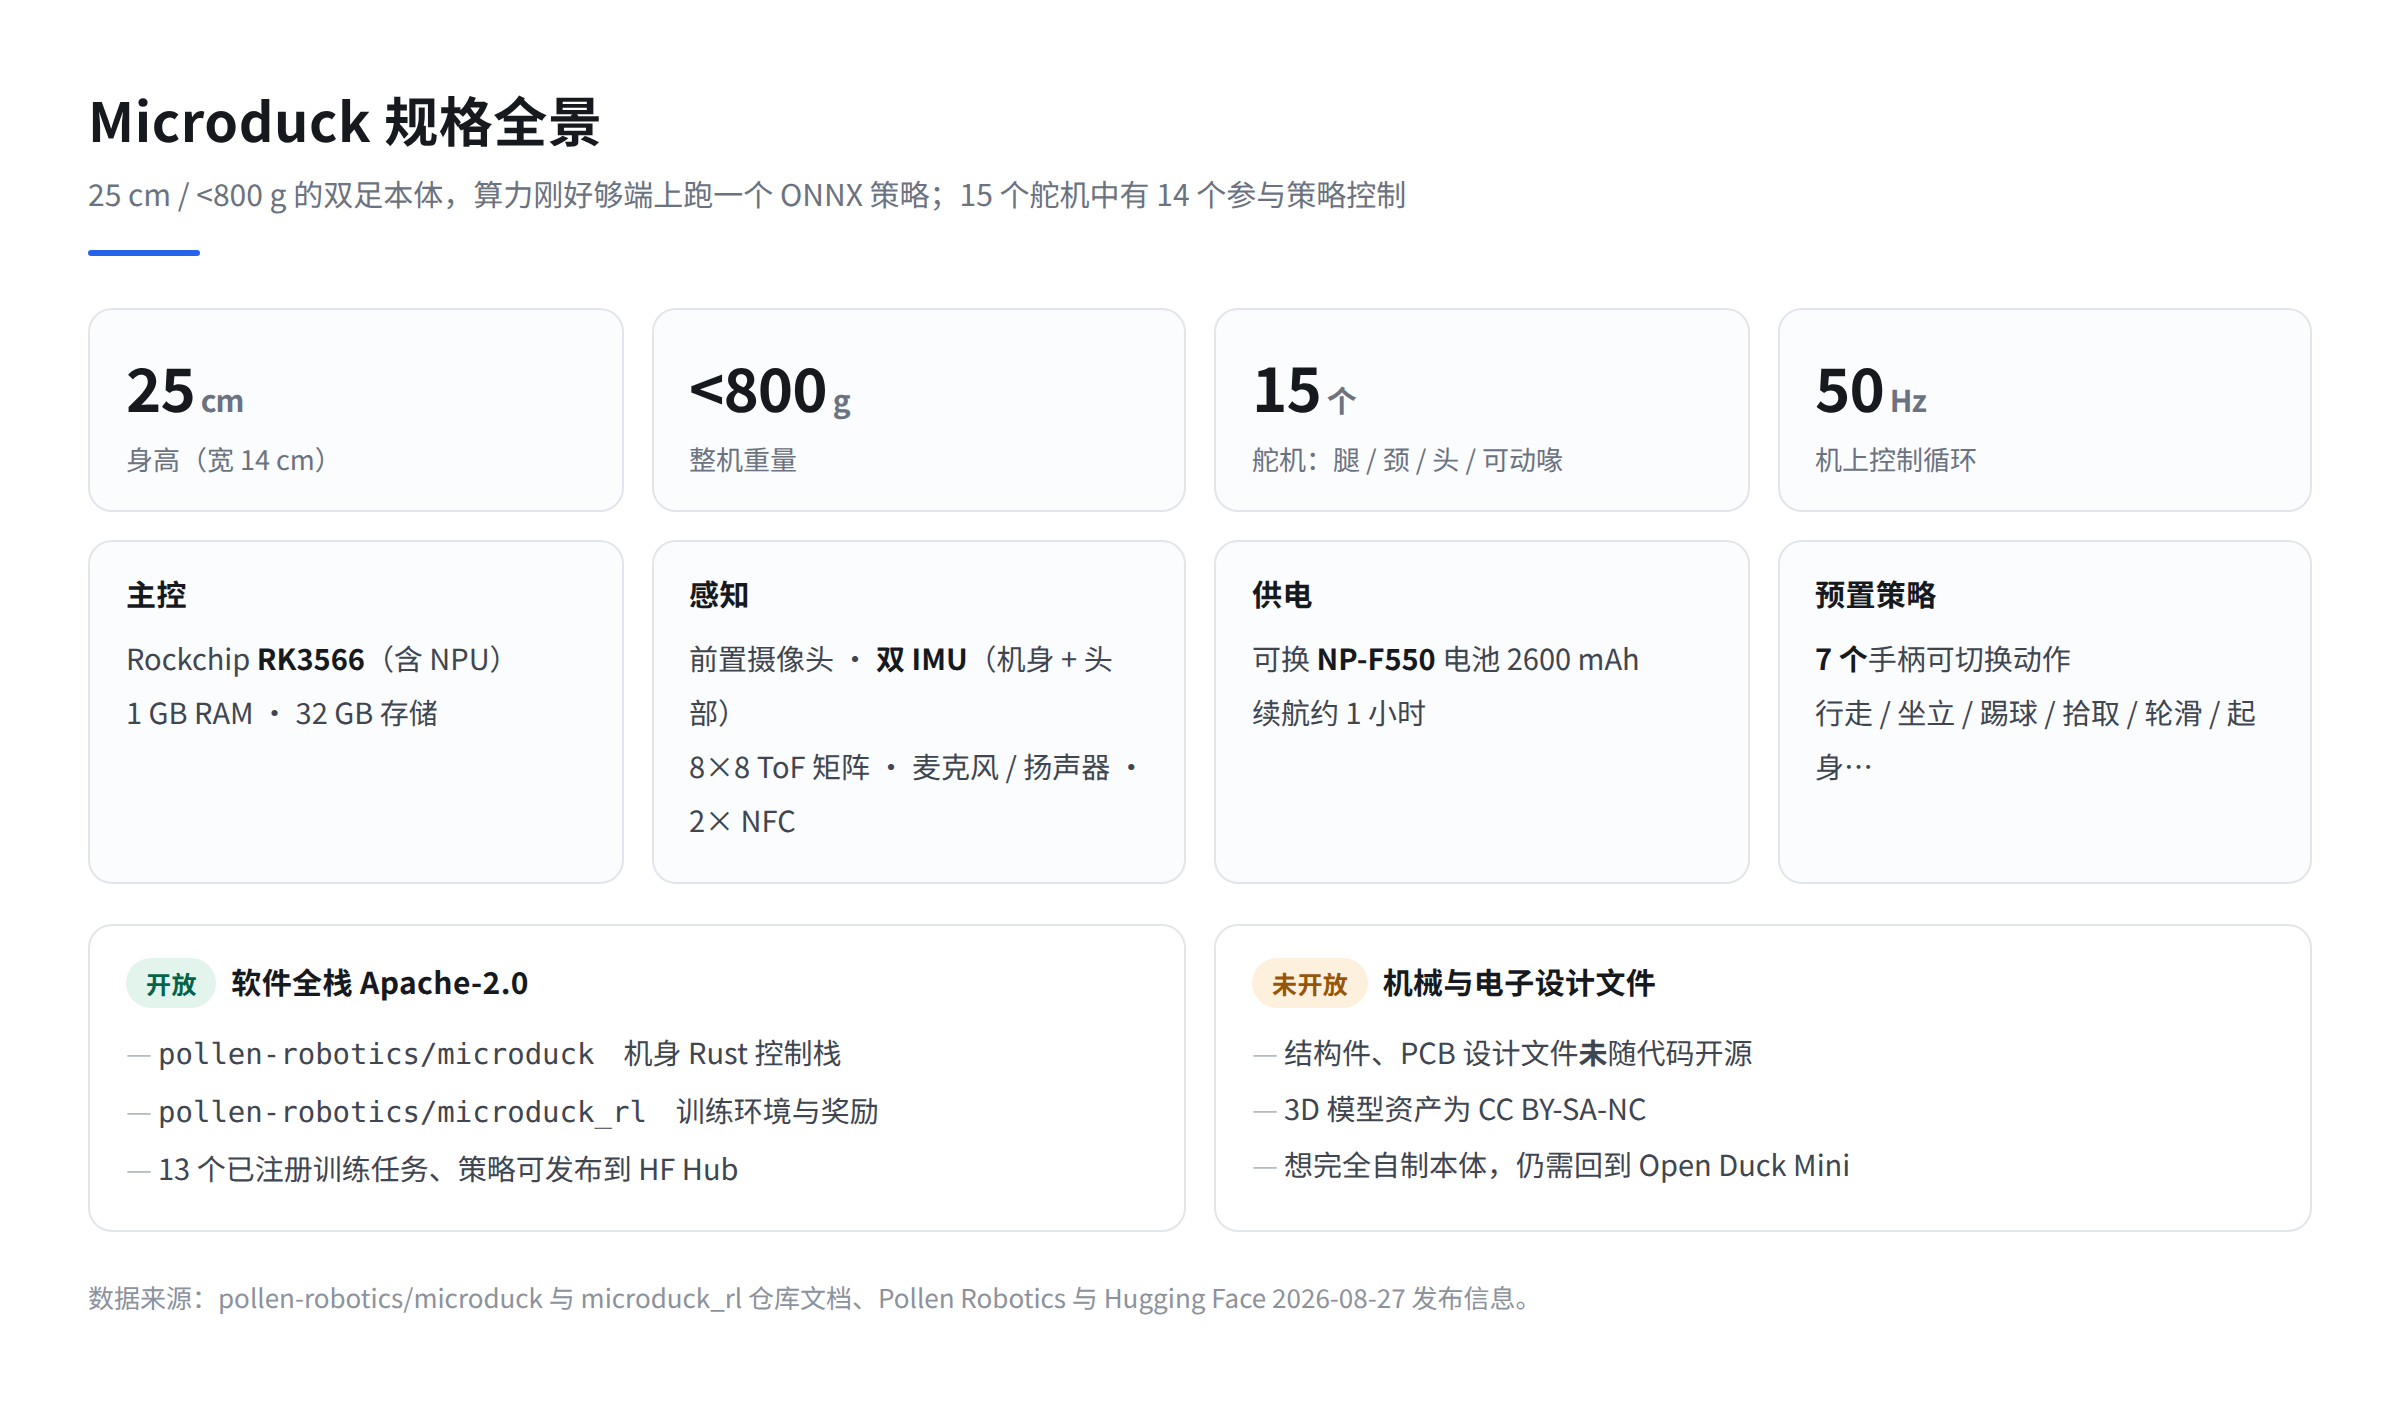
图1|Microduck 规格全景与开源边界。
几个数字值得单独说。
主控是 RK3566,1 GB 内存。 这不是给 VLA 或者任何大模型准备的算力,而是刚好够跑一个小策略网络加上视频编码。它非常明确地宣告了这台机器的技术路线:端上闭环控制,不联云。策略推理必须在 20 毫秒的节拍里完成,任何一次网络往返都不可接受。
双 IMU。 机身一个、头部一个。对一个 800 克的小家伙来说,这是相当奢侈的配置——但它在后面的观测空间设计里会兑现:头部姿态是一个独立的指令维度,机器人可以在行走的同时"看向某个方向",这需要头部姿态被独立观测。
15 个舵机,其中 14 个参与策略控制。 腿、颈、头,加上一个可动的喙。第 15 个自由度(喙)主要服务于表现力和"用嘴叼东西"这类动作,不进入速度跟踪类策略的动作空间。
8×8 的 ToF 矩阵。 官方称之为微型 LiDAR,但要清楚它的分辨率:64 个深度点。这个精度足够做避障和"前面有没有东西"的判断,不足以做稠密建图。
续航约 1 小时,电池可换(NP-F550,2600 mAh)。 可换电池这件事在小型机器人上经常被忽略,但它直接决定了做实验时的迭代节奏——不用等充电,换一块继续。
3. 它的真正来源:Open Duck Mini 这条社区线
要理解 Microduck 为什么长这样,得先看它的前身。
过去两年"低成本开源双足"这条线上最有影响力的项目是 Open Duck Mini:一个复刻迪士尼 BDX droid 的社区项目,Onshape CAD 全公开、3D 打印、BOM 控制在 400 美元以内,目前约 3.9k star、近 500 fork。它的软件侧同样完整:
Open_Duck_Playground—— 基于 MuJoCo Playground 的 PPO 训练环境Open_Duck_reference_motion_generator—— 参考轨迹生成,用于模仿奖励Open_Duck_Mini_Runtime—— 跑在 Raspberry Pi Zero 2W 上的 Python 运行时- 执行器辨识接的是 Rhoban 的 BAM
Pollen Robotics 是 Open Duck Mini 的赞助方之一。所以 Microduck 不是凭空冒出来的产品,而是同一条技术路线的产品化版本:技术选型几乎一一对应,但把"你要自己打印、自己配舵机、自己调 sim2real"这一大段门槛砍掉了。
这个对应关系在第 10 节会用一张完整的对比表展开。先记住一点:两者降低的不是同一个门槛。
4. 训练侧:mjlab + PPO,4096 并行环境,一两个小时出步态
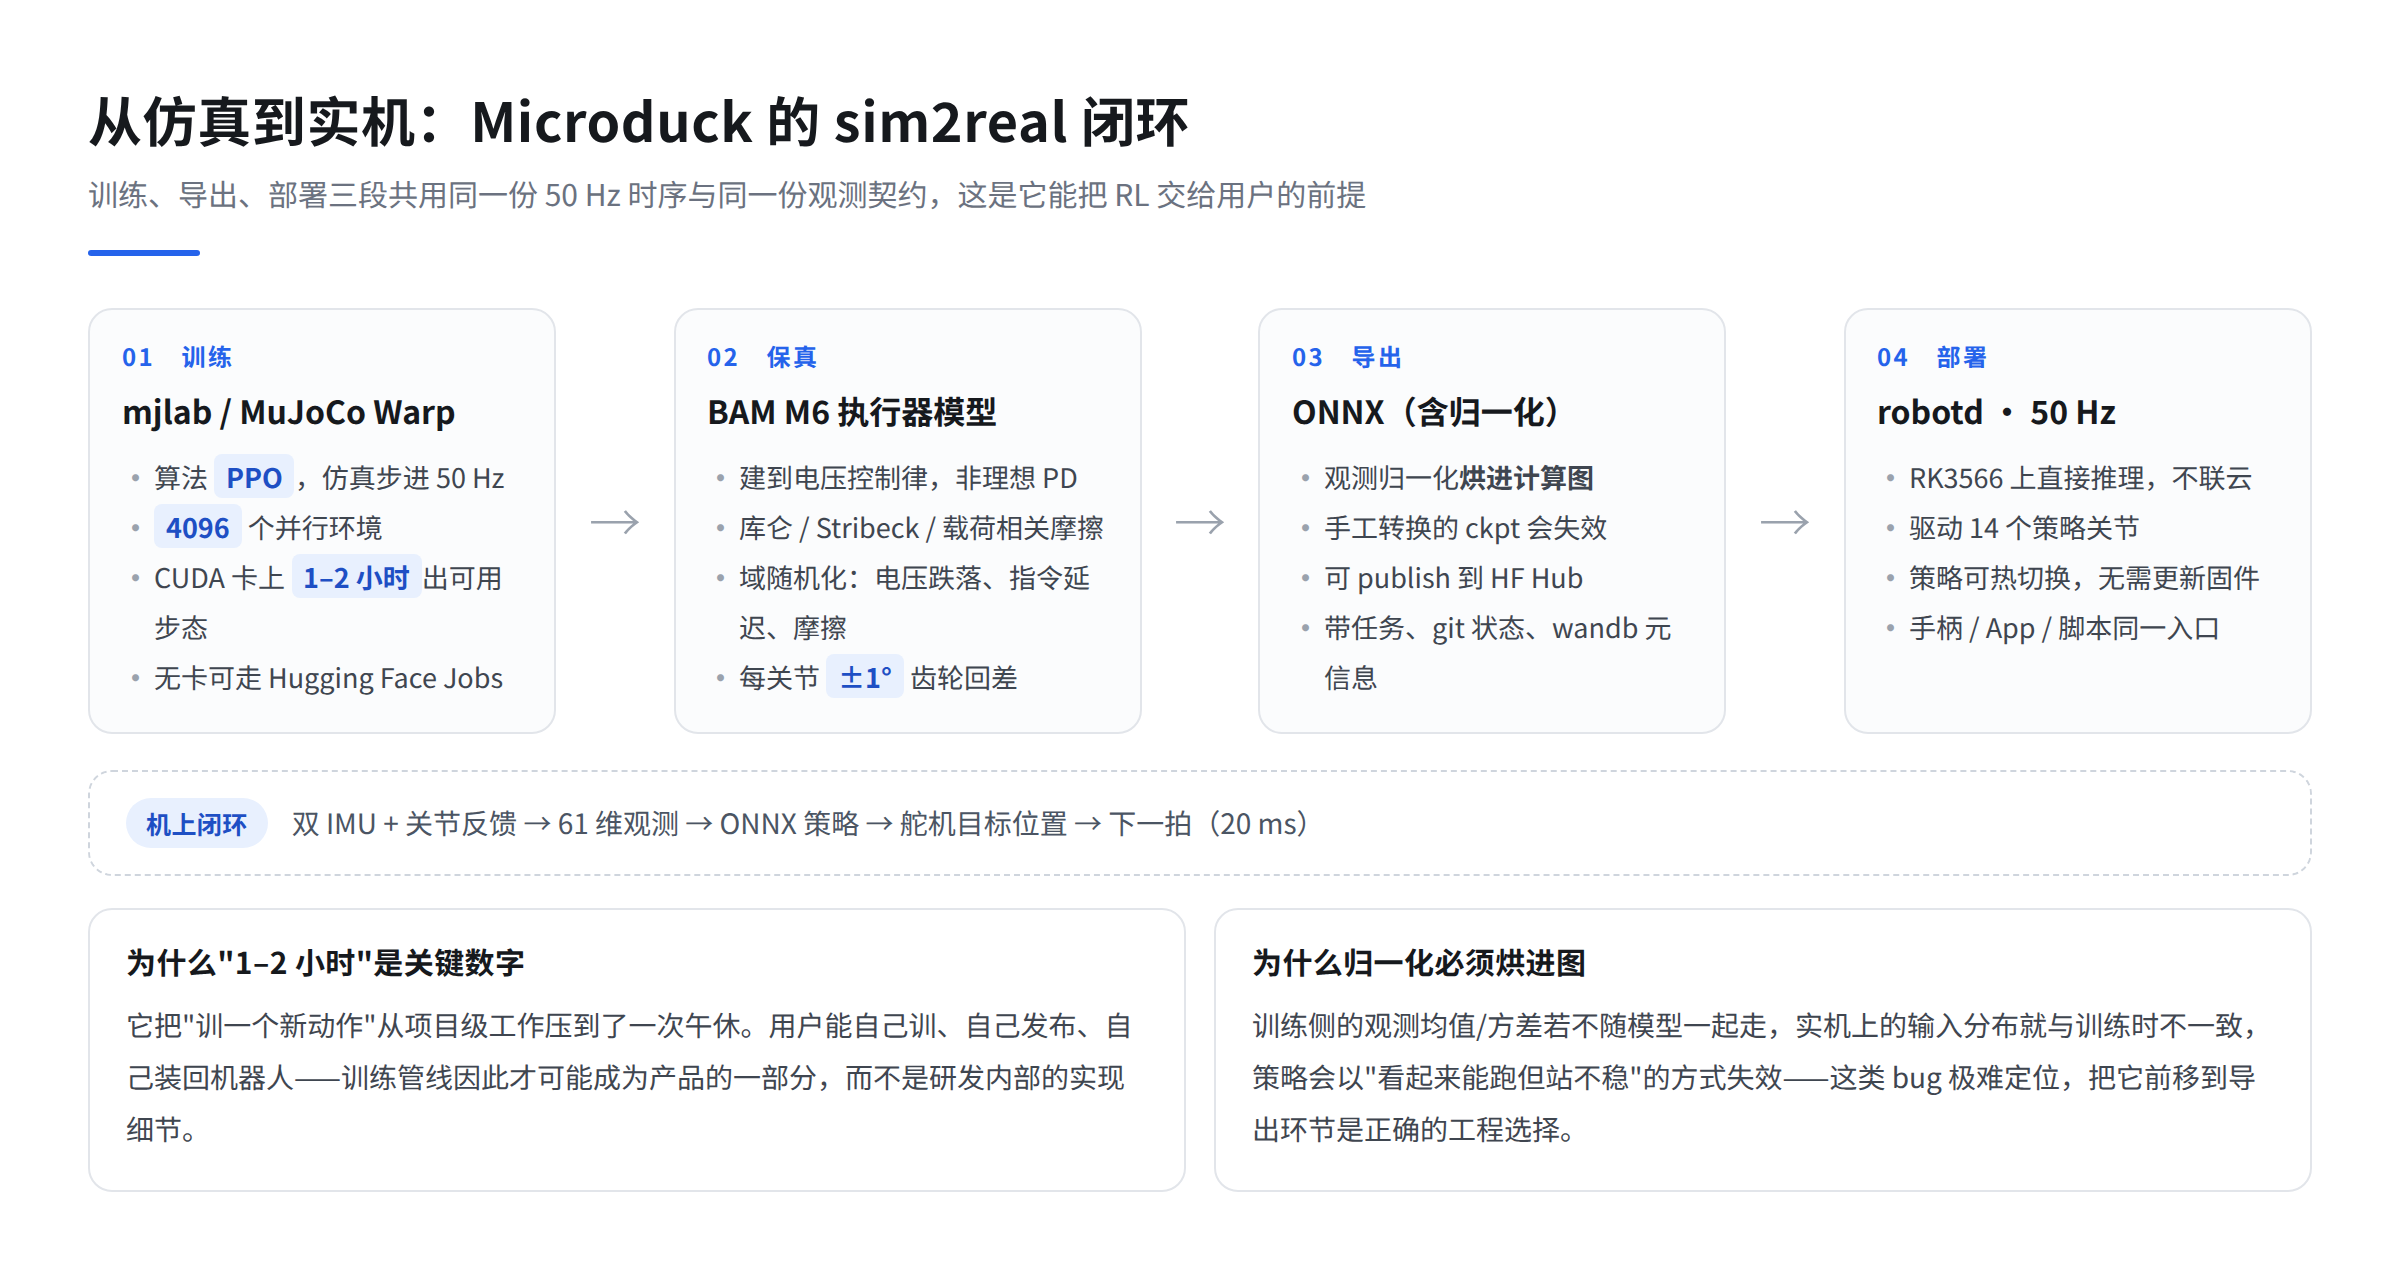
图2|从仿真到实机的完整闭环。
训练代码构建在 mjlab(MuJoCo Warp) 之上,算法是 PPO,仿真与部署都跑在 50 Hz。跑一个速度跟踪的行走策略,就是一行:
bash
uv run train Mjlab-Velocity-Flat-MicroDuck --env.scene.num-envs 4096
支持从 checkpoint 续训:
bash
uv run train Mjlab-Velocity-Flat-MicroDuck --env.scene.num-envs 4096 \
    --agent.run-name resume --agent.load-checkpoint model_29999.pt
没有显卡的用户加一个 --hf-jobs,训练直接跑到 Hugging Face Jobs 上。环境依赖用 uv 管理;ARM 平台需要设 UV_HTTP_TIMEOUT=600,因为 CUDA wheel 有 2 GB 左右。
官方给出的数字是:4096 个并行环境,单张 CUDA 卡上大约 1–2 小时训出可用步态。
4.1 为什么"1–2 小时"是产品参数而不是性能指标
这个数字很容易被当成"训练效率不错"一笔带过,但它其实是整个产品设计的支点。
把"训一个新动作"的耗时从两天压到两小时,改变的不是效率,是这件事归谁做。两天意味着这是一个需要立项、需要排期的研发任务,只有厂商内部会做;两小时意味着一个买了机器人的爱好者,可以在周末的一个下午里试三四个想法。
于是训练管线才有资格成为产品的一部分,而不是研发内部的实现细节。后面所有关于"策略可发布、可安装、可热切换"的设计,前提都是这个数字。
5. sim2real 的真正瓶颈:执行器,而不是策略
这是全文我认为最值得抄作业的一段。microduck_rl 的文档说得很直白:在这个尺度上——微型舵机驱动一个 800 克的双足——执行器的保真度就是 sim2real gap 的绝大部分,所以舵机被建模到了它的电压控制律这一层,而不是一个理想 PD。
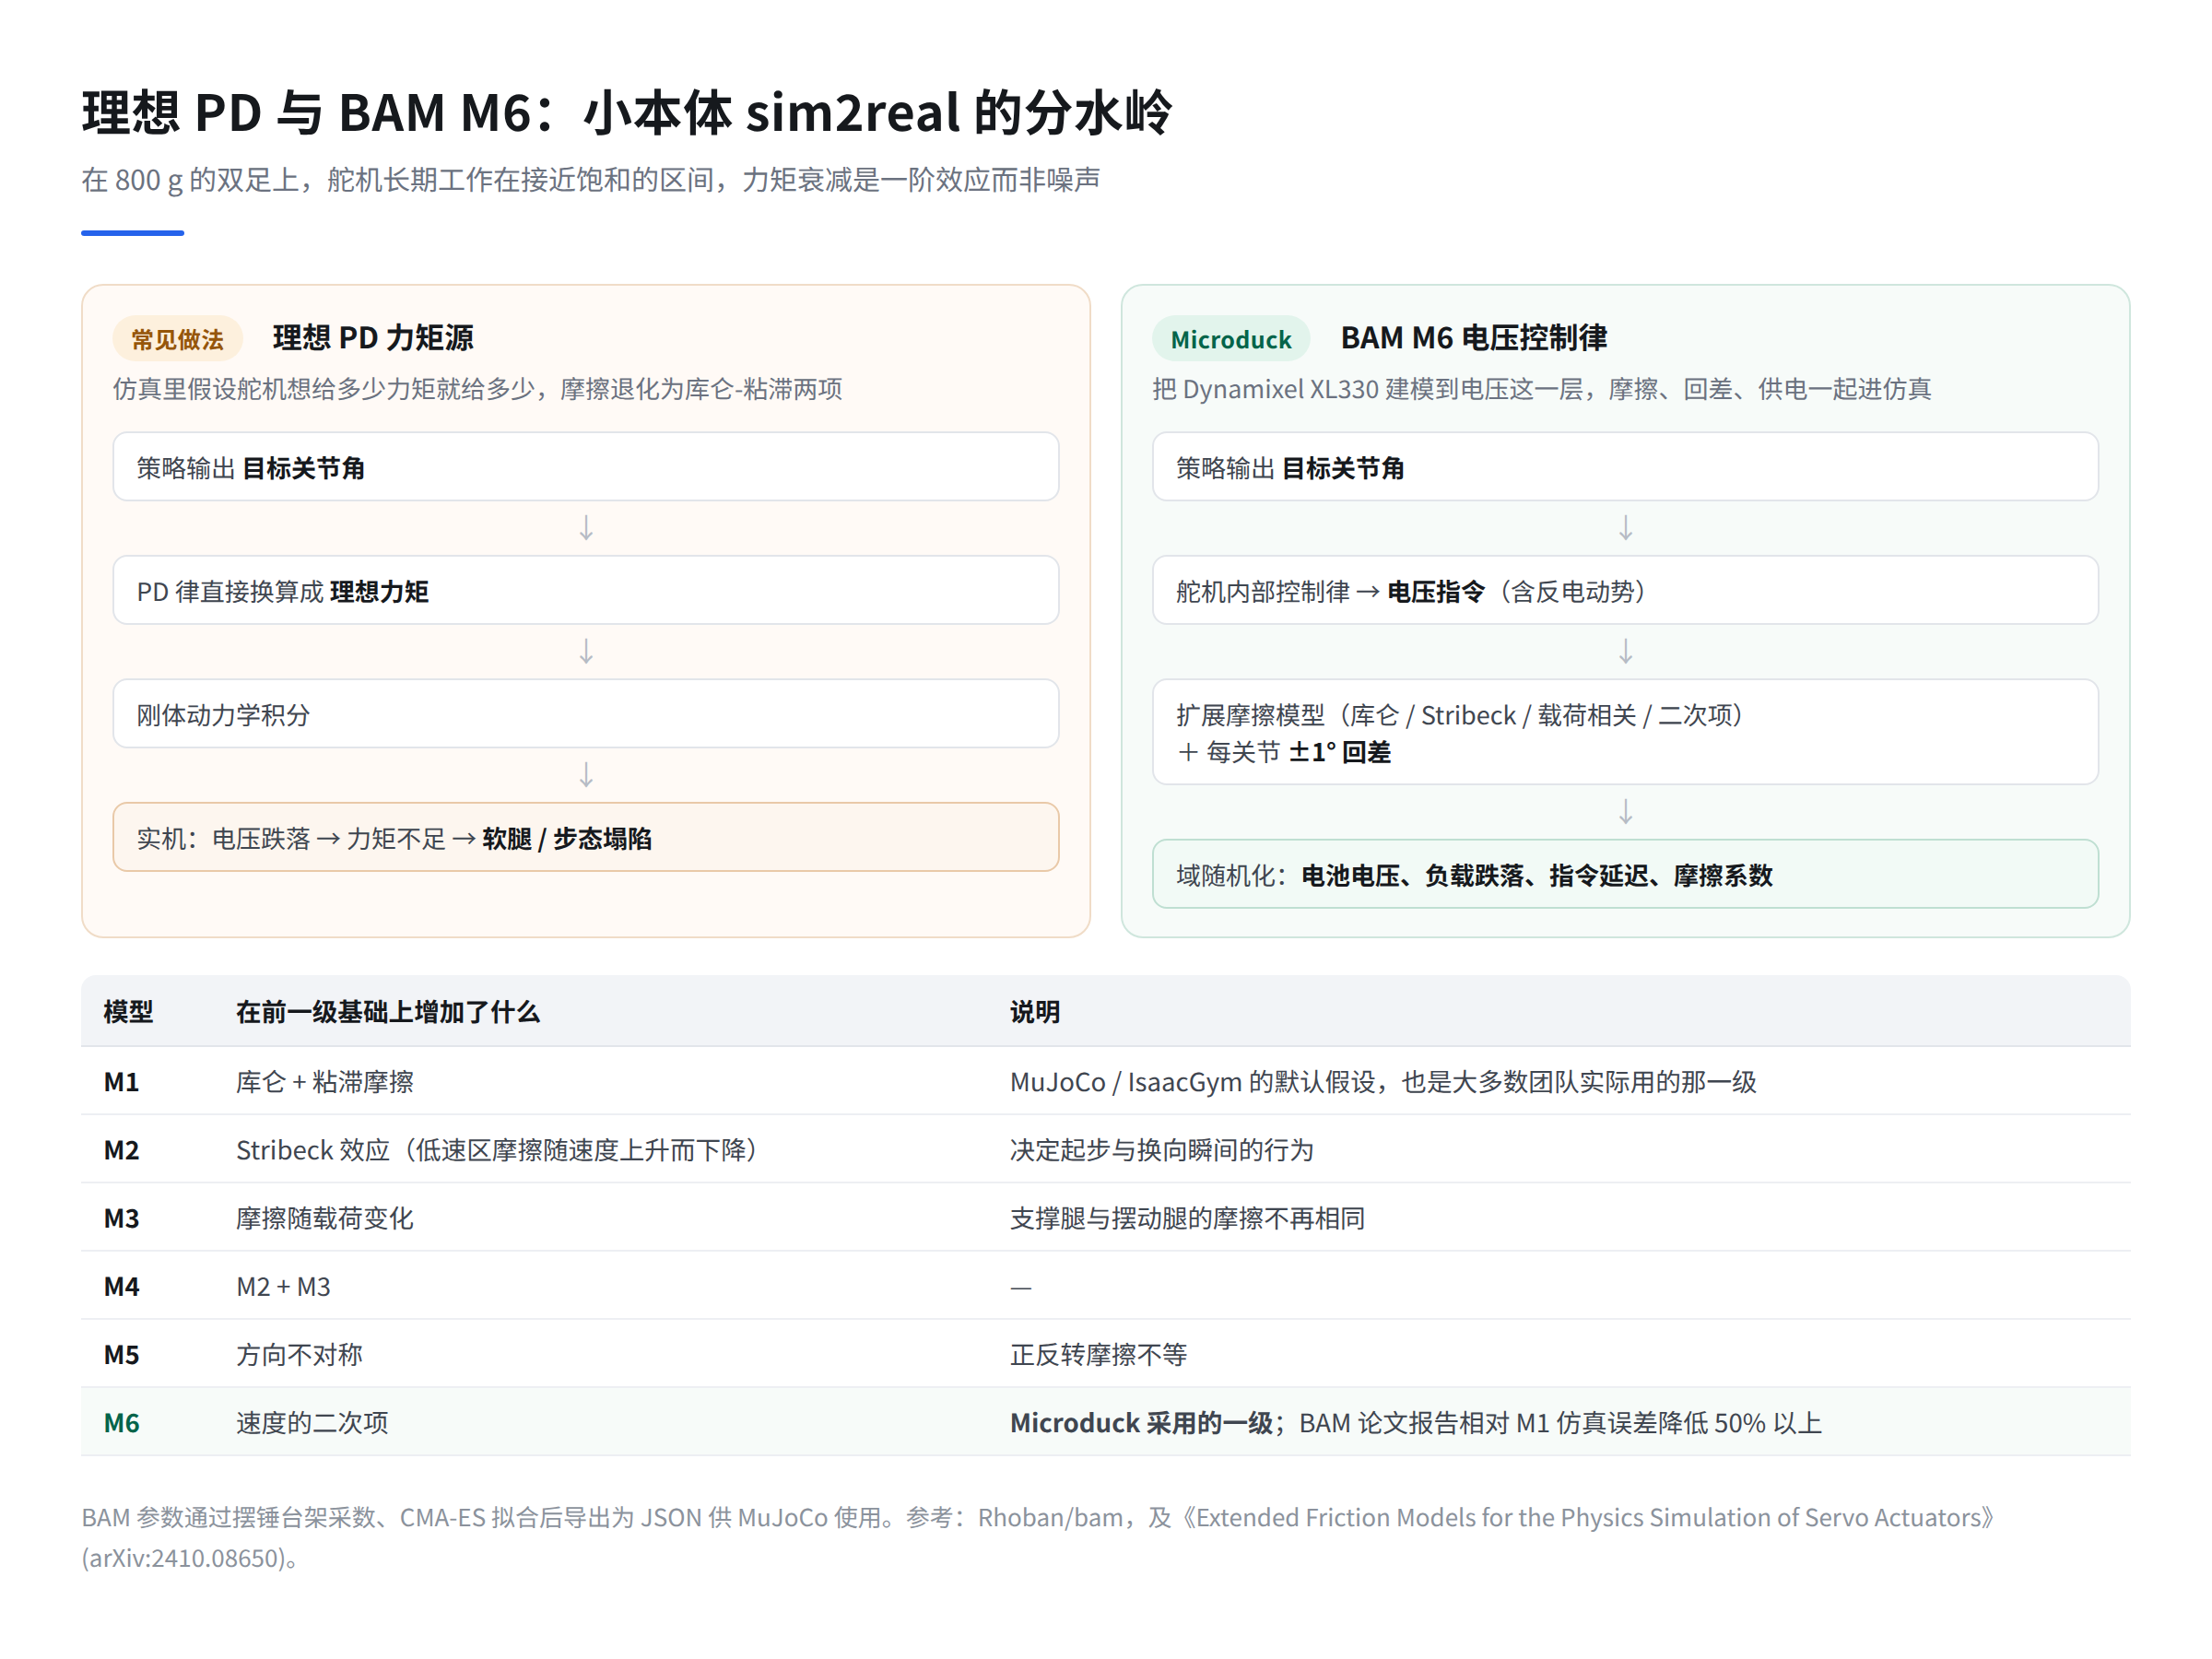
图3|理想 PD 与 BAM M6:小本体 sim2real 的分水岭。
对照一下常见做法:很多团队的域随机化停留在"质量 ±10%、摩擦 ±20%、加一点观测噪声",执行器仍然是一个理想力矩源——策略想要多少力矩就有多少力矩。这在大功率、力矩余量充足的本体上问题不大,但当机器人只有 800 克、舵机长期工作在接近饱和的区间时,电压跌落带来的力矩衰减是一阶效应,不是噪声。不建它,仿真里再漂亮的步态到了实机上也是软腿。
5.1 BAM:从 M1 到 M6,多出来的四项都在补什么
Rhoban/bam(Better Actuator Models)的出发点是一句很扎心的观察:MuJoCo、IsaacGym 这类主流仿真器默认的摩擦模型是库仑-粘滞(M1),而这个模型对舵机来说太简单了。
BAM 提出了六级递进的模型:
| 模型 | 在前一级基础上增加了什么 | 它在补的物理 |
|---|---|---|
| M1 | 库仑 + 粘滞摩擦 | 主流仿真器的默认假设 |
| M2 | Stribeck 效应 | 低速区摩擦随速度上升而下降——决定起步与换向瞬间的行为 |
| M3 | 摩擦随载荷变化 | 支撑腿与摆动腿的摩擦不再相同 |
| M4 | M2 + M3 | —— |
| M5 | 方向不对称 | 正转与反转的摩擦不相等 |
| M6 | 速度的二次项 | Microduck 采用的一级 |
BAM 论文报告,相对 M1,仿真误差降低了 50% 以上。参数的获取方式是工程化的:用摆锤台架在不同负载质量、不同摆长、不同控制律下采数,用 CMA-ES(也支持随机搜索、NSGA-II)拟合模型参数,最后导出成 JSON 给 MuJoCo 用。
对 Microduck 来说,被辨识的对象是 Dynamixel XL330——这也意味着这套参数不能直接搬到别的舵机上,换型号就得重做台架。这是这条路线的成本所在,但相对它带来的确定性,是笔划算的账。
5.2 域随机化随机的是什么
值得注意的是随机化的对象选得很具体,全都挂在执行器上(代码里对应 FrictionDRBamActuator,各项由任务配置里的 ENABLE_* 开关控制):
- 电池电压 —— 满电和快没电时,舵机能给出的力矩不一样
- 负载下的电压跌落(voltage sag) —— 多个舵机同时发力时的瞬时掉压
- 指令延迟 —— 从策略输出到舵机真正开始动之间的时间
- 摩擦系数 —— 每台机器、每个关节、甚至同一个关节在不同温度下都不同
这四项的共同点:它们都是同一台机器在不同时刻会发生变化的量,而不是"机器与机器之间的差异"。这是一个值得注意的取向——它随机的不只是个体差异,还有工况漂移。
5.3 ±1° 回差为什么要单独拎出来
任务注册表里,每一个主任务都有一个 backlash 孪生版本,模拟每个关节 ±1° 的齿轮回差,覆盖 14 个策略关节。
回差之所以要单独处理,是因为它不是一个可以用噪声近似的量:它是带记忆的死区——换向时关节要先空转过间隙才开始传力,方向不变时则完全不体现。在小舵机上这个间隙相对于步态幅度并不小,一旦策略学会了依赖"指令下去关节立刻响应",到了实机就会在每次换向时踩空。
给每个任务配一个 backlash 孪生版本,本质上是把"这条策略经不经得起回差"变成了一个可以单独测量的问题,而不是混在 sim2real 失败里说不清楚。
6. 61 维观测契约:全文最值得抄的一处设计

图4|61 维观测契约与策略热切换。
microduck_rl 里所有任务共享一份固定的 61 维观测:
61 = 48 本体感知
   + 13 指令(twist 3 + head pose 4 + body pose 6)
某个任务用不到的指令维度,直接补零。
6.1 补零的代价与收益
代价是显而易见的:起身策略永远看着 3 个恒为零的 twist 维度,网络得自己学会忽略它们;输入层多了一点参数,训练早期多了一点无效梯度。
收益是所有策略的输入输出接口完全一致。于是:
- 运行时可以在不重训、不改 daemon 的情况下热切换策略
- 七个预置动作就是七个独立的 ONNX 文件,机器人按状态机在它们之间跳转
- 用户自己训的新动作,只要遵守同一个契约,装上去就能用
这笔账在任何一个想做技能库的平台上都是划算的。相比之下,"每个技能一套观测定义"的做法,会让每加一个技能都要动一次运行时代码——技能数量一多,运行时就变成了一个谁也不敢碰的泥潭。
6.2 策略作为可分发单元
有了统一契约,publish 命令才有意义:训练完的策略可以发布到 Hugging Face Hub,带上任务名、训练时的 git 状态、wandb run 等元信息。机器人的使用者安装这个策略,不需要更新 daemon,也不需要刷固件。
这一步把"技能"从代码变成了可安装的软件包。对任何想让社区贡献动作的机器人平台,这条路径值得完整照抄:先定契约,再谈生态。
7. 十三个任务:一份被忽略的课程表
任务注册表本身就是一份很好的参考——它展示了在一个小双足上,RL 到底能被要求做哪些事:
| 任务 | 地形 | 内容 |
|---|---|---|
Mjlab-Velocity-{Flat,Rough} |
平地 / 崎岖 | 主行走任务,速度 + 头部姿态指令 |
Mjlab-VelStand-{Flat,Rough} |
平地 / 崎岖 | 行走与摔倒恢复合并进同一条策略 |
Mjlab-StandUp-{Flat,Rough} |
平地 / 崎岖 | 从地面回到站立,身体姿态可控 |
Mjlab-SitStand-{Flat,Rough} |
平地 / 崎岖 | 坐下与起立的转换,带头部指令 |
Mjlab-GroundPick-{Flat,Rough} |
平地 / 崎岖 | 下蹲、喙尖触地、再回到站立 |
Mjlab-BallKick-Flat |
平地 | 向前踢球(70 mm,15 g) |
Mjlab-Roulade-Flat |
平地 | 前滚翻,越过头部并以双脚落地 |
Mjlab-Velocity-Flat-Rollers |
平地 | 装上轮子后的速度跟踪 |
Mjlab-Velocity-Swizzle |
平地 | 对称摆动式滑行 |
Mjlab-RollerCrouch-Flat |
平地 | 滑行中下蹲 |
Mjlab-RollerSlope-Flat |
斜坡 | 下坡滑行 |
Mjlab-RollerStandUp-Flat |
平地 | 从地面站起到轮子上 |
Mjlab-Spin-Flat |
平地 | 轮上原地旋转 |
两个观察:
第一,VelStand 这个任务很有意思。 它把行走和摔倒恢复训进同一条策略,而不是靠状态机在"行走策略"和"起身策略"之间切换。这两种做法各有取舍——合并策略的切换更连续,但训练更难、奖励设计更容易打架;分开则更好调试。项目把两种方案都保留了,这是一个诚实的工程状态。
第二,轮滑相关的任务占了五个。 装上轮子后,本体的动力学完全变了(从间歇接触变成持续滚动约束),但观测契约一模一样。这几乎是对第 6 节那套设计最好的压力测试:如果契约只在相似任务间成立,它就没什么价值。
8. 导出这一步的坑:归一化必须烘进图
导出命令:
bash
uv run scripts/export.py Mjlab-Velocity-Flat-MicroDuck \
    --wandb-run-path <entity/project/run_id>
仓库特意标注了一件事:导出器会把观测归一化直接烘进 ONNX 计算图,手工转换的 checkpoint 会绕开这一步,在实机上直接失效。
这个提醒的分量,做过部署的人应该都懂。训练时观测是用运行统计量归一化过的;如果这套均值和方差没有随模型一起走,实机上送进网络的输入分布就和训练时不是一回事。失效的方式还特别隐蔽——策略不会崩,它会以"看起来能跑但站不稳"的方式退化,你会先怀疑机械、怀疑标定、怀疑舵机,最后才想到归一化。
把它前移到导出环节、变成一个用户无法绕过的默认行为,是正确的工程选择。
不上实机也可以先预演多策略切换:
bash
uv run scripts/infer_policy.py --walking walk.onnx --standing stand.onnx
另外仓库里有一组回归测试,锁死了关节映射和奖励约定:
bash
uv run --with pytest pytest tests/
这类测试在 RL 项目里很少见但极其必要——关节顺序被谁不小心改了一位,训练照样收敛,实机直接劈叉,而且几乎不可能靠看曲线发现。
9. 机身运行时:Rust 多 daemon + 一套 JSON-RPC
Show Image
图5|机身控制栈架构。
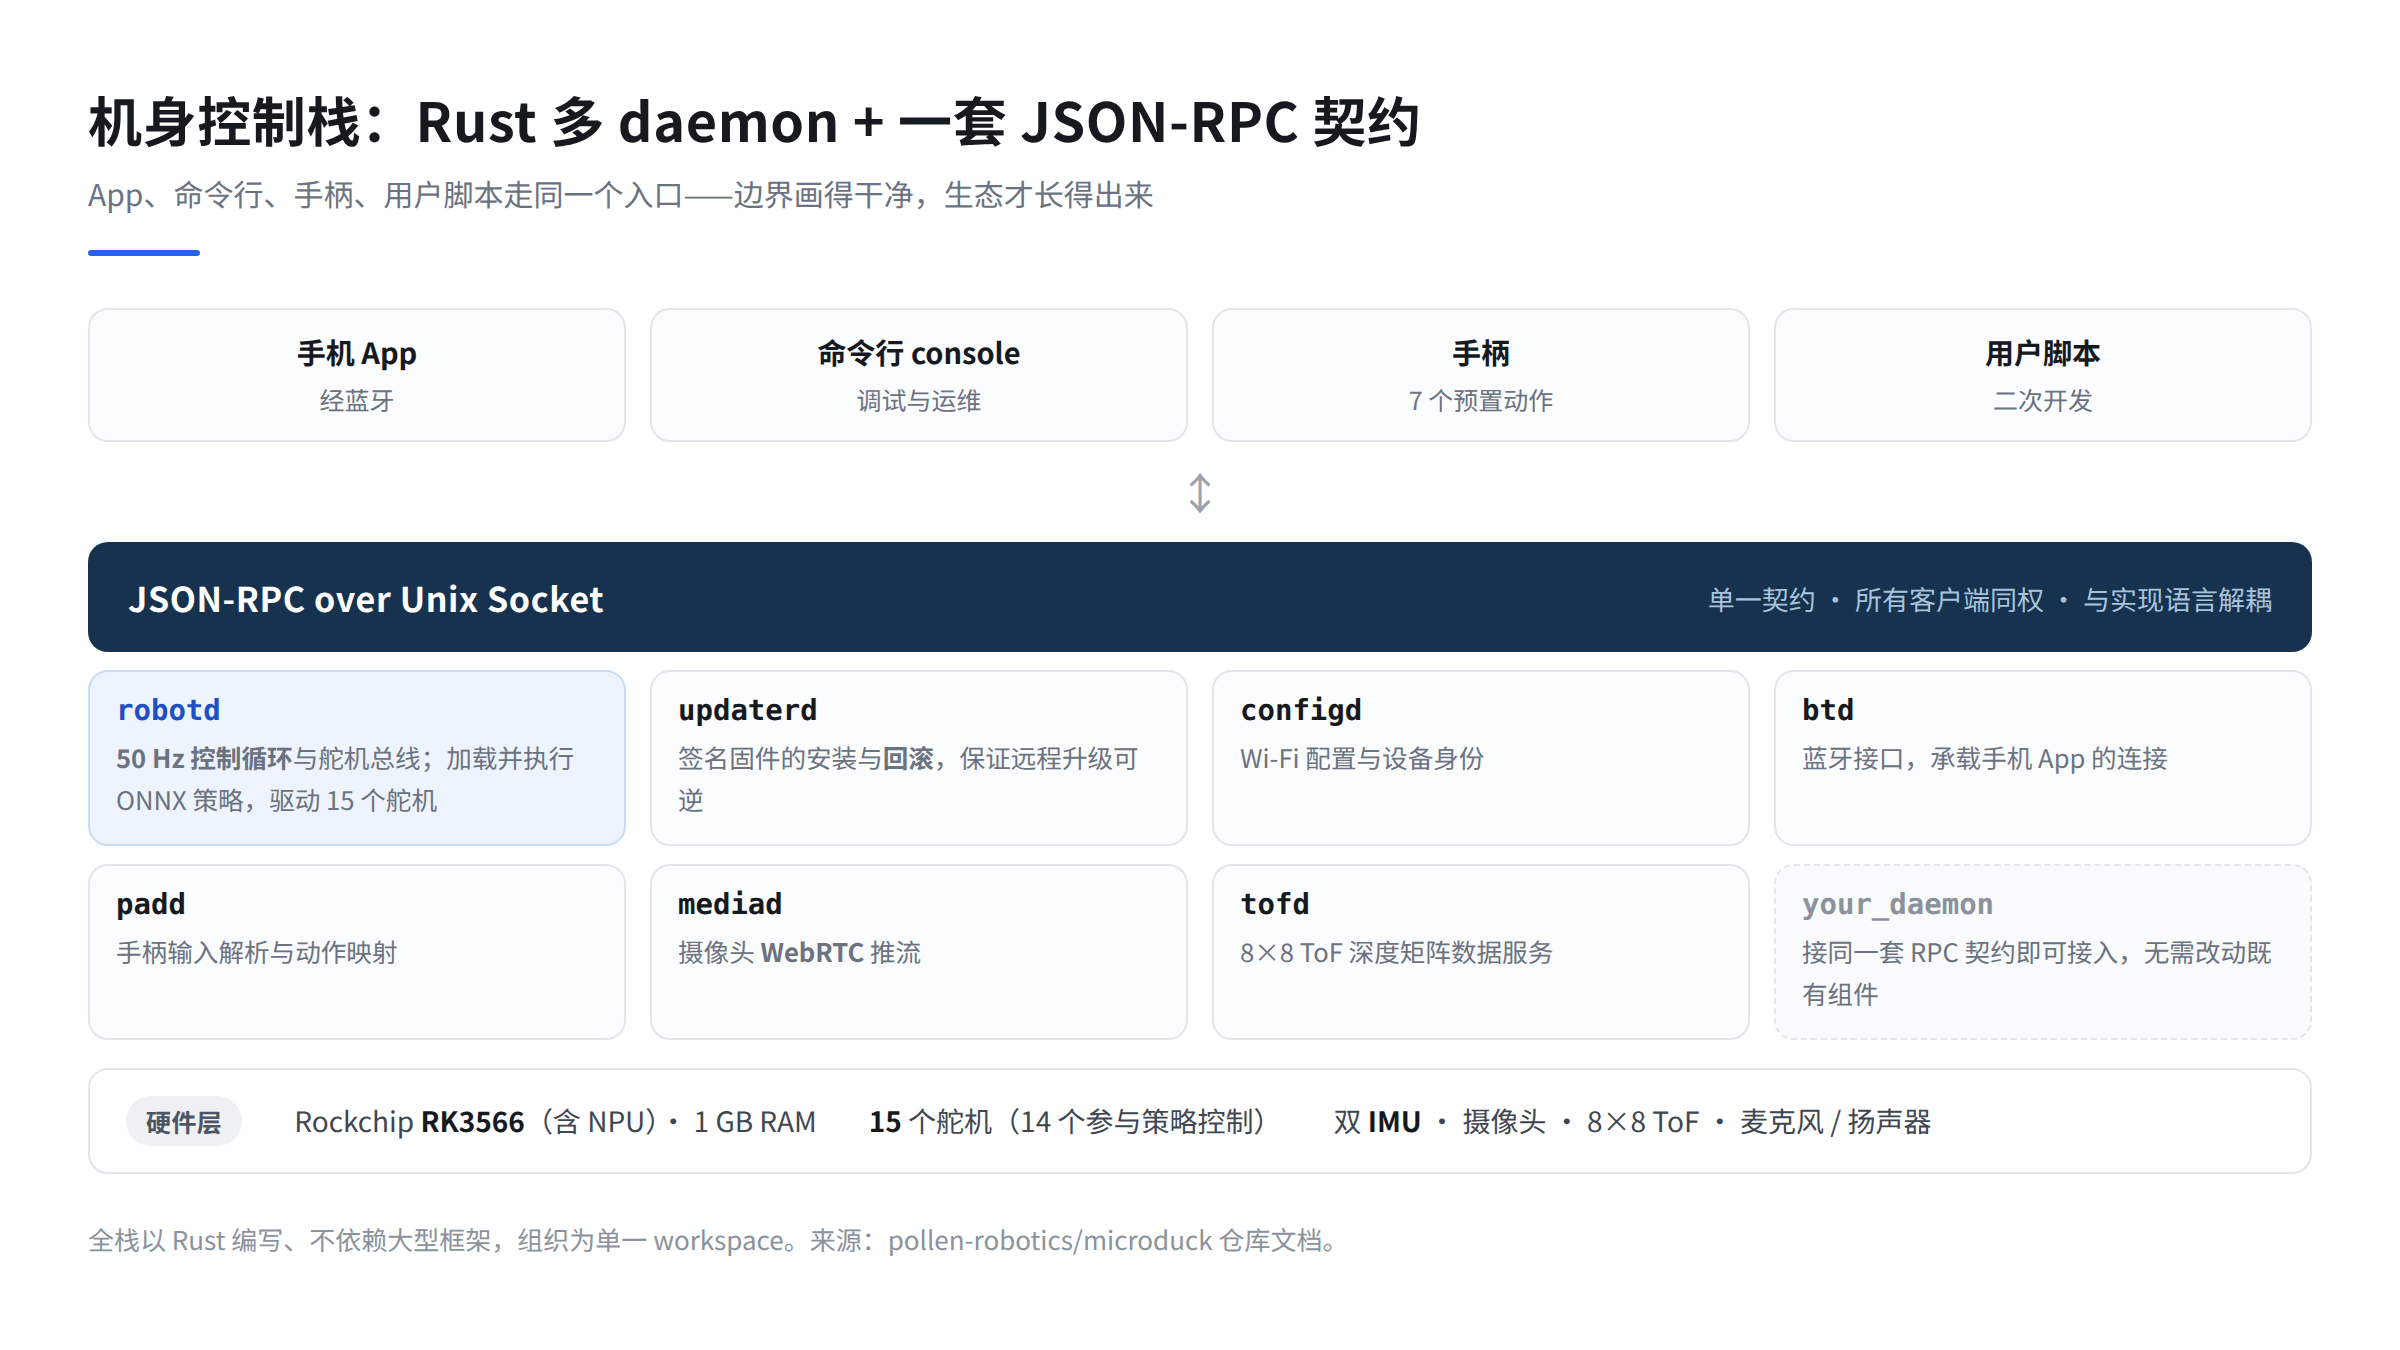
机身上的控制栈用 Rust 编写、不依赖大型框架,组织成一个 workspace,拆成若干 daemon:robotd 管 50 Hz 控制循环与舵机总线,updaterd 管签名固件的安装与回滚,configd 管 Wi-Fi 与设备身份,btd 管蓝牙,padd 管手柄输入,mediad 做摄像头 WebRTC 推流,tofd 提供深度数据服务。
它们之间只有一套 JSON-RPC over Unix socket 的契约——手机 App、命令行 console、手柄、用户脚本,全部走同一个入口。
这套架构本身没什么新鲜的。值得注意的是它和第 6 节的观测契约构成了同一种思路:把系统的每个边界都收敛成一份显式的、可被第三方调用的契约。
- 策略侧的边界是 61 维观测
- 进程间的边界是 JSON-RPC
- 升级的边界是签名与回滚
一个开源硬件产品能不能长出生态,很大程度上取决于这些边界画得干不干净,而不是取决于它的算法有多先进。反过来说,如果手柄走一套私有协议、App 走另一套、脚本只能改源码,那么"开源"就只剩下了可读性。
10. 开源边界:软件全开,机电不开
这是需要说清楚、也最容易被宣传口径糊过去的一点:Microduck 的软件是 Apache-2.0,但机械与电子设计文件并未开源,3D 模型资产为 CC BY-SA-NC。
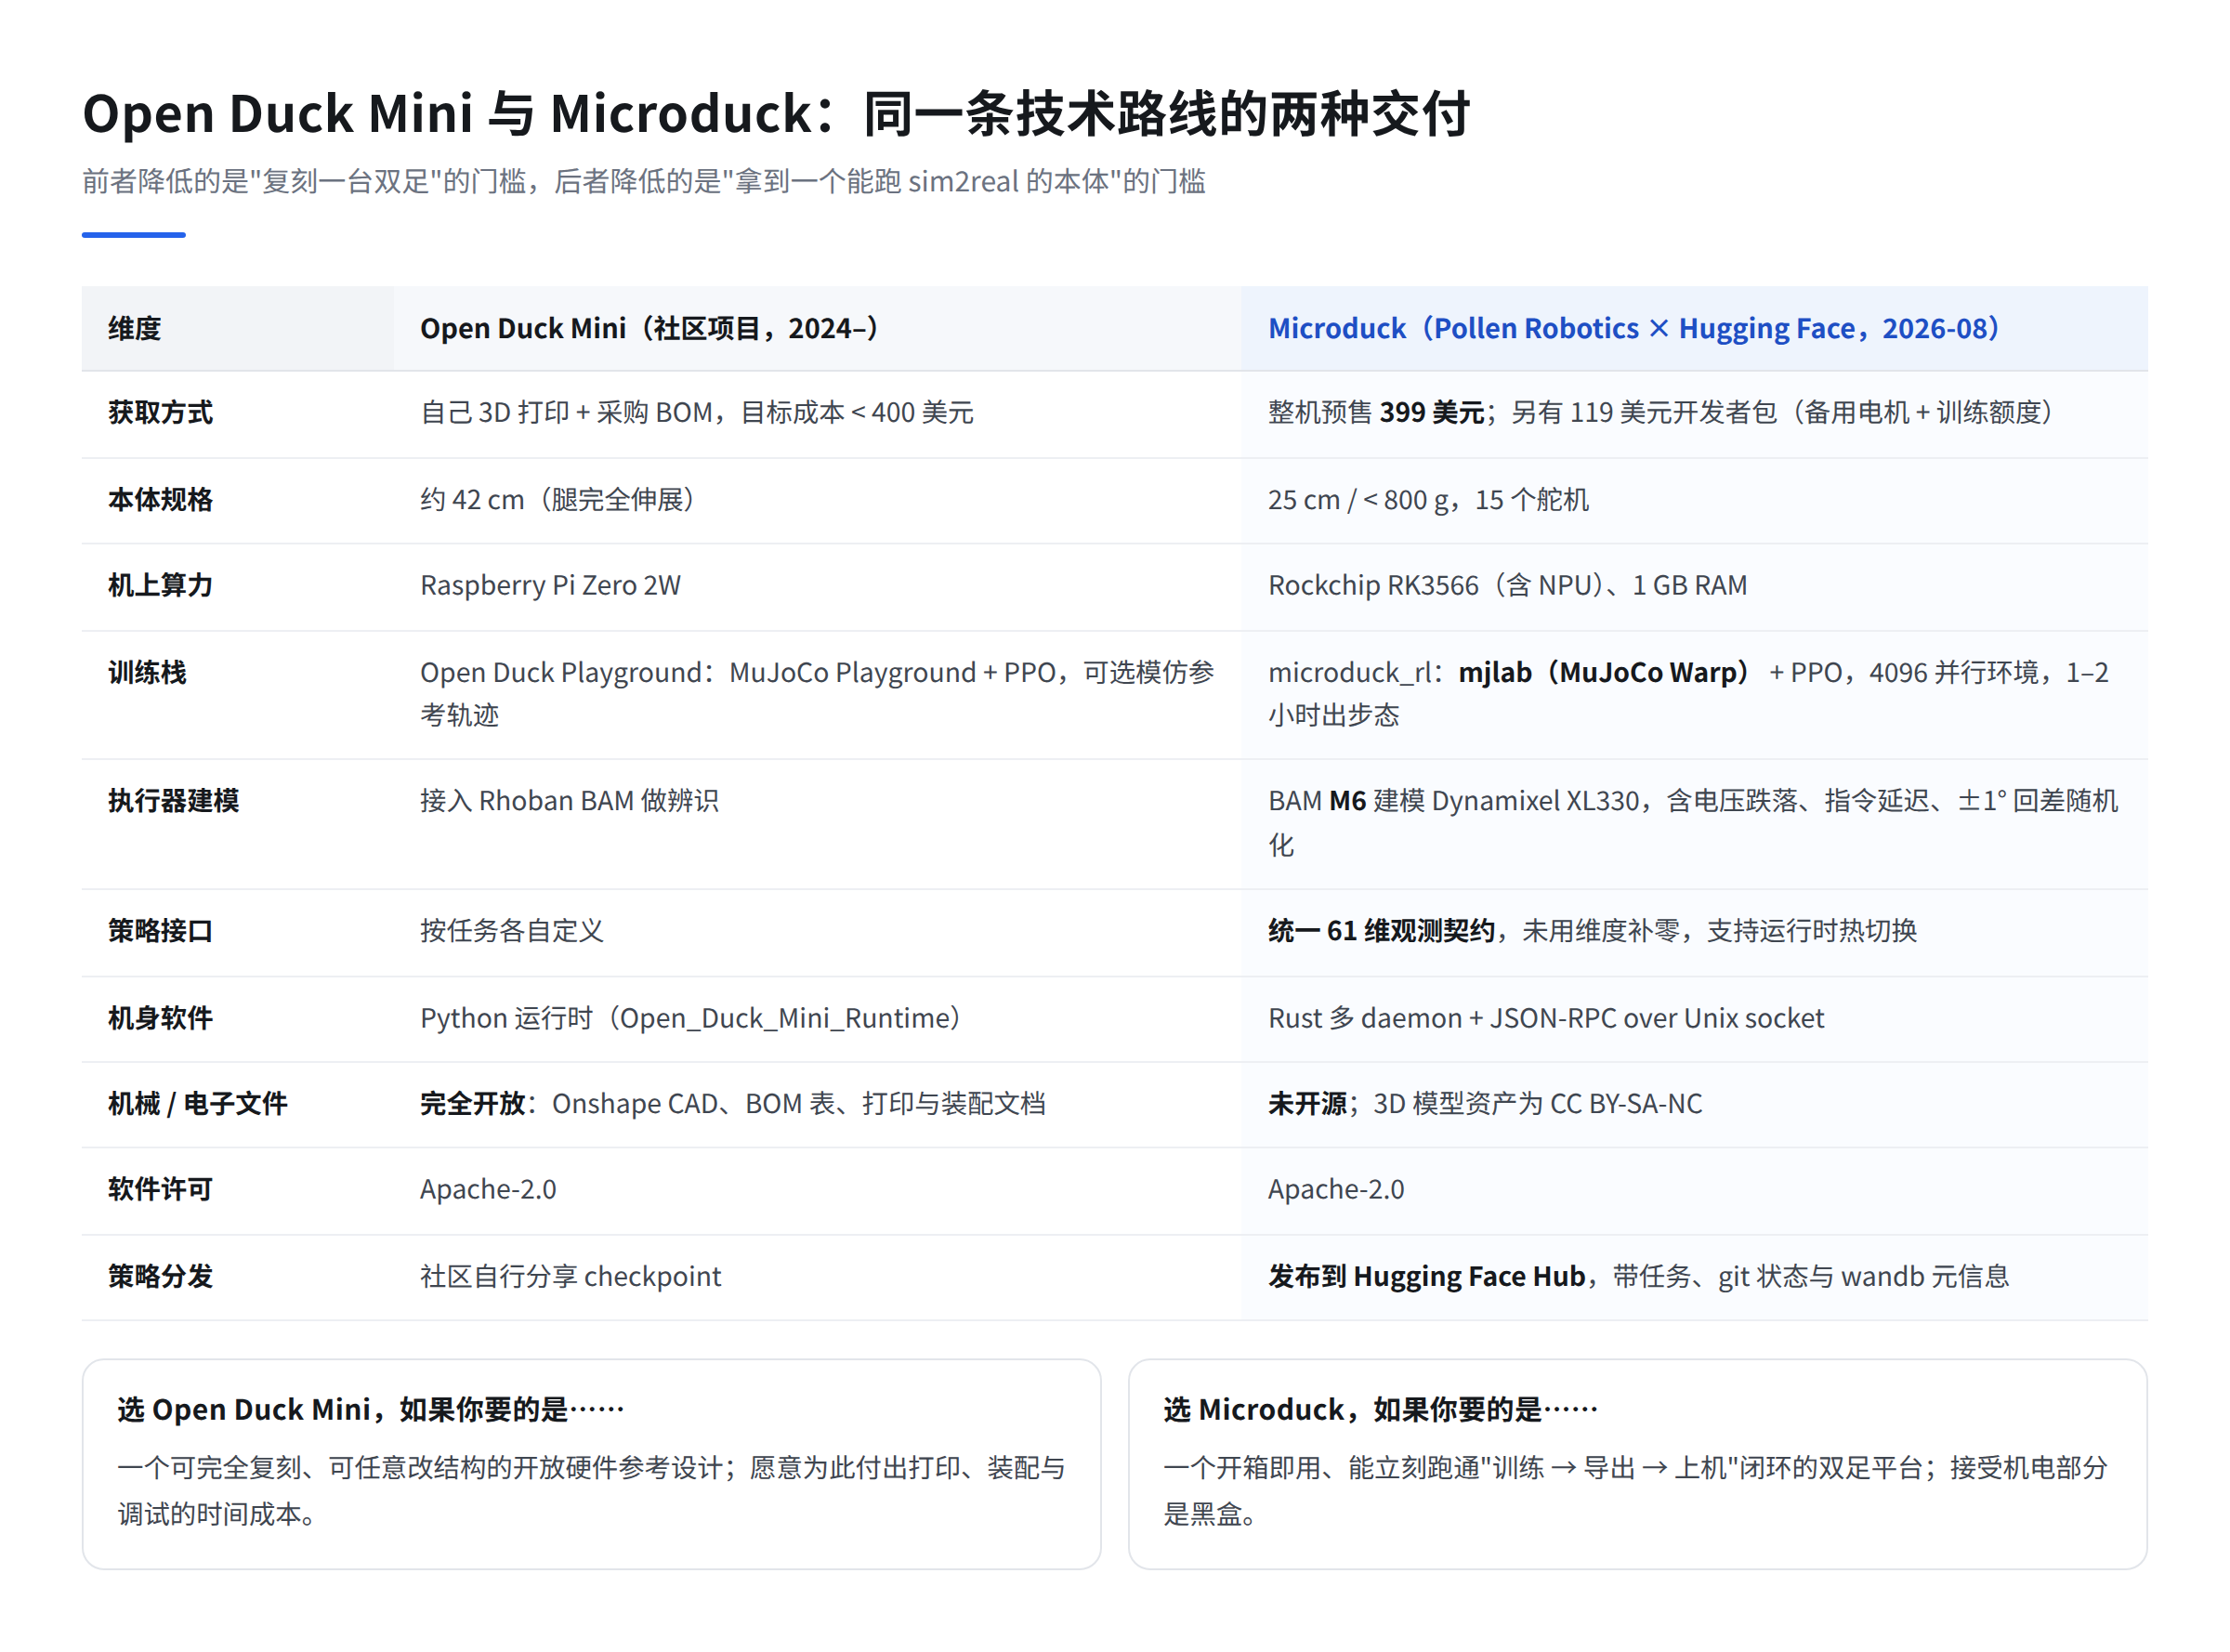
图6|Open Duck Mini 与 Microduck 的完整对比。
这和 Open Duck Mini 是两种性质:
- Open Duck Mini 是彻底的开放硬件。CAD、BOM、打印与装配文档全公开,你可以完全自己造一台,也可以把腿改长、把舵机换掉。
- Microduck 是"买一台硬件,软件随便你改"。你能改的是它的大脑,不是它的身体。
所以更准确的说法是:Microduck 把 Open Duck Mini 验证过的技术路线商品化了。它降低的是"拿到一个能跑 sim2real 的双足本体"的门槛,而不是"复刻一台双足机器人"的门槛。
对想做研究、教学、技能训练的人,这是好事——省掉的打印和调试时间,都能换成实验轮次。对想把它当作开放硬件参考设计的人,还是得回去看 Open Duck Mini。
11. 它没有解决的问题
一篇只讲优点的拆解没有价值,这里列几条真实的限制。
第一,视觉没有进策略闭环。 61 维观测里全是本体感知和指令,没有一维来自摄像头或 ToF。摄像头的数据由 mediad 推流出去,ToF 由 tofd 提供服务,但它们目前服务的是遥控与上层应用,不是运动策略。也就是说,这只鸭子的所有动作都是"盲走"——它靠 IMU 和关节反馈维持平衡,而不是靠看见地面。这不是缺陷,是清晰的分层,但如果你期待的是一个端到端的 VLA 平台,方向不对。
第二,算力上限锁死了后续路线。 RK3566 + 1 GB RAM 跑一个小 MLP 策略绰绰有余,跑任何有意义的视觉-语言模型都不现实。要在这台机器上做感知驱动的策略,要么外接算力,要么把模型压到极限。
第三,ToF 只有 64 个点。 8×8 的深度矩阵能回答"正前方有没有障碍",回答不了"障碍长什么样"。
第四,BAM 参数是绑舵机的。 这套辨识结果针对 Dynamixel XL330,换舵机就要重新搭台架、重新采数、重新拟合。这条路线的收益是确定的,成本也是确定的。
第五,续航 1 小时。 对做 RL 实验来说,这意味着一块电池大约对应一轮完整的实机验证,多备几块是刚需。
12. 如果你只是想动手
即使暂时不买硬件,microduck_rl 本身也是一份质量不错的参考实现,可以直接跑:
bash
# 1. 环境(需要 CUDA)
git clone https://github.com/pollen-robotics/microduck_rl
cd microduck_rl && uv sync

# 2. 训练一条行走策略,1–2 小时
uv run train Mjlab-Velocity-Flat-MicroDuck --env.scene.num-envs 4096

# 3. 导出(归一化会被烘进计算图,别手工转)
uv run scripts/export.py Mjlab-Velocity-Flat-MicroDuck \
    --wandb-run-path <entity/project/run_id>

# 4. 不上实机也能预演多策略切换
uv run scripts/infer_policy.py --walking walk.onnx --standing stand.onnx

# 5. 回归测试:锁死关节映射与奖励约定
uv run --with pytest pytest tests/
值得单独读的几个地方:BAM 执行器的接入方式、FrictionDRBamActuator 里域随机化的组织、backlash 孪生任务的实现,以及导出脚本里归一化是怎么被写进计算图的。这几件事拆开看都不复杂,但凑齐之后就是一条能跑通的 sim2real 管线。
13. 对做腿足与人形的团队,值得带走的三条
一、小本体的 sim2real 瓶颈在执行器模型,不在策略容量。 把舵机建到电压控制律这一层,收益远大于再给网络加两层 MLP。功率余量越薄、本体越小,这条越成立。反过来,如果你的 sim2real 一直调不通,先别急着换算法——去量一下满载时的实际输出力矩和仿真里的差多少。
二、用统一的观测契约把策略变成可插拔单元。 补零的代价很小,接口统一的收益很大。这是技能库、社区贡献、运行时热切换这三件事能不能成立的共同前提,而且越早定越好——项目做到一半再统一契约,代价会高一个数量级。
三、把训练管线本身当成产品的一部分交付。 用户能自己训出一个新动作、发布出去、装回机器人,这件事的生态价值远大于多送几个预置技能。而这一切的前提,是把训练时间压到一次午休能跑完。
结语
Microduck 最有意思的地方,是它把强化学习从"产品里的一个隐藏实现细节"变成了"产品本身"。你买到的不只是七个能用手柄触发的动作,而是产生这七个动作的那条完整管线——以及把第八个动作加进去的权利。
至于那只会自己爬起来的鸭子,它只是这套工程学最上镜的一个输出而已。
参考
- Microduck 机身控制栈:https://github.com/pollen-robotics/microduck
- Microduck RL 训练环境:https://github.com/pollen-robotics/microduck_rl
- Open Duck Mini:https://github.com/apirrone/Open_Duck_Mini
- Open Duck Playground:https://github.com/apirrone/Open_Duck_Playground
- Rhoban BAM(Better Actuator Models):https://github.com/Rhoban/bam
- Duclusaud et al., Extended Friction Models for the Physics Simulation of Servo Actuators, arXiv:2410.08650
- TechCrunch:Hugging Face is selling a cute $399 open source duck robot, Microduck(2026-08-27)
- MarkTechPost:Hugging Face Unveils Microduck: A $399 Open-Source 25 cm Biped You Train with Reinforcement Learning(2026-08-28)
- Engadget:Hugging Face and Pollen Robotics open pre-orders for the $399 Microduck