
基数、采样与成本
08|基数、采样与成本:既要看清问题,也要付得起账单
可观测性希望保留细节,但每一条 Span、每一个属性和每一天的保留时间都会产生成本。工程设计的目标不是采集一切,而是在关键时刻保留足够证据。
先把数据放对地方
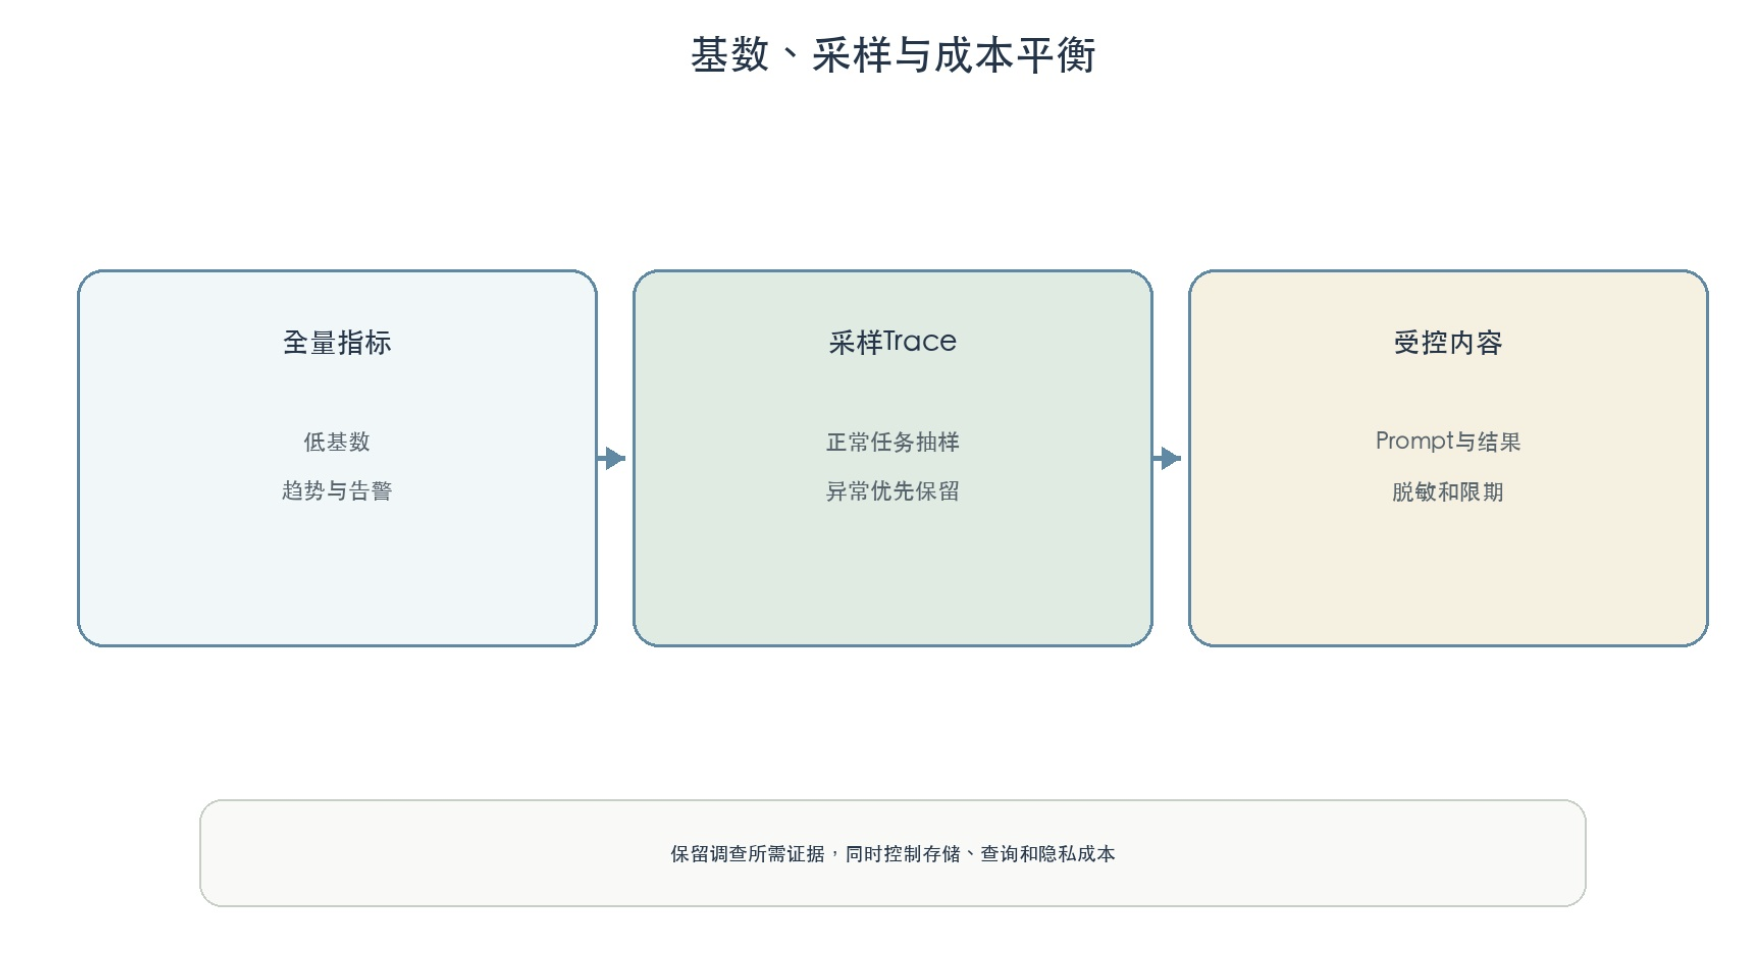
低基数字段适合指标,例如环境、状态和工具名;高基数标识适合 Trace 和事件,例如 task_id、trace_id 和 tool_call_id。把用户 ID 或任务 ID 直接作为指标标签,会迅速制造大量时间序列。
一个简单案例
每天有一百万次 Agent 任务,全部保存完整 Prompt 和工具结果,成本和隐私风险都会失控。可以保留全部低成本指标,只采样部分正常 Trace,同时保留全部错误、超时、人工接管和高价值任务。
原始内容默认不采集,只保存长度、Token、哈希和必要摘要;需要复盘时,通过受控引用访问原文。
现实挑战:采样恰好丢掉罕见故障
Head Sampling 在请求开始时决定是否保留 Trace,成本低,但当时还不知道任务最终会不会失败。Tail Sampling 在执行完成后决定,能保留错误和高延迟任务,却需要更多缓冲和 Collector 容量。
现象—假设—证据—判断
现象:用户报告偶发死循环,但平台中没有对应 Trace。假设包括未埋点、导出失败、采样丢弃。证据显示同一时间指标记录了循环次数异常,Collector 正使用 1% 随机 Head Sampling。判断:罕见故障大概率在开始阶段被丢弃。
改进方式是增加错误与长任务的 Tail Sampling 规则,同时限制最大持续时间和缓冲规模。
成本也需要可观测
至少持续观察每日 Span 数、平均属性大小、Token 内容量、采样率、Collector 丢弃量、后端写入量和查询扫描量。没有这些数据,采集策略只能靠感觉调整。
小结
控制成本不是少采数据,而是分层保存:指标覆盖全局,Trace 保存过程,异常优先保留,敏感原文受控访问。采样策略必须围绕真实故障模式验证。