
紫东太初开源 ZDTaichu5.0-9B 空间智能模型:不只“看懂图片”,还想成为机器人的空间大脑
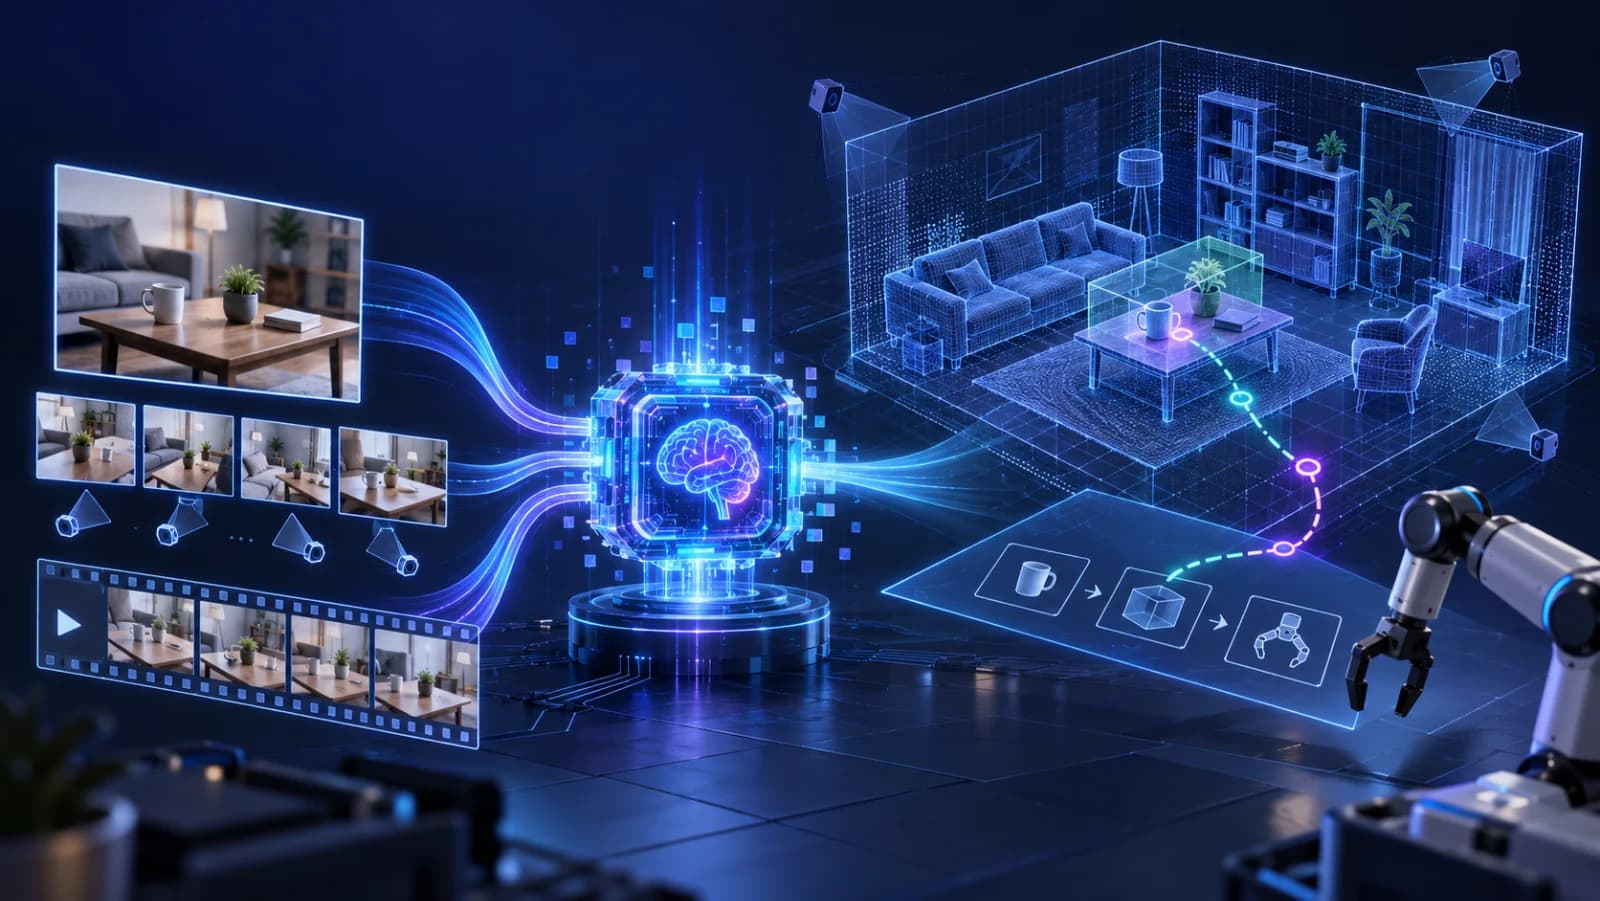
一个多模态模型会识图、会 OCR、会回答图表问题,已经不算稀奇。
真正困难的是:当视角发生变化、物体彼此遮挡,或者机器人需要连续完成多个步骤时,模型还能不能回答“谁在谁的左边”“换个角度后目标在哪里”“下一步应该调用什么技能”?
这正是紫东太初最新开源的 ZDTaichu5.0-9B 想解决的问题。
它不是一个直接输出关节控制量的 VLA,也不是单纯为跑分训练的视觉问答模型。更准确地说,它是一款面向通用视觉理解、空间推理、Agent 工具调用与具身智能适配的 9B 级多模态基础模型:先把视觉世界看懂,再为规划器、工具系统或机器人控制栈提供高层判断。
项目当前已经开放模型权重、推理代码、Hugging Face / ModelScope 下载入口,以及适配后的 vLLM 服务方案。
本文核验时间:2026 年 9 月 16 日。当前公开材料以项目 Blog、GitHub README 和模型卡为主,尚未提供一篇完整的同行评审论文或正式技术报告。因此,本文会把“官方已公开事实”“Benchmark 结果”和“工程判断”分开说明。
先看结论:它到底值得关注什么?
| 项目 | 官方信息 |
|---|---|
| 参数规模 | 约 9B |
| 语言骨干 | Qwen3.5-9B LLM Decoder |
| 视觉编码器 | C-RADIOv4-H |
| 输入 | 文本、单图、多图、视频 |
| 视觉分辨率 | 任意分辨率输入 |
| 上下文 | 模型卡标注最高 128K tokens |
| 权重体积 | Hugging Face 文件页约 19.6 GB |
| 主要能力 | 通用视觉、空间推理、高层具身理解、Agent 工具调用 |
| 服务方式 | Transformers 离线推理;官方改造版 vLLM 提供 OpenAI 兼容接口 |
| 权重许可 | NVIDIA Open Model License,并需遵守 Qwen3.5 等上游声明 |
如果只用一句话概括:
ZDTaichu5.0-9B 的价值,不是用 9B 参数取代所有大模型,而是在保留通用视觉能力的同时,把多视角、三维关系、可供性和高层具身规划补得更完整。
它不是“看见”,而是试图建立空间关系
普通视觉问答更像是在一张图里找证据:读文字、识物体、数数量、回答属性。
空间智能多走了几步:
- 二维关系:物体位于谁的左侧、上方或附近;
- 跨视角关联:同一场景换一个相机位置后,仍能对应同一批物体;
- 三维关系与心智旋转:从有限画面推断遮挡、深度、朝向与结构;
- 可供性理解:判断物体能被怎样操作,动作需要满足什么前提;
- 高层技能规划:把任务拆成可交给外部工具或机器人技能库的步骤。
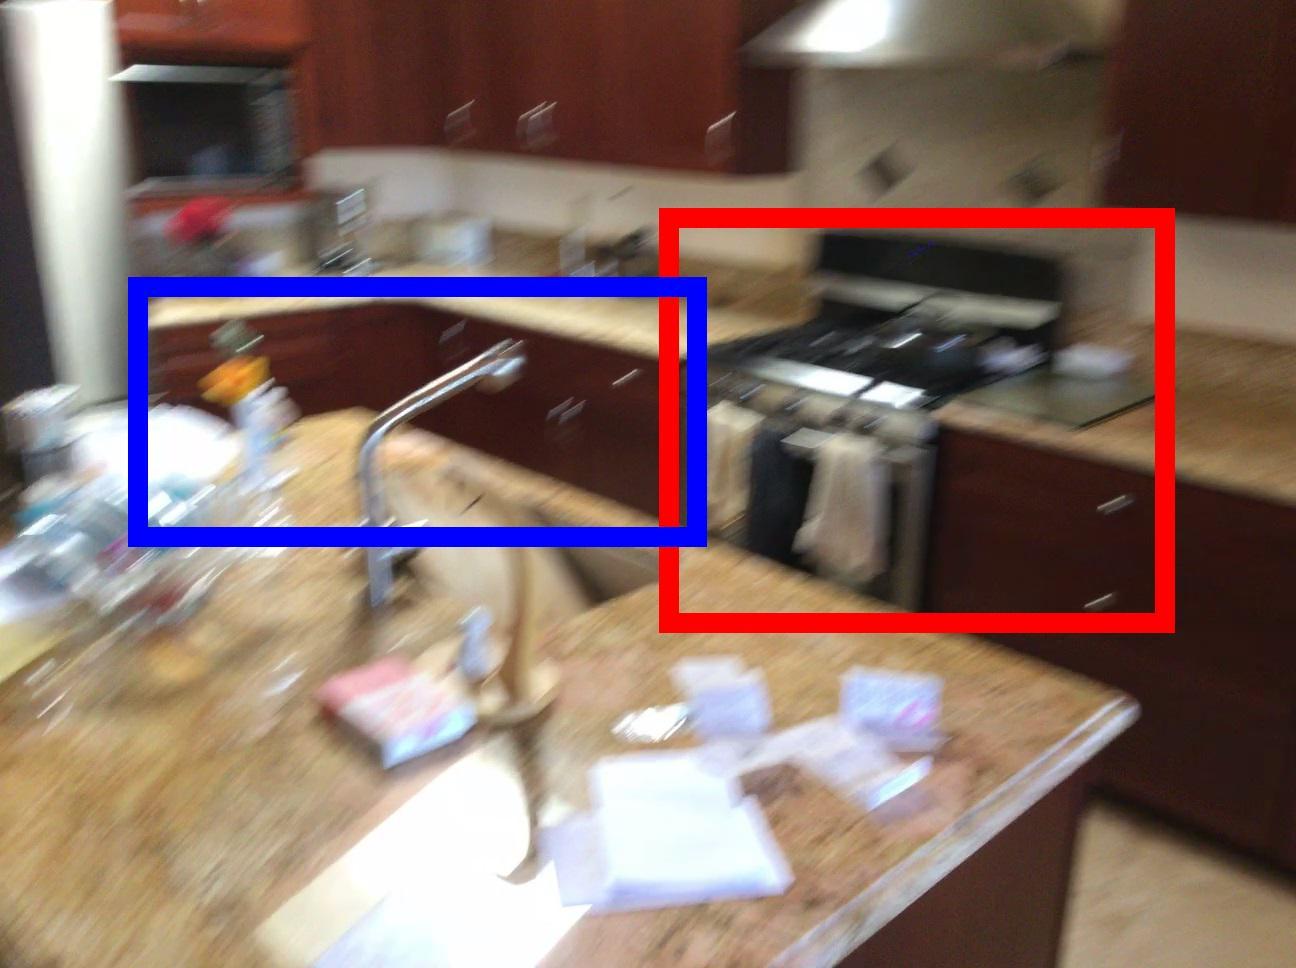
图 2|官方 3D spatial relations 案例输入(来源:项目 Blog,case-06)。
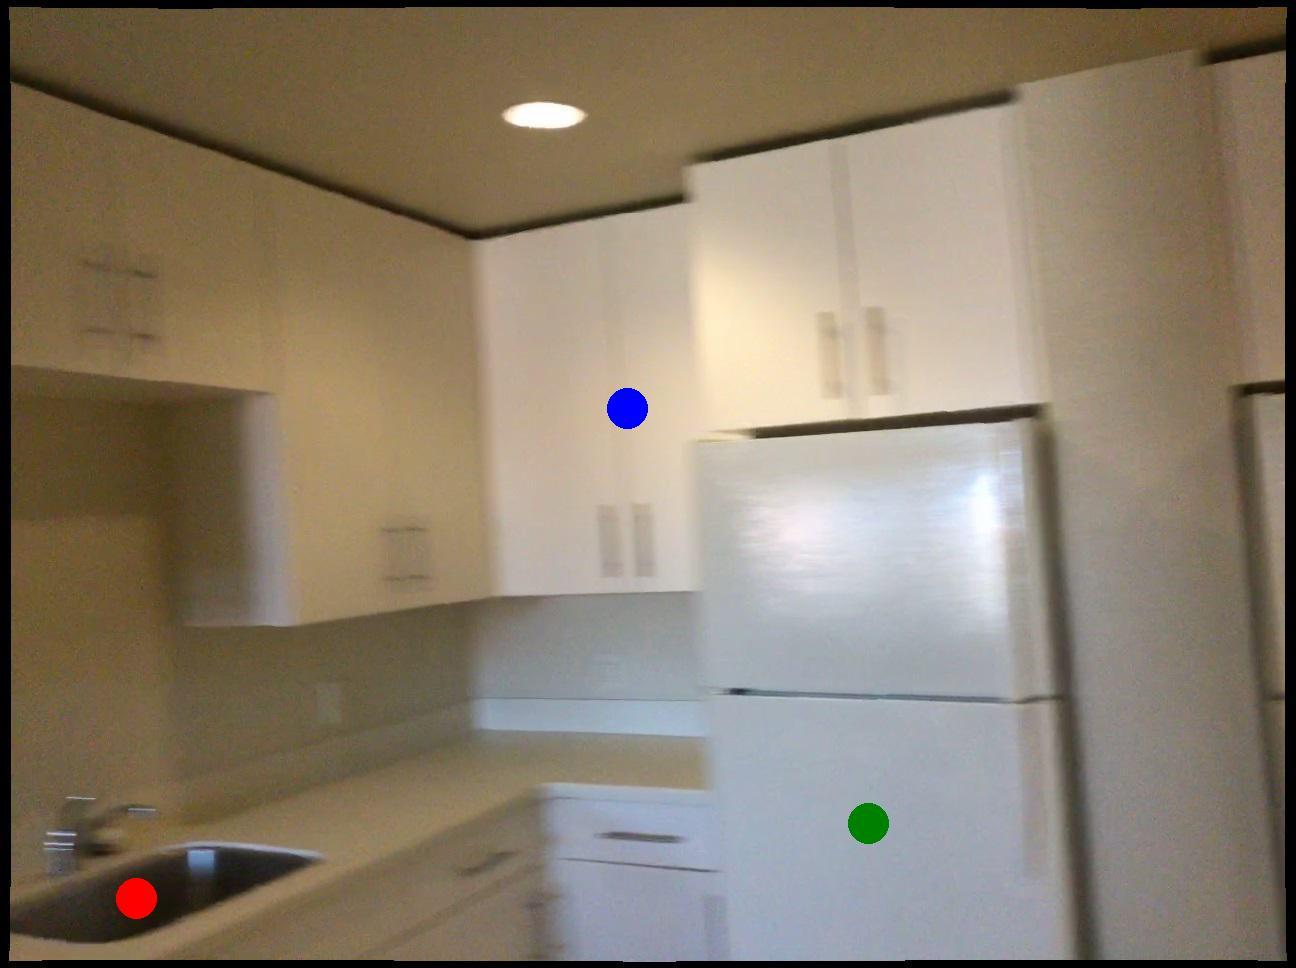
图 3|官方 Multi-object spatial relations 案例输入(来源:项目 Blog,case-07)。
这两张图看起来并不“高清”:一张带明显运动模糊,另一张只有稀疏彩色标记。它们恰好说明空间任务的难点——模型不能只靠漂亮的静态物体特写,而要在视角变化、遮挡和弱视觉证据下维持关系判断。
放进机器人系统,它处在哪一层?
这里必须划清一条边界:空间推理模型不等于完整的 VLA,更不等于低层控制器。
ZDTaichu5.0-9B 可以根据图像、视频和任务描述给出空间判断、高层技能计划或工具调用参数;但电机控制、轨迹生成、碰撞检查、力控、安全约束和执行后的终态验证,仍要由外部系统负责。
放到一套真实机器人栈里,更合理的链路是:
相机 / 视频 / 任务指令
        ↓
ZDTaichu5.0-9B
空间关系 + 可供性 + 高层技能计划
        ↓
Schema 校验 / 权限与安全检查
        ↓
技能库 / 运动规划器 / VLA 动作专家
        ↓
机器人执行 → 新观测 → 再规划
因此,它更像“具身大脑”的高层感知与推理模块,而不是直接替代实时动作生成模型。
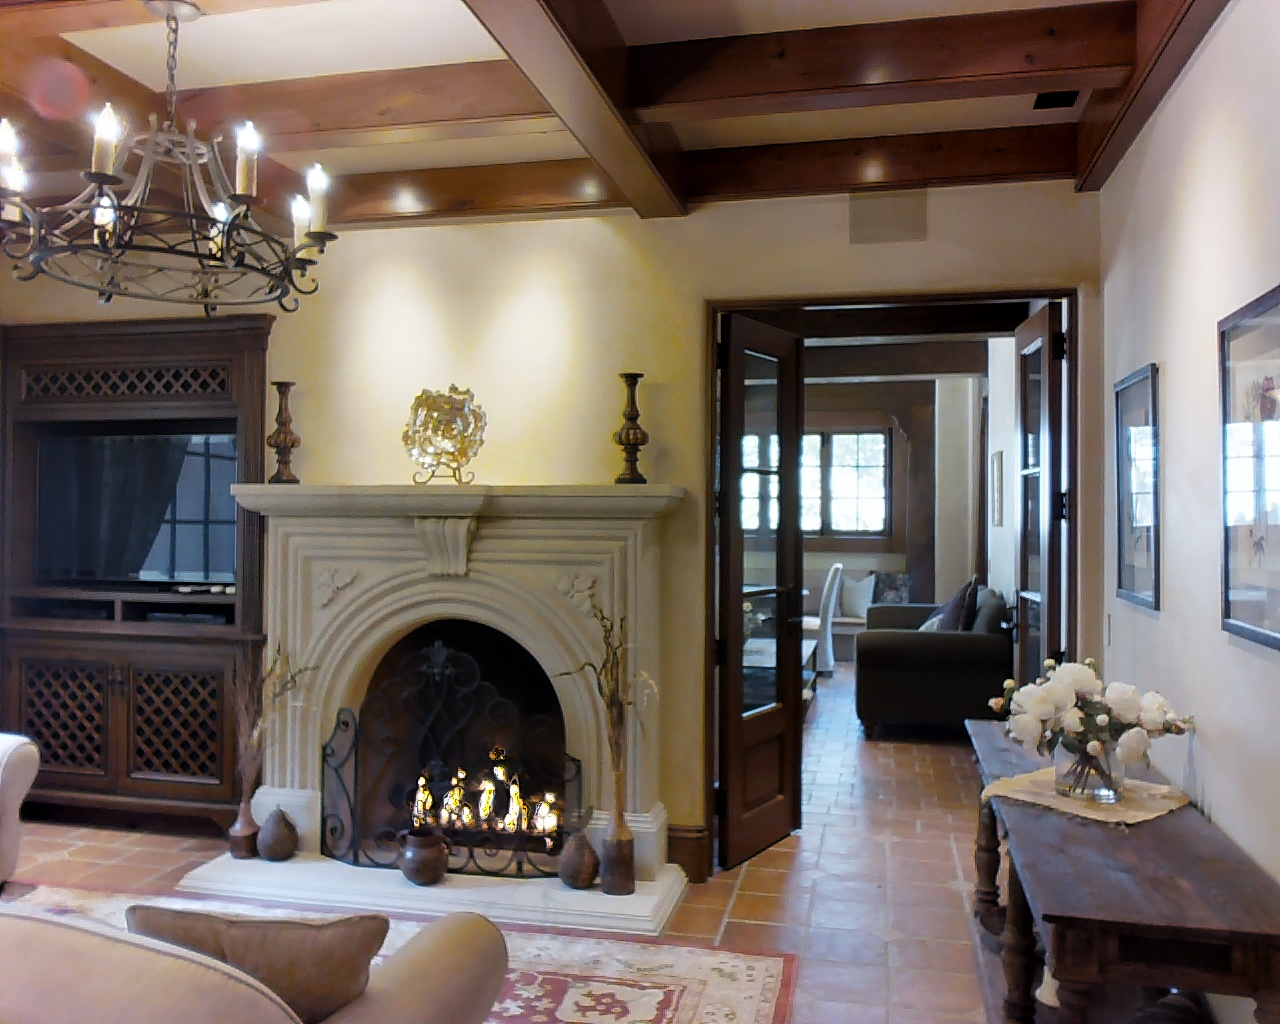
图4|官方 Multi-view indoor spatial understanding 案例的两幅输入(来源:项目 Blog,case-10)。模型需要跨视角关联同一室内空间,而不是把两张图分别回答。
EARR:难题多想一步,简单题直接通过
ZDTaichu5.0-9B 公开了一个很值得研究的机制:Entropy-Gated Adaptive Recurrent Reasoning,熵门控自适应循环推理,简称 EARR。
直觉并不复杂。
模型正常前向计算后,会得到当前 token 的概率分布。如果分布很集中,说明模型相对确定,可以直接继续生成;如果分布熵较高,意味着模型自己也拿不准,EARR 就让一段中间层在潜空间中额外循环,对隐藏状态继续细化。
它不是在文本里强制输出更长的思维链,也不是再次调用一个外部模型,而是在模型内部动态增加计算深度。
官方给出的稳定化设计包括:
- 阻尼与锚定更新:限制每次隐藏状态修正幅度,避免循环发散;
- 双重停止信号:同时观察输出分布的 KL 散度和隐藏状态残差;
- 轨迹读出与回滚:在多个候选状态中选择风险更低的结果,必要时退回先前状态。
不过,这里不能把“低熵”误解成“答案正确”。模型可能非常自信地答错,所以 EARR 仍然需要视觉证据、工具执行反馈与任务终态检查配合。
公开的 batch size=1 结果中,开启 EARR 后:
| Benchmark | 基础模型 | 开启 EARR |
|---|---|---|
| ViewSpatial | 0.5410 | 0.5427 |
| MMSI-Bench | 0.3680 | 0.3740 |
| MindCube-tiny | 0.7404 | 0.7500 |
| RoboSpatial | 0.6800 | 0.7000 |
增益并非数量级跃升,但方向一致。它更像一种“按难度分配计算”的推理增强机制,而不是把 9B 模型凭空变成更大模型。
训练数据怎么把“空间感”喂出来?
官方 Blog 披露了五阶段、约 1.28T tokens 的数据课程:
| 阶段 | Token 规模 | 重点 |
|---|---|---|
| Stage 1 | 364B | 双语图文、OCR 语料、短视频描述 |
| Stage 2 | 737B | 文档、PDF/OCR、长尾中文视觉数据、视频 |
| Stage 3 | 136B | 图像推理、视频问答、空间与物理任务、CAD 类问题 |
| Stage 4 | 28B | 长视频与高难专家指令 |
| Stage 5 | 10B | 过滤、采样与合成的空间、OCR、结构化视觉任务 |
训练上下文也从 8K、16K、32K 逐步扩展到 128K,最后加入高质量退火和基于可验证奖励的 GRPO:答案正确性、空间坐标命中和输出格式都可以成为自动奖励信号。
这条路线有一个很明确的工程含义:空间能力不是只靠换视觉编码器得到的,而是来自数据课程、任务构造、可验证奖励和推理机制的组合。
Benchmark 怎么看,才不被“第一”带跑?
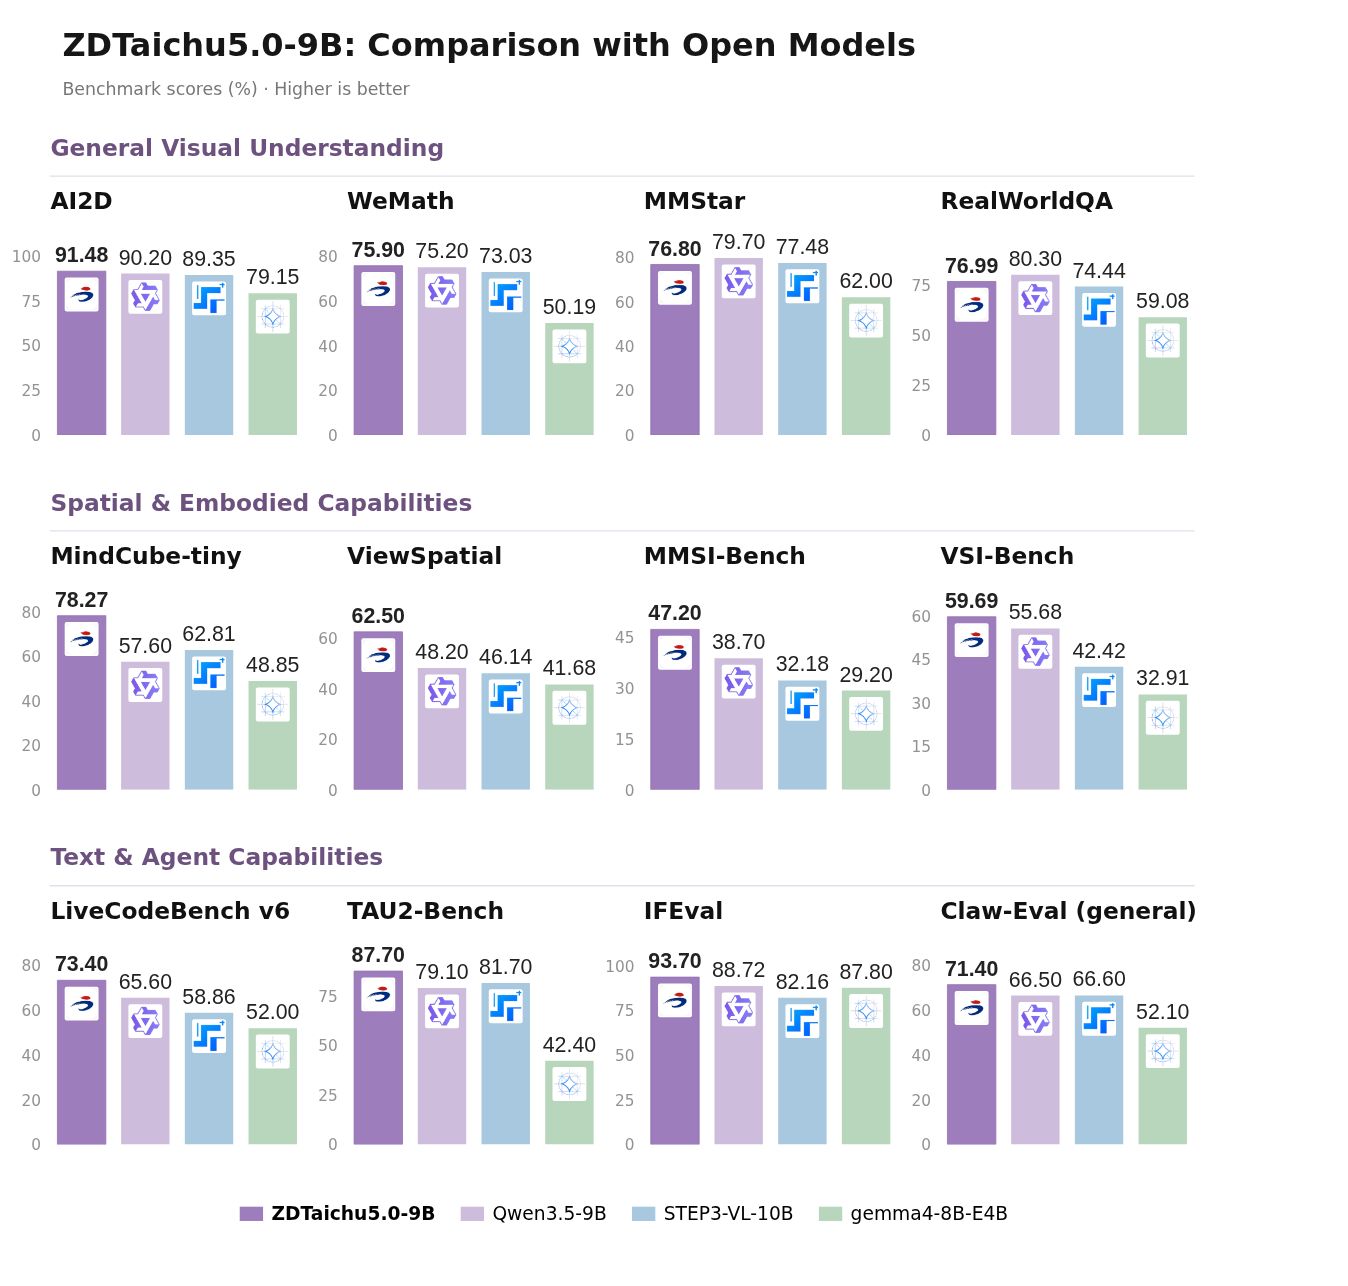
图 5|官方与 10B 级开源模型的 Benchmark 对比。
官方对比中,ZDTaichu5.0-9B 在多项空间与 Agent 指标上领先所列同规模开源模型:
- ViewSpatial:62.50;
- MMSI-Bench:47.20;
- MindCube-tiny:78.27;
- VSI-Bench:59.69;
- TAU2-Bench:87.70;
- Claw-Eval general:71.40;
- IFEval:93.70。
与此同时,它并非每个通用视觉指标都第一。例如 MMStar、OCRBench、MathVista Mini 等项目上,Qwen3.5-9B 或其他模型仍有更高分数。这反而更符合它的定位:重点补强空间与具身理解,而不是宣称所有能力全面领先。
还要注意三点:
- 官方表格同时使用了本地评测结果与其他模型公开报告的外部成绩,未必是完全相同的推理栈;
- TAU2-Bench 与 Claw-Eval 的本地评测使用 DeepSeek-V4-Flash-0731 作为模拟用户和/或裁判;
- ViewSpatial、MMSI-Bench、MindCube-tiny、VSI-Bench 的评测提示中增加了特定输出格式要求。
所以这些分数适合说明“能力方向很强”,但不能直接换算成真实机器人成功率、控制频率或跨本体泛化能力。
Quick Start:先跑通一张图
1. 环境与硬件前提
官方离线示例固定了以下主要版本:
pip install transformers==5.3.0 torch==2.10.0 torchvision==0.25.0 accelerate timm
注意:官方 README 当前把
transformers误写成了tranformer,直接复制会安装失败。上面的命令已按正确包名修正。
模型文件约 19.6 GB。官方没有公布“最低显存”或统一吞吐数据,因此不能把 24 GB、32 GB 或某张消费卡写成已验证配置。按 BF16 权重体积推断,单卡 24 GB 会比较紧张;32 GB 级 GPU 更适合先做单图、短输出验证,但 128K 长上下文、视频和高并发还会显著增加 KV Cache 与视觉 token 开销。这是工程估算,不是官方 Benchmark。
建议单独创建环境,不要直接覆盖现有训练环境:
python -m venv .venv-zdtaichu
source .venv-zdtaichu/bin/activate
python -m pip install -U pip
pip install transformers==5.3.0 torch==2.10.0 torchvision==0.25.0 accelerate timm
2. 下载并设置模型
模型可以从 Hugging Face 或 ModelScope 下载。以 Hugging Face 路径为例:
export ZDTAICHU_MODEL_ID=TaichuAI/ZDTaichu5.0-9B
export CUDA_VISIBLE_DEVICES=0
如果服务器需要离线运行,可以先将仓库完整下载到本地,再把 ZDTAICHU_MODEL_ID 改为本地目录。
3. 最小离线推理脚本
保存为 demo.py:
import os
import torch
from transformers import AutoModel, AutoProcessor

model_id = os.environ["ZDTAICHU_MODEL_ID"]

processor = AutoProcessor.from_pretrained(
    model_id,
    trust_remote_code=True,
    use_fast=False,
)

model = AutoModel.from_pretrained(
    model_id,
    trust_remote_code=True,
    torch_dtype=torch.bfloat16,
    device_map="auto",
    attn_implementation="sdpa",
).eval()

messages = [{
    "role": "user",
    "content": [
        {"type": "image", "image": "floorplan.png"},
        {"type": "text", "text": "Which room is directly to the left of the kitchen?"},
    ],
}]

inputs = processor.from_messages(
    messages,
    return_tensors="pt",
).to(model.device)

with torch.inference_mode():
    output_ids = model.generate(
        **inputs,
        max_new_tokens=256,
        do_sample=False,
    )

generated_ids = output_ids[:, inputs["input_ids"].shape[1]:]
answer = processor.batch_decode(
    generated_ids,
    skip_special_tokens=True,
)[0]
print(answer)
运行:
python demo.py
成功判据不是输出某句固定答案,而是:模型和处理器能够加载,GPU 上完成一次生成,并针对平面图给出可读的空间关系回答。
最常见的失败原因:
- 安装命令中的
transformers包名写错; - 依赖版本与当前环境冲突;
- 模型约 19.6 GB,加载后显存不足;
trust_remote_code=True未开启,导致自定义架构无法加载;- 输入图片路径不存在,或当前工作目录不对。
服务化:暴露 OpenAI 兼容接口
官方不是直接使用标准 vLLM,而是提供了适配 ZDTaichu5.0 架构、量化与 speculative decoding 的 v0.26.0-zdtaichu 分支和 Docker 镜像。
官方推荐命令:
docker run -d \
  -e CUDA_VISIBLE_DEVICES=0 --gpus all \
  --privileged --ipc=host \
  -p 18050:8000 \
  registry-dx.wair.ac.cn/taichu-public/vllm-openai:v0.26.0.zdtaichu_5_0 \
  TaichuAI/ZDTaichu5.0-9B \
    --max-model-len 220000 \
    --served-model-name zdtaichu \
    --mamba-ssm-cache-dtype float32 \
    --gdn-prefill-backend triton \
    --trust-remote-code \
    --tensor-parallel-size 1 \
    --generation-config vllm
这套镜像要求 CUDA ≥ 12.9、NVIDIA Driver ≥ 575.51.03。
这里还有一个版本边界:模型卡写的是“最高 128K tokens”,而服务示例设置了 --max-model-len 220000。后者是服务启动参数,不应直接改写成“模型已公开验证 220K 原生上下文”。正式部署前应按真实图片数量、视频帧数和并发重新压测,并从更保守的长度开始。
服务启动后,接口地址为:
http://<host>:18050/v1
最小图像请求:
import base64
import requests

def data_url(path: str, mime: str) -> str:
    with open(path, "rb") as f:
        data = base64.b64encode(f.read()).decode()
    return f"data:{mime};base64,{data}"

body = {
    "model": "zdtaichu",
    "messages": [{
        "role": "user",
        "content": [
            {"type": "text", "text": "描述场景中的空间关系。"},
            {"type": "image_url", "image_url": {
                "url": data_url("scene.png", "image/png")
            }},
        ],
    }],
    "temperature": 0,
    "top_p": 0.95,
    "top_k": 20,
}

resp = requests.post(
    "http://127.0.0.1:18050/v1/chat/completions",
    json=body,
    timeout=600,
)
resp.raise_for_status()
print(resp.json()["choices"][0]["message"]["content"])
对于空间定位任务,官方建议 temperature=0;其他任务使用 temperature=1.0、top_p=0.95、top_k=20。
Demo 命令不等于生产配置
官方 Docker 示例使用了 --privileged。在生产环境中,不应默认让推理容器获得广泛宿主权限。更稳妥的做法是:
- 先验证是否确实需要
--privileged,能删除就删除; - 固定镜像版本或 digest,避免环境漂移;
- 将模型缓存单独挂载,并设定磁盘配额;
- 限制接口访问来源,增加鉴权、并发上限与请求体大小限制;
- 对图片、视频类型及帧数做白名单校验;
- 对工具调用先做 Schema 校验、权限判断和必要的人工确认。
模型卡也明确说明:模型本身不会执行工具。真正执行外部动作的是周围的应用程序,因此安全责任不能交给一次模型输出。
怎样接入机器人或空间 Agent?
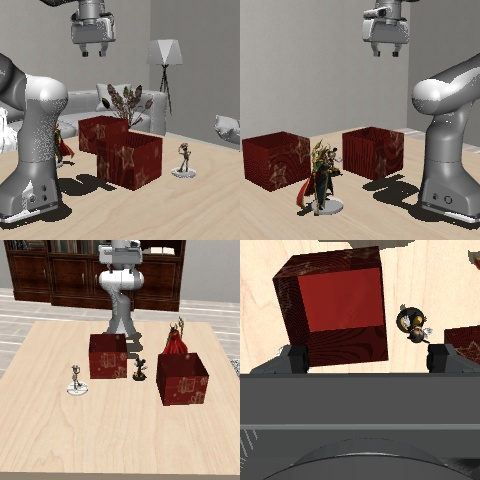
图 6|官方 Embodied skill planning 案例输入与标注视图(来源:项目 Blog,case-14)。任务要求将目标物体放入满足空间条件的礼盒。
第一版不建议让模型直接控制机械臂。更稳妥的接入方式是固定一个高层输出协议:
{
  "target": "loki",
  "relation": ["right", "nearest"],
  "selected_container": "giftbox_2",
  "skill": "pick_and_place",
  "confidence": 0.82,
  "preconditions": ["target_visible", "container_reachable"]
}
随后由外部系统完成:
JSON Schema 校验
→ 目标与地图实体绑定
→ 可达性 / 碰撞 / 安全检查
→ 调用 pick_and_place 技能
→ 视觉或力觉验证终态
→ 把新观测交回模型
如果用于你现有的 FAST-LIVO2 + YOLO 语义地图路线,它最合适的初始角色不是替代定位或检测,而是放在更上层:
- 输入当前 RGB、多视角历史帧、商品语义实体和任务描述;
- 判断跨视角物体关系、遮挡与可供性;
- 输出高层查找、移动、观察或抓取意图;
- 由 FAST-LIVO2、Persistent Semantic Map、YOLO/深度与机器人技能栈完成坐标落地和执行。
这样能把“大模型擅长的语义与空间推理”和“几何系统擅长的厘米级定位”分开,系统边界会更可靠。
Jetson 能不能直接跑?
当前官方材料没有给出 Jetson Orin 的部署、量化权重或端侧延迟。
尤其是官方 vLLM Docker 要求 CUDA 12.9 以上,而 JetPack 5.1.5 对应的 CUDA 11.4 明显不满足。这意味着:
它目前不能按官方 Docker 命令直接搬到你现有的 Orin 环境。
如果要做端侧尝试,需要另行解决量化、算子兼容、视觉编码器支持、KV Cache、视频帧采样和推理后端适配。更现实的第一阶段是:
Orin:相机 / YOLO / 深度 / 定位 / 控制
             ↓ 局域网
5090 工作站:ZDTaichu5.0-9B 空间推理与高层规划
             ↓
Orin:校验后执行具体技能
先验证模型是否真正改善任务成功率,再决定是否投入端侧量化与 TensorRT/其他后端适配。
适合什么,不适合什么?
适合
- 需要多图、视频和跨视角空间推理的研究;
- 机器人高层任务规划、可供性判断与技能选择;
- 室内场景、货架、实验室、工业工位等空间 Agent;
- 需要中文能力、OCR、图表理解与空间能力兼顾的本地多模态系统;
- 想研究自适应循环推理、困难 token 动态算力分配的团队。
暂不适合
- 直接替代低层 VLA 动作专家或实时控制器;
- 需要官方 Jetson 一键部署与明确端侧 FPS 的项目;
- 显存非常有限、又没有量化与分层卸载条件的设备;
- 需要已同行评审论文、完整消融与训练细节才能立项的严谨复现;
- 只看单张普通图片、对空间能力没有需求的轻量应用。
如果是我,我会怎么落地?
我会分五步,不会一上来就接机器人:
- 离线小样本评测:挑 50~100 个真实场景,测试空间关系、遮挡、多视角关联和可供性;
- 与现有模型盲测:同一输入对比 Qwen3.5-9B 或当前在用 VLM,先确认增益;
- 固定结构化输出:只允许模型输出预定义 JSON,不直接执行工具;
- 接数字孪生或仿真:验证技能选择、失败恢复和终态检查;
- 再接真实机器人:保留几何定位、运动规划、碰撞检测与安全控制闭环。
EARR 也应作为可控开关做 A/B 测试:记录准确率、首 token 延迟、总生成延迟和循环触发比例,而不是默认“开了就一定更好”。
最后总结
ZDTaichu5.0-9B 最值得关注的,不只是 9B 这个尺寸,而是它试图把过去分散的能力收拢到同一个模型里:
通用视觉理解
→ 多视角与三维空间推理
→ 可供性与高层具身规划
→ Agent 工具调用
它目前仍有清晰边界:没有完整技术论文,没有官方 Jetson 数据,Benchmark 也不能等同于真实机器人成功率。但对于正在做空间语义地图、机器人高层规划、多模态物理世界理解的团队,它已经是一个值得尽快做小规模实测的开源底座。
真正正确的打开方式,不是把它宣传成“9B VLA 控制一切”,而是把它放到该在的位置:让模型负责理解与决策,让几何、控制与安全系统负责把决策可靠地变成动作。