
把通用 Agent 塞进 2B:MiniCPM5-2B 开源,1.56GB 量化模型如何在端侧跑起来
过去几年,端侧大模型一直在解决一个问题:小设备能不能把话说好?
参数从几十亿压到十几亿,长文本、数学、代码和多语言能力也逐渐被塞进笔记本、手机和边缘计算盒子里。到了今天,问题开始变化:
端侧模型能不能不只回答问题,还能拆任务、调工具、接收执行反馈,再继续把事情做完?
这才是 Agent 真正难的地方。它不是把聊天模型换一个系统提示词,而是要求模型在多轮交互中持续保持目标,输出结构化工具调用,并在搜索、代码执行、文件处理等结果返回后继续判断下一步。
2026 年 9 月 7 日,面壁智能/OpenBMB 发布了 MiniCPM5-2B。这是一个面向本地部署和资源受限场景的稠密语言模型。它最值得关注的地方并不只是“又一个 2B 小模型”,而是同时把三层东西摆到了开发者面前:
- 可直接部署的模型权重与多种量化格式;
- 工具调用、搜索、代码和通用 Agent 训练数据;
- 从 Transformers、llama.cpp 到 SGLang、vLLM、MLX 的部署与微调说明。
换句话说,这次开放的不只是一个结果,更接近一套“端侧 Agent 模型怎么训、怎么跑、怎么接”的样板。
不过,“端侧通用 Agent”也很容易被宣传语带偏。MiniCPM5-2B 是 Agent 的大脑,不是完整的电脑操作系统;它会生成工具调用,不代表模型权重自己就能浏览网页、修改文件或控制设备。要真正做事,仍然需要 Agent Harness、工具实现、权限控制和结果验证。
先看结论:MiniCPM5-2B 到底是什么
| 项目 | MiniCPM5-2B |
|---|---|
| 模型类型 | 纯文本因果语言模型,稠密 Transformer |
| 架构 | 标准 LlamaForCausalLM |
| 参数量 | 2,516,756,480;其中非 Embedding 参数约 1.982B |
| 层数 | 42 |
| 注意力 | GQA,16 个 Q Head / 2 个 KV Head |
| 原生上下文 | 131,072 tokens |
| 主要能力 | 中文/英文对话、推理、代码、长文本、工具调用、Agent 任务 |
| 官方格式 | BF16、GGUF、MLX 4-bit、GPTQ 4-bit、DSpark 草稿模型等 |
| Q4_K_M 文件大小 | 1.56 GB;这是模型文件大小,不是完整运行内存 |
| License | Apache-2.0 |
这里有两个容易误解的点。
第一,名称里的“2B”是尺寸级别,不是精确参数数。官方模型卡给出的总参数约为 25.17 亿,非 Embedding 参数约为 19.82 亿。
第二,它是纯文本模型,不是 MiniCPM-V 或 MiniCPM-o 那类多模态模型。它不能直接读取图片、视频或语音;如果要处理这些输入,需要外接 OCR、视觉模型或多模态前端。
以上模型信息、格式列表与 License 均可在 MiniCPM5-2B 官方模型卡 和 MiniCPM 主仓库 中核对。
所谓“端侧 Agent”,真正的链路是什么
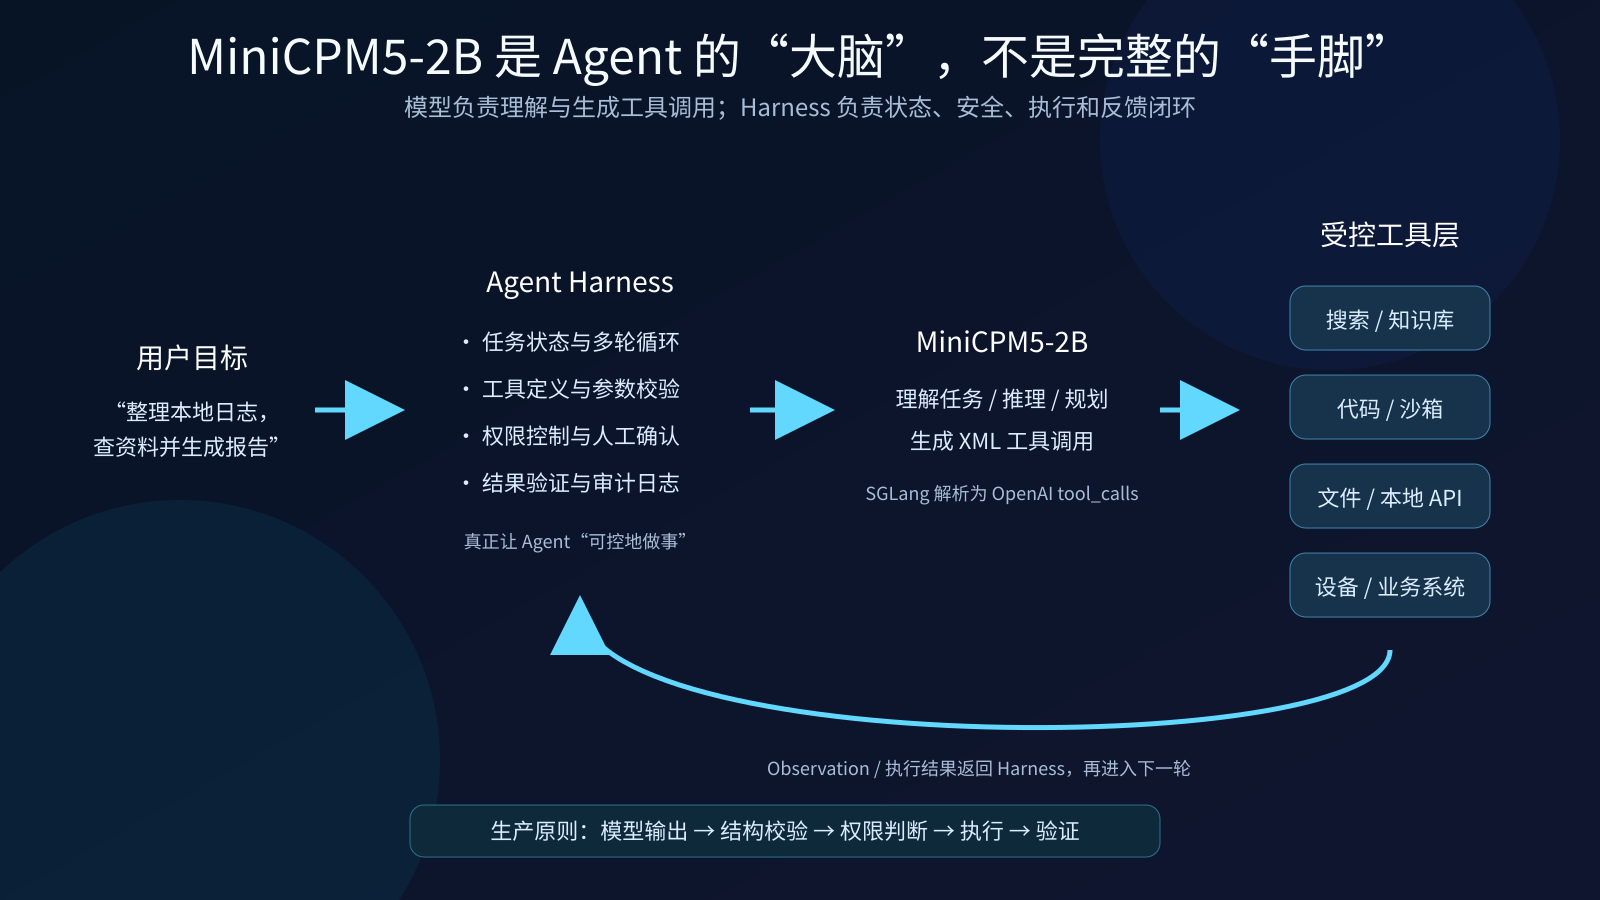
图1|MiniCPM5-2B 在 Agent Runtime 中的位置
MiniCPM5-2B 原生输出的是 XML 风格的工具调用。使用 SGLang 时,minicpm5 解析器可以把它转换成 OpenAI 兼容的 tool_calls。这解决的是“模型如何表达自己想调用哪个工具、传什么参数”。
但一个可用的 Agent 还至少需要:
- Harness:维护消息、任务状态、循环和重试;
- 工具注册表:明确模型能调用哪些搜索、代码、文件或业务 API;
- 参数校验:拒绝路径越界、危险 Shell、非法 SQL 等输入;
- 权限边界:读操作与写操作分开,高风险动作要求确认;
- Observation 回传:把工具真实结果送回模型继续推理;
- 成功判据:不能只看模型说“已完成”,还要验证文件、测试或接口状态。
因此,更准确的说法不是“MiniCPM5-2B 下载后就是通用 Agent”,而是:
它开始具备让轻量 Agent Runtime 在本地运行的模型基础,尤其适合工具调用、搜索规划和代码任务。
这次为什么值得看:开放的不只是最终权重
MiniCPM5-2B 使用标准 Llama 架构,主流推理框架不需要额外维护一套模型代码。官方同时给出了多个训练阶段的 Checkpoint:Base、Midtrain、SFT,以及经过 RL + OPD 的最终版。这对研究者很有价值,因为能力演进不再只剩一个最终黑盒。
更重要的是,官方同步开放了 UltraData 系列中的多类数据。
| 数据集 | 当前公开规模 | 主要用途 | 需要注意 |
|---|---|---|---|
| UltraX-Preview | 5 个英文语料子集,每个约 20B tokens | 用可执行编辑函数精炼网页预训练数据 | 当前页面名称包含 Preview,不应写成全部预训练语料完整复刻 |
| UltraData-Code | L2 约 400B tokens;L3 约 150B tokens;11 种语言 | 代码预训练与任务化合成 | 从约 1.92 亿公共 GitHub 仓库起步,需继续关注代码来源与许可证合规 |
| UltraData-SFT-Agent-2609 | 483,661 条 Agent 轨迹 | Tool Use、Search、Code、General Agent SFT | 统计口径是轨迹,不是 48 万个唯一任务 |
| UltraData-RL-2609 | 85,995 条样本 | 数学、知识、长文本、代码的可验证奖励 RL | Code 数据含测试用例,但不含安全执行沙箱 |
其中,Agent SFT 数据的构成很有代表性:General-Agent 311,006 条、Tool-Use 82,760 条、Code-Agent 69,895 条、Search-Agent 20,000 条。它保留的不只是“问题—答案”,还包括工具定义、调用、Observation、失败、重试和最终交付。
但这里也要把开放边界说清楚:官方明确提示,这些是静态轨迹,不包含原始环境、工具实现、测试基础设施和采样代码,很多虚拟 API 也不能在真实部署中直接使用。因此,它非常适合做数据研究、格式迁移和 SFT 配方实验,却不是下载后即可重放的 Agent 环境。
此外,有第三方文章提到 Meshy 强化学习框架。截止本文核验时间(2026 年 9 月 8 日),MiniCPM 官方主仓库与 Hugging Face Collection 中没有给出足以确认其独立开源状态的明确入口,因此本文不把它列入已核实的开放清单;后续应以 OpenBMB 官方链接为准。
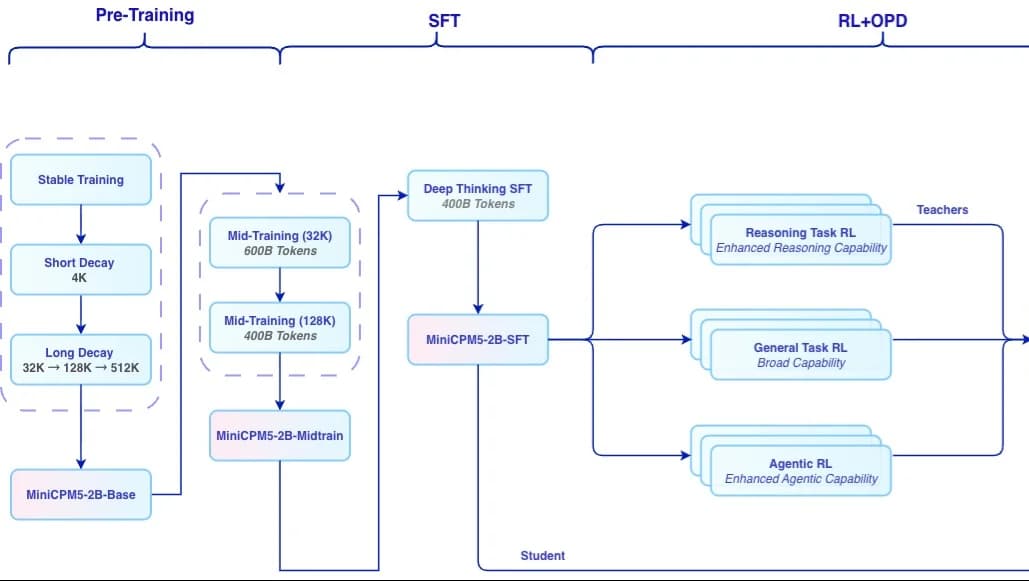
模型能力从哪里来:预训练、SFT、RL,再把专家蒸回一个模型
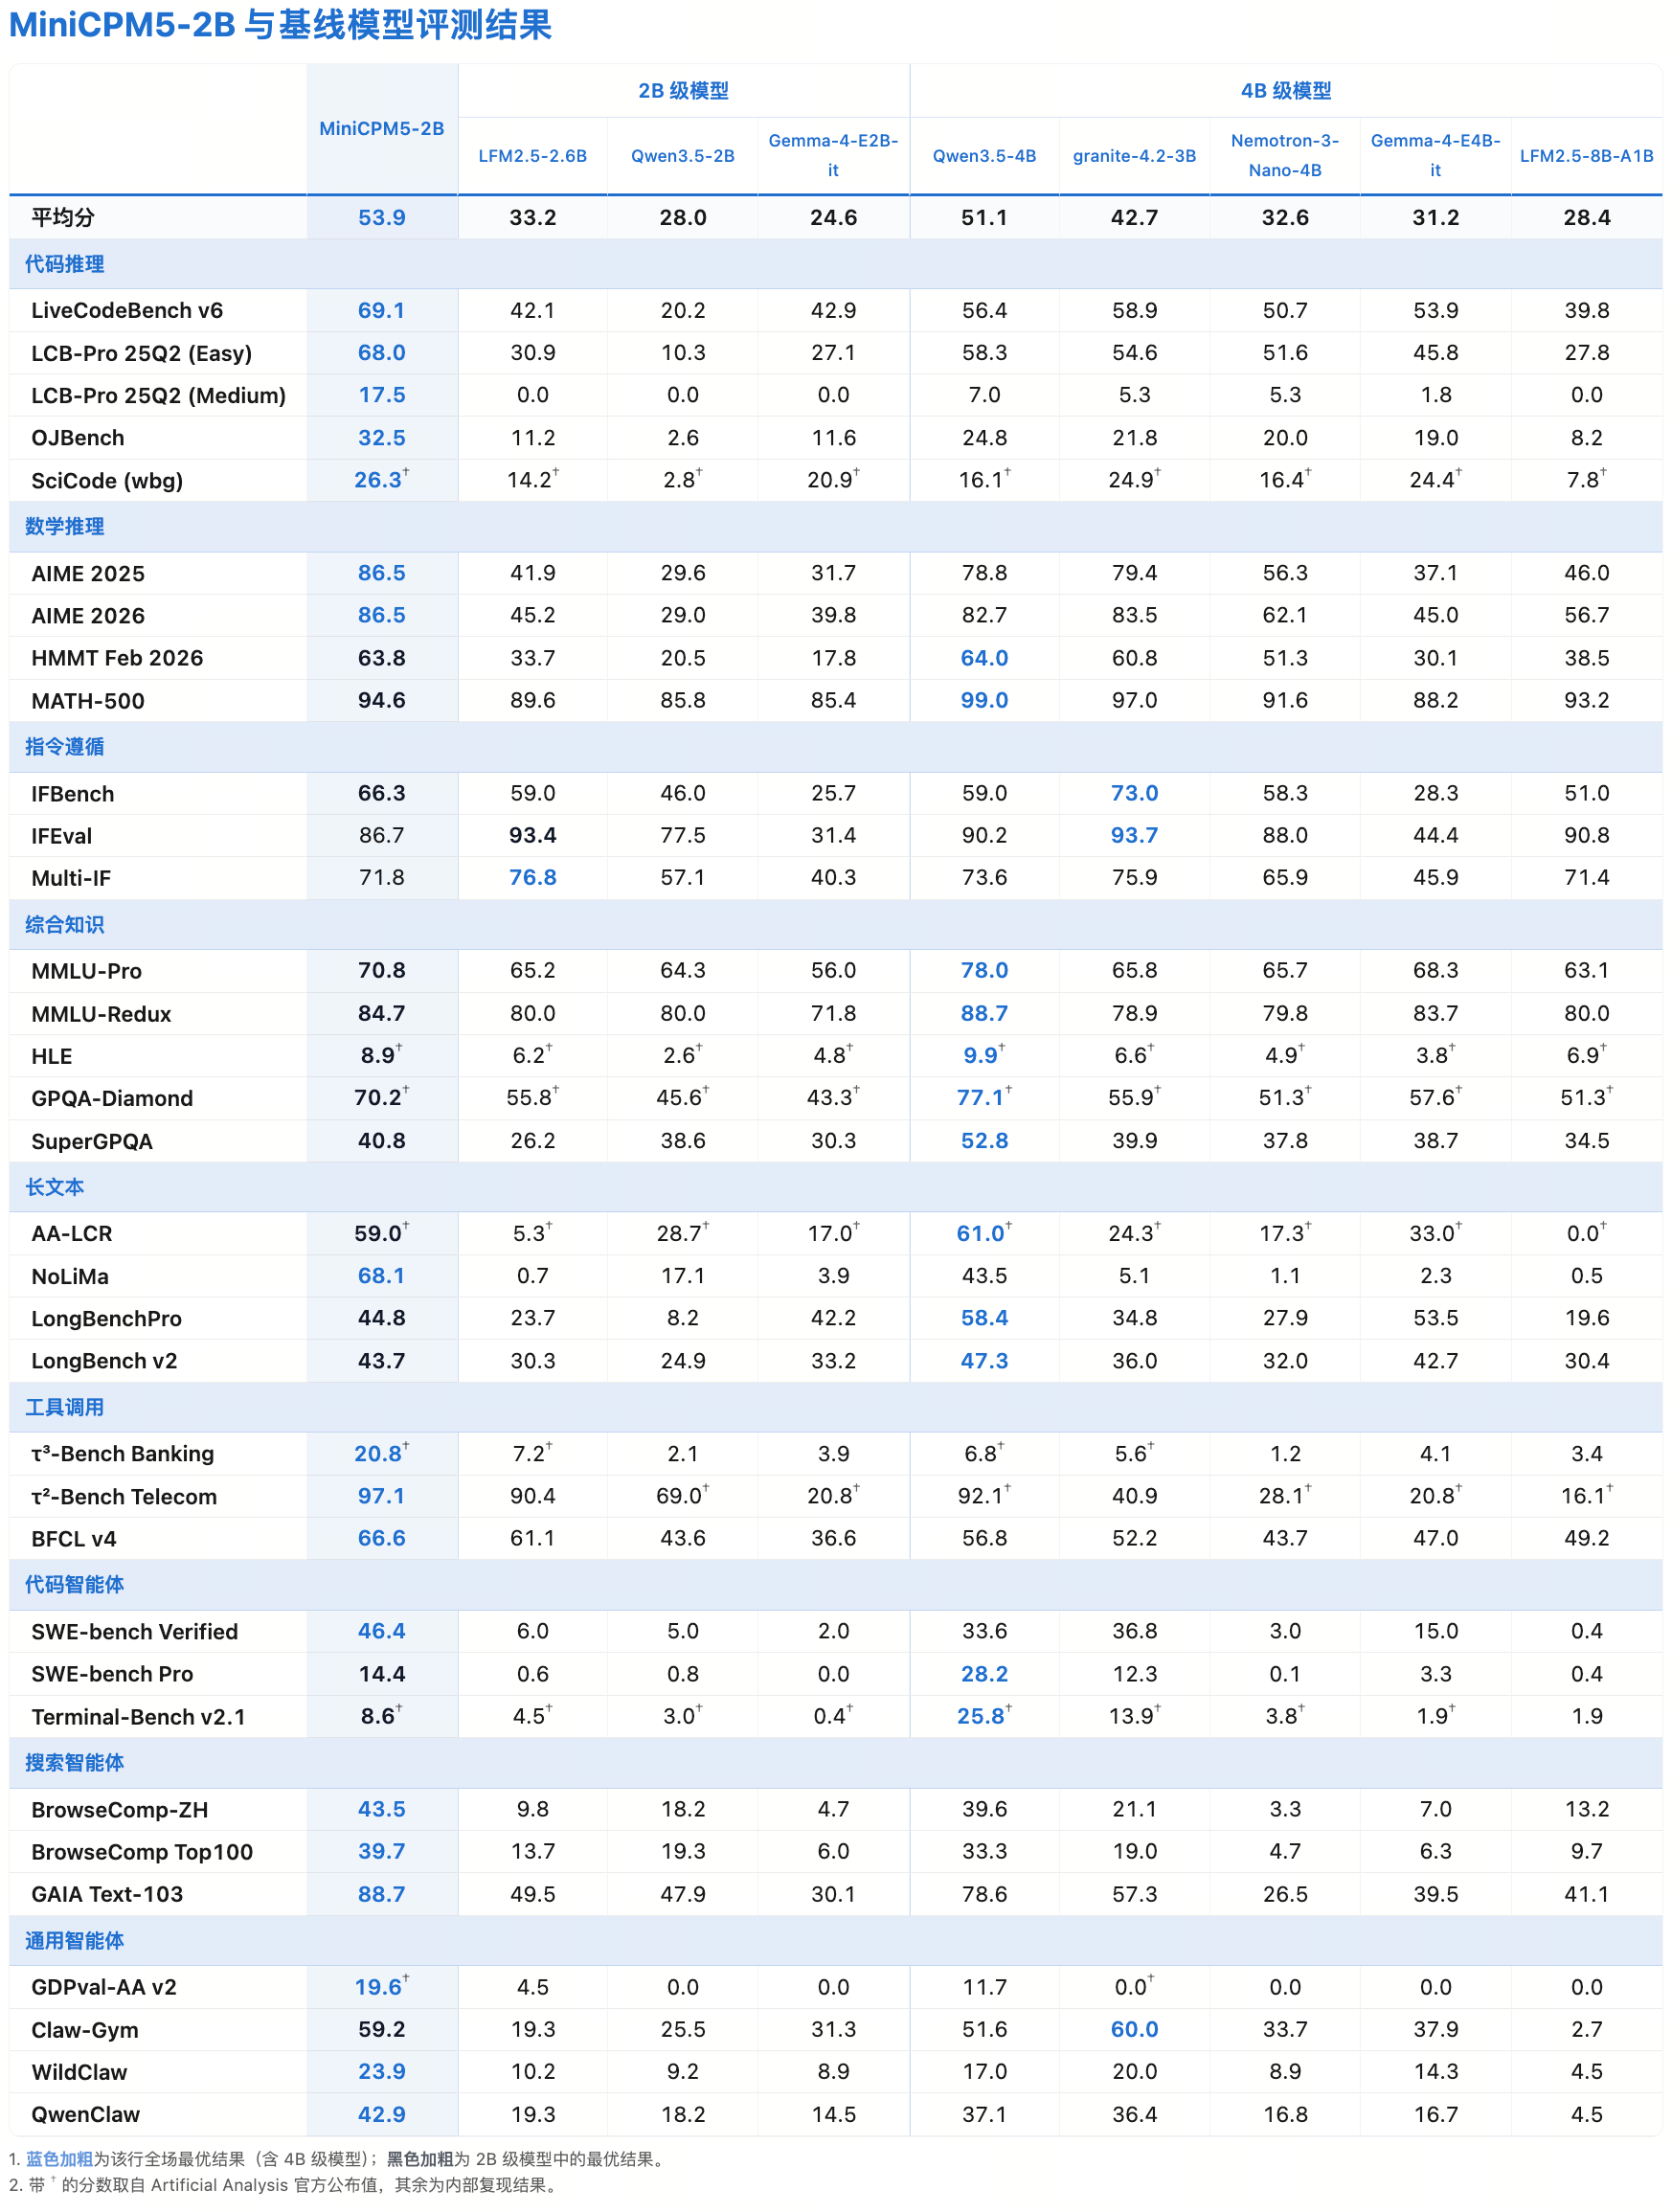
图2|MiniCPM5-2B 训练流程
官方给出的训练路线可以压缩成三段:
- Pre-Training:稳定训练和不同上下文长度的衰减训练,形成 Base 模型;
- Mid-Training + SFT:进一步适配目标数据分布,并使用官方所称 400B tokens 的 Deep-Thinking SFT;
- RL + OPD:分别训练推理、通用任务和 Agent 专家,再通过 On-Policy Distillation 把能力汇总到一个最终模型。
这里最关键的不是“又做了强化学习”,而是如何避免小模型在多个专项能力之间顾此失彼。
RL 阶段产生了 16 个专家模型,其中包括 5 个 Agent 专家。OPD 再用这些教师在当前策略分布上的输出监督学生,把数学、代码、搜索、工具调用和通用任务能力重新压回一个 2B 级模型。这样做的工程目标很明确:部署时只需要维护一个模型,而不是在设备里塞进一排专家并做路由。

图3|RL + OPD 相对 SFT Checkpoint 的分项增益
按照官方统计,RL + OPD 让推理与通用能力平均提升 10.96 分,Agent 能力平均提升 6.96 分。SWE-bench Verified 从 29.0 提升到 46.4,BFCL v4 从 55.4 提升到 66.59,GAIA Text-103 从 79.29 提升到 88.67。
这些数字更适合用来说明“后训练确实改变了模型能力”,不宜直接推导成“本地 Agent 已经达到生产可靠性”。真实项目还会受到工具定义、上下文组织、Harness、模型量化和任务分布影响。
Benchmark 怎么看:53.9 很亮眼,但比较口径必须保留
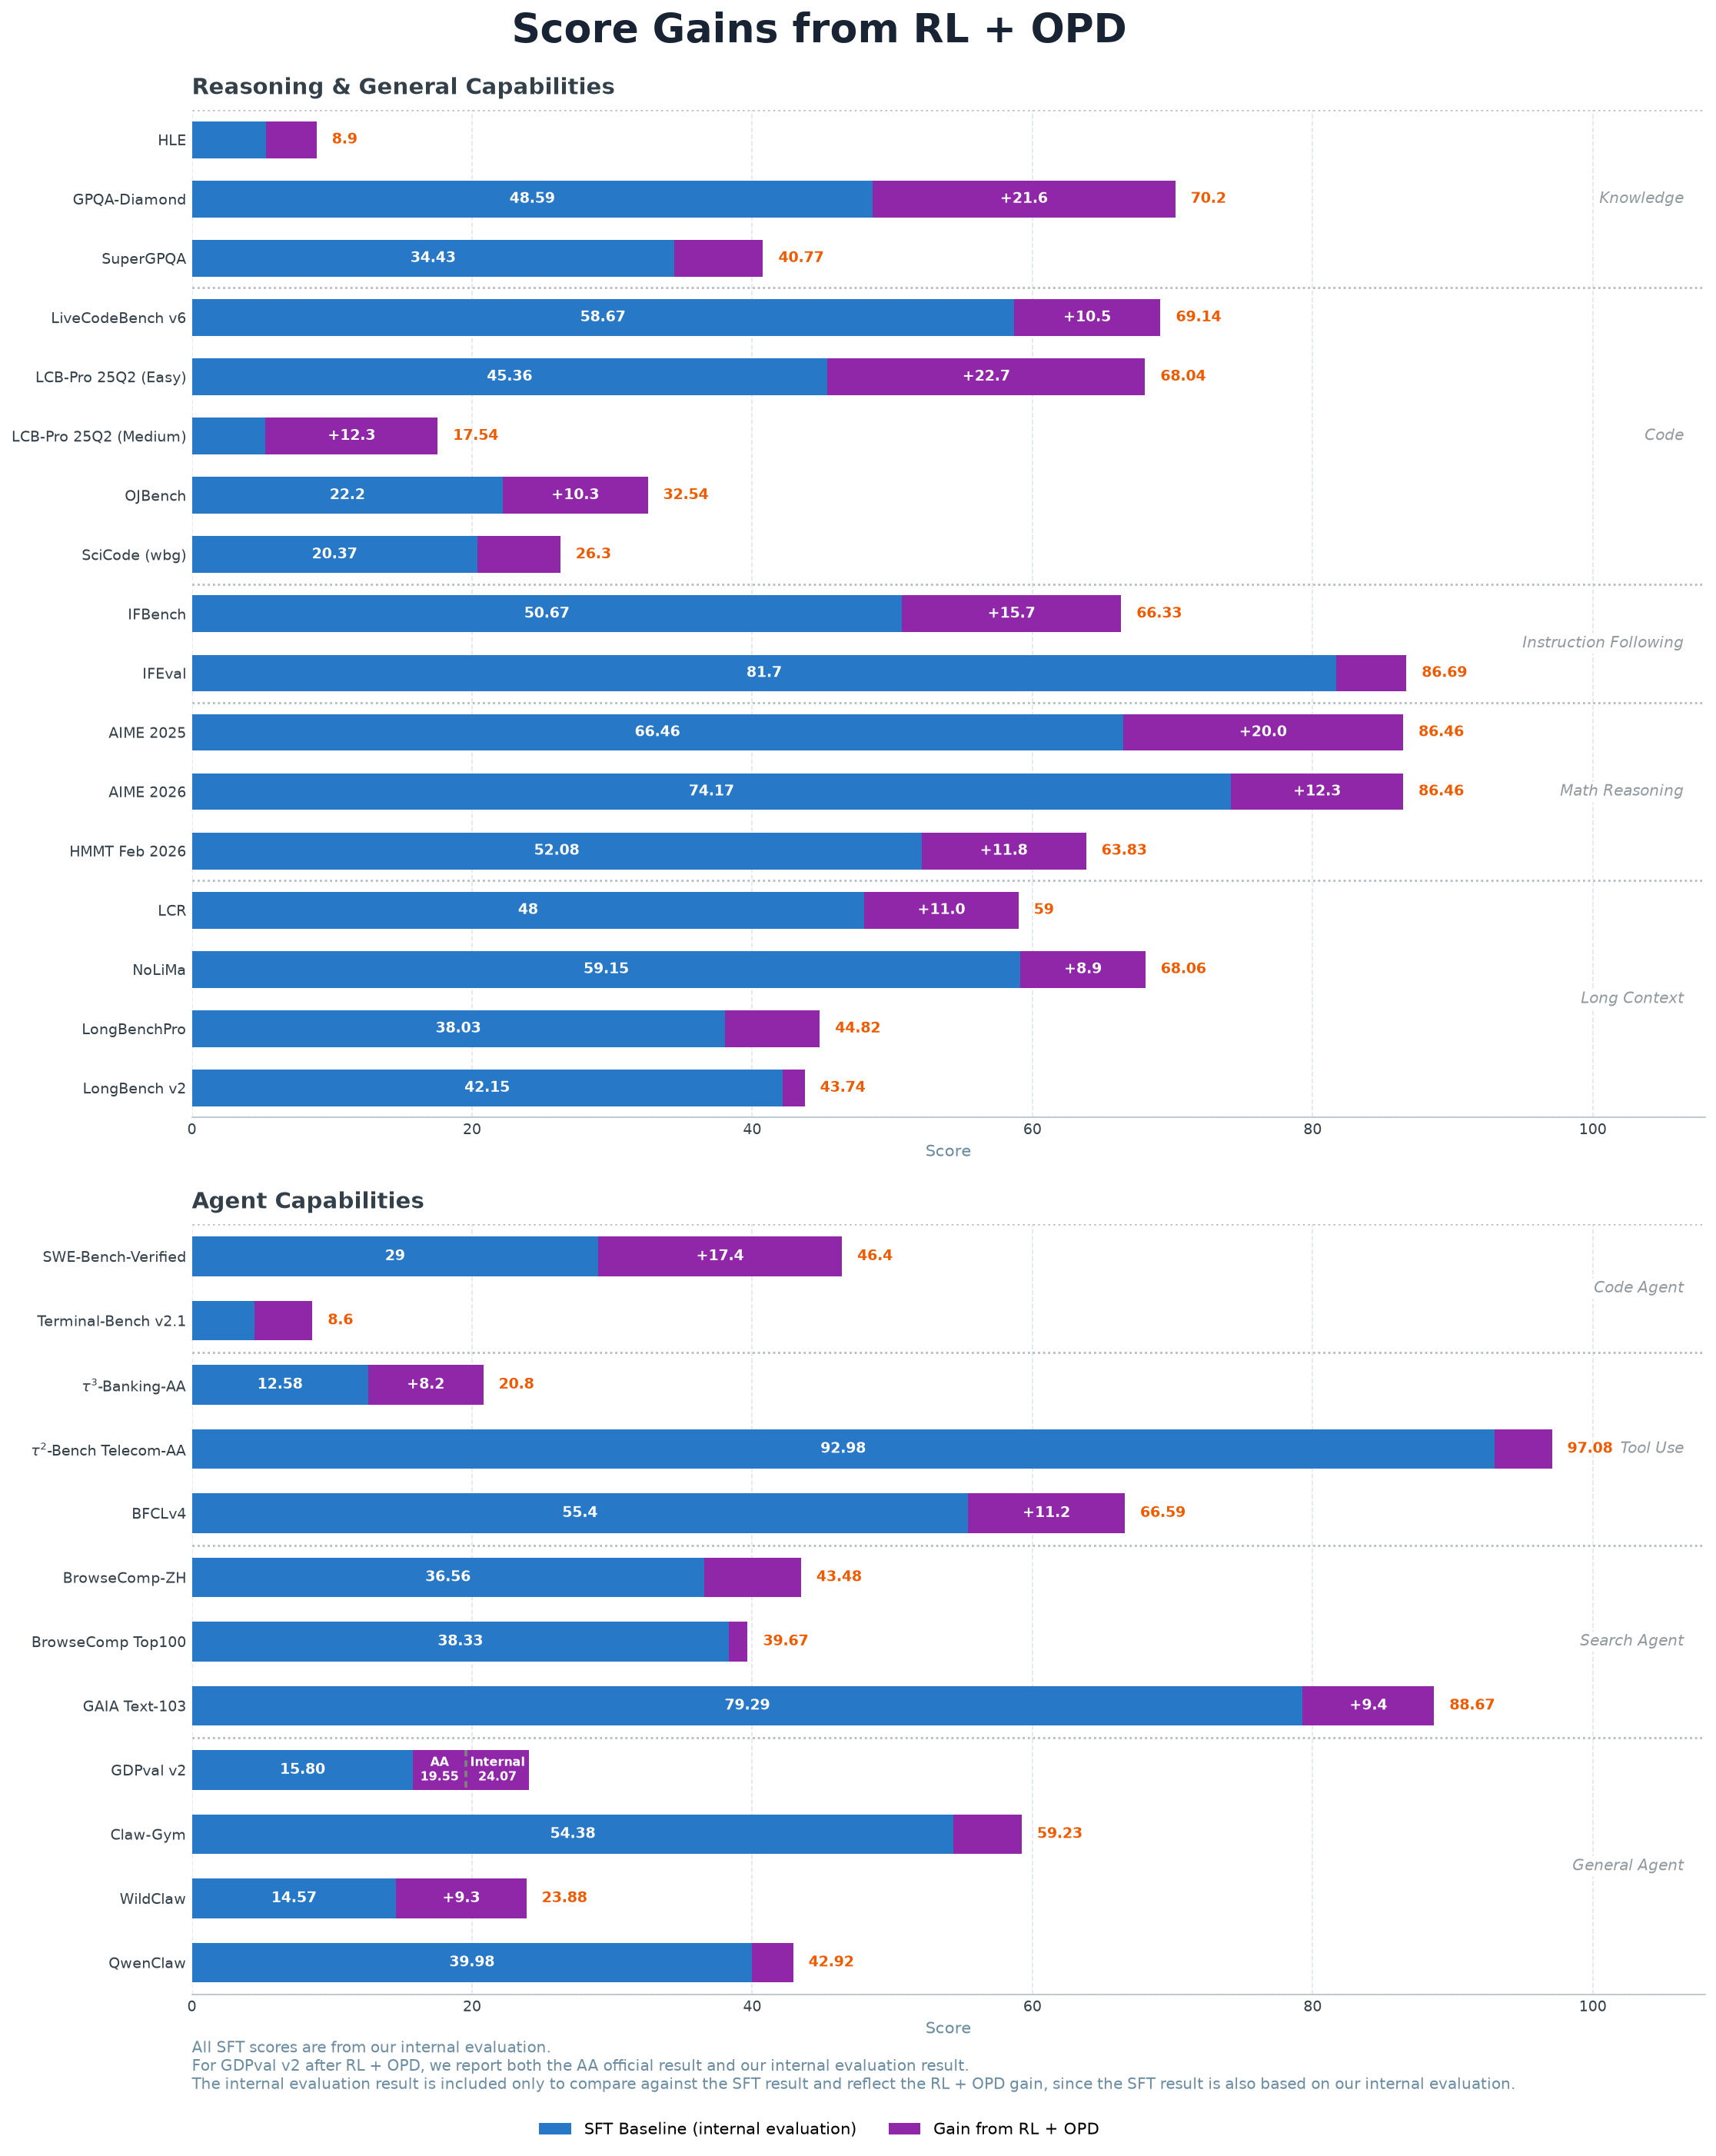
图4|MiniCPM5-2B 与 2B/4B 级基线的官方评测结果
在官方列出的比较集中,MiniCPM5-2B 平均分为 53.9。同表中的 2B 级模型 LFM2.5-2.6B、Qwen3.5-2B 和 Gemma-4-E2B-it 分别为 33.2、28.0 和 24.6;作为参考列出的 4B 级模型中,最高平均分为 Qwen3.5-4B 的 51.1。
分项上,MiniCPM5-2B 的强势区域非常集中:
- LiveCodeBench v6:69.1;
- AIME 2025 / 2026:均为 86.5;
- BFCL v4:66.6;
- SWE-bench Verified:46.4;
- BrowseComp-ZH:43.5;
- GAIA Text-103:88.7。
不过,官方表格已经注明:带 † 的数字来自 Artificial Analysis 官方发布,其余多数结果为团队内部复现。因此最严谨的表述应当是:
在 OpenBMB 给定的模型集合、任务组合和复现口径下,MiniCPM5-2B 获得了最高平均分,并在代码、数学、长文本和 Agent 相关任务上表现突出。
不要把它改写成“任何场景都全面超过所有 4B 模型”。平均分会受到任务选择和等权方式影响,真实部署还要重新测试量化版本、上下文长度、响应时延与工具调用成功率。
Quick Start:先用 1.56GB 的 GGUF 在本地跑起来
如果你的目标是先在普通笔记本、CPU 主机或小型边缘设备上验证,优先走 llama.cpp + Q4_K_M。官方提供的三个 GGUF 文件分别约为:F16 5.04GB、Q8_0 2.68GB、Q4_K_M 1.56GB。
1. 准备环境
macOS 可直接安装:
brew install llama.cpp
pip install -U huggingface_hub
Linux 若没有现成包,可按官方 Cookbook 从源码构建 CPU 版本:
git clone --depth=1 https://github.com/ggerganov/llama.cpp.git
cd llama.cpp
cmake -B build -DCMAKE_BUILD_TYPE=Release
cmake --build build --config Release -j "$(nproc)" --target llama-cli llama-server
2. 下载 Q4 模型
mkdir -p ~/minicpm5 && cd ~/minicpm5
huggingface-cli download openbmb/MiniCPM5-2B-GGUF \
  MiniCPM5-2B-Q4_K_M.gguf --local-dir .
3. 启动本地 OpenAI 兼容服务
macOS Homebrew 安装后通常可以直接调用 llama-server;源码构建版对应 llama.cpp/build/bin/llama-server。
llama-server \
  -m MiniCPM5-2B-Q4_K_M.gguf \
  --port 8080 \
  -c 8192 \
  --jinja
有兼容 GPU 时可追加 -ngl 99 尝试将全部层卸载到 GPU;纯 CPU 不必添加。
4. 发起测试请求
curl http://localhost:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "MiniCPM5-2B",
    "messages": [{"role":"user","content":"1+1等于多少?只回答数字。"}],
    "temperature": 1.0,
    "top_p": 0.95,
    "max_tokens": 64
  }'
正常情况下,你会收到带 choices 的 JSON,回复内容包含 2。这时只证明“模型服务可用”,还没有证明 Agent 工具链已接通。
为什么示例只开 8192 上下文,而不是一上来就 131072?因为 1.56GB 只是量化权重文件,运行时还需要 KV Cache、计算缓冲区、进程和操作系统内存。上下文越长,占用越大。官方 llama.cpp Cookbook 也建议没有真实长文本需求时先用 -c 8192。
把它接成一个真正的工具调用服务
如果目标是 Agent,官方推荐 SGLang,因为它能把 MiniCPM5-2B 的 XML 调用解析成 OpenAI 兼容的 tool_calls。
1. 启动 SGLang
pip install "sglang[srt]>=0.5.16"

python -m sglang.launch_server \
  --model-path openbmb/MiniCPM5-2B \
  --port 30000 \
  --tool-call-parser minicpm5
2. 给模型声明工具
curl http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openbmb/MiniCPM5-2B",
    "messages": [{"role":"user","content":"查询北京今天的天气"}],
    "tools": [{
      "type": "function",
      "function": {
        "name": "get_weather",
        "description": "查询指定城市的天气",
        "parameters": {
          "type": "object",
          "properties": {"city": {"type": "string"}},
          "required": ["city"]
        }
      }
    }],
    "tool_choice": "auto",
    "temperature": 1.0,
    "top_p": 0.95,
    "max_tokens": 256
  }'
正常结果不是模型凭空写一段天气,而是响应中出现类似 get_weather 与 {"city":"北京"} 的结构化 tool_calls。
接下来必须由你的程序完成四步:
读取 tool_calls
→ 校验工具名和参数
→ 调用真实天气 API
→ 把工具结果作为 tool message 回传模型
Demo 可以自动执行;生产环境不能把模型生成的 Shell、SQL、文件路径直接放行。建议从只读工具开始,用 JSON Schema 严格校验参数,并给删除、覆盖、转账、发送消息等动作增加人工确认。
UltraData 也能快速读取,但不要直接把全部数据倒进训练
安装 Hugging Face Datasets:
pip install -U datasets
读取 Agent SFT 的一个子集:
from datasets import load_dataset

ds = load_dataset(
    "openbmb/UltraData-SFT-Agent-2609",
    "Tool-Use",
    split="train",
)

sample = ds[0]
print(sample["domain"])
print(sample["tools"][:1])
print(sample["messages"][:3])
可用配置包括 Code-Agent、Search-Agent、General-Agent 和 Tool-Use。RL 数据则可按 Math、Knowledge、Long-Context、Code 分别加载。
真正做微调前,建议先完成三件事:
- 把样本中的
tools正确渲染进目标模型的 Chat Template; - 按你的真实工具集合过滤虚拟 API 和不兼容轨迹;
- 重新做隐私、许可证、危险操作和 Benchmark 污染检查。
尤其是 Code RL 数据,候选程序必须放进隔离沙箱执行。官方只提供测试输入输出,不提供替你承担安全风险的执行环境。
该选哪种部署方式
| 场景 | 推荐路径 | 理由 |
|---|---|---|
| 普通 Windows/Linux 笔记本 | GGUF + llama.cpp / LM Studio | Q4 文件小,跨平台,验证成本最低 |
| Apple Silicon | MLX 4-bit | 官方提供预转换模型,适合统一内存架构 |
| 单机 CUDA GPU 做 API | vLLM | OpenAI 兼容服务与并发更方便 |
| 本地工具调用 Agent | SGLang | 官方推荐,内置 minicpm5 Tool Parser |
| CPU/ARM 边缘盒子 | GGUF + llama.cpp / ArcLight | 不依赖 Python,可按上下文和线程数逐步压缩 |
| 昇腾环境 | vLLM Ascend / FlagOS 路线 | 官方已有接入说明,但仍需按具体芯片验证 |
| 研究与快速改模型 | Transformers + TRL/PEFT | 代码路径直观,适合 SFT/LoRA |
“支持端侧”不等于“任何手机都能满血跑 128K”。官方移动应用仓库对 MiniCPM5-2B Q4 给出的设备内存建议为 至少 6GB RAM,但这仍取决于上下文、运行时和系统占用。部署到具体 Android、iOS、ARM SBC 或国产芯片前,必须按目标硬件做真实验证。
常见坑与容易误解的地方
1. 它不是多模态模型
MiniCPM5-2B 只处理文本。照片、PDF 页面、屏幕截图和摄像头输入需要先经过 OCR、文档解析或视觉模型。
2. 1.56GB 不等于只需 1.56GB 内存
模型文件之外还有 KV Cache、临时张量和应用进程。长上下文尤其吃内存,先以 8K 验证,再逐步提高。
3. 128K 是上限,不是默认必须开满
如果你的 Agent 每轮都把全部历史、网页正文和日志塞回去,速度与稳定性很快会恶化。生产上应做摘要、检索、上下文裁剪和工具结果压缩。
4. Tool Calling 不等于工具执行正确
模型可能选错工具、填错参数,甚至被网页中的 Prompt Injection 诱导。工具层必须有白名单、Schema、权限、超时、幂等和审计。
5. BF16 Benchmark 不能直接代表 Q4 体验
官方主榜对应最终模型的标准评测,不能默认等价于你的 GGUF Q4、不同推理框架或不同上下文设置。量化后至少重测你的核心任务集。
6. Agent 数据不等于可重放环境
UltraData-SFT-Agent 提供轨迹和工具描述,但没有完整环境与工具后端。使用前需要映射到自己的 Harness。
7. 依赖版本要钉住
MiniCPM README 当前要求 Transformers >=5.6、vLLM >=0.21、SGLang >=0.5.16。验证通过后应锁定版本和模型 revision,不要让生产环境长期追随 main 自动变化。
它适合什么,不适合什么
适合
- 在笔记本、边缘盒子和内网服务器上做本地文本助手;
- 做代码检索、日志分析、知识库问答等“模型 + 少量只读工具”任务;
- 对数据不出域、离线可用和低部署成本有要求的场景;
- 研究小模型的 Agent SFT、RLVR、OPD 与量化部署;
- 用一个轻量模型承担高频简单任务,把困难任务再路由给云端大模型。
不适合
- 直接替代顶级云端模型处理高风险、开放域、超长链复杂任务;
- 不做权限和校验,就让模型控制生产服务器、数据库或资金系统;
- 需要原生看图、听音频或理解视频的应用;
- 仅凭官方平均分就要求 Q4 版本在所有业务上稳定超过 4B 模型;
- 内存非常紧张,却必须长期开满 128K 上下文的设备。
如果是我,我会这样把它用起来
第一阶段,只做 GGUF Q4 + 8K 上下文 + 本地对话 API,确认目标设备的首 Token 时延、生成速度、峰值内存和中文输出质量。
第二阶段,接入一个只读工具,例如本地文档检索或日志查询。记录工具选择准确率、参数正确率、任务完成率,而不只是看模型回答是否“像对的”。
第三阶段,再切到 SGLang Agent 服务,加入 Schema 校验、工具白名单、超时、重试、最大循环次数和审计日志。任何写操作默认需要确认。
第四阶段,收集真实失败样本,先优化 Prompt、工具描述、上下文和任务拆分。只有当错误稳定来自模型领域知识或行为模式时,再考虑 LoRA/SFT;不要因为官方开放了 48 万条 Agent 轨迹,就在第一天把全部数据混进训练。
最后再决定是否加入更激进的优化:GPTQ、MLX、DSpark 投机解码、目标芯片迁移,或者“小模型本地优先、难任务云端回退”的分层架构。
总结
MiniCPM5-2B 的意义,不只是“2B 模型又刷了一张更高的表”。更重要的是,它把小模型的能力边界从聊天与推理推向了工具调用、代码、搜索和通用 Agent,同时公开了多个训练阶段、UltraData 数据和多条部署路径。
它离“在任何设备上可靠完成所有任务”当然还有距离。2B 级模型的规划稳定性、长链错误累积、量化损失和安全边界都必须在真实系统中重新验证。
但如果你的目标是做一个本地、私有、低成本、可控的轻量 Agent,MiniCPM5-2B 已经不是只能围观的模型:你可以用 1.56GB 的 Q4 文件先跑通,也可以用 SGLang 把工具调用接进现有 OpenAI API 生态;如果还想研究它为什么学会这些能力,训练数据和中间 Checkpoint 也已经摆在桌面上。
这才是这次开源真正有分量的地方。