
从肌肉信号到机器人动作:sEMG 能为具身智能带来什么?
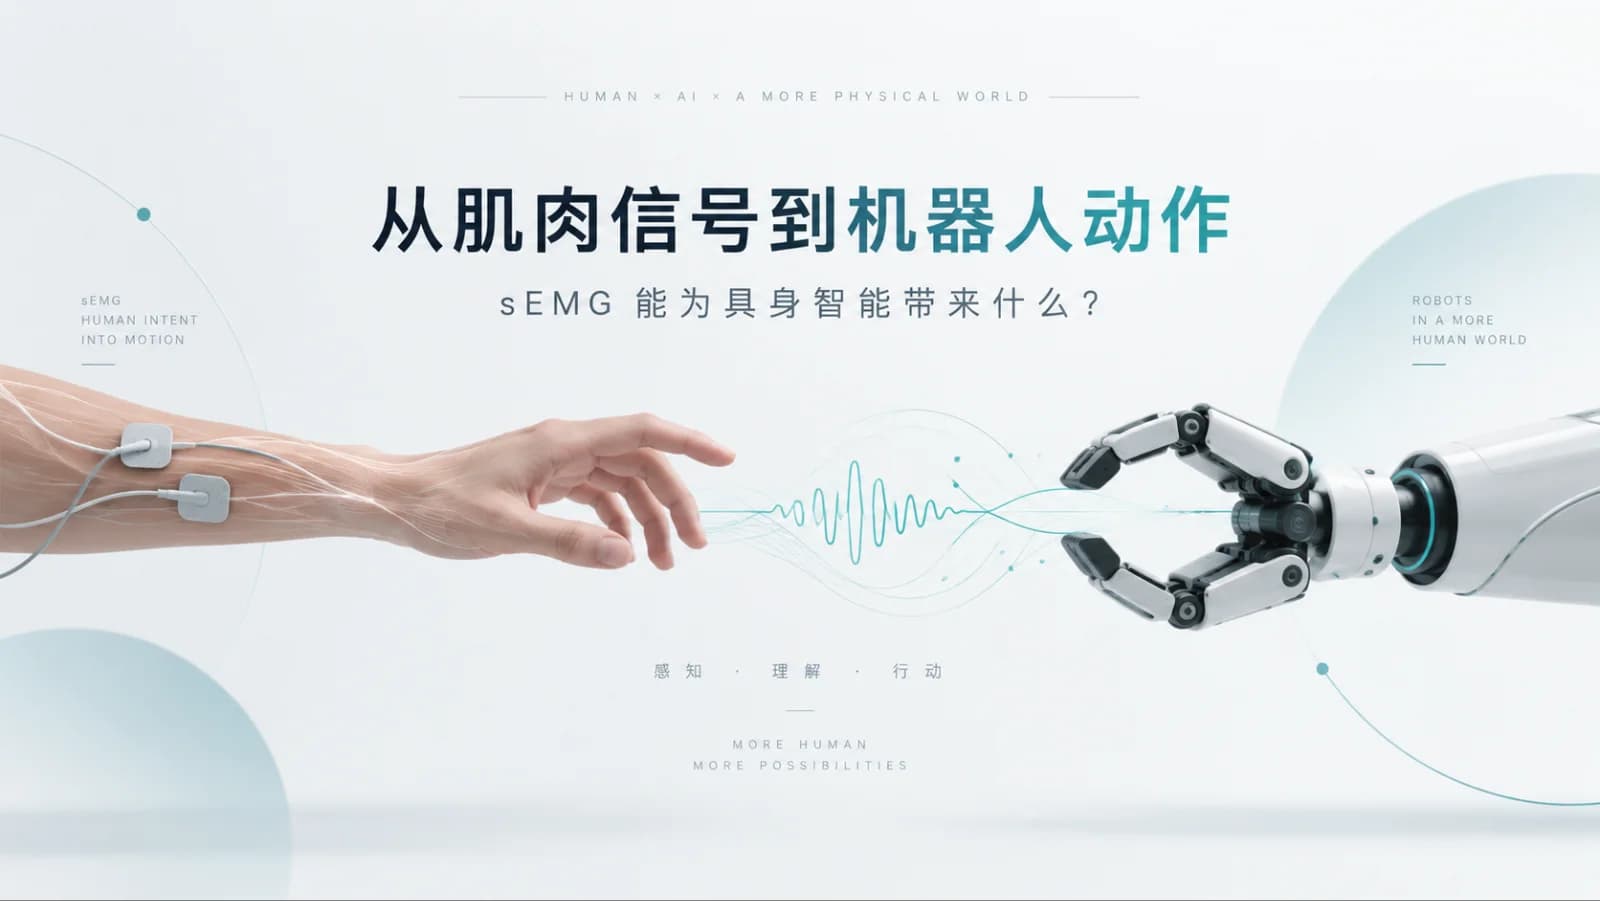
今天的机器人已经拥有越来越丰富的“感官”。
摄像头让机器人看到周围环境,深度相机和 LiDAR 帮助机器人理解空间结构,IMU 可以估计自身姿态,力传感器与触觉传感器则让机器人知道自己是否接触到了物体、用了多大的力。
然而,当机器人真正开始走进人的生活,并且需要与人协作时,仅仅“看懂环境”还不够。
机器人还需要回答另一个更加困难的问题:
人想做什么?
例如,一个人准备拿起桌上的水杯。对于摄像头来说,通常需要等到手臂已经开始移动以后,系统才能从视觉变化中推测这个人正在伸手。但从人体自身的控制过程来看,在明显动作真正出现之前,神经系统已经开始向相关肌肉发送控制信号,肌肉也已经进入激活状态。
如果我们能够捕捉这些信号,那么机器或许不必一直等到“动作已经发生”,才开始理解人的意图。
这就是表面肌电信号——surface electromyography,sEMG——开始与机器人、义肢以及具身智能产生联系的地方。
从“肌肉在发力”到“机器知道你想做什么”
人体的运动并不是一个单纯的机械过程。
当我们准备握拳、抬起手臂或者迈出一步时,大脑和神经系统首先产生运动指令,这些指令沿着神经传递到肌肉,最终导致肌肉收缩,并产生我们能够观察到的运动。
肌肉激活过程中会伴随电活动。
sEMG 所做的事情,就是利用放置在皮肤表面的电极,以非侵入式的方法采集这些肌肉活动产生的电信号。
它并不是在“读取思想”,也不是像脑机接口那样直接从大脑获取信息。它实际上位于人体运动控制链条中一个非常有意思的位置:
神经系统 → 肌肉激活 → 身体运动
sEMG 捕捉的是中间的“肌肉激活”阶段。
从生理学角度看,表面肌电信号主要来自多个运动单位动作电位在电极检测范围内的叠加。因此,信号的幅值、频率以及多个肌肉通道之间的变化,都可能包含与肌肉收缩和动作有关的信息。现有研究已经广泛利用这些信息进行动作识别、运动意图检测、力度估计以及义肢控制。
于是,一个很自然的控制链就出现了:
Human → sEMG → Signal Processing → AI → Robot
比如,当使用者尝试握拳时,前臂几组肌肉会出现特定的激活模式。系统采集这些信号以后,可以通过机器学习模型判断:
“使用者现在想要握住某个东西。”
然后,机器人手或者电子义肢执行抓握。
这可能是 sEMG 最容易理解的一种应用。
但如果仅仅停留在“识别几个手势”,sEMG 与今天所说的“具身智能”之间,其实还有相当长的一段距离。
具身智能并不只是“机器人上运行一个 AI”
讨论这个问题之前,需要先明确一个容易被混淆的概念。
具身智能并不单纯意味着:
把一个更大的 AI 模型安装到机器人里面。
真正重要的是“身体”和“环境”参与了智能形成的过程。
一个具身智能系统需要不断经历这样的循环:
感知环境 → 理解当前状态 → 做出动作 → 与环境发生交互 → 获得新的感知 → 调整下一步动作
机器人抓一个杯子就是非常典型的例子。
摄像头首先确定杯子的位置;机械臂向目标移动;手指开始接触杯子;触觉或者力传感器检测接触状态;如果杯子开始滑动,就增加握力;如果抓偏了,就重新调整手指位置。
智能并不是只发生在第一次“看见杯子”的瞬间。
它存在于整个连续的 Perception–Action Loop,也就是感知—动作闭环 中。
而当“人”加入这个系统以后,问题就变得更加复杂。
机器人不仅需要理解环境,还需要理解与自己协作的人。
这时,sEMG 提供了一种传统机器人传感器并不擅长获取的信息:
人的运动意图。
从 Environment-aware 到 Human-aware
传统机器人主要感知的是外部世界。
Camera 告诉机器人:
前面有什么?
Depth Camera 和 LiDAR 告诉机器人:
这些东西在哪里?
Force Sensor 和 Tactile Sensor 告诉机器人:
我碰到了什么?
IMU 和 Joint Encoder 告诉机器人:
我的身体现在是什么状态?
而 sEMG 尝试回答的是另一个问题:
和我协作的人,现在准备做什么?
因此,与其说 sEMG 是另一种普通传感器,不如说它给机器人增加了一条来自人体内部的感知通道。
机器人由此可能从单纯的:
Environment-aware
逐渐走向:
Environment-aware + Human-aware
这也是 sEMG 对具身智能最值得关注的影响之一。
不过,这种影响存在不同层次。
最简单的一层是离散动作识别。
比如把四种肌电模式分别映射为:
握拳、张手、手腕内旋、手腕外旋。
模型只需要完成一个分类问题:
Class A / B / C / D
这已经能够控制一些设备,但本质上仍然类似于“肌肉版按钮”。
更加自然的控制方式,是从离散分类走向连续控制。
系统不仅判断:
“他想握拳。”
还希望知道:
“他想握多紧?”
“手腕希望转动多少?”
“什么时候应该开始?”
“什么时候应该停止?”
“现在是在主动发力,还是已经疲劳?”
此时问题逐渐从 Classification 变成 Regression、State Estimation 以及 Continuous Control。
对于多自由度义肢来说,这一点尤其重要。
真正的人手并不是几个固定动作之间的切换,而是多个关节同时、连续地变化。一个自然的义肢控制系统,也不应该要求使用者每次先“选择模式”,再执行动作。
理想状态应该更接近:
人产生运动意图,义肢像身体的一部分一样自然响应。
义肢:sEMG 与具身智能最直观的交汇点
如果要找一个能够同时体现 sEMG、机器人控制和具身智能的场景,电子义肢可能是最典型的案例之一。
对于部分截肢者来说,虽然手或者前臂的一部分已经不存在,但残余肌肉以及相应的神经控制通路仍然可能保留下来。
当使用者尝试做某个动作时,这些肌肉依然可能产生相应的肌电活动。
于是可以构建这样一个系统:
残余肌肉 → sEMG → 意图解码 → 义肢控制器 → 电机 → 假手动作
这也是所谓 Myoelectric Prosthesis,肌电义肢 的基本思想。
sEMG 在义肢领域已经存在很长时间,但真正困难的问题并不是让假手“动起来”,而是让控制变得足够自然、稳定和可靠。
传统肌电控制通常只能提供数量有限的动作或者自由度。研究领域则长期在探索模式识别、同时多自由度控制、比例控制以及更加复杂的神经信息提取方法。系统综述也指出,实验室中的先进方法与日常实际应用之间仍然存在明显距离,尤其是鲁棒性和真实使用价值的问题。
而从具身智能角度来看,真正有意思的方向并不是:
“让 AI 把 EMG 分类得更准。”
而是让整个义肢进入一个持续交互的闭环。
例如:
使用者产生抓握意图;
↓
sEMG 识别运动意图;
↓
义肢开始闭合;
↓
指尖触觉传感器发现已经接触杯子;
↓
力传感器判断当前抓力;
↓
控制器调整电机输出;
↓
使用者看到杯子已经稳定抓起;
↓
肌肉活动发生变化;
↓
系统继续调整动作。
此时,sEMG 不再是系统中孤立的一路输入。
它成为了 Human–Robot–Environment Loop 的一部分。
从义肢到外骨骼:机器人开始理解“人在用多少力”
类似的思想也可以扩展到康复机器人和外骨骼。
传统外骨骼可以按照预设轨迹带着使用者运动。
例如让髋关节和膝关节按照提前计算好的曲线完成一次迈步。
这种系统解决的是:
“机器人应该怎样运动?”
但在康复过程中,还有另一个非常重要的问题:
“人在这个过程中主动参与了多少?”
假设两名使用者都完成了同样的抬腿动作。
第一个人可能正在主动尝试抬腿,机器人只需要提供少量辅助;
第二个人可能几乎没有主动输出,主要依靠外骨骼带动。
单看最后的关节轨迹,两种情况可能非常相似。
肌电信息却有机会帮助系统区分其中的差别。
因此,未来更加智能的外骨骼并不一定只是机械地执行轨迹,而可能根据人的运动意图、肌肉激活程度以及身体状态动态调整辅助程度。
近年来针对康复外骨骼的研究,也越来越强调从固定轨迹跟踪走向 assist-as-needed、个体化轨迹以及人—机器人—环境闭环,同时将运动意图识别和多模态感知作为重要组成部分。
机器人因此不再只是:
“我带着你走。”
而逐渐变成:
“我知道你正在尝试走,所以我只补上你目前完成不了的部分。”
这实际上已经非常接近具身智能在人机协作中的核心思想。
但 sEMG 远没有实验室结果看起来那么简单
如果只看一些实验结果,sEMG 很容易给人一种感觉:
训练一个分类器,做到很高准确率,然后就可以控制机器人。
现实情况复杂得多。
首先是个体差异。
不同人的肌肉结构、脂肪厚度、皮肤状态以及运动习惯不同,同样一个动作产生的信号分布可能存在明显差别。
其次是电极位置变化。
今天腕带戴在这个位置,明天稍微旋转一些;甚至只是电极相对于肌肉移动几毫米,都可能导致输入数据分布发生改变。
除此之外,还有汗液、皮肤阻抗、肌肉疲劳、运动伪影以及设备移动等问题。
所以:
实验室中很高的离线分类准确率,并不自动意味着现实世界中拥有同样可靠的控制性能。
这一问题在义肢研究中尤其明显。针对下肢肌电义肢控制的系统综述就指出,EMG 信号质量与稳定性、电极位置、义肢硬件以及算法鲁棒性仍然是阻碍实际应用的重要问题。
这也是为什么 sEMG 很难单独承担整个具身系统的感知任务。
因为肌肉信号可以告诉机器人:
“人正在发力。”
却无法直接告诉机器人:
“前方有一个台阶。”
它可能告诉机器人:
“使用者准备抓握。”
但不会直接告诉机器人:
“这个杯子距离手还有 15 cm。”
所以 sEMG 并不是 Camera、IMU、Force Sensor 或 Tactile Sensor 的替代品。
更有可能的发展方向恰恰是:
多模态融合。
真正值得期待的,也许是“多模态人体—机器人共同体”
未来一个更加完整的具身智能系统,可能同时拥有三类感知。
第一类来自外部世界:
Camera、Depth、LiDAR。
它们帮助机器人理解:
世界是什么样的。
第二类来自机器人自己的身体:
Joint Encoder、IMU、Force、Tactile。
它们告诉机器人:
我的身体现在发生了什么。
第三类则来自人本身:
sEMG,甚至未来结合 EEG、眼动、动作捕捉和其他生理信号。
它们尝试告诉机器人:
人现在想做什么。
于是一个更加完整的具身系统就可能形成:
Human Intention
↓
sEMG / Motion / Vision
↓
Multimodal Perception
↓
AI / Policy / Controller
↓
Robot Body
↓
Environment
↓
Vision / Force / Tactile Feedback
↓
重新进入下一轮决策。
在这样的系统里,sEMG 的意义就已经远远超过了“肌电手势识别”。
它开始成为连接人的身体与机器人的身体的一座桥梁。
视觉告诉机器人:
世界是什么样。
触觉告诉机器人:
我碰到了什么。
而 sEMG 尝试告诉机器人:
人想做什么。
写在最后
今天谈具身智能时,我们经常讨论机器人应该如何看见世界、理解世界,然后在世界中行动。
但当机器人最终进入家庭、医院、康复中心和真实工作环境以后,它面对的不只是桌子、杯子、楼梯和工具。
它还需要面对人。
人与机器人之间真正自然的协作,也许并不只是让人学会怎样使用机器人,而是让机器人逐渐理解人的身体。
sEMG 提供的正是这样一种可能。
它并不是完美的“意图读取器”,也远远没有解决信号漂移、个体差异、长期稳定性和真实环境鲁棒性的问题。但它让我们看到了一种新的交互方式:
人不再一定需要通过按钮、键盘或者手柄明确地告诉机器下一步做什么。
有一天,机器也许能够从身体本身产生的信号中,理解我们正在尝试做出的动作,并结合视觉、触觉和环境信息决定如何协助。
从这个角度看,sEMG 对具身智能真正重要的地方,也许不是让机器人多了一种传感器。
而是让具身智能第一次有机会同时理解两个“身体”:
机器自己的身体,以及与它共同完成任务的人的身体。