
一张图,实时生成一个“玩不完”的世界:LingBot-World 2.0 全量开源
如果一个视频模型只能根据提示词生成十几秒画面,它更像一台“镜头制造机”。
但如果你按下 W,它会继续向前生成世界;你挥剑、开门、射箭,画面会接着变化;你再输入“开始下雪”,原来的世界又会沿着新的事件继续演化——这时它更接近一个可以被实时操控的世界模拟器。
这正是蚂蚁集团旗下灵波科技(Robbyant)发布的 LingBot-World 2.0 想做的事。项目也被称为 LingBot-World-Infinity:从一张初始图像出发,模型持续接收相机动作和文本事件,按时间顺序一段一段生成后续画面。
截至 2026 年 9 月 10 日,官方仓库已将 TODO 中的四种模型全部标记为发布完成,包括 14B 的 causal-fast、causal-pretrain、bidirectional 版本,以及 1.3B causal-fast 版本。代码、模型和技术报告均已公开。
不过,先把一个很容易被宣传视频掩盖的事实说在前面:
“完整系统达到 720p、60 fps”不等于下载 GitHub 仓库后就能用一张消费级显卡复现。
官方公开代码的参考命令目前是 480×832,14B 版本使用 8 张 GPU;1.3B 的 README 示例使用 4 张 GPU。论文中的 720p、60 fps 来自包含多 GPU 并行、编译优化、TensorRT 时空增强和流式传输的完整部署系统,而官方明确表示这套部署代码不会开源。
这并不削弱 LingBot-World 2.0 的研究价值,反而让它的定位更清楚:它目前首先是一套值得研究者拆解的开放世界模型,而不是已经封装好的本地游戏引擎。
先看结论:它到底开源了什么?
| 项目 | 当前官方信息 |
|---|---|
| 模型定位 | 可交互的因果视频世界模型 |
| 输入 | 初始图像、历史视频上下文、相机位姿、分块文本提示 |
| 输出 | 根据动作持续生成的后续视频帧 |
| 主模型 | 14B causal-fast / causal-pretrain / bidirectional |
| 轻量模型 | 1.3B causal-fast |
| 开源推理分辨率 | 官方示例为 480×832 |
| 完整系统展示能力 | 官方报告为 720p、60 fps、亚秒级控制响应 |
| 长时稳定性证据 | 一次连续 60 分钟、20 个场景的定性压力测试 |
| 训练目标 | 条件 Flow Matching |
| 实时化方法 | 一致性蒸馏 + Distribution Matching Distillation |
| 交互方式 | 相机移动、角色动作、物体交互、文本事件注入 |
| 代码基础 | Wan2.2 |
| License | CC BY-NC-SA 4.0,仅限非商业用途 |
模型页报告的存储体积也值得提前看:1.3B causal-fast 的 DiT 权重约 6.84 GB;14B causal-fast 仓库约 86.1 GB,其中包含共享的 T5、VAE 与 tokenizer;14B causal-pretrain 约 74.2 GB;14B bidirectional 约 148.4 GB。这些是下载体积,不是运行时显存,但足以说明本地复现前要先留好磁盘空间。
它不是“无限长视频”,而是一个持续闭环
普通图生视频通常是:
一张图 + 一段提示词
        ↓
一次性生成固定长度视频
        ↓
结束
LingBot-World 2.0 的逻辑则是:
当前世界状态 + 历史上下文 + 当前动作
                ↓
          生成下一段视频
                ↓
        新结果进入历史上下文
                ↓
          接收下一次动作
这一区别很关键。模型不是先知道整段视频未来会发生什么,再一次性把它画完;它只能看到已经发生的历史和当前输入,然后预测下一段状态。

图2 LingBot-World-Infinity 因果生成流程
因此,所谓“Infinity”更准确的理解是:
生成流程没有预先写死的结束时间,只要计算资源和交互循环继续,模型就能继续向后滚动生成。
但它并不代表模型拥有了一张永不遗忘的三维地图。论文也明确承认:一个区域离开上下文窗口后,再次返回时往往会被重新生成,而不是从长期记忆中准确恢复。因此,它实现的是“长时间视觉连续”,还不是“世界身份永久持久化”。
第一层关键:先把训练数据改造成“能教交互”的样子
只拿普通互联网视频训练,很难直接得到可操控世界模型。原因是普通视频通常只有一段全局描述,例如“一个人在房间里行走”,却没有精确告诉模型:
- 第 3 秒人物向左转;
- 第 7 秒打开门;
- 第 10 秒光线变暗;
- 哪一段变化来自相机移动,哪一段来自物体交互。
LingBot-World 2.0 的数据引擎混合了三类来源:第一人称视频、游戏或 Unreal Engine 等合成数据,以及开放域网络视频。它先进行切片、基础质量过滤和 VLM 语义分析,再按角色、动作、交互、环境动态和静态场景等多条事件轨分别标注。
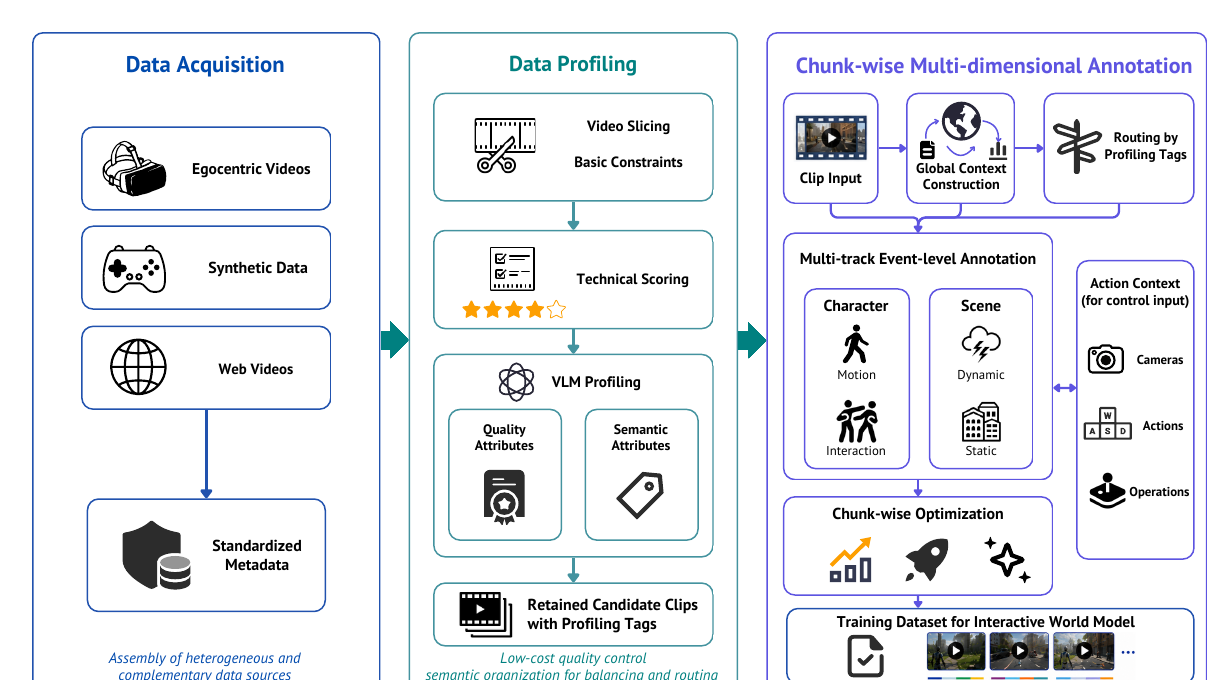
图3 数据引擎:从异构视频到分块、多维事件标注
最后得到的不是“一条视频配一句话”,而是按时间块变化的局部描述。这样,推理阶段即使用户在中途换动作、改天气、召唤新物体,模型也见过类似的“局部条件发生变化”训练形式。
这个数据设计其实比模型结构更容易被低估:世界模型要学的不只是画面质量,而是“什么输入在什么时间导致什么变化”。
第二层关键:MoBA 让模型既学会画好,又学会只看过去
高质量视频扩散模型通常习惯双向看整段视频,这有利于画面一致,却不适合实时世界模拟——真实交互时,模型不可能提前看到未来动作。
如果直接改成严格自回归训练,又容易出现另一个问题:上下文越长,模型越依赖已经存在的干净历史,而忽视真正学习下一段画面应该怎么生成,最终画质下降。
LingBot-World 2.0 为此提出 MoBA(Mixture of Bidirectional and Autoregressive Attention)Mask。直觉上,它把两种训练视角混合起来:
- 自回归区域只允许当前状态查看过去,避免未来信息泄漏;
- 双向区域保留完整注意力,用来维持基础视频生成模型的画质与可变长度能力;
- 相机位姿通过 Plücker Embedding 和 AdaLN 注入;
- 文本则拆成背景提示和按时间块变化的局部提示。
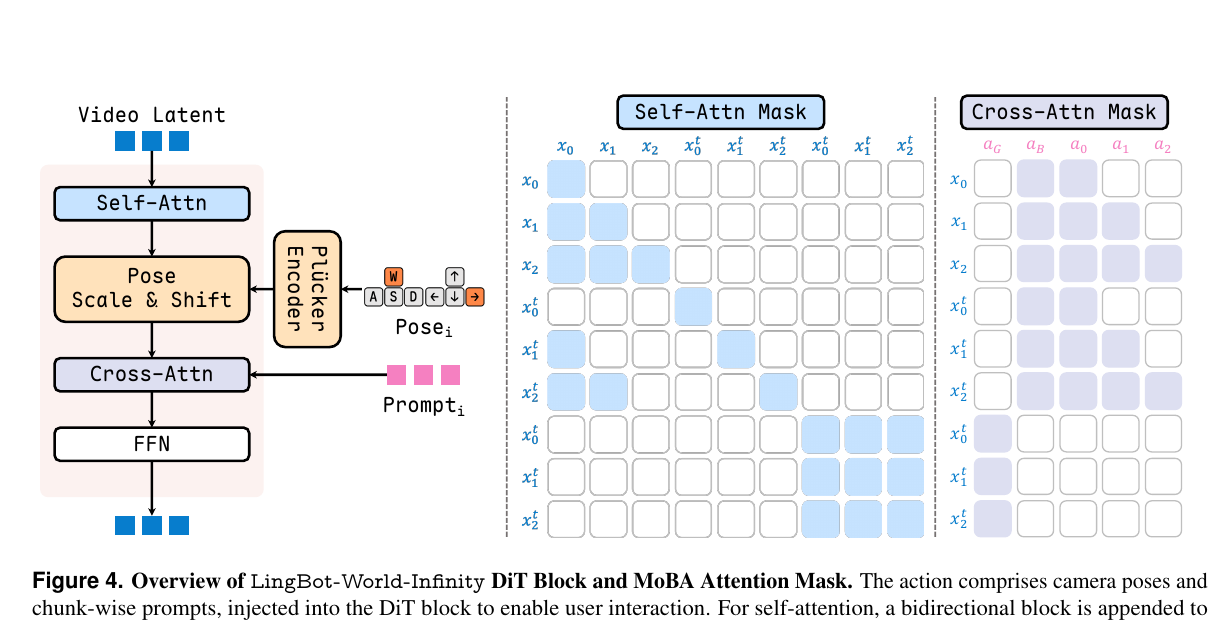
图4 DiT Block 与 MoBA Attention Mask
可以把它理解成一次“从双向视频生成模型向因果世界模型迁移”的缓冲:模型不能偷看未来,但也不必一下子丢掉原本擅长的视觉生成能力。
第三层关键:实时不是少算几步就够了,还要压住自回归漂移
预训练模型画面质量高,但每一段都要进行多步去噪,速度很难满足实时交互。团队因此采用两阶段蒸馏:
- 一致性蒸馏:让同一条教师去噪轨迹上的不同中间状态,尽量映射到相同结果,把多步生成压缩成少步生成。
- 分布匹配蒸馏(DMD):继续约束学生模型生成分布接近真实数据,补回少步生成损失的细节和稳定性。
尤其重要的是,DMD 不是只在教师提供的干净历史上训练,而是让学生沿着自己生成的长轨迹继续滚动,再对这种“自己制造出来的状态分布”进行优化。
这正面对应了世界模型最棘手的误差累积:
第 1 段出现一点误差
        ↓
第 2 段把误差当作真实历史
        ↓
误差继续被放大
        ↓
纹理融化、几何扭曲、身份漂移
所以,LingBot-World 2.0 的实时版本不是简单把采样步数从多步砍到少步,而是在“少步”之外,额外针对长时间自回归时会遇到的错误分布进行训练。
第四层关键:VLM 当导演,视频模型当演员
视频模型擅长把条件变成连续画面,却不一定擅长判断复杂事件是否合理。例如,用户站在一扇门前时,下一步更合理的候选事件可能是“打开门”“开灯”或“离开”,而不是随机召唤一架飞机。
LingBot-World 2.0 在视频生成器外增加了 Director-Pilot Co-Simulation Framework:
- **Director(VLM)**读取当前画面,分析场景和用户动作,提出符合上下文的事件候选;
- **Pilot(视频生成模型)**把这些高层语义事件变成连续视频变化;
- 对需要精确指向物体的交互,可通过 SAM 追踪目标,保持跨视频块的空间对应;
- 用户也可以直接注入昼夜、天气或新实体等全局事件。
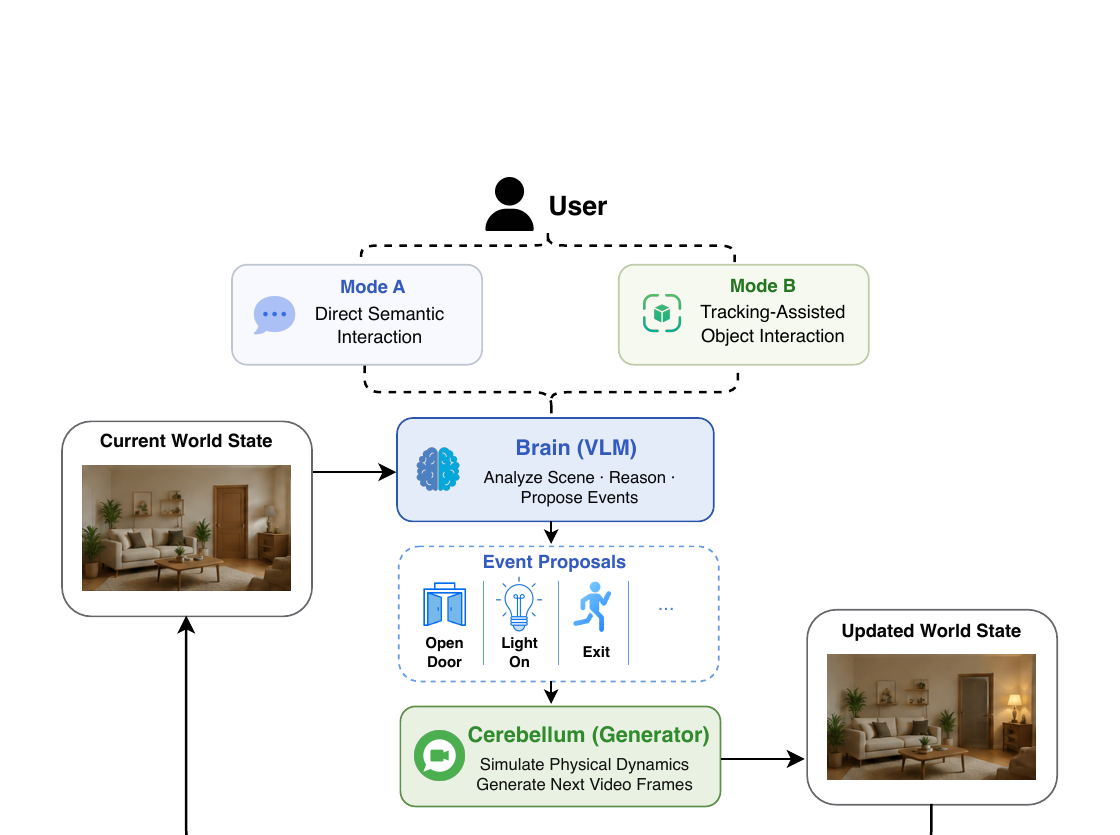
图5 Agentic Interaction Harness
这使它不再只是“按键控制镜头”的视频生成器。VLM 会主动提出接下来可以发生什么,用户选中某个事件后,视频模型再负责把后果画出来。
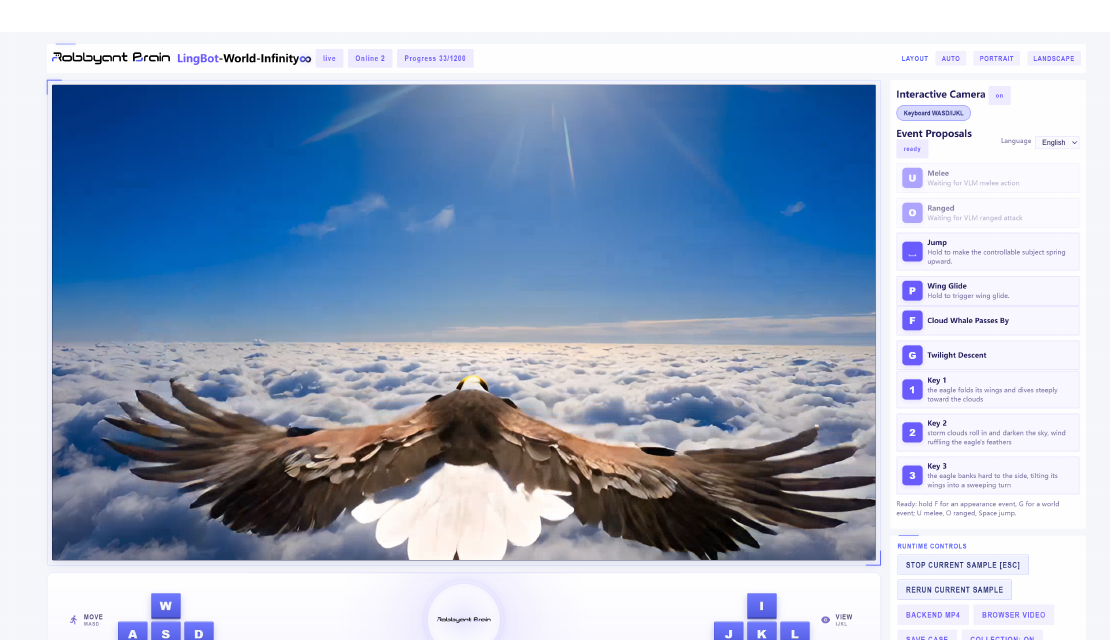
图6 交互界面:WASD 控制移动,IJKL 控制视角,右侧为 VLM 生成的事件卡片
一小时不崩,究竟证明了什么?
论文展示了一次连续 60 分钟的生成过程,从竹林水道、城市街道一路切换到遗迹、温室、雪地码头、轨道站和太空视角,共抽取 20 个场景作为长时压力测试。
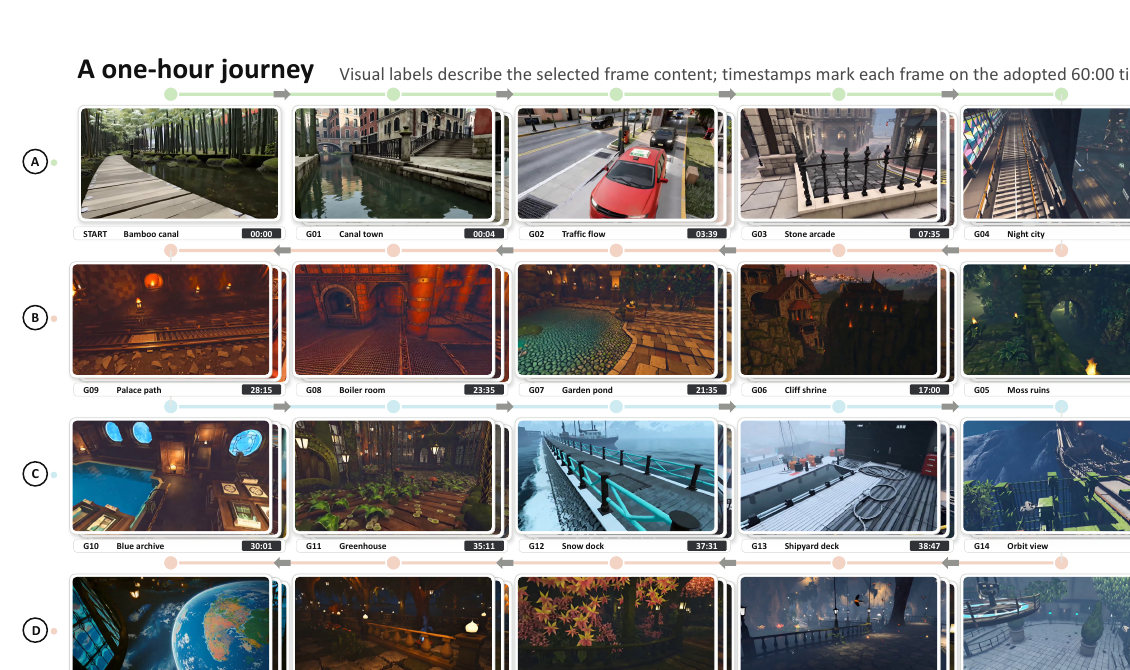
图7 连续 60 分钟世界生成轨迹
这个结果至少说明:模型没有像许多自回归视频生成器那样,在几十秒或几分钟后明显融化成噪声,整体场景结构和可探索性能够维持很久。
但要注意,它是一项定性压力测试,不是关于“世界记忆准确率”的定量 benchmark。图像保持清楚,不代表离开某个房间半小时后还能找回桌面上同一只杯子。
论文对不同模型的长时画面也给出了定性对比。官方结果显示,部分基线会逐渐失焦、变形或偏离原场景,而 LingBot-World 2.0 在相同展示时间点保持了更稳定的视觉结构。
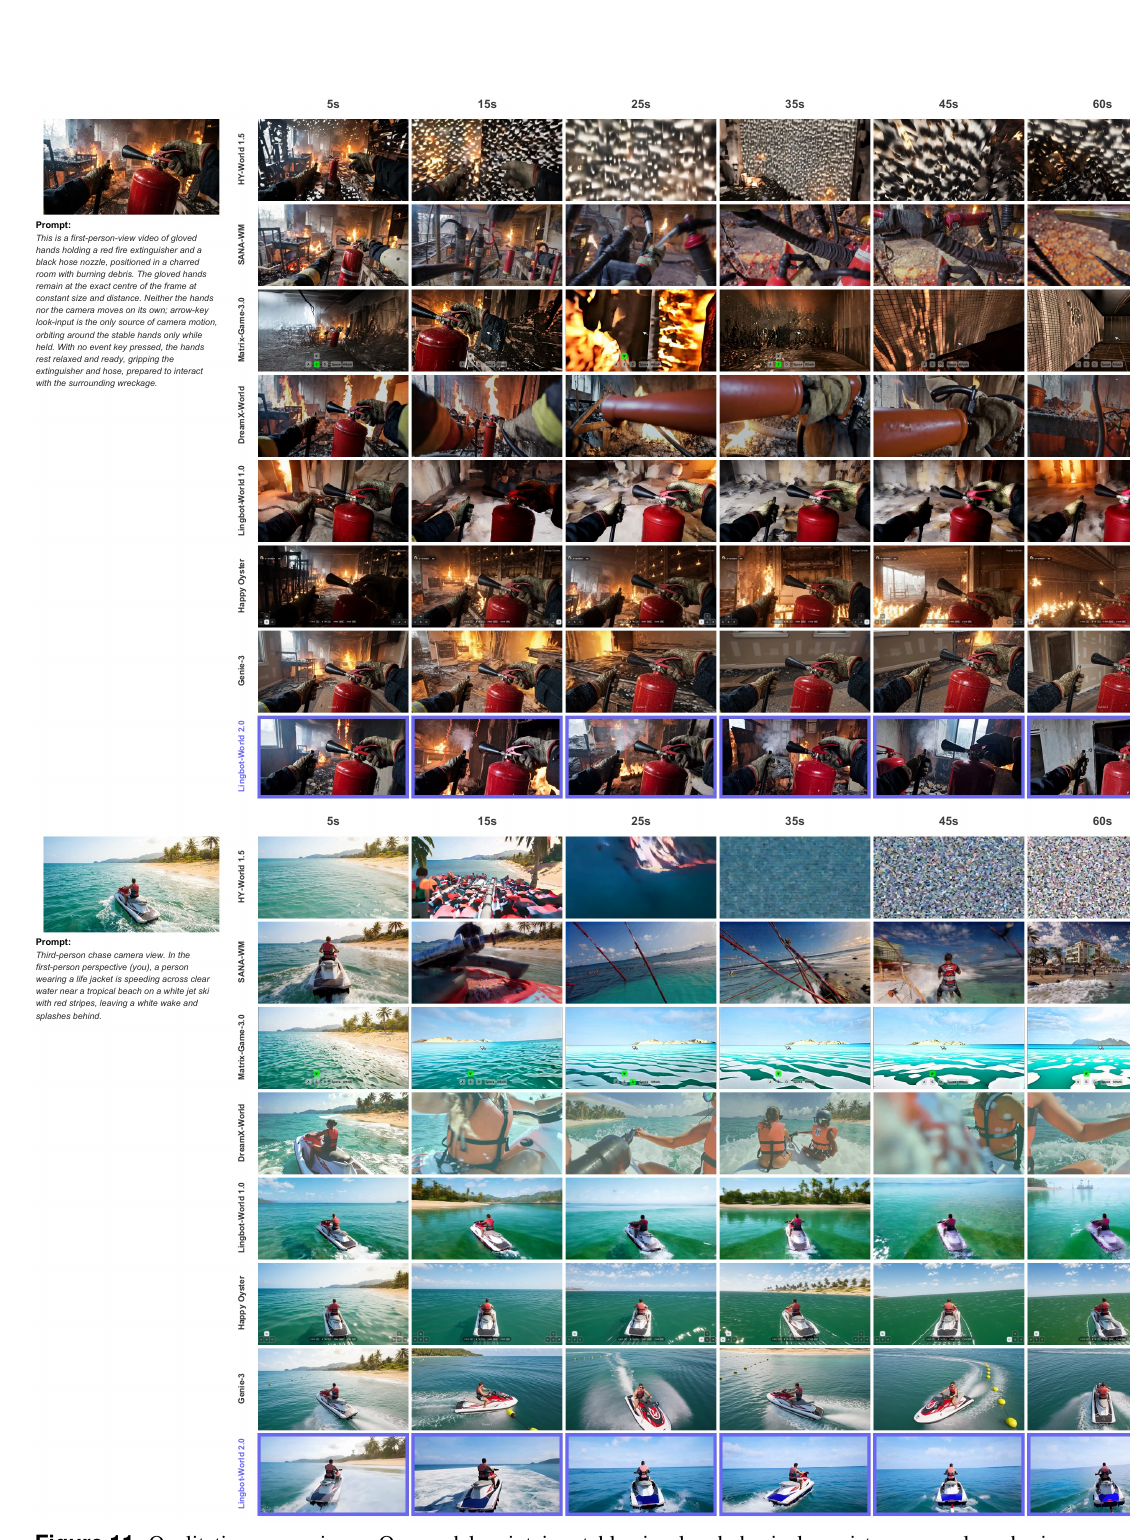
图8 长时生成定性对比
这类图适合判断“是否明显崩坏”,却不能替代严格的用户研究、物理一致性指标或可复现的统一硬件测速。因此,把论文表格中的“Hours(Infinite)”理解成“官方验证了小时级连续生成能力”更稳妥,不应理解成数学意义上的无穷,也不等于永不遗忘。
Quick Start:先跑通官方 1.3B causal-fast
如果只是想体验产品效果,优先使用官方列出的 Reactor 网页版或灵光移动端入口,不需要下载几十 GB 权重。
如果要研究代码,下面以当前仓库的 1.3B causal-fast 为例。官方环境要求 Python 3.10 及以上、PyTorch 2.4 及以上,并需要可编译 FlashAttention 的 CUDA 环境。
1. 克隆并安装
git clone https://github.com/robbyant/lingbot-world-v2.git
cd lingbot-world-v2

python -m venv .venv
source .venv/bin/activate

pip install -r requirements.txt
pip install flash-attn --no-build-isolation
transformers 在 requirements.txt 中被限制为 4.49.0~4.51.3,不要无条件升级到最新版后再排查模型加载错误。
2. 下载 1.3B DiT 与共享资产
pip install "huggingface_hub[cli]"

huggingface-cli download \
  robbyant/lingbot-world-v2-1.3b-causal-fast \
  --local-dir ./lingbot-world-v2-1.3b-causal-fast/transformers

huggingface-cli download \
  robbyant/lingbot-world-v2-14b-causal-fast \
  --local-dir ./lingbot-world-v2-14b-causal-fast
为什么用了 1.3B 还要下载 14B 仓库?因为截至本文核验时,1.3B 模型页只提供 DiT 权重,T5、VAE 和 tokenizer 仍复用 14B causal-fast 包中的共享资产。这里复用的是外围资产,不是让 1.3B 推理时再加载一套 14B DiT。
如果使用魔搭下载 14B causal-fast,可执行:
pip install modelscope
modelscope download \
  robbyant/lingbot-world-v2-14b-causal-fast \
  --local_dir ./lingbot-world-v2-14b-causal-fast
3. 执行官方参考推理
README 当前给出的 1.3B 参考配置是 4 张 GPU:
torchrun --nproc_per_node=4 generate.py \
  --task i2v-1.3B \
  --size 480*832 \
  --ckpt_dir lingbot-world-v2-1.3b-causal-fast \
  --assets_dir lingbot-world-v2-14b-causal-fast \
  --image examples/03/image.jpg \
  --action_path examples/03 \
  --dit_fsdp \
  --t5_fsdp \
  --ulysses_size 4 \
  --frame_num 361 \
  --local_attn_size 18 \
  --sink_size 6 \
  --prompt "A serene lakeside scene with a lone tree standing in calm water."
正常运行时,日志会出现 Generating video ... 与 Saving generated video to ...,最终 MP4 默认保存在 output/ 目录。frame_num 必须满足 4n+1,例如 81、361。
4. 如何换成自己的输入?
最小改动有三处:
--image         换成自己的初始图像
--prompt        换成世界背景与目标描述
--action_path   换成自己的相机控制序列目录
官方 examples/ 中每个案例至少包含 action.npy、poses.npy、intrinsics.npy 和初始图像。建议先完整复制一个案例目录,只替换图像与提示词,确认模型和依赖正常后,再研究相机轨迹数组的生成,避免同时排查模型加载与动作格式两个问题。
从 Demo 到真实项目,应该怎么接?
路线一:做离线“可控镜头生成器”
这是当前开源仓库最容易落地的方向:
- 由应用生成相机轨迹和分块提示;
- 调用
generate.py分段生成; - 监听
output/中的 MP4; - 再接入素材管理、镜头筛选或视频编辑流程。
这种用法不要求实时键盘回路,也不依赖未开源的完整部署服务,适合研究可控视频、游戏概念预演和合成数据生成。
路线二:搭建研究型交互服务
如果目标是让前端持续发送动作,后端返回下一段画面,建议把系统拆成四层:
Web / 游戏控制器
        ↓
动作与事件协议
        ↓
常驻模型进程 + KV Cache
        ↓
分块解码、编码与流式传输
不要让每次按键都重新启动 torchrun、重新加载 T5、VAE 和 DiT。模型进程应常驻,动作按时间戳写入队列;视频块生成、VAE 解码、编码和网络发送应做成异步流水线。
官方仓库推荐参考 SGLang 的 LingBot-World 部署方案或 NVIDIA FlashDreams,但这属于二次工程开发,并非仓库自带的一键服务。
路线三:用于机器人研究,但先别把它当物理仿真器
LingBot-World 2.0 的第一人称数据、相机动作条件和长时自回归能力,使它很适合研究:
- 未来视觉状态预测;
- 策略候选的视觉想象;
- 交互式合成数据生成;
- VLM 规划与视觉世界模型的闭环。
但论文明确指出,它从像素中学习动态,没有显式几何、碰撞和刚体约束,仍会出现物体穿透、角色相交等不符合物理规律的结果。对于机械臂抓取、碰撞安全或精确轨迹验证,不能把生成画面直接当作可信仿真真值。
五个最容易踩的坑
1. 720p、60 fps 是完整部署系统指标
论文的实时系统使用编译优化、高效注意力核、多 GPU 混合并行、异步 VAE 解码、TensorRT 时空增强和流式传输。开源 Quick Start 是 480×832 离线生成,而且部署代码不公开。两者不能直接画等号。
2. “1.3B 可单卡”还没有对应的官方单卡复现命令
论文摘要称 1.3B 支持单 GPU 部署,但当前 README 的参考命令使用 4 张 GPU。更细一点看,仓库内的 run_fast.sh 又把 1.3B 设置为 2 张 GPU。说明公开代码与文档仍处于快速更新期。复现时应优先固定某个 commit,并记录自己实际使用的 GPU 数量,不要只转述“单卡可跑”。
3. 1.3B 包不是完整运行包
它只有 DiT 权重,仍需要从 14B causal-fast 目录提供 T5、VAE 和 tokenizer。磁盘占用和下载时间会明显高于“只有 1.3B”给人的直觉。
4. 长时间视觉稳定不等于长期记忆
模型可以长时间保持画面不明显崩坏,但区域离开上下文后可能被重新生成;具体角色外观和整体风格也可能缓慢漂移。
5. License 不允许直接商用
代码和模型采用 CC BY-NC-SA 4.0。可以在署名和相同方式共享的条件下进行非商业研究与改作,但不能因为“代码公开”就直接集成进商业产品。
它适合谁,不适合谁?
适合
- 研究因果视频生成、长视频生成和交互式世界模型的团队;
- 想分析少步扩散蒸馏与自回归抗漂移训练的研究者;
- 需要生成第一人称交互数据、可控相机轨迹或游戏概念视频的人;
- 想研究 VLM Director + Video Generator Pilot 双系统的 Agent 开发者;
- 有多 GPU 服务器、愿意做模型服务化和流式推理优化的工程团队。
不适合
- 只有普通笔记本或单张小显存消费卡,却希望按 README 直接实时运行的人;
- 需要开箱即用、带完整前后端的商业世界生成产品;
- 需要严格三维几何、碰撞、守恒关系和可重复状态的物理仿真任务;
- 需要把生成世界直接用于商业产品的团队;
- 把“小时级连续生成”理解为精确长期记忆的人。
如果是我,我会这样上手
在线 Demo 感受控制延迟与交互方式
        ↓
固定 Git commit 与模型版本
        ↓
用官方 examples/03 跑通 81 帧短样例
        ↓
再扩展到 361 帧并记录峰值显存、速度和失败日志
        ↓
只替换初始图与 prompt,验证内容泛化
        ↓
生成自己的 action / pose / intrinsics
        ↓
将模型改造成常驻服务,再尝试流式交互
第一轮不要追求复刻 720p、60 fps,也不要一上来接 VLM Director。先证明三件事:模型能稳定加载、动作条件确实生效、长序列不会快速崩坏。之后再决定是否值得投入部署优化。
最后:它真正值得看的,不只是“一小时视频”
LingBot-World 2.0 最吸引眼球的是“一小时不崩”和“720p、60 fps”,但更有研究价值的是它把一个可交互世界拆成了四个层次:
- 用分块、多轨事件标注,让数据能够描述交互;
- 用 MoBA 把高质量双向视频模型迁移成因果生成器;
- 用一致性蒸馏和 DMD 同时解决速度与长时漂移;
- 用 Director-Pilot Agentic Harness,让模型不只响应按键,还能持续提出和执行事件。
它仍然没有真正的长期世界记忆,也不是严格物理模拟器;开源版本距离官方实时系统还有明显工程差距。但它给出了一条相当完整的路线:
世界模型不应只生成“看起来像世界”的视频,而要在持续动作、持续事件和持续反馈中维持一个可以被操作的视觉状态。
这也是 LingBot-World 2.0 比普通视频生成项目更值得关注的地方。