
UC San Diego的新工作:怎么解决动作接近了,但是没抓着这个问题
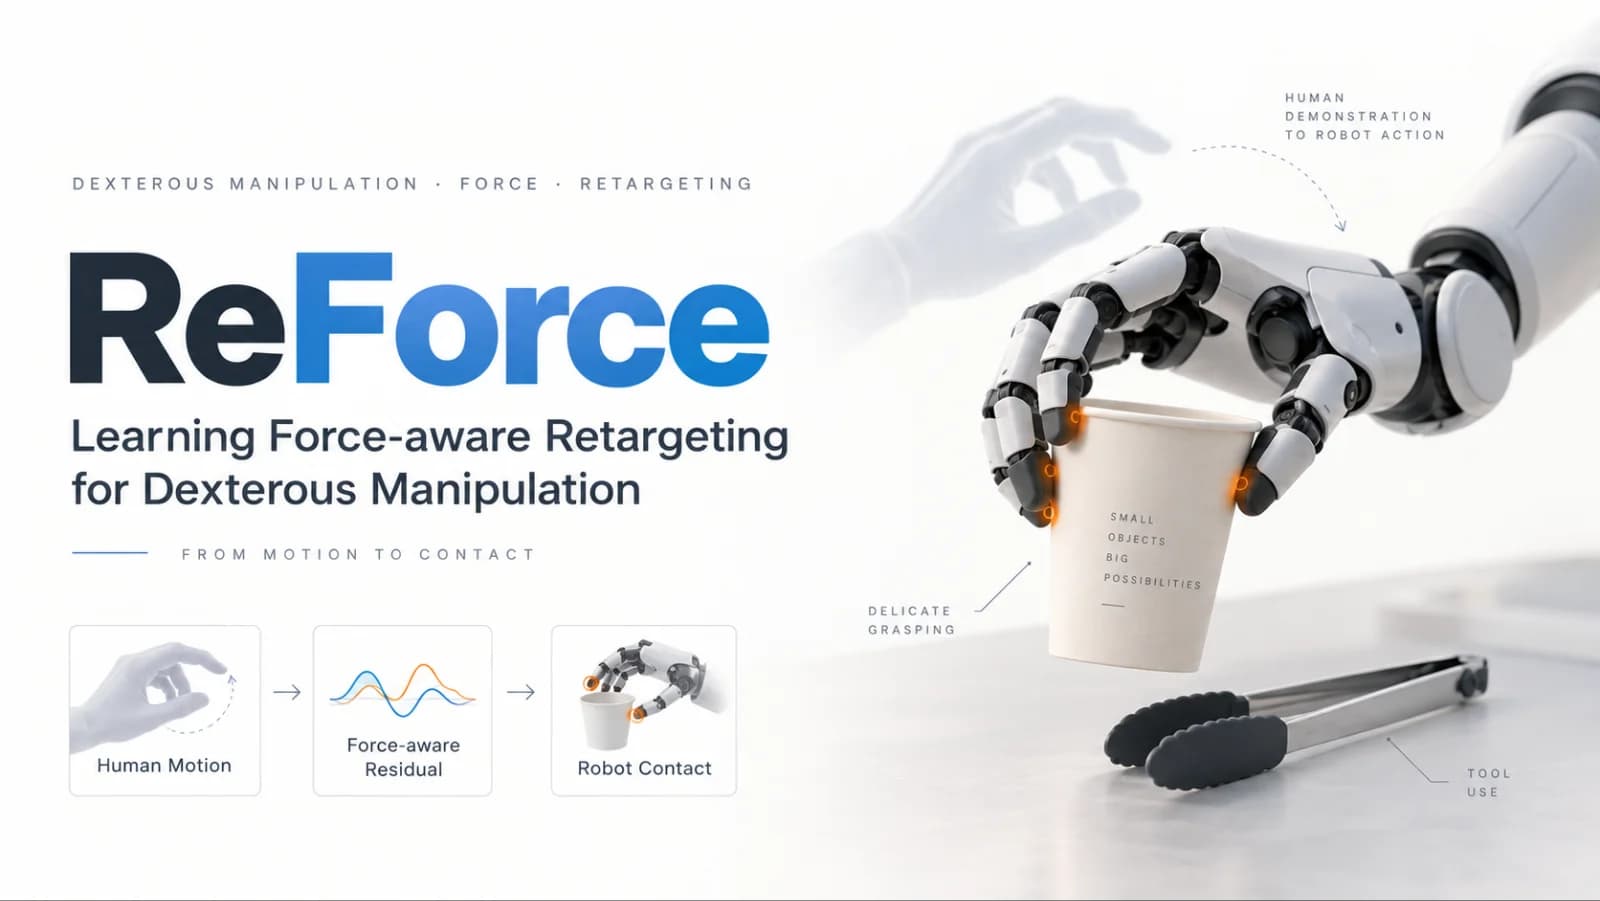
ReForce:Retargeting 只迁了一半
如果最近一直在看 Dexterous Manipulation、Human-to-Robot Retargeting、Teleoperation 或者 Human Video 这条线,会发现一个很容易被忽略的问题:我们天天在说"把人的动作迁到机器人上",而实际迁过去的内容只有一半,姿态迁了,力没有。这件事听起来好像只是"少了一个传感器",放到灵巧操作里,问题就大得多。
比如一个人拿纸杯。从视觉上看,手指位置可以和机器人几乎一模一样:拇指在左边,食指和中指在右边,手型也差不多。然后机器人一执行:啪,杯子瘪了。或者手指位置看起来也对,结果机器人根本没碰到。这时候只看 Kinematics,还会觉得"挺像的啊";物理世界的反应是"像有用吗?"
这是 ReForce 这篇 Paper 的出发点,全名 ReForce: Learning Force-aware Retargeting for Dexterous Manipulation。传统 Retargeting 负责"手应该摆成什么样",ReForce 补上后面那一层:"你摆成这样以后,接触力到底对不对?"
论文针对的核心问题是 Human-to-Robot Retargeting 里的 Embodiment Gap。传统方法(DexPilot、AnyTeleop 这类)把人手关键点或者关节位置映射到机器人手上,本质是一个 Kinematic Optimization:
而 manipulation 的结果由 Pose、Contact、Force 三者共同决定:
论文指出,同样的几何姿态可能对应完全不同的物理结果:抓住、滑掉、夹坏,差别都落在接触力上。
这个问题在普通夹爪上还没那么明显,parallel gripper 的世界比较简单:闭合,夹住,结束。到了五指灵巧手,复杂度立刻上来:食指有没有真的接触?中指是轻轻扶着还是已经承担主要载荷?无名指参与了,还是只是离物体很近?拇指是在对抗其它手指,还是已经压太狠?这些问题单靠 Joint Position 很难回答。
机器人手可能长得很像人,动作也模仿得很像,最后还是拿不住。Kinematic Similarity 和 Functional Similarity 之间隔着一层物理接触,PPT 很像,落地另说。
从 Kinematic Retargeting 到 Force-aware Retargeting
传统 Retargeting 可以写成
给它一个 human pose,算出一个 robot pose。ReForce 认为这不够,Reference 本身应该同时包含 和 ——手应该在哪,以及每根手指大概应该有多大的接触力。目标状态于是变成
机器人当前状态是
是当前机器人手的 joint configuration, 是当前测到的 fingertip normal forces。ReForce 用五个 fingertip force channel,对应 thumb、index、middle、ring、pinky。
误差写出来很直接:
Kinematic Retargeting 盯前半段,ReForce 两段都看。模型预测一个 Joint Command Residual:
然后在现有 command 上继续修:
ReForce 的定位在这里很关键:原有 Retargeting 的输出仍然是起点,它自己负责在接触发生之后,把这个动作往"真的能产生目标接触"的方向修。上层说"手指放这里",ReForce 发现放是放了、但是没碰到;上层说"姿态不是差不多吗",ReForce 回一句"你跟纸杯解释吧"。
它是一个 Residual Controller。Kinematic Retargeting 在 free-space motion 阶段通常已经做得不错,出问题的是 Contact-rich phase。抓杯子差 3 mm,没必要把从伸手开始的整套 Pipeline 重写,在接触阶段哪里力不对就补哪里。补的方式用 Learned Residual 完成。
为什么不直接用 Admittance Control
传统 force controller 也能做类似的事。Admittance Control 的写法是:实际力比目标力小,
再通过
生成修正量,映射到 fingertip displacement,再通过 Jacobian 转成 joint correction。论文把这种手工设计的控制器当 Baseline。理论没问题,现实问题是 Gain 怎么调:不同手指一样吗?不同接触方向一样吗?纸杯和夹子一样吗?已经接触和完全没接触一样吗?多个手指同时接触怎么办?最后 Controller 进入一个熟悉的状态
全是参数。实验室里开始出现"这个 gain 昨天不是还能用吗""换了个杯子""哦"。
ReForce 把 这套映射学出来,减少对手调参数的依赖。整篇 Paper 最核心的内容就在这:Learned Force-to-Motion Correction。
训练数据从哪来:Simulation
问题马上来了:怎么训练?真实世界采几百万条五指接触数据,成本又回到原点。作者的答案是 Simulation。
ReForce 在 Simulation 里大量生成 hand-object interaction trajectory,同时记录 和 ,也就是 Joint Position 和 Contact Force,然后训练一个 General Force Tracker。论文强调这个 tracker 是统一训练的,不做某个 object、某条 trajectory 的单独 optimize,所以可以直接 Zero-shot 用到不同 reference source 上。
这个设计和前面 SPD 那篇放在一起看很合适。SPD 说 Simulation 可以先生产 Dexterity Data,ReForce 说 Simulation 还可以先生产 Contact Correction Experience。最近仿真的 KPI 越来越多:以前是"帮我跑个 benchmark",现在是"帮我采数据、训 skill prior、学 contact dynamics,顺便把现实世界也解决一下"。MuJoCo:"好的,我的排期呢?"
Future Window:别只盯下一帧
训练时它没有直接拿未来某一帧当 Reference,Reference 来自对 Future Window 的平均:
是未来窗口里有效的 timestep 数。可以理解成,它给机器人的指令从"下一毫秒必须精确到哪里"放宽成"接下来这段时间逐渐到达一个差不多这样的 motion + contact state"。好处是 Reference 不会对单个 timestep 的噪声或者瞬时 contact spike 太敏感,force signal 本来就容易抖。
supervised action 还是一小步:
Future Window 提供"未来应该发展成什么状态",当前 action supervision 给出"现在先迈哪一步"。
训练 Objective 很朴素,就是 Behavior Cloning MSE:
是第 根手指对应的 joint 数。作者先在每根手指内部平均,再在五根手指之间平均,否则 joint 数更多的 finger group 会天然在 loss 里声音更大——开董事会可以,但不能因为部门人多就自动多五票。
训练时故意制造不完美
训练数据里故意加入各种不完美情况:Contact Timing Variation、Force Noise、Missing Contact、Residual Force,还会让 reference 暂时 stall,姿态 reference 卡住,但正确 action 还得继续往目标 contact 推。
这些正是部署时天天遇到的情况:Reference 说"你现在应该碰到了",现实是没碰到;Reference 已经开始松手,现实里力还残留着。Force-aware Retargeting 需要学的是出问题之后怎么拉回来,这比单纯的 Force Tracking 更贴近实际。
Human Demo 怎么接进来
除了 Simulation Reference,ReForce 还能吃一套完整 Human Demo Pipeline。人这边:Quest Controller 提供 Wrist Pose,Manus Glove 记录 Hand Pose,五个 Fingertip FSR Sensor 记录 Human Contact Force。机器人这边是 UFACTORY xArm + 12-DoF XHand,XHand 自己的 fingertip tactile sensor 提供当前真实机器人 contact force。
Human Demo 最后变成一条 Robot-space Reference:
是 Human Pose 做 Kinematic Retargeting 后得到的 Robot Joint Reference, 是 Human Fingertip Force 经过 Calibration 得到的 Per-finger Force Reference。
以前的 Human Demo 记录"这个人手怎么动",现在多记录了每根手指大概用了多大力。整篇 Paper 的思想可以压成
比只 Retarget Motion 多出一半信息。这个区别对 Tool Use 尤其关键:人用夹子的时候,拇指关节 34° 这个数字本身不重要,重要的是几根手指一起施加了足够的力让夹子闭合、又没用力过头。Motion 在这里只是实现 Force 的手段之一。接触任务里 Pose 是手段,Force 是结果,这话不能无限推广,但在很多 Contact-rich manipulation 里确实接近现实。
Online 修正和 Offline Translation
ReForce 除了 Online Teleoperation Correction,还支持 Offline Data Translation:已经有一条 Human Demo,不需要人在现场实时操作,先把它转换成 ,再让 ReForce 在机器人执行的时候根据 tactile feedback 在线修正。
论文强调它不依赖每个新 Object 都有 Digital Twin,也不要求每条 trajectory 都重新在 Simulation 里做 trajectory-specific optimization,因此比一些 physics-aware retargeting 方法更适合 Online Teleoperation 和大规模 Offline Translation。
以前一些 Force-aware 或 Contact-aware Retargeting 方法要求先知道 Object Mesh、准确 Pose、摩擦参数,然后进 Simulation 优化。实验室里做 Demo 很漂亮,一旦换成"我现在随手拿了一个新杯子,在线 Teleop",系统回一句"请先给我 CAD",人就无语了。
ReForce 的做法是:在 Simulation 里把各种 contact correction 练过一遍,现场根据 Force Error 直接修。这个 general force tracker 的定位比"又一个 retargeting network"更值得关注。
ACT:告诉机器人应该去哪
论文还训练了一个 ACT(Action Chunking Transformer),预测未来一小段的 Motion Reference 和 Force Reference:
其中
是历史 configuration, 是 task phase。
这个 Reference Policy 不吃当前测得的 fingertip force。它负责"按照 Demo,我现在大概应该进入什么 contact phase",当前接触偏差怎么修交给 ReForce,Force Feedback 也另外送给 ReForce。
分工因此很干净:ACT 说应该去哪,ReForce 看现实有没有做到,没做到就修。这样的结构避免了让一个 Policy 同时处理 Task Progress、Reference Generation、Force Feedback、Local Contact Correction:
战略部门给方向,现场部门负责别把纸杯捏爆。
实验:Paper Cup 和 Tongs
论文在真实机器人上主要用了两个 Force-sensitive Task:Paper Cup Grasping 和 Tongs Manipulation。为什么选纸杯其实很好理解——纸杯是一个非常讨厌的测试物:力小了拿不住,力大了瘪。它特别适合测试一个系统到底是真的 Force-aware,还是"我只是把手指关得更紧"。Tongs 同理,你需要足够力把夹子闭合,但过大又可能导致操作异常。
作者先做了一个最干净的实验:固定同一条 Recorded Reference,比较 Direct Replay、Admittance、ReForce。Paper Cup Side Grasp 的 Force Tracking Error:
- Replay:
- Admittance:
- ReForce:
Top Grasp 更明显:
- Replay:
- Admittance:
- ReForce:
同一条 Kinematic Reference,执行方式不同,最后 Force 可以差很多。Joint Trajectory 对了,力不一定对。
Direct Replay 的问题在于它不看现实:Reference 说"现在食指应该已经碰到了",机器人回"好的",实际根本没碰,它还是继续往后放——流程走完了,业务没发生。
Admittance 会根据 Force Error 修,但 hand-designed mapping 有时候会产生 Residual Force:Reference Force 已经下降,Controller 由于动态响应、gain 或映射关系还在继续压。ReForce 更容易根据当前 contact state 学出不同的 correction。
论文没有把自己写成全赢。进入 Learned Reference 的完整实验以后,结果复杂起来。Paper Cup 上,Reference Policy 的 Force-safe Success 是 ,Reference + Admittance 是 ,Reference + ReForce 是 。ReForce 的 Force Tracking Error 是 ,低于 Reference Policy 的 和 Admittance 的 。Severe Missing Contact 从 Reference Policy 的 降到 ReForce 的 ,平均 Active Fingers 从 提高到 。
ReForce 的优势集中体现在 Contact Engagement 上:该碰到的时候,真的更容易碰到。
Force Error 单独看容易被骗。目标力 2 N、实际力 0 N,如果模型从来没碰到物体,某些任务阶段的平均值可能看起来也没那么夸张。作者因此加了 Active Fingers、Severe Missing Contact、Over-force 这些指标,这个实验设计是对的。Force-aware manipulation 只报一个 Mean Force Error,很容易掩盖"整个手都没碰东西"这件事——模型说"误差挺小",物体说"你谁?"
到了 Tongs,事情更真实。Force-safe Success:Reference Policy ,Admittance ,ReForce 。ReForce 明显没赢 Admittance,原因也写得很清楚:它有 次 Over-force Trial。平均 Active Fingers 它最高(),Missing Contact 也减少了,但压得太狠,Force-safe Success 被直接拉下来。
更会建立接触和更会控制接触是两件事。ReForce 擅长解决"本来该碰但没碰"的 Missing Contact,在某些任务里会过度补偿——"我知道你要力""收到""给你更多力""不用了""给",这就是 Tongs 里面的问题。
有人看完标题写成"ReForce 全面优于 Admittance Control",不准确。合理的结论是:ReForce 在复杂多指 Contact Engagement 上有优势,Force Regulation 相比经典 Admittance 仍然是 Task-dependent。
论文自己也是这么写的。它证明了 Hand-designed Force-to-Motion Mapping 在多指、高维、Embodiment-specific Contact 里有一部分可以被 learned correction 替代,同时 Classical Control 在结构清晰的任务上依然能打。Force Control 不是昨天才发明的,经典控制几十年也不是在实验室摸鱼。
Retargeting 的定义被推了一步
几个牛顿的误差之外,更值得看的是 Retargeting 的定义往前挪了一段。
以前说 Retargeting,想到的是 Joint Mapping、Keypoint Mapping、Pose Mapping、Trajectory Matching。现在得习惯:
manipulation 里人真正演示的是"我怎么和这个物体发生作用",手长什么样只是其中一个 Observable,Force 是 interaction 的另一半。
这和 Human Video 迁机器人直接相关。Human Video 数据多,但如果只从 RGB recover Pose 再拿去 Retarget,很多细粒度 manipulation skill 天生就丢了:RGB 能告诉你手指在那里,告诉不了你它压了多少、有没有真的接触、主要载荷在哪根手指上。
由此引出一个更大的问题:Human Demonstration Dataset 要不要把 Force / Tactile 当成第一等公民?现在很多 Human Data Pipeline 是 RGB、Depth、Hand Pose、Body Pose,偶尔加个 IMU。目标往 Dexterous Manipulation 走,Pose-only Human Data 本身就带着信息缺失。
和 SPD 的关系
SPD 绕开 Human-to-Robot Embodiment Gap,直接让人操作 Virtual Robot;ReForce 走另一条路,Human Data 继续要,把 Force Intent 一起迁过来。两者处理的是同一个大问题的不同侧面:
一个解决 Embodiment Alignment,一个解决 Interaction Alignment。再叠加视觉 world model,分工大概会变成:世界长什么样、手应该怎么动、手真正应该怎么和东西接触。系统复杂度开始向企业组织架构发展。
限制
Force Reference 怎么来? 论文真实实验里 Human Side 用了五个 Fingertip FSR Sensor,这段信号没法从随手一个 YouTube Video 里拿到。想要 Force-aware Human Demonstration,就得有 Force Sensing,这会直接影响数据 Scale。Human Video 的一个巨大优势是已经存在,ReForce 这种 Force Demo 得重新采。它解决了"怎么迁 Force",没有解决 Force Data 本身怎么大规模来。这个问题以后会很大:wearable tactile、从 vision / deformation 估 force、multimodal sensor,总得挑一条,反正不会凭空出现。
当前 real-world task 还是比较少,核心就 Paper Cup 和 Tongs。它们确实 Force-sensitive,也适合验证方法,但还不足以说明 ReForce 已经是 General Dexterous Retargeting。In-hand Rotation、复杂 Tool Use、软物体、双手操作、多阶段 Contact Switching 这些还没有真正证明。
训练高度依赖 Simulation Interaction Distribution。 不需要每个 Deployment Object 都有 Digital Twin,这一点比 per-object optimization 方便,但能不能 Zero-shot generalize,取决于 Simulation 里到底把哪些 Contact Failure 看过了。现实里出现一种完全不同的 tactile response,网络照样可能"这个题没刷过"。
Force 也只是一部分。 论文主要用 Fingertip Normal Force,真实 dexterous manipulation 里还需要 Tangential Force、Torque、Slip、Contact Location、Shear,甚至 deformation。 已经比 Pose-only 前进一大步,离完整 Contact State 还有很远。
值不值得看
如果你做 Dexterous Manipulation、Human-to-Robot Retargeting、Teleoperation、Tactile、Force Control、Human Demonstration,这篇值得看,做 Retargeting 的人尤其建议看。它把一个之前很容易被忽略的问题摆到了正中间:你在迁"动作长得像",还是在迁"动作产生的效果像"?
时间有限的话重点看三块。
- Problem Formulation。 和 这两个式子看懂了,整篇 Paper 的思想懂了一半。
- Figure 2 的 Training / Inference Pipeline。 看清 ReForce 是堆在 Kinematic Retargeting 上面的 Residual,别误以为它把 Retargeting 重做了一遍。
- Table 2。 Paper Cup 和 Tongs 一起看,能看到方法的边界在哪里。看完别急着下"加了 Force-aware Network 就能扔掉传统 Force Control"的结论,这篇还没证明这件事。