
CEED-VLA:让离散自回归 VLA 学会“并行改动作”,再提前结束解码
论文: CEED-VLA: Consistency Vision-Language-Action Model with Early-Exit Decoding
会议: ECCV 2026
论文版本: 2506.13725v1,2025-06-16
先说结论:CEED-VLA 到底快在哪里?
VLA 模型现在已经能够根据图像、语言指令和机器人状态直接生成动作,但它们在真正的机器人上经常遇到一个现实问题:动作生成不够快。
对于“按一下按钮”这类动作,低频推理有时还能勉强工作;但对于倒水、折毛巾、抓取边缘这类灵巧操作,机器人需要连续、平滑、高频地更新动作。如果每一轮动作都要让语言模型自回归地一个 token 一个 token 生成,延迟就会直接变成控制质量问题。
CEED-VLA 的核心不是重新设计一个更小的 VLA,而是对已有的离散自回归 VLA 做两层改造:
- 训练层:一致性蒸馏。 让学生 VLA 学会从 Jaco-bi 解码的任意中间状态,直接预测最终稳定结果,并且一次修正多个 token。
- 推理层:早退出解码。 机器人动作通常不需要等到每个 token 都严格收敛,达到一个足够好的中间状态就可以先执行。
论文在 OpenVLA + LIBERO-Long 上报告 4.1× 解码加速、25.60 Hz 执行频率;在 LLaVA-VLA + CALVIN 上报告 2.0× 解码加速。真实机器人实验中,倒水成功率从 15% 提升到 80%,折毛巾从 5% 提升到 75%,四项任务平均成功率从 33.25% 提升到 77.50%。
但要注意:这些数字对应论文的特定基座模型、数据、GPU 和评测设置,不能简单理解为“所有 VLA 都能固定得到 4 倍加速”。
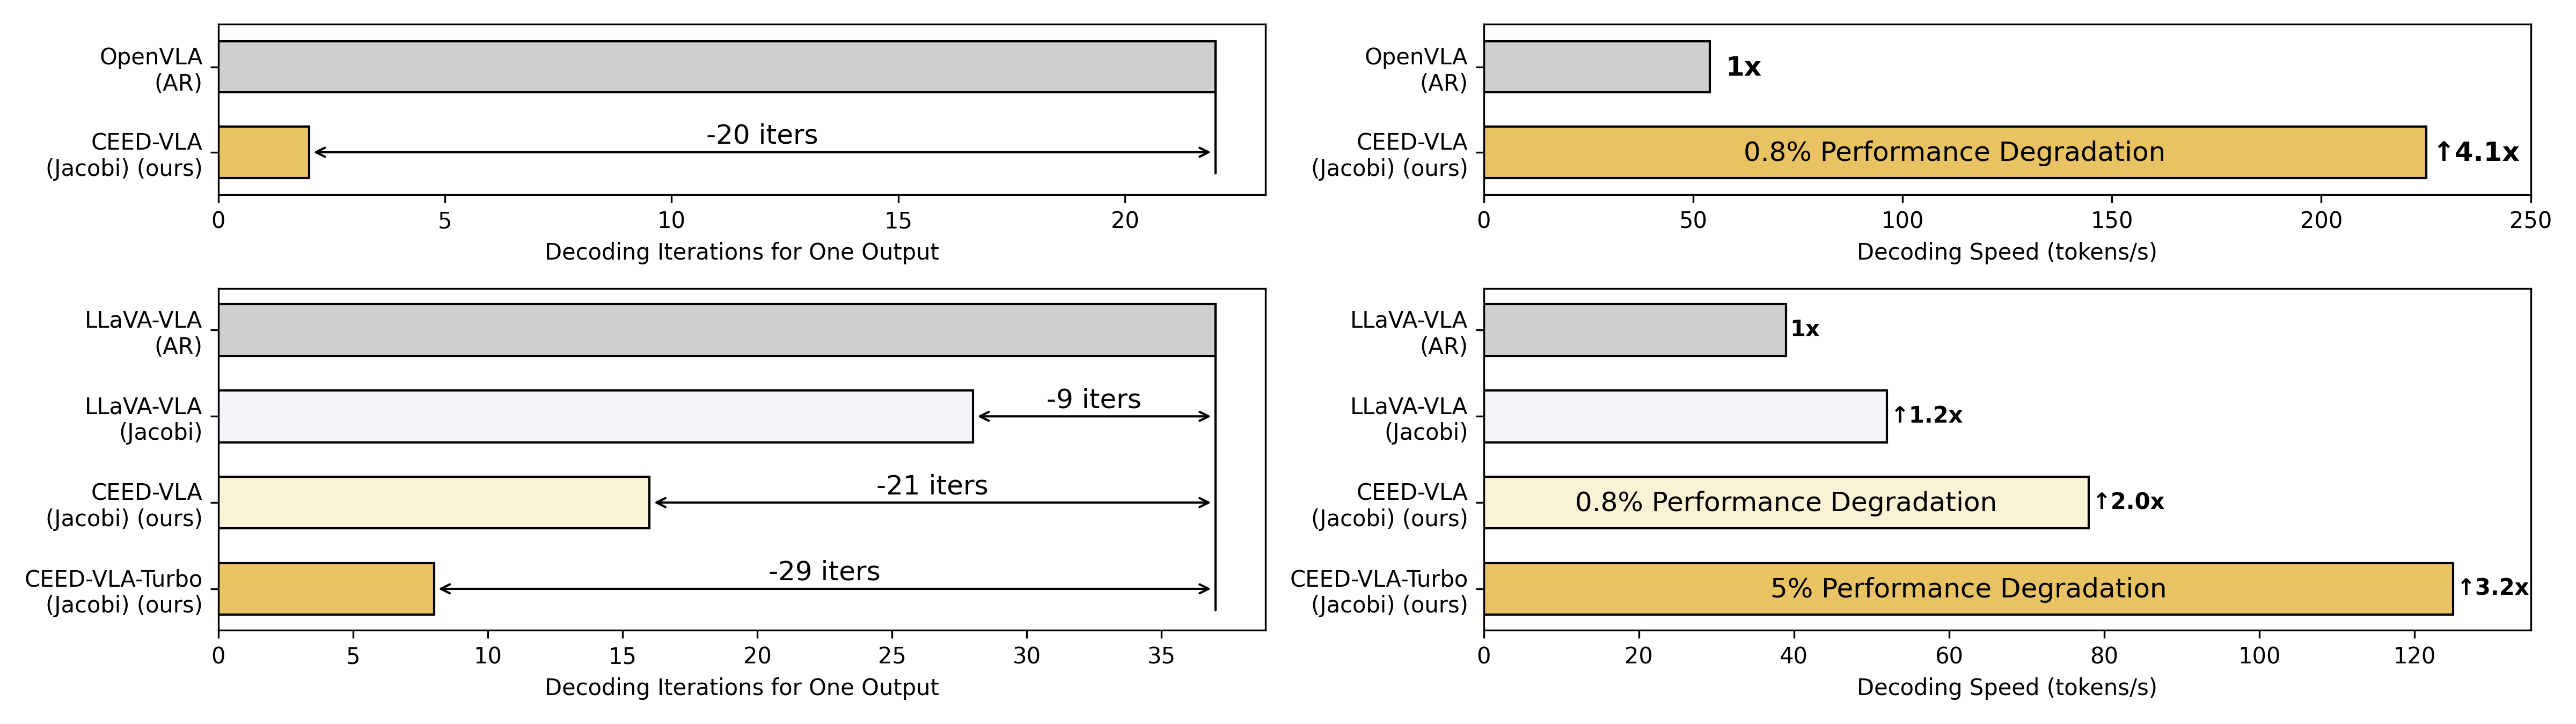
图1 CEED-VLA 在 OpenVLA 与 LLaVA-VLA 上的加速效果
图中可以看到,直接运行 Jaco-bi 解码的 vanilla VLA 加速有限;经过 CEED-VLA 训练后,OpenVLA 版本的速度达到约 4.1×,LLaVA-VLA 版本达到约 2.0×。论文同时报告了较小的性能下降,说明它的目标是把更多 token 的并行预测能力真正转化为可用的推理速度。
一、问题不只是模型大,而是解码方式太慢
1. VLA 的动作也被表示成 token 序列
以一个动作块为例,VLA 并不是直接一次性吐出一整个连续动作向量,而是先将动作离散化成一串 action tokens。模型根据:
- 当前相机图像;
- 语言指令;
- 机器人本体状态;
逐步生成这些 token,再经过 action detokenizer 还原成末端位置、姿态和夹爪状态。
论文附录中的 LLaVA-VLA 结构可以概括为:
图像 ──→ Image Encoder ─┐
                         ├─→ Large Language Model ─→ action tokens
指令 ──→ Text Tokenizer ─┘                              │
                                                        ↓
                                             Action De-tokenizer
                                                        ↓
                                                   机器人动作
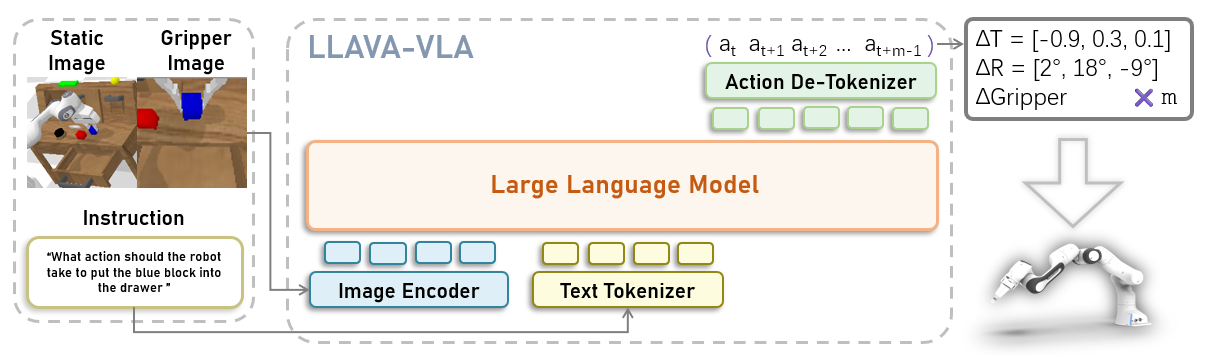
图2 LLaVA-VLA 模型结构
2. 标准 AR 解码:稳定,但必须串行
标准自回归解码的逻辑很简单:
先生成 a₁
再根据 a₁ 生成 a₂
再根据 a₁、a₂ 生成 a₃
……
直到生成 aₙ
它的优势是训练和推理行为一致,输出通常比较稳定;缺点是每生成一个 token,都要进行一次模型前向计算。动作序列越长,串行等待越明显。
二、Jaco-bi 解码:能并行,但原始 VLA 学不会一次改对多个 token
Jaco-bi 解码的思路来自数值计算中的固定点迭代。它先随机初始化一串动作 token,然后把整串 token 一起送进模型,让模型在每一轮同时更新所有位置:
初始化:a₁  a₂  a₃  a₄  ……  aₙ
第 1 轮:a₁' a₂' a₃' a₄' …… aₙ'
第 2 轮:a₁''a₂''a₃''a₄''…… aₙ''
……
直到两轮结果完全相同
如果一次迭代能够固定多个正确 token,那么总前向次数就可能远小于 AR 解码。
问题在于:普通 VLA 是按照自回归方式训练的。 它习惯了“前面的 token 已经正确,再预测后面的 token”。当 Jaco-bi 解码给它一个包含错误前缀的中间状态时,错误会沿着序列传播:前面一个 token 错了,后面的 token 也不容易一次预测正确。
所以,直接把 AR 换成 Jaco-bi 并不能自动得到理想收益。PD-VLA 这类工作已经说明并行解码可以 加速 VLA,但在普通模型上,Jaco-bi 迭代可能仍然很多,实际加速有限。
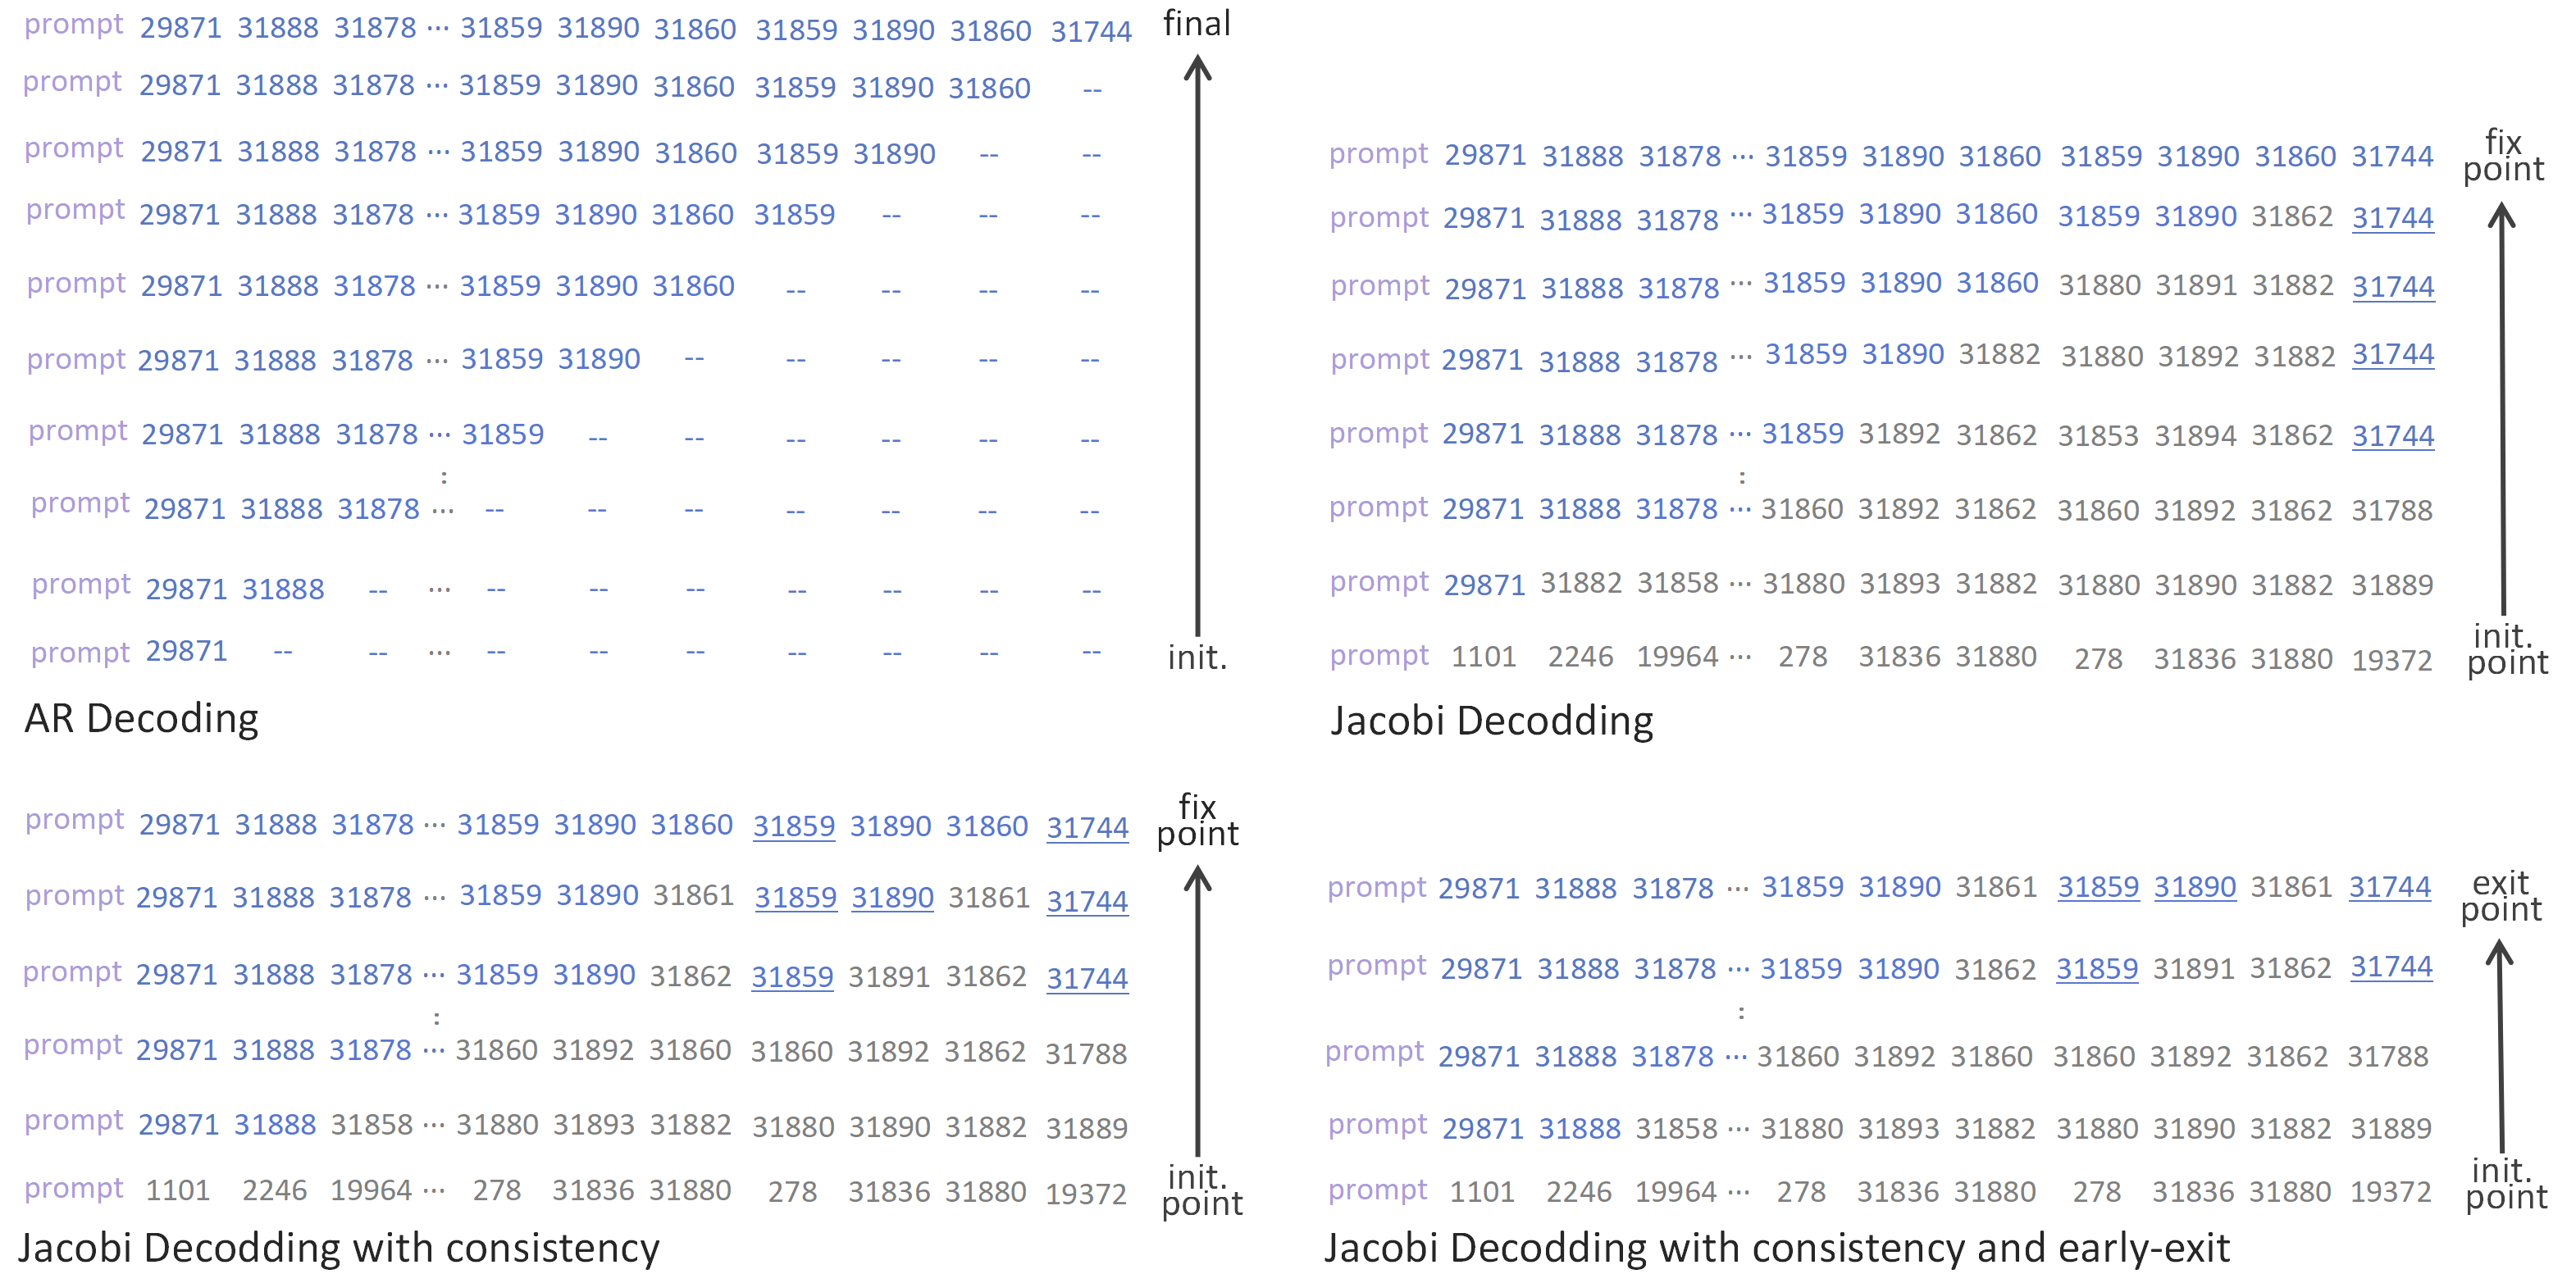
图3 四种解码方式的直观对比
从图中可以看到,CEED-VLA 的目标不是放弃 Jaco-bi,而是让模型具备一种新的能力:即使输入状态还没有完全正确,也能在一轮中把多个位置推向最终结果。
三、三秒看懂 CEED-VLA:教师负责走完整轨迹,学生学会从中间状态跳到定点
下面这张图是本文根据论文方法重新绘制的辅助理解图。最重要的关系只有一句话:
一致性蒸馏负责减少“每一轮要迭代多少次”,早退出负责减少“是否还需要继续等尾部收敛”。
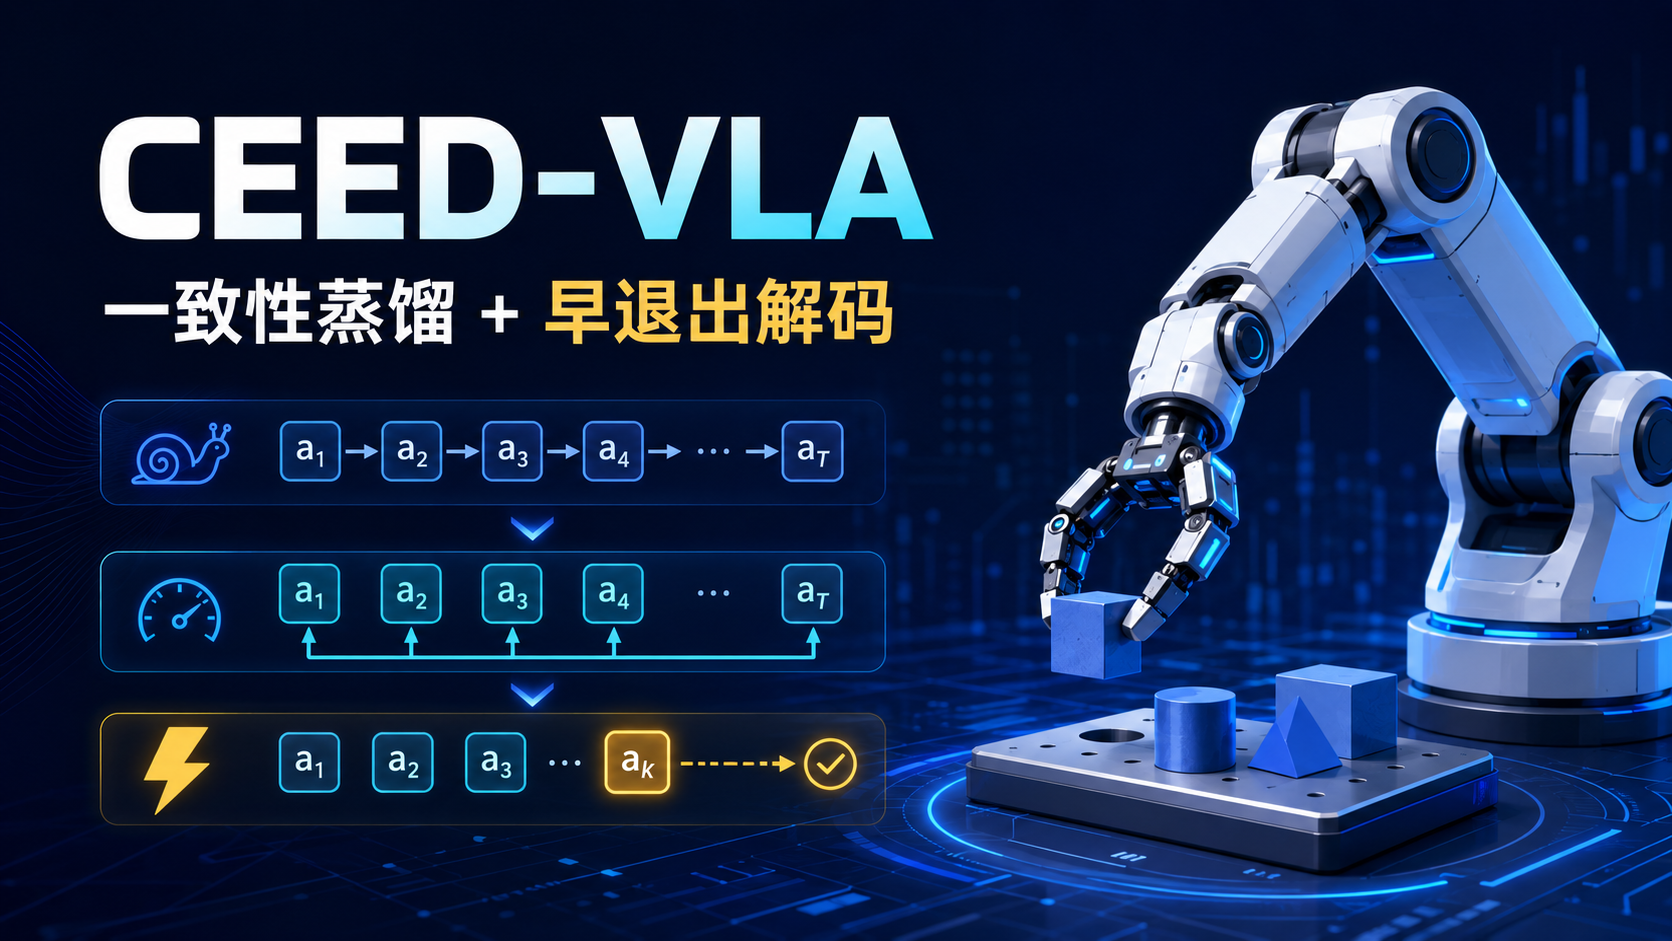
图4 CEED-VLA 核心流程
论文原始框架图如下,它同时展示了教师模型、Jaco-bi 轨迹、一致性损失、混合标签监督和早退出解码之间的关系。
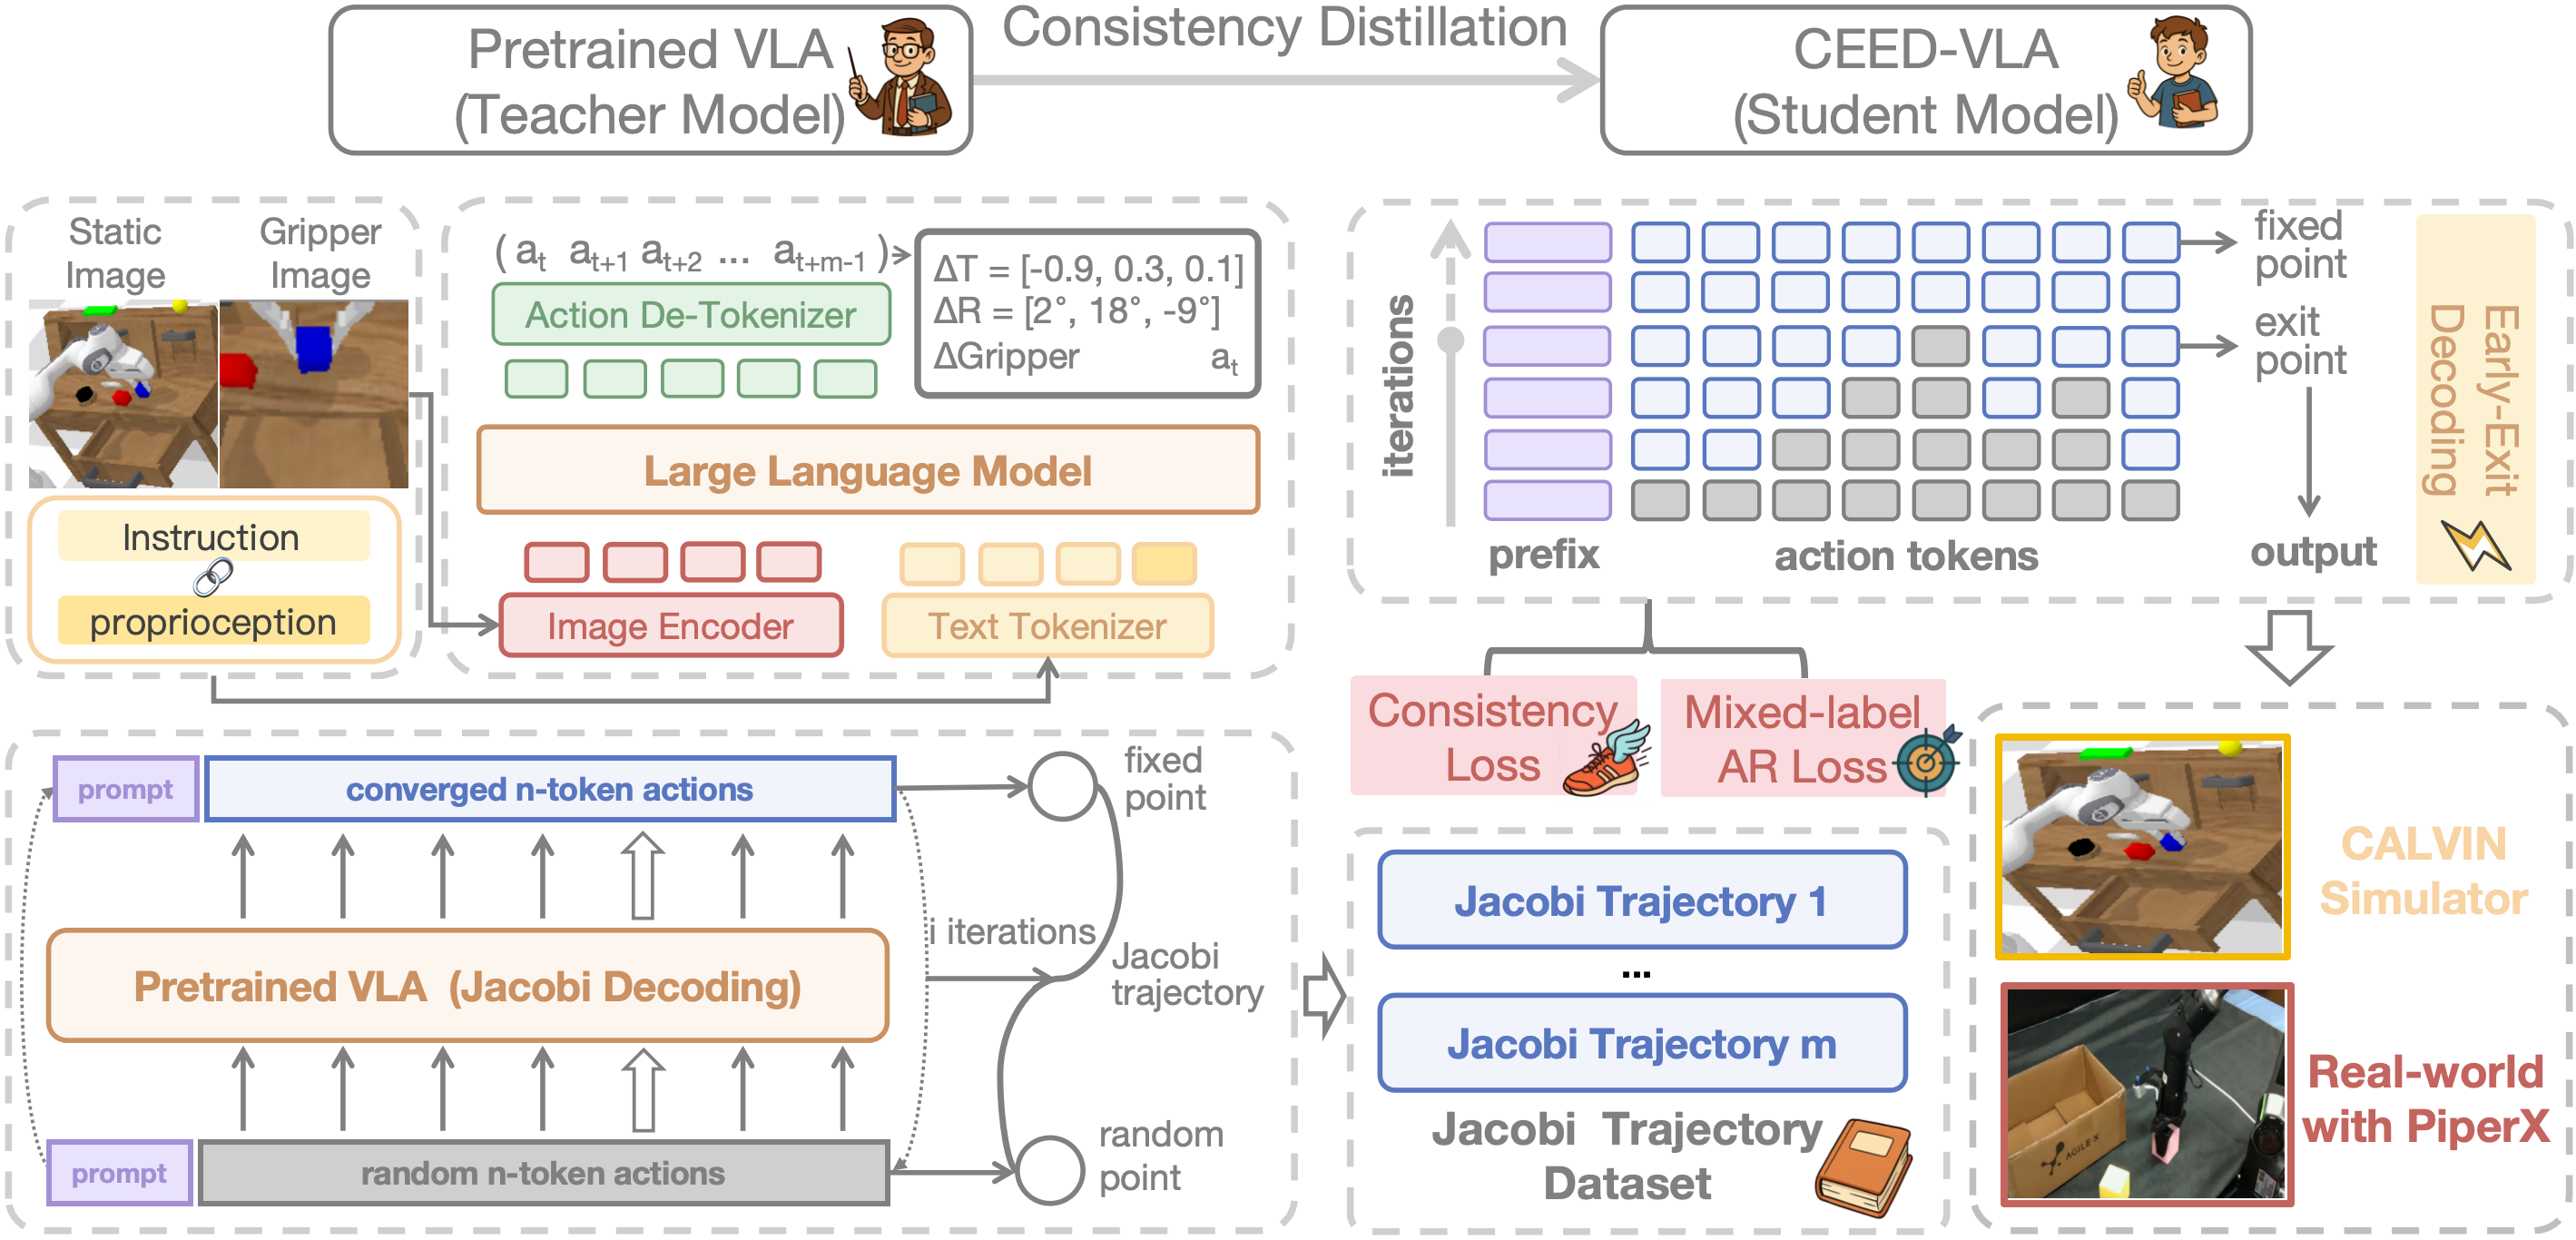
图5 CEED-VLA 整体框架
四、第一层加速:先收集 Jaco-bi 轨迹
CEED-VLA 的训练不是凭空构造一个“多 token 预测”目标,而是先让预训练教师 VLA 用 Jaco-bi 解码跑起来,并记录它从随机初始化到最终固定点的完整过程。
对于一个训练样本,记录的数据大致是:
输入 x = 图像 + 语言指令 + 本体状态
Jaco-bi 轨迹 J = {Y⁰, Y¹, Y², …, Y*}
其中:
Y⁰是随机初始化的动作 token 序列;Y¹、Y²……是中间迭代状态;Y*是传统 Jaco-bi 解码最终达到的固定点。
这条轨迹告诉学生模型:同一个任务从不同中间状态出发,最终应该走向哪里。
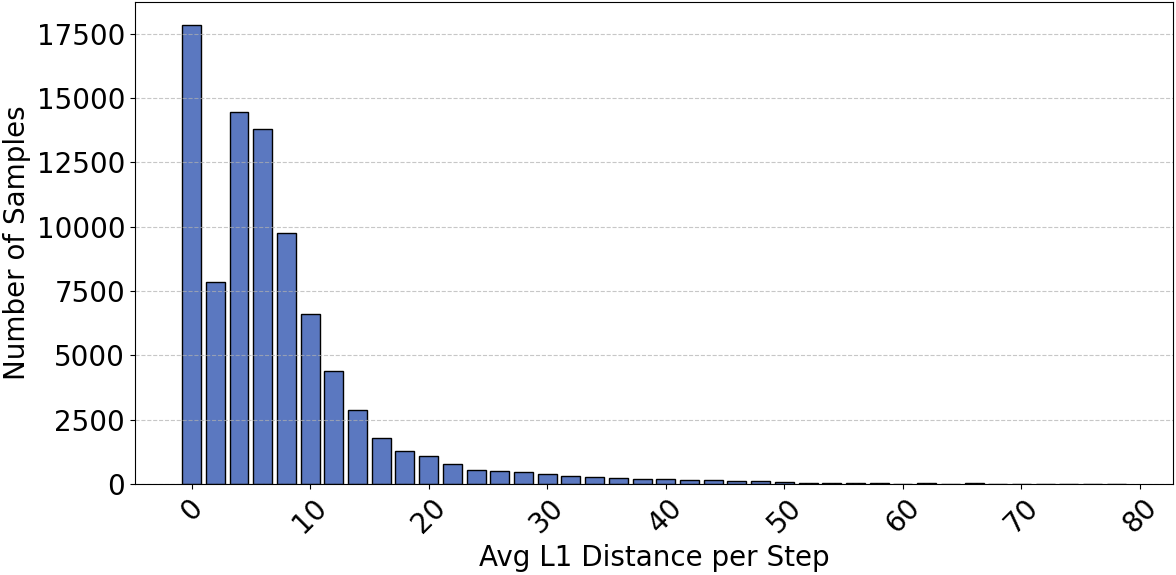
图6 Jaco-bi 轨迹数据的 L1 距离分布
论文观察到,大部分样本的平均 L1 距离集中在较小范围,但仍存在偏离较大的样本。这正是后面混合标签监督要处理的部分:教师自己生成的固定点并不一定永远比真实示范标签可靠。
五、第二层加速:一致性蒸馏到底蒸馏了什么?
1. 不是让学生背答案,而是学“从任意中间状态到最终状态”的映射
传统 Jaco-bi 解码需要:
Y⁰ → Y¹ → Y² → Y³ → …… → Y*
一致性训练希望学生模型学成:
任意 Yᵏ ─────────────→ Y*
也就是说,输入不再被限制为“已经正确的前缀”,而是允许包含错误 token 的中间状态。学生模型被训练成:即使前面几个 token 还不对,也能同时修正后面多个位置。
论文用一致性损失约束学生模型在中间状态 Y 上的预测分布,接近教师在最终固定点 Y* 上的预测分布。工程直觉可以理解为:
把“逐步走完全程”变成“看到路线中的任意位置,都知道终点附近应该长什么样”。
2. 为什么还要保留 AR 监督?
只使用一致性损失会有一个风险:学生可能越来越像教师在 Jaco-bi 轨迹上的输出,却逐渐偏离原始机器人示范分布。
因此 CEED-VLA 同时保留 AR 监督,让模型继续学习正确动作序列。但这里又不能简单地只用教师标签,因为教师的 Jaco-bi 固定点可能本身就有误差。
六、混合标签监督:教师标签和真实标签之间动态切换
CEED-VLA 用生成轨迹中的固定点与真实动作标签之间的 L1 距离判断样本是否可信:
如果 L1(Y*, GT) 较小:
    使用教师生成的固定点 Y* 作为 AR 标签

如果 L1(Y*, GT) 较大:
    放弃这个教师标签,切换为真实示范标签 GT
这样做解决了两个相反的问题:
- 只用教师标签: 教师误差可能在蒸馏中累积,导致动作质量下降;
- 只用真实标签: 真实标签和一致性目标之间可能产生冲突,影响模型学习快速收敛行为;
- 混合标签: 小误差样本利用教师轨迹提供的加速信号,大误差样本回到真实示范,兼顾速度和动作质量。
论文中的消融结果很清楚:在 LLaVA-VLA 上,混合标签取得 2.00× speedup、平均完成长度 3.67;只用教师标签为 1.83×、3.48;只用真实标签为 1.67×、3.20。这说明混合标签并不是一个附属技巧,而是稳定蒸馏过程的重要保险机制。
训练目标可以用一句话概括:
总训练目标 = 一致性损失 + 加权 AR 监督
一致性损失负责“更快靠近固定点”,AR 监督负责“不要忘记原来的操作能力”。
七、第三层加速:为什么已经会并行了,还要早退出?
一致性训练解决了“每一轮能不能固定更多 token”,但严格 Jaco-bi 解码仍然有一个瓶颈:它要求相邻两轮的完整 token 序列完全一致,才算收敛。
这会带来一些低收益迭代:
- 前面大部分 token 已经不再变化;
- 只有极少数 token 还在微调;
- 这些末尾变化对最终机器人任务可能影响很小;
- 但系统仍然必须继续计算,直到整串 token 完全不变。
论文称这类过程为 inefficient iterations。它们会拉低平均速度,甚至拉低最小速度。
早退出的核心假设
机器人任务和一般的 token-level accuracy 不完全一样。一个任务最终是否成功,往往由少数关键状态决定,例如:
- 夹爪是否在正确位置闭合;
- 是否在目标位置释放物体;
- 是否抓住了毛巾的边缘;
- 倒水时杯口是否保持在合适姿态。
其余很多动作状态并不要求逐 token 达到绝对最优,只要落在“足够好”的动作区域内,任务仍然可以成功。
因此,CEED-VLA 设置一个退出点 σ:迭代达到 σ 步后,不再等待严格固定点,直接输出当前中间结果。
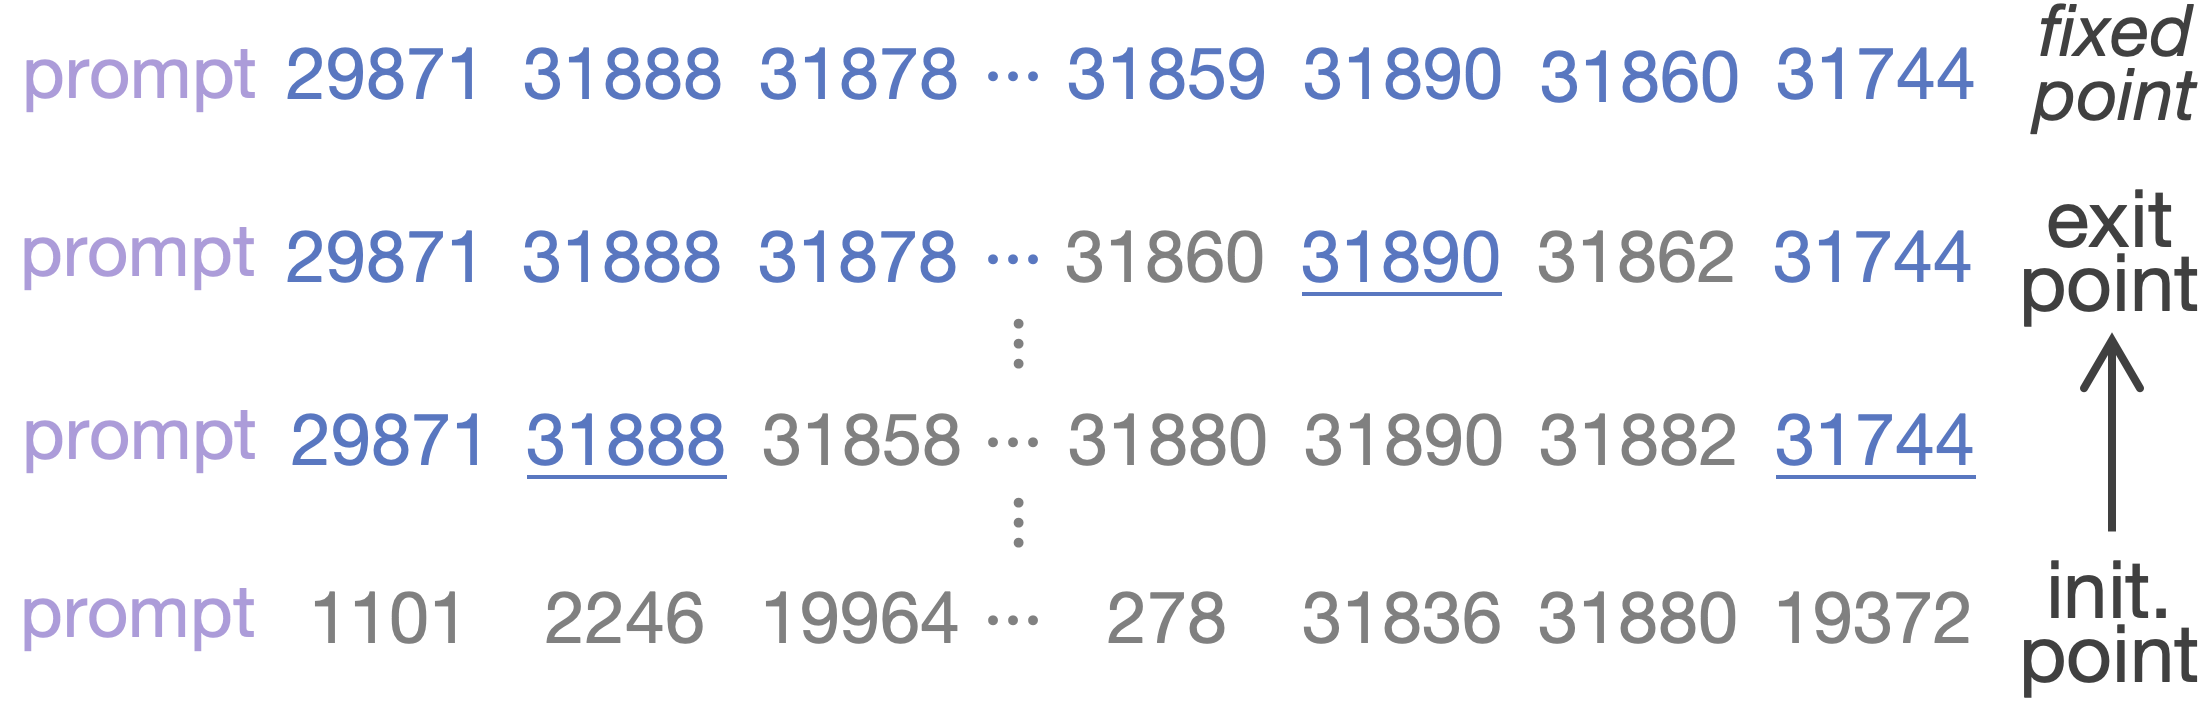
图7 带早退出的 Jaco-bi 轨迹示例
图中的关键点是:退出点的结果不一定等于传统 Jaco-bi 的最终固定点。 CEED-VLA 有意接受这个小差异,换取更少的迭代次数。
八、退出点不是越小越好:CEED-VLA 和 Turbo 的区别
论文对不同退出点进行了分析:
- 退出点为 16 时,CEED-VLA 在速度和成功率之间取得较好平衡;
- 退出点降到 8 时,速度更快,但性能会出现一定下降,论文将这个版本称为 CEED-VLA-Turbo;
- 退出点降到 4 时,速度虽然继续提升,但动作质量明显下降,任务成功变得困难。
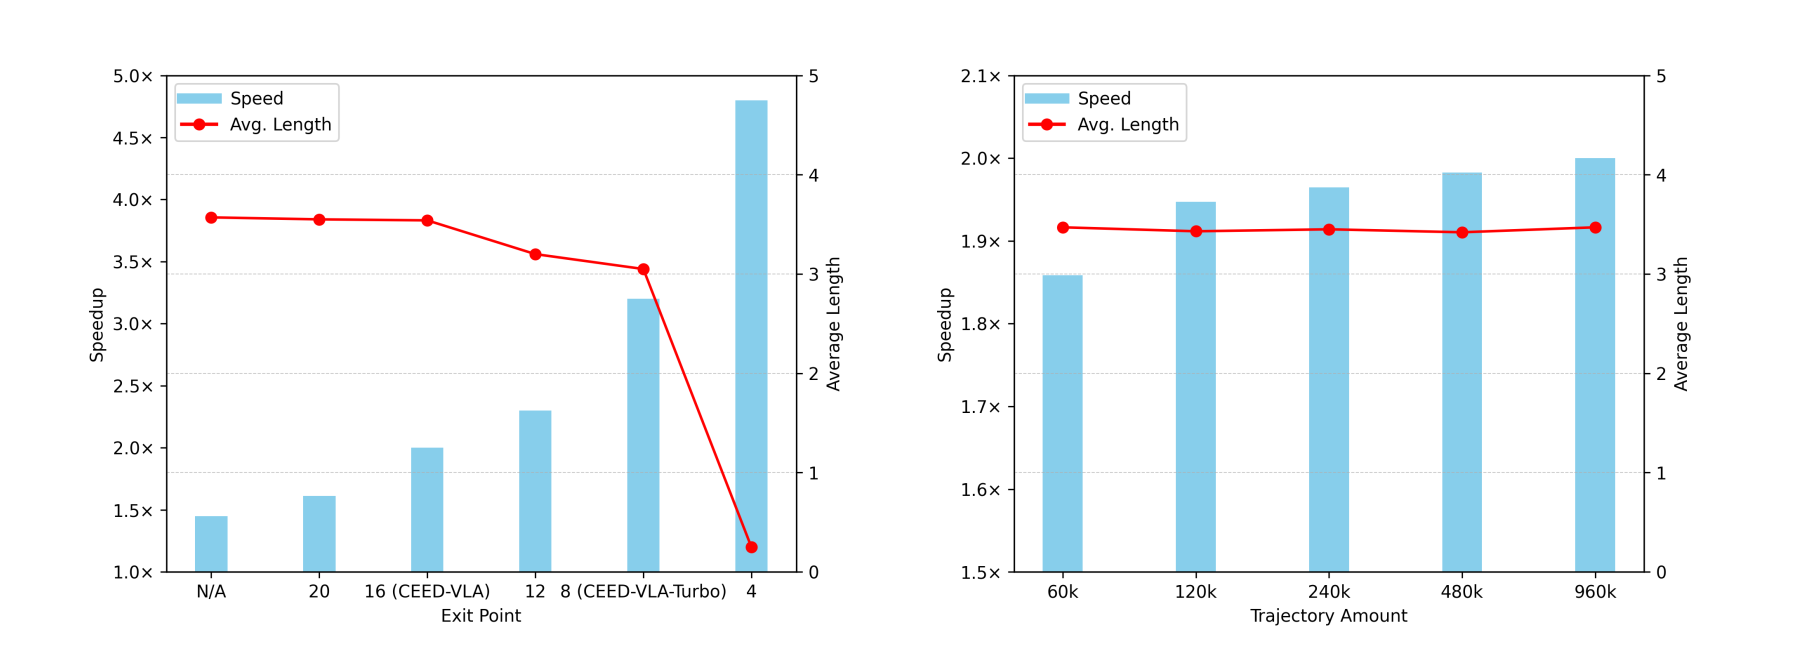
图8 不同退出点和训练轨迹数量下的速度与平均完成长度
这张图说明一个很实用的工程事实:早退出不是简单把迭代次数砍到最小,而是要根据任务容错性选择退出点。
训练数据也不是越多越好
在轨迹数量方面,论文观察到:
- 60k 条轨迹已经足以产生明显加速;
- 超过 120k 条轨迹后,收益开始趋于饱和;
- 继续增加到 240k、480k、960k,对平均完成长度的影响有限。
这意味着一致性蒸馏的训练数据效率相对较高。论文还报告,使用这些轨迹训练一个 epoch 约需 10 小时,但具体时间取决于硬件和实现配置,不能直接当成普适训练时长。
九、实验结果:加速是否真的转化成了更好的机器人动作?
1. OpenVLA + LIBERO-Long:4.1× 解码速度,25.60 Hz 执行频率
在 OpenVLA 基座上,论文比较了标准 AR、带 action chunking 的 AR、PD-VLA 和 CEED-VLA:
| 方法 | 解码方式 | 速度(tokens/s) | 成功率(%) | 执行频率(Hz) |
|---|---|---|---|---|
| OpenVLA | AR | 54.4 | 53.2 | 5.95 |
| OpenVLA + action chunking | AR | 54.4 | 60.4 | 7.08 |
| PD-VLA | Jaco-bi | 85.0 | 62.4 | 10.79 |
| CEED-VLA | Jaco-bi + 一致性 + 早退出 | 225.0 | 62.2 | 25.60 |
这里最值得关注的不是成功率从 62.4% 变成 62.2%,而是:在几乎保持相同任务表现的情况下,解码速度从 85 tokens/s 提升到 225 tokens/s,执行频率从 10.79 Hz 提升到 25.60 Hz。
论文还指出,action chunking 本身会提升动作的连续性和规划能力,因此速度和成功率不能只看单一解码器因素。
2. LLaVA-VLA + CALVIN:2.0× 解码加速
在 LLaVA-VLA + CALVIN ABC→D 设置下,结果为:
| 方法 | action chunking | 解码方式 | 速度(tokens/s) | 平均完成长度 | 执行频率(Hz) |
|---|---|---|---|---|---|
| LLaVA-VLA | — | AR | 39.6 | 2.01 | 2.23 |
| LLaVA-VLA | 5 | AR | 39.6 | 3.70 | 4.33 |
| PD-VLA | 5 | Jaco-bi | 52.8 | 3.69 | 5.43 |
| CEED-VLA | 5 | Jaco-bi | 79.2 | 3.67 | 7.27 |
这里的加速比 OpenVLA 版本低,论文给出的解释是:CALVIN ABC→D 包含更长、更复杂的五段式任务,需要更谨慎地规划和迭代,因此 Jaco-bi 轨迹本身更难快速收敛。
这也是一个重要提醒:加速效果与任务难度、动作序列长度和基座模型的 Jaco-bi 可收敛性有关。
十、消融实验:真正贡献最大的不是一个单点技巧
在 OpenVLA action chunk=3 上,论文给出了下面的组合消融:
| 模型/设置 | Jaco-bi | 一致性训练 | 混合标签 | 早退出 | 加速比 | 准确率(%) |
|---|---|---|---|---|---|---|
| OpenVLA | ||||||
| 1.0× | 60.4 | |||||
| PD-VLA | ✓ | |||||
| 1.6× | 62.3 | |||||
| CEED-VLA 去掉混合标签 | ✓ | ✓ | ||||
| 2.3× | 54.2 | |||||
| CEED-VLA 去掉早退出 | ✓ | ✓ | ✓ | |||
| 2.5× | 61.2 | |||||
| CEED-VLA 完整版 | ✓ | ✓ | ✓ | ✓ | 4.1× | 62.2 |
这个结果把方法拆得很清楚:
- 只有 Jaco-bi,已经能带来一定加速,但还不够;
- 一致性训练让模型真正学会多 token 并行修正;
- 混合标签主要负责守住动作质量;
- 早退出进一步清除严格收敛带来的低收益尾迭代。
十一、固定 token:CEED-VLA 为什么能一次改对更多位置?
论文进一步分析了 Jaco-bi 轨迹中的 fixed tokens:某些 token 在一轮迭代后已经正确,并且后续不会再变化。固定 token 越多,每次迭代真正需要修正的内容就越少,也越容易快速达到稳定结果。
在 profiling 实验中,论文报告:
| 模型 | 平均固定 token 数量 | 加速比 |
|---|---|---|
| LLaVA-VLA | 0 | 1.00× |
| PD-VLA | 8.75 | 1.33× |
| CEED-VLA | 13.5 | 2.00× |
这可以看作 CEED-VLA 的底层机制证据:它不是单纯减少了循环次数,而是提高了每一轮真正“固定”正确 token 的数量。
十二、真实机器人实验:速度最终变成了动作连续性
论文使用双臂 AgileX PiPer 系统进行真实世界实验,配置包括:
- 两个 AgileX PiPer 6-DoF 机械臂;
- ORBBEC Dabai 深度相机作为第一视角输入;
- RealSense L515 深度相机作为第三视角输入;
- 一只机械臂由人类遥操作采集示范,另一只作为跟随臂执行 VLA 动作。
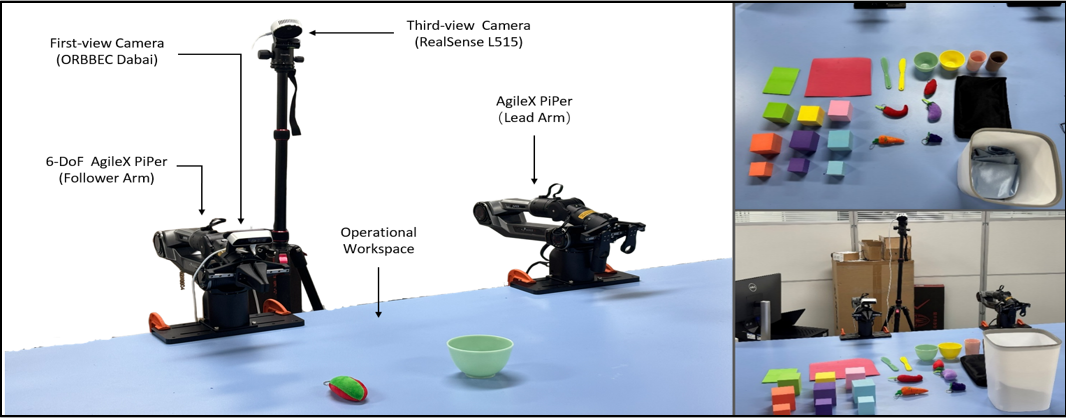
图9 真实世界机器人实验系统
真实世界结果如下,表中每个任务包含 20 个变体、每个变体进行一次评测:
| 方法 | 按钮推动 | 抬起方块 | 倒水 | 折毛巾 | 平均成功率 | 频率 |
|---|---|---|---|---|---|---|
| LLaVA-VLA | 65% | 40% | 15% | 5% | 33.25% | 3.3 Hz |
| PD-VLA | 85% | 65% | 45% | 35% | 57.50% | 6.0 Hz |
| CEED-VLA | 85% | 70% | 80% | 75% | 77.50% | 13.0 Hz |
这个结果很有代表性:CEED-VLA 的提升主要集中在高频灵巧任务上。
- 按钮推动和抬起方块属于相对基础的动作,低频模型也能完成一部分;
- 倒水和折毛巾需要连续、细粒度的控制,低频和不连续动作更容易失败;
- CEED-VLA 把执行频率从 3.3 Hz 提高到 13.0 Hz,同时让动作更平滑,因而显著提升了灵巧操作成功率。
因此,这篇论文的真实价值不只是“tokens/s 更高”,而是证明了:解码加速可以直接改善机器人动作的时间连续性。
十三、官方代码现在能不能直接跑?
可以跑一部分,但不能把论文完整方法当成已经全部开源。
截至 2026-09-01,官方 GitHub 仓库明确说明:目前只开放了基于 OpenVLA 的、不包含一致性训练的版本;一致性训练代码、Jaco-bi 轨迹生成代码和 LLaVA-VLA 版本仍计划后续发布。
所以当前仓库更适合:
- 查看 OpenVLA 的 Jaco-bi 解码实现;
- 配置 LIBERO 环境;
- 运行仓库已提供的评测脚本;
- 复现仓库 README 中列出的基础结果。
它不等于已经公开了论文中完整的 CEED-VLA 训练流程。尤其是论文最关键的:
Jaco-bi trajectory collection
→ consistency distillation
→ mixed-label supervision
→ early-exit student model
目前还不能仅靠仓库一键重新训练出来。
Quick Start:当前公开仓库的最小复现路径
官方 README 给出的路线是:
conda create -n openvla python=3.10 -y
conda activate openvla

# 根据自己的 CUDA / PyTorch 平台选择安装命令
conda install pytorch torchvision torchaudio pytorch-cuda=12.4 \
  -c pytorch -c nvidia -y

git clone https://github.com/OpenHelix-Team/CEED-VLA.git
cd CEED-VLA
pip install -e .

git clone https://github.com/Lifelong-Robot-Learning/LIBERO.git
cd LIBERO
pip install -e .
仓库 README 还提供了 LIBERO 评测脚本入-口:
bash ./vla-scripts/eval/run_eval_libero_10_Jaco-bi_kv.sh
说明:当前仓库 README 的安装片段里仍写着 cd openvla,但上一步克隆的是 CEED-VLA 仓库;按当前目录结构,实际应进入 CEED-VLA 再执行安装。后续依赖和 checkpoint 仍应以仓库最新 README 为准。
需要注意:PyTorch、FlashAttention、CUDA 和 LIBERO 的安装会受到显卡、驱动和系统版本影响;官方 README 中的 PyTorch 命令本身也标注了需要根据平台更新,不能机械复制到所有机器。
十四、CEED-VLA 适合什么场景?不适合什么场景?
适合
- 已经有一个离散 action-token VLA,想减少推理延迟;
- 需要更高控制频率的机器人操作任务;
- 动作序列存在一定容错空间,不要求每个 token 都严格等于唯一答案;
- 希望尽量不改动 VLA 主体结构,通过训练和解码策略获得加速;
- 有离线机器人示范数据,可以额外收集 Jaco-bi 迭代轨迹。
不适合或需要谨慎
- 连续动作空间中没有清晰的离散收敛条件;
- 任务对每一步动作都极其敏感,不能接受中间结果近似;
- 没有足够的示范数据,也无法运行教师模型收集 Jaco-bi 轨迹;
- 只看平均 tokens/s,却没有验证真实控制频率、动作连续性和任务成功率;
- 直接把论文结果迁移到不同基座模型、不同 action tokenizer 或不同硬件上。
论文也明确指出,当前方法更容易应用于离散动作表示;对于连续动作空间,收敛条件更难定义,是后续需要解决的限制。
十五、如果把它接入自己的 VLA,我会怎么做?
建议按下面的顺序推进:
先对现有 VLA 做 AR 基线
        ↓
实现不训练的 Jaco-bi 解码
        ↓
统计每轮固定 token 数量与迭代次数
        ↓
收集 Jaco-bi 轨迹
        ↓
先只加入一致性损失
        ↓
加入 L1 阈值控制的混合标签监督
        ↓
扫描退出点 σ = 4 / 8 / 16 / 完全收敛
        ↓
用真实机器人验证频率、连续性和成功率
这里最重要的工程指标不应该只有 speedup,还应该同时记录:
- 每轮 forward 延迟;
- 平均与最小迭代次数;
- fixed token 数量;
- action chunk 长度;
- 实际控制频率;
- 动作抖动与时间连续性;
- 关键任务成功率;
- 早退出后失败发生在哪些状态。
尤其不要一开始就把退出点设得很小。更稳妥的做法是先用完整收敛结果作为参考,再根据任务对中间误差的容忍度逐步缩短退出点。
十六、这篇论文真正带来的启发
CEED-VLA 的贡献可以概括成三句话:
- Jaco-bi 解码的瓶颈不只在并行算法本身,还在于原始 AR 训练方式没有教会 VLA 如何处理错误前缀。
- 一致性蒸馏把“从中间状态到固定点”的能力写进了模型参数,混合标签则防止这个过程偏离真实机器人动作。
- 机器人任务的成功标准不是每个 token 都要完全收敛,因此早退出可以把一部分低收益计算换成更高的控制频率。
它和重新训练一个更小的 VLA 不同:CEED-VLA 试图保留原有 VLA 的视觉理解和操作能力,只改变“如何学会快速收敛”和“什么时候停止等待”。
从更大的研究趋势看,这条路线也说明了 VLA 加速正在从单纯的工程优化,走向训练目标与解码策略联合设计:模型不仅要会输出正确动作,还要学会以适合机器人控制的方式尽快输出足够好的动作。
Great breakdown! Tackling the error prefix bottleneck via consistent distillation avoids closed-loop instability. Prioritizing high control frequency over absolute step convergence is key. In advanced control architectures, applying an adaptive threshold under delay conditions handles early exits smoothly without losing actuator command. Excellent co-design strategy!