
一个 Token,决定何时请大模型接手:PyroDash 如何把大小模型协同做到推理中途
论文:PyroDash: Cost-Efficient Token-Level Small-Large Language Model Collaborative Inference
作者:Niqi Lyu、Pengtao Shi、Wei Qiu、Jianlin Zhong、Sicong Xia、Jianyao Ma、Yicheng Ding
机构:Pyromind Dynamics Inc.
版本:arXiv:2607.20327v1,2026 年 7 月 22 日
方向:小—大语言模型协同推理、Token-Level Routing、GRPO、推理成本优化
如果一项任务,小模型能解决 80%,只有最后 20% 真正困难,我们是否还需要从第一个 token 开始就调用大模型?
传统模型路由通常在生成前做决定:先判断问题难不难,再把整条请求交给小模型或大模型。但问题是,很多任务并不是一眼就能判断难度。题目可能看起来简单,真正的能力边界却在第三步推导、一次单位换算,或者某个组合讨论中才暴露。
PyroDash 把问题重新定义为:
不再只问“这道题该由哪个模型回答”,而是问“小模型推理到哪一步,才值得把剩余工作交给大模型”。
它让小模型在生成过程中自行输出一个控制 token:<|llm_offload|>。协同引擎检测到它后,停止小模型解码,把原问题和已经生成的局部推理轨迹打包给大模型,由大模型继续完成答案。整个过程最多交棒一次,不需要额外训练一个 Router,也不需要访问大模型的 logits 或隐藏状态。
这就是 PyroDash 最核心的贡献。
一、先用一张图看懂:它到底改变了什么?
请求级路由只能利用输入问题做判断。PyroDash 则把“小模型已经推到哪里、当前生成轨迹呈现出什么状态”也变成决策依据。
它的优势并不是把两个模型频繁交替调用,而是保留一个非常克制的执行结构:
用户问题
  ↓
小模型开始生成
  ├── 没有生成 <|llm_offload|> → 小模型独立完成
  └── 生成 <|llm_offload|>
          ↓
      停止小模型
          ↓
      打包「原问题 + 小模型前缀」
          ↓
      大模型一次性续写到答案
这里有三个关键词:
- SLM-first:所有请求默认从小模型开始。
- Token-level self-routing:是否交棒,由小模型在生成 token 时自己决定。
- Single handoff:一旦切到大模型就不再切回,单条请求最多调用大模型一次。
二、PyroDash 的推理架构:小模型不是草稿机,而是第一棒选手
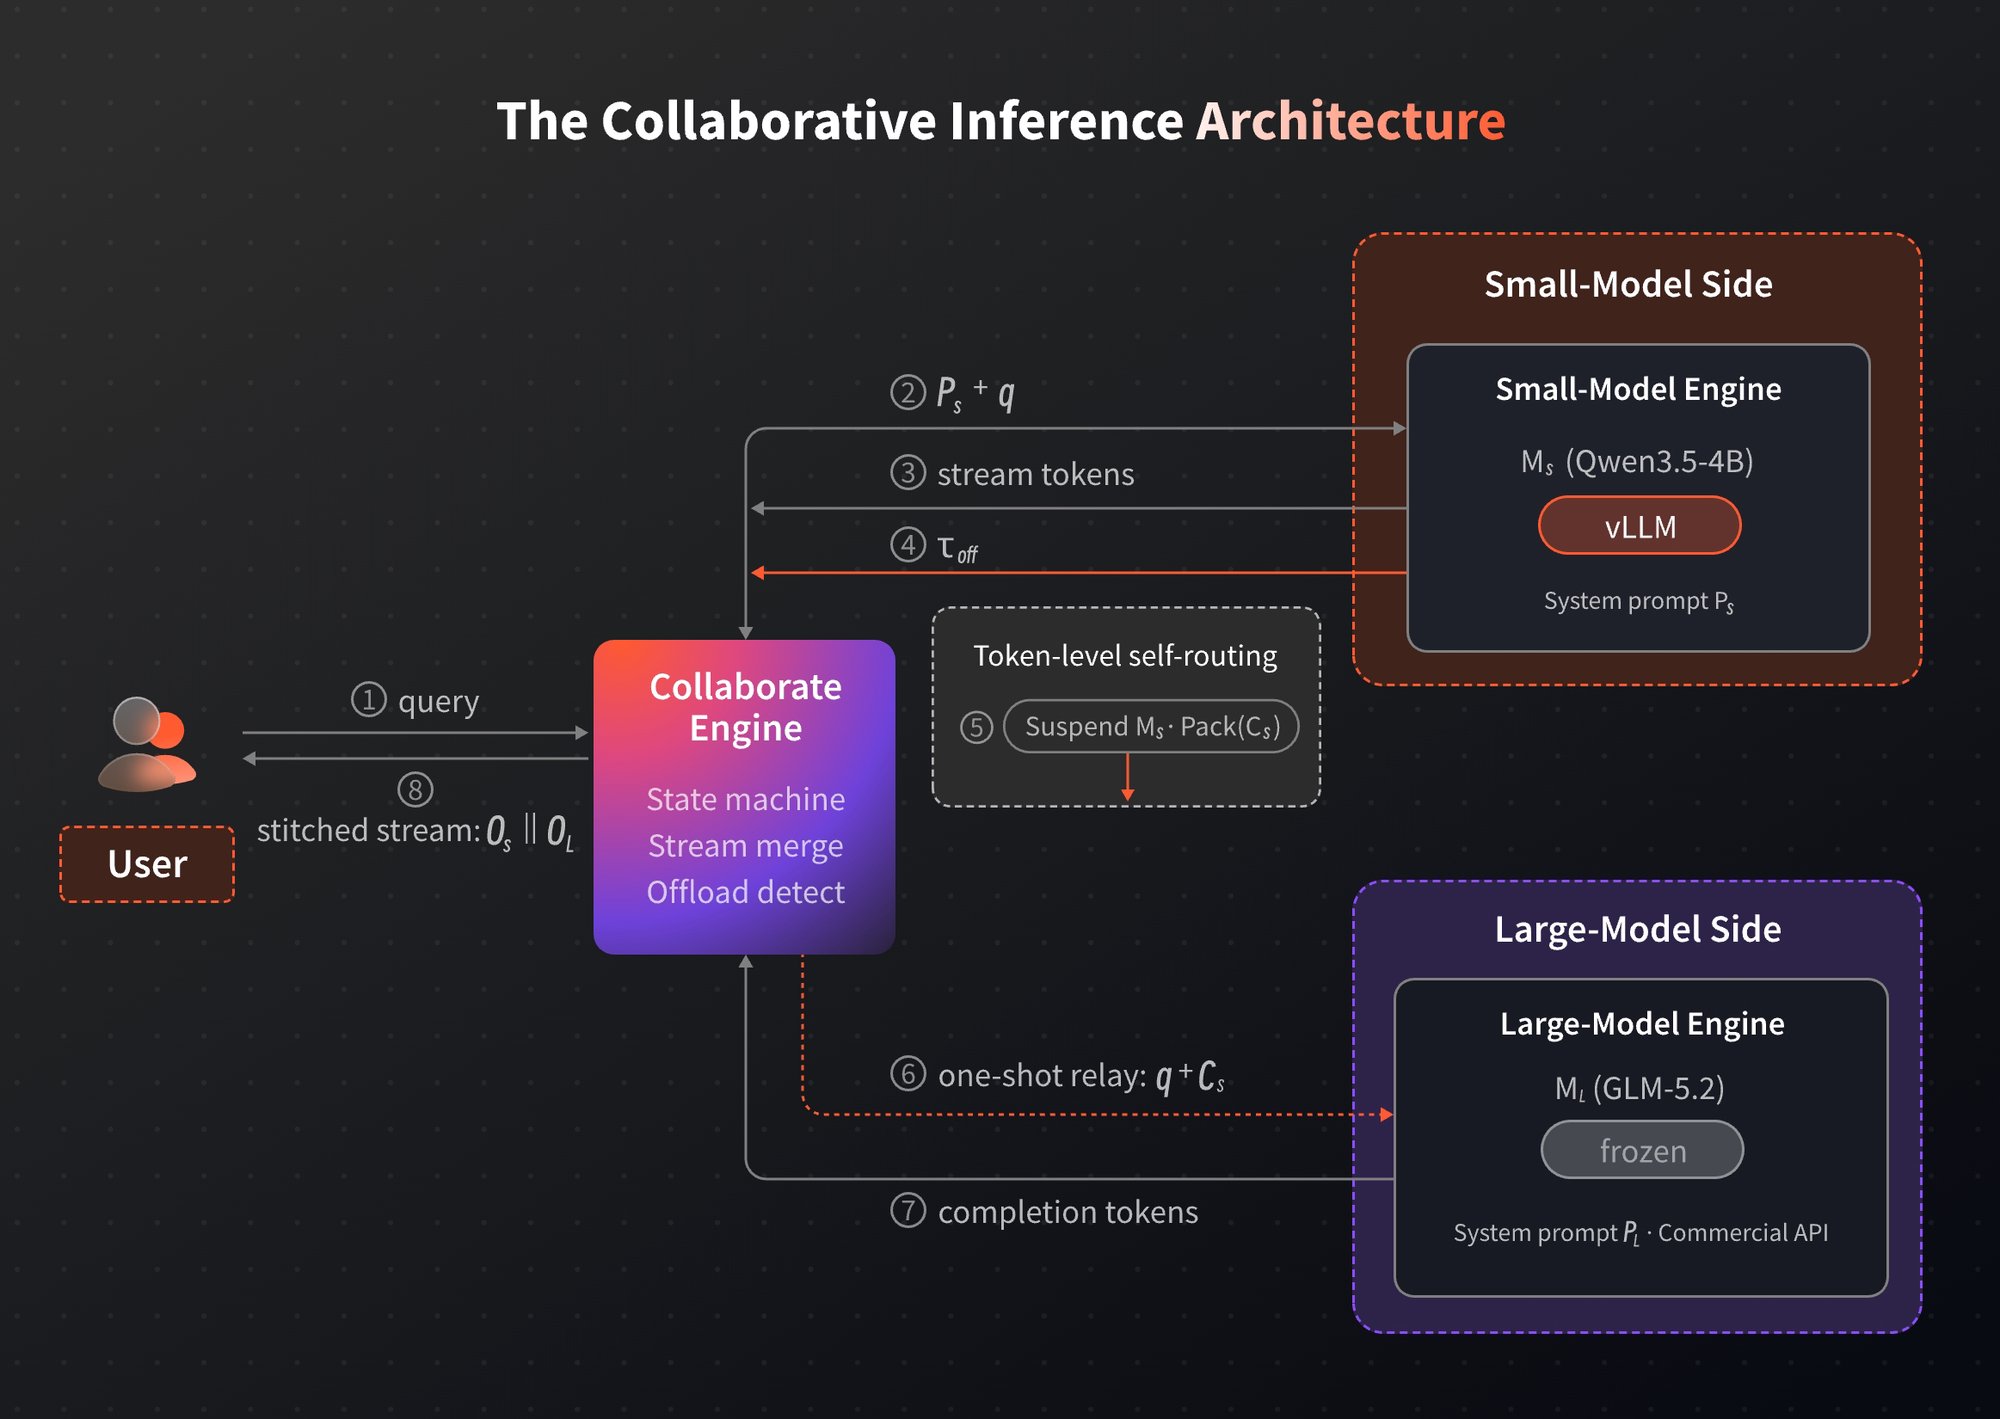
图 1:PyroDash 协同推理架构
论文将系统拆成三个组件:
- SLM Engine:承载训练后的 Qwen3.5-4B,负责默认推理和触发交棒。
- LLM Engine:承载冻结的 GLM-5.2-FP8,收到请求后完成剩余推理。
- Collaborate Engine(CE):监听生成流、识别控制 token、整理上下文并调用大模型。
CE 本身并不判断问题难度。真正的路由策略已经内化进小模型。CE 做的事情更像一个确定性的协议执行器:
监听 token → 发现 offload → 截断 → Pack → 调用 LLM → 拼接输出
假设小模型已经生成前缀 Os。当 <|llm_offload|> 出现时,CE 会移除这个控制符,将前缀整理为 Cs,再用以下内容调用大模型:
大模型提示词 Pl
+ 原始问题 q
+ 小模型局部轨迹 Cs
大模型返回后续内容 Ol,最终结果是小模型前缀与大模型续写的拼接:
O = Os + Ol
这和 speculative decoding 有本质区别。推测解码中的小模型通常负责“猜”,大模型仍需验证候选 token,目标是加速且保持目标模型分布;PyroDash 允许小模型独立完成整条请求,大模型只在触发后出现,优化目标是答案质量与调用成本,而不是无损复现大模型输出。
同时,它也不同于反复在两个模型之间切换的 token-level 系统。一次性交棒牺牲了一部分调度灵活性,却换来了三项很实际的工程优势:
- 无需在每个 token 上额外运行 Router;
- 不需要维护反复切换时两套模型的解码状态;
- 可以直接把大模型接成普通的生成 API,甚至是闭源服务。
但“一次性交棒”也意味着,只要切到大模型,后面的内容全部由大模型生成,小模型不会重新接管。这是它降低系统复杂度的关键,也是能力上限之一。
三、难点不在识别控制符,而在教会小模型“什么时候交棒”
只在词表里加入 <|llm_offload|> 并不够。
未经训练的小模型既不知道这个 token 代表什么,也不知道哪些问题该独立完成、哪些问题需要协作,更不知道在哪个推理位置交棒最划算。
PyroDash 因此设计了一个三阶段训练流程。

图 2:PyroDash 三阶段渐进式训练流程
阶段 0:先构造 EasyHard-24K
训练从数据分流开始。作者用基础小模型跑候选样本:
- 小模型答对的样本归入 Easy;
- 小模型答错、但能够重建出正确推理轨迹的样本归入 Hard。
论文最终构建了 24,061 条 EasyHard-24K 数据。这个“难”不是由题目所属 benchmark 静态决定,而是相对于当前基础小模型的能力定义:同一道题换一个更强的小模型,Easy/Hard 划分可能就会改变。
作者又构造了两类训练语料:
- Corpus A:不启用协同提示词,所有答案都不出现 offload token,用于保留普通的小模型推理能力。
- Corpus B:启用协同提示词;Easy 样本仍由小模型完整回答,Hard 样本的正确推理链中插入 1~4 个候选 offload token。
这里需要特别注意:这些插入位置只是给监督训练提供冷启动,并不被作者视为真正最优的能力边界。最终的交棒时机还要由第三阶段根据完整协同结果重新学习。
阶段 1:先让新 token 在模型里“有位置”
<|llm_offload|> 是新加入词表的特殊 token。若完全随机初始化,它在训练初期很容易出现预测不稳定。
作者选择句号、换行、序列结束符等“自然断点 token”,取它们 embedding 的均值并加入少量高斯噪声,以此初始化 offload token。随后更新 embedding、输出头和临时 LoRA,训练结束后丢弃临时 LoRA,只保留新 token 对应的参数行。
这一步解决的是:
让模型先学会表达“我要交棒”这个动作,而不是一上来就要求它学会复杂的交棒策略。
阶段 2:用 SFT 建立两条基本行为
第二阶段混合训练 Corpus A 与 Corpus B,让同一个小模型同时学会:
- 没有协同提示时,保持普通推理;
- 启用协同提示后,简单题自己完成,困难题能够输出 offload token。
这一阶段使用监督微调建立“行为冷启动”。它可以让 offload 发生,却还不能保证:交棒一定能提高最终正确率,也不能保证这一调用在经济上值得。
阶段 3:用 GRPO 学习准确率—成本权衡
第三阶段才是 PyroDash 的方法核心。训练环境真正执行协同推理:小模型生成多条 rollout;遇到 offload token,就调用冻结的大模型完成答案;最后依据答案是否正确和整条轨迹消耗的 token 成本给分。
论文的奖励可以直观写成:
总奖励 = 答案正确性 − λ ×(本次协同成本 / 同题纯 LLM 成本)
这里的成本不只计算大模型输出。小模型生成的前缀随后会成为大模型输入,因此前缀越长:
- 小模型已经付出的解码成本越高;
- 大模型接手时的 prefill 输入也越长。
这会自然惩罚“先让小模型写很久,最后还是把整段内容交给大模型”的低效策略。
λ 决定系统有多在意成本:
- λ 小:更重视答对,允许频繁调用大模型;
- λ 大:更重视节省,大模型只有在收益足够高时才值得调用。
不过,论文里的 λ 不是部署时可直接拖动的实时旋钮。不同 λ 对应的是不同训练策略和模型检查点。若想在线动态调节,仍需要加载不同模型,或进一步训练一个条件化策略。
GRPO 更新的只有小模型生成的 token。大模型始终冻结,它的输出只通过“最终是否答对”和“花了多少钱”影响奖励,不进入梯度路径。
四、实验怎么做:先把“省成本”这件事算清楚
论文在五个数学推理 benchmark 上评测:
- Minerva
- GSM8K
- OlympiadBench
- AIME 2025
- AIME 2024
模型组合为:
- 小模型:Qwen3.5-4B
- 大模型:GLM-5.2-FP8
训练阶段,EasyHard-24K 用于前两阶段,DAPO-Math 用于 GRPO。训练在 4 张 NVIDIA H100 上进行;服务评测时,Qwen3.5-4B 使用 4 张 H100,GLM-5.2-FP8 使用 8 张 B200,并通过 vLLM 部署。
成本按论文列出的 token 单价估算:
| 模型 | 输入价格 | 输出价格 |
|---|---|---|
| Qwen3.5-4B | $0.05 / 百万 token | $0.08 / 百万 token |
| GLM-5.2-FP8 | $0.90 / 百万 token | $2.86 / 百万 token |
因此,论文中的“Cost”主要指按 token 定价推算的服务账单,不等同于实测 GPU 电费、服务器折旧或端侧能耗。
五、主结果:96.4% 很亮眼,但 λ=0.1 可能更值得看
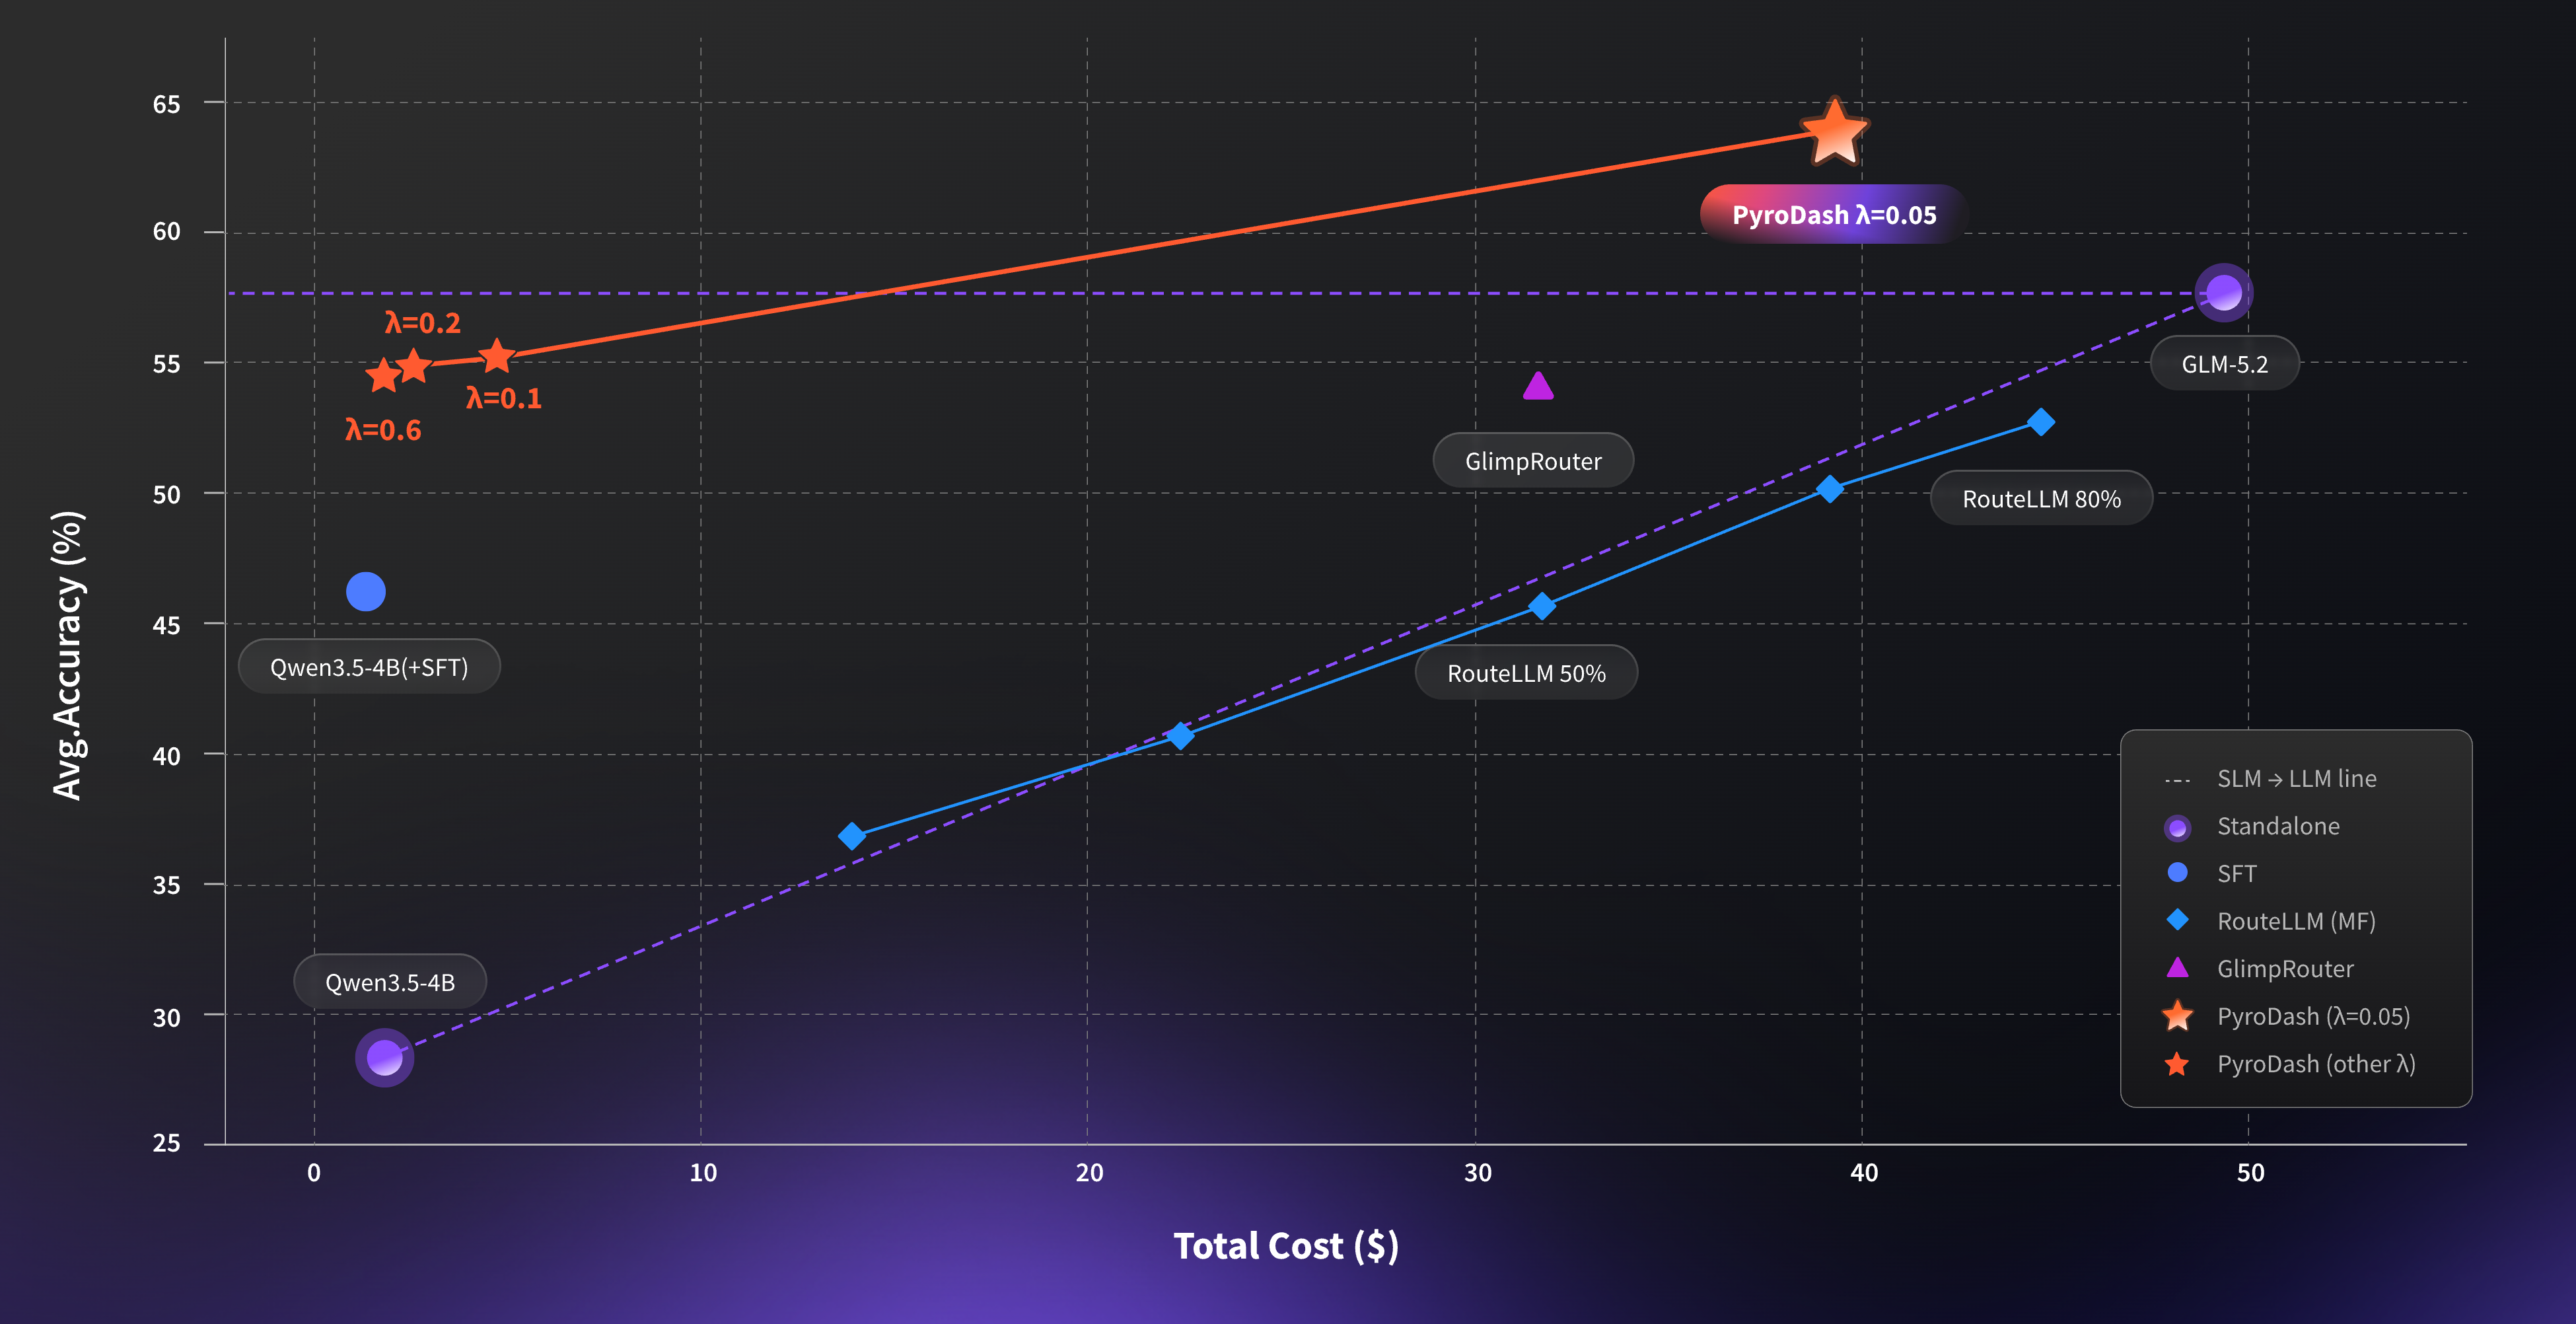
图 3:五个数学 benchmark 上的成本—准确率关系
论文给出了多个 λ 下的工作点:
| 配置 | 平均准确率 | LLM Token 比例 | 每题平均 LLM 调用 | 总成本 |
|---|---|---|---|---|
| Qwen3.5-4B | 28.36% | 0% | 0 | $2.26 |
| Qwen3.5-4B + SFT | 46.25% | 0% | 0 | $1.32 |
| RouteLLM | 52.74% | 77.37% | 0.808 | $44.62 |
| GlimpRouter | 54.20% | 75.11% | 1.20 | $31.61 |
| PyroDash,λ=0.05 | 64.04% | 95.34% | 0.975 | $39.29 |
| PyroDash,λ=0.1 | 55.29% | 8.19% | 0.058 | $4.71 |
| PyroDash,λ=0.6 | 54.55% | 1.90% | 0.012 | $1.78 |
| GLM-5.2-FP8 | 57.68% | 100% | 1.000 | $49.36 |
1. λ=0.05:质量优先,甚至超过纯大模型
PyroDash 达到 64.04% 平均准确率,比 GLM-5.2-FP8 单独推理的 57.68% 高 6.36 个百分点,同时成本从 $49.36 降至 $39.29,降低约 20.4%。
但这个配置的 LLM Token 比例达到 95.34%,每题平均调用 0.975 次。也就是说,它几乎每道题都会交给大模型,而且大部分输出 token 仍来自大模型。这个工作点证明的是:
小模型提供的局部推理前缀,有可能成为大模型的有效脚手架,协同结果不一定只是纯 LLM 的廉价近似。
不过,论文没有进一步消融“为什么协同能够超过纯 GLM-5.2”。一个合理推测是,小模型前缀改变了后续解题路径,形成了类似多阶段推理的增益;但在缺少更多控制实验前,不能把它写成已经被证明的机制。
2. λ=0.6:极限成本优先
这个配置只有 1.90% 的 LLM Token 比例,每题平均调用 0.012 次,总成本从 $49.36 降至 $1.78,即论文所说的 96.4% 成本降低。
平均准确率为 54.55%,比纯 GLM-5.2 低 3.13 个百分点,但略高于 RouteLLM 的 52.74% 和 GlimpRouter 的 54.20%。
从调用次数理解更直观:0.012 次/题意味着实验中只有约 1.2% 的样本触发大模型。这个策略已经非常接近“强化后的小模型独立完成,极少数情况才升级”。
3. λ=0.1:更像实际系统的甜点位
λ 从 0.05 提高到 0.1 后:
- LLM Token 比例:95.34% → 8.19%
- 每题调用:0.975 → 0.058
- 成本:$39.29 → $4.71
- 准确率:64.04% → 55.29%
相对纯 LLM,成本减少约 90.5%,准确率下降 2.39 个百分点;同时准确率仍高于两个路由基线。若目标不是冲最高分,而是为高频服务寻找质量与账单之间的平衡,λ=0.1 反而可能是更有讨论价值的工作点。
更有意思的是:当 λ 从 0.1 继续提高到 0.6,LLM Token 比例继续从 8.19% 降至 1.90%,但准确率只从 55.29% 降到 54.55%。这说明在当前实验里,策略确实学会删掉了一批收益很低的大模型调用。
六、一次真实交棒是什么样?
论文用一道 GSM8K 题展示了执行轨迹:种下一棵柠檬树需要 90 美元,每年产 7 个柠檬,每个卖 1.5 美元,每年维护成本 3 美元,问第几年开始真正盈利。
小模型先算出年净收入:
7 × 1.5 − 3 = 7.5 美元
随后输出 <|llm_offload|>。大模型接着这一步推理:
7.5 × n > 90
所以 n > 12。第 12 年只是收回成本,第 13 年才首次出现正利润。
这个例子很好地说明了 PyroDash 想实现的角色分工:小模型并非什么都不做,而是先完成问题转写或局部化简;一旦后续推导超出策略判断的能力边界,再把已经获得的中间结果交给大模型。
但它也暴露出一个研究空白:论文只展示了几条成功案例,没有系统验证 offload 位置是否真的对应模型不确定性、逻辑错误或能力边界。作者也在 Limitations 中承认,当前评测没有分析单次交棒决策的合理性。
七、它和 Router、Token 协同、推测解码到底有什么不同?
| 路线 | 什么时候决策 | 谁决策 | 模型切换 | 主要目标 |
|---|---|---|---|---|
| 请求级 Router | 生成前 | 外部路由器 | 选一个模型 | 整体成本与质量 |
| CITER / Co-LLM / RelayLLM 类方法 | 生成过程中 | Router 或联合策略 | 可细粒度、多次 | 细粒度能力分配 |
| 推测解码 | 解码过程中 | 接受/拒绝机制 | 大模型持续验证 | 延迟与吞吐 |
| PyroDash | 生成过程中 | 小模型控制 token | SLM→LLM 最多一次 | 答案准确率与 token 账单 |
PyroDash 的取舍非常明确:
- 它没有多次切换那么灵活,却更容易接入标准 API;
- 它不像推测解码那样保证复现大模型分布,却能让简单请求完全绕过大模型;
- 它比请求级 Router 更晚做决定,却必须先承担一段小模型生成成本。
所以它不是“所有协同推理方案的替代品”,而是面向 本地小模型默认服务 + 云端大模型按需接力 这一部署形态的专门设计。
八、当前开源、Quick Start 与 Agentic-Preview 版本差异
截至 2026 年 9 月 13 日,项目已经公开:
- 数学评测代码;
- EasyHard-24K 数据集;
- SFT、GRPO λ=0.05、GRPO λ=0.6 等模型检查点;
- 项目主页和实验结果。
仓库提供的最小评测流程是:
git clone https://github.com/PyroMind-Dynamics/PyroDash.git
cd PyroDash
pip install -r requirements.txt
填写 evaluation/evaluation_math/math_eval.sh 中的小模型路径、大模型 OpenAI-compatible endpoint、API Key 和模型名后执行:
bash evaluation/evaluation_math/math_eval.sh
脚本会在 8001 端口启动本地小模型的 vLLM 服务,运行数学评测,并在结束后关闭服务。Tokenizer 必须包含 <|llm_offload|>。
但这还不是完整的一键复现。项目 README 明确标注:数学评测闭环基本完成,独立 Collaborate Engine 与端到端一键复现仍在推进。因此,现阶段更准确的表述是“模型、数据与数学评测代码已开放”,而不是“生产级协同推理框架已经成熟”。
另外,仓库 2026 年 9 月 1 日新增的 Agentic-Preview 已经发生两项重要变化:
- 控制符从论文版单一的
<|llm_offload|>,升级为<|llm_offload|>N<|/llm_offload|>,其中 N 为 0~9 的思考等级; - 第二阶段从 offload SFT 升级为
SFT + OPD,并开始面向 agentic coding 轨迹训练。
仓库报告其在 SWE-Bench Verified 预览实验中节省约 20% 成本、准确率下降约 5%,但明确标注为早期结果。它不属于 arXiv v1 的数学推理实验,不能与论文表格直接合并比较。
九、这篇论文最需要冷静看的七个问题
1. “成本降低 96.4%”不是 GPU 系统成本实测
成本来自预设的 token 单价换算,不是实际云账单,也没有计入 GPU 利用率、跨机通信、队列等待、KV Cache、服务空载和运维成本。
2. 没有报告端到端延迟
论文没有给出首 token 延迟、交棒停顿、P50/P95 延迟或并发吞吐。SLM 先生成、再把前缀重新作为 LLM 输入,会引入额外 prefill 和网络往返。省钱不自动等于更快。
3. 隐私收益是条件性的
只有未触发 offload 的请求能够完全留在本地。一旦交棒,原始问题和小模型前缀都会发送给大模型端点。实际系统仍需要脱敏、权限和数据出境策略。
4. λ 目前不是运行时旋钮
论文展示的是多个分别训练的策略。业务在“质量优先”和“成本优先”之间实时切换时,需要维护多个模型检查点,或重新设计可条件控制的策略。
5. 只验证了一个模型组合和数学领域
Qwen3.5-4B + GLM-5.2-FP8 在数学任务上的结论,不能直接外推到代码 Agent、长文写作、工具调用、多模态理解或机器人控制。
6. 没有系统证明交棒点真的合理
作者没有分析 offload token 与熵、错误步骤、任务阶段或模型置信度之间的关系,也没有与 oracle handoff 做距离比较。
7. 基线还不够完整
主实验直接比较了 RouteLLM 与 GlimpRouter,但没有对 CITER、Co-LLM、RelayLLM 等 token-level 协同方法做端到端实证比较。PyroDash 的系统简洁性很清楚,但 token 级 Pareto 优势还需要更全面的同类实验支撑。
十、对“本地小模型 + 云端强模型”Agent 架构有什么启发?
PyroDash 与本地 Agent 的现实需求非常契合:大量文件检索、格式转换、简单问答由本地小模型处理;涉及复杂推理、长链规划或高风险操作时,再升级到云端强模型。
如果把论文思想落到生产 Agent,我会做三点调整。
第一,不直接把不可控的完整思维链当作交接材料,而是让小模型产生结构化 handoff:
{
  "action": "handoff",
  "reason": "insufficient_evidence",
  "task_state": "已完成文件定位,尚未解决版本冲突",
  "required_capability": "cross-source verification"
}
这样比无约束的长推理前缀更容易校验、压缩和脱敏。
第二,把“是否调用大模型”与“调用多强的大模型”拆开。Agentic-Preview 中 0~9 的思考等级已经沿这个方向迈了一步。真实系统还可以进一步映射为:普通云模型、强推理模型、是否启用搜索、是否允许执行工具。
第三,线上评价不能只看 token 账单,还应联合记录:
- 任务成功率;
- 首 token 与端到端延迟;
- handoff 率与 handoff 位置;
- 交接上下文长度;
- 云端调用失败后的降级策略;
- 敏感内容出域比例。
从这个角度看,PyroDash 最有价值的并不是一个特殊 token,而是把模型协同从“网关前的一次分类”推进为“生成过程中的可学习控制动作”。
十一、总结
PyroDash 给出了一个非常清晰的答案:
小模型不必只负责筛选问题,也可以先真正参与推理,并在生成轨迹中主动决定何时把控制权交给大模型。
它的关键设计可以浓缩为四点:
- 用
<|llm_offload|>把路由动作内化进小模型; - 保留小模型已完成的局部推理,只做一次 SLM→LLM 交棒;
- 通过 embedding 学习、SFT 冷启动和 GRPO 三阶段训练交棒策略;
- 把实际 token 价格放进奖励,以 λ 学习不同的质量—成本工作点。
实验最亮眼的两个端点分别是:64.04% 平均准确率并比纯大模型节省 20.4%,以及在准确率仅低 3.13 个百分点时将估算成本从 $49.36 降至 $1.78。但更接近工程讨论的,也许是 λ=0.1:它以 8.19% 的 LLM Token 比例取得 55.29% 准确率和 $4.71 成本。
这项工作仍处于研究原型阶段:数学任务之外的泛化、真实账单、端到端延迟、交棒合理性和生产级协同引擎都还没有被充分验证。可它提出的方向很值得继续跟进——未来的模型能力,不一定只来自单个模型越来越大,也可能来自一组不同成本、不同能力的模型,在正确的时刻完成一次干净的交接。