
从 World Model 到 World Action Model:具身智能正在进入“先想象,再行动”的时代

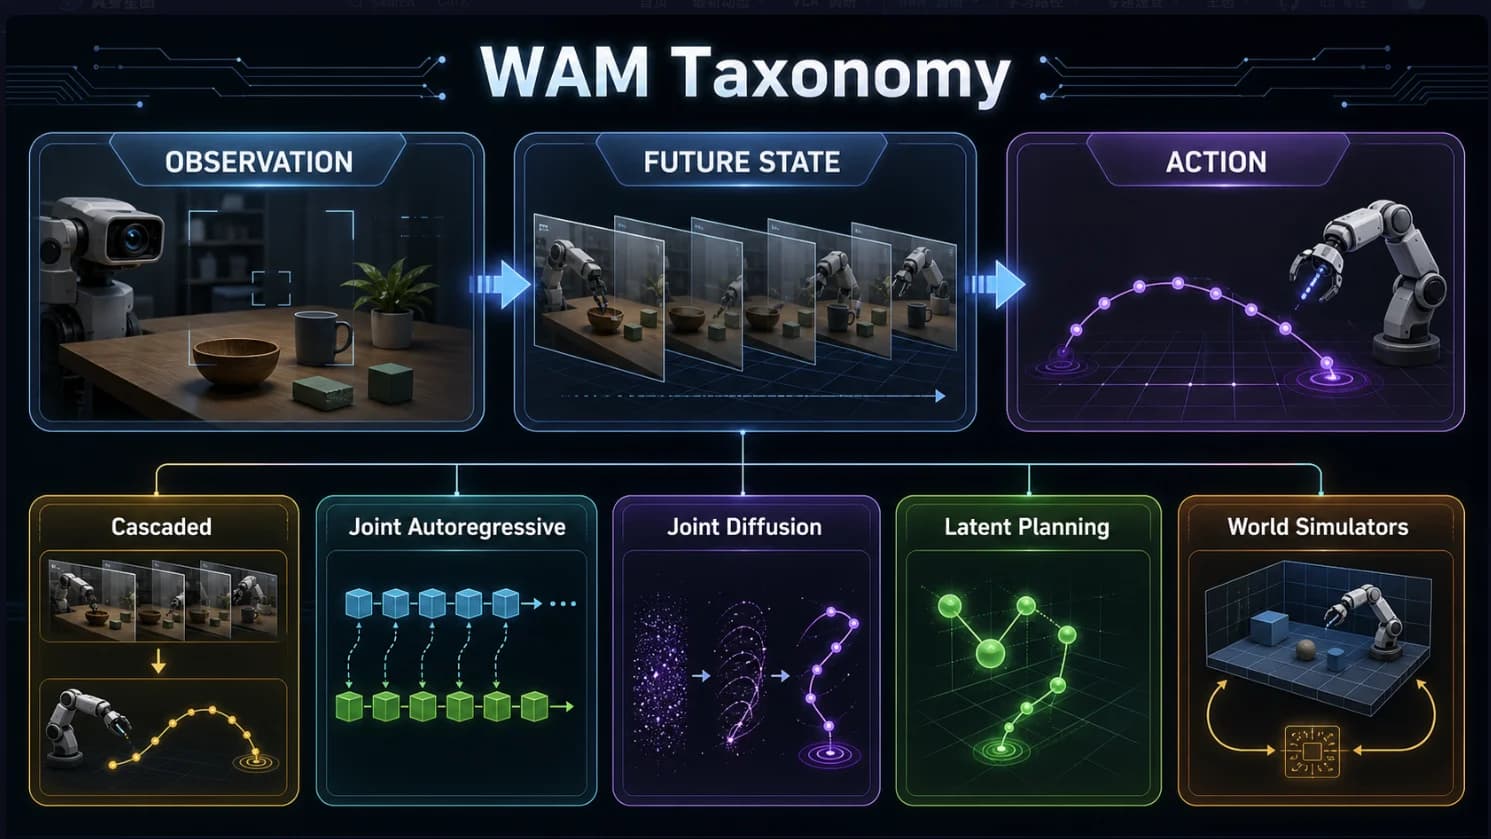
从强化学习里的环境预测,到视频生成里的世界模拟,再到机器人领域的 World Action Model(WAM),AI 正在尝试获得一种新的能力:
不是看到世界后立即反应,而是在行动之前先预测世界会如何变化。
过去几年,具身智能(Embodied AI)领域最热门的关键词之一是 VLA(Vision-Language-Action)。
我们希望机器人能够:
- 看懂环境;
- 理解人类指令;
- 生成对应动作。
例如:
“把桌面上的工具盒整理到抽屉里。”
VLA 的目标是学习:
视觉观察 + 语言指令
|
v
动作输出
模型看到当前状态,然后直接预测下一步动作。
但随着机器人任务越来越复杂,一个问题逐渐暴露出来:
一个真正智能的机器人,仅仅知道“下一步应该做什么”是不够的。
它还需要知道:
- 如果移动这个物体,会不会撞到旁边的东西?
- 如果抓取失败,物体会掉到哪里?
- 如果当前路径被阻挡,换一种策略会不会更好?
- 如果连续执行五个动作,最终结果是否符合预期?
换句话说:
机器人需要的不只是动作能力。
它需要一种对未来的想象能力。
这也是 World Model(世界模型)重新成为热点的原因。
目录
- 1. 为什么 AI 开始需要一个“内部世界”
- 2. World Model 的起源:让智能体在梦境中学习
- 3. 从 Dreamer 到 MuZero:世界模型的两条路线
- 4. 为什么视频生成推动了 World Model 新浪潮
- 5. JEPA:预测世界状态,而不是生成世界像素
- 6. 为什么 VLA 还不够
- 7. 从 World Model 到 World Action Model
- 8. WAM 的技术路线
- 9. 代表模型解析
- 10. 数据、评测和未来挑战
1. 为什么 AI 开始需要一个“内部世界”
如果观察今天的大模型发展,会发现一个非常明显的趋势:
语言模型学习的是:
世界中的语言规律。
视觉模型学习的是:
世界中的视觉规律。
而具身智能需要学习:
世界如何变化,以及行动如何改变世界。
这三者之间最大的区别是:
机器人必须和世界发生交互。
一个语言模型回答:
“如果把玻璃杯推到桌边,会发生什么?”
它可以根据文本知识回答。
但机器人需要真正知道:
- 推多少力度?
- 桌面摩擦如何?
- 杯子重量是多少?
- 倾斜角度达到多少会掉落?
- 掉落过程中是否会碰撞其他物体?
这些问题,本质上都是:
action 会导致什么 consequence?
也就是动作产生的后果预测。
1.1 没有 World Model 的机器人是什么样?
传统策略模型通常类似:
Observation
|
v
Policy Network
|
v
Action
例如:
摄像头看到:
- 一个散乱的零件盒;
- 工具散落在工作台。
语言指令:
“整理这些零件。”
模型输出:
移动机械臂
抓取零件
放入盒子
问题在哪里?
它知道:
“现在应该抓。”
但是不知道:
“抓之后会怎样。”
例如:
- 零件是否容易滑落?
- 盒子是否已经满了?
- 放置位置是否稳定?
- 下一步动作是否还能继续?
因此很多 VLA 模型在短任务上表现很好。
但是到了:
- 长时间任务;
- 多步骤任务;
- 开放环境任务;
性能会明显下降。
1.2 人类为什么可以完成复杂任务?
因为人类大脑并不是简单的:
看到 -> 行动
而更像:
观察当前世界

↓

在脑中模拟多个未来

↓

比较不同结果

↓

选择最优动作

↓

执行
比如一个人整理房间:
他不会马上拿起第一个物品。
他可能会先想:
- 这个东西应该放哪里?
- 如果先移动这个,会不会挡住后面的操作?
- 哪些物品应该一起处理?
这种能力,就是一种内部世界模型。
AI 研究者希望构建类似机制。
2. World Model 的起源:让智能体在梦境中学习
World Model 并不是最近才出现的概念。
早在强化学习(Reinforcement Learning)时期,研究者就已经意识到:
如果智能体能够学习环境规律,那么它就可以减少真实世界交互。
传统强化学习:
Agent

选择动作

↓

真实环境

↓

获得反馈

↓

更新策略
问题:
真实环境交互非常昂贵。
例如:
游戏 AI:
失败一百万次没关系。
机器人:
摔倒一次可能:
- 损坏机械结构;
- 重新校准;
- 人工恢复。
因此研究者提出:
能不能让机器人先在一个模型世界里面学习?
也就是:
真实世界数据
↓
学习 World Model
↓
模拟未来
↓
训练 Agent
↓
部署真实世界
3. 从 World Models 到 Dreamer:让 AI 在“梦里学习”
2018 年,Ha 和 Schmidhuber 提出的:
World Models
是这个方向非常重要的起点。
论文提出:
智能体可以拥有一个内部世界。
这个世界不需要完全复制现实。
只需要能够帮助决策。
整体结构:
视觉输入

↓

Vision Model

↓

Latent State

↓

Memory Model

↓

Future Prediction

↓

Controller

↓

Action
核心思想:
模型先学习:
世界如何变化。
然后:
策略模型在这个内部世界里训练。
这个想法非常重要。
因为它改变了强化学习的基本假设:
过去:
智能来自大量试错。
World Model:
智能来自理解环境,然后进行想象。
3.1 Dreamer:进入真正的 latent imagination
随后 DeepMind 提出的 Dreamer 系列进一步推动了 World Model。
Dreamer 的关键思想:
不要直接预测未来像素。
原因:
真实世界像素太复杂。
例如机器人打开一个抽屉:
视觉变化包括:
- 光照变化;
- 背景变化;
- 纹理变化;
- 相机运动。
但真正重要的是:
- 抽屉位置;
- 机械臂状态;
- 接触关系;
- 任务进度。
因此 Dreamer 学习:
latent dynamics。
即:
Observation
↓
Encoder
↓
Latent State

Latent State + Action
↓
Future Latent State
然后策略在 latent space 中进行 imagination rollout。
例如:
机器人准备打开柜门。
模型可以模拟:
方案 A:
抓住把手
拉动
预测:
柜门打开
方案 B:
从侧面推
预测:
柜门偏移
任务失败
方案 C:
调整角度
重新抓取
预测:
成功概率更高
最终选择更好的动作。
这就是 World Model 的核心价值:
不是生成未来,而是帮助决策。
下一篇讲讲
MuZero、JEPA、视频生成 World Model、VLA 局限,以及为什么 WAM 成为下一阶段方向)