
亮源新创 & 逐际动力 LightNav-0 开源:一个 4B 模型,统一指令跟随、开放词汇导航与目标跟踪
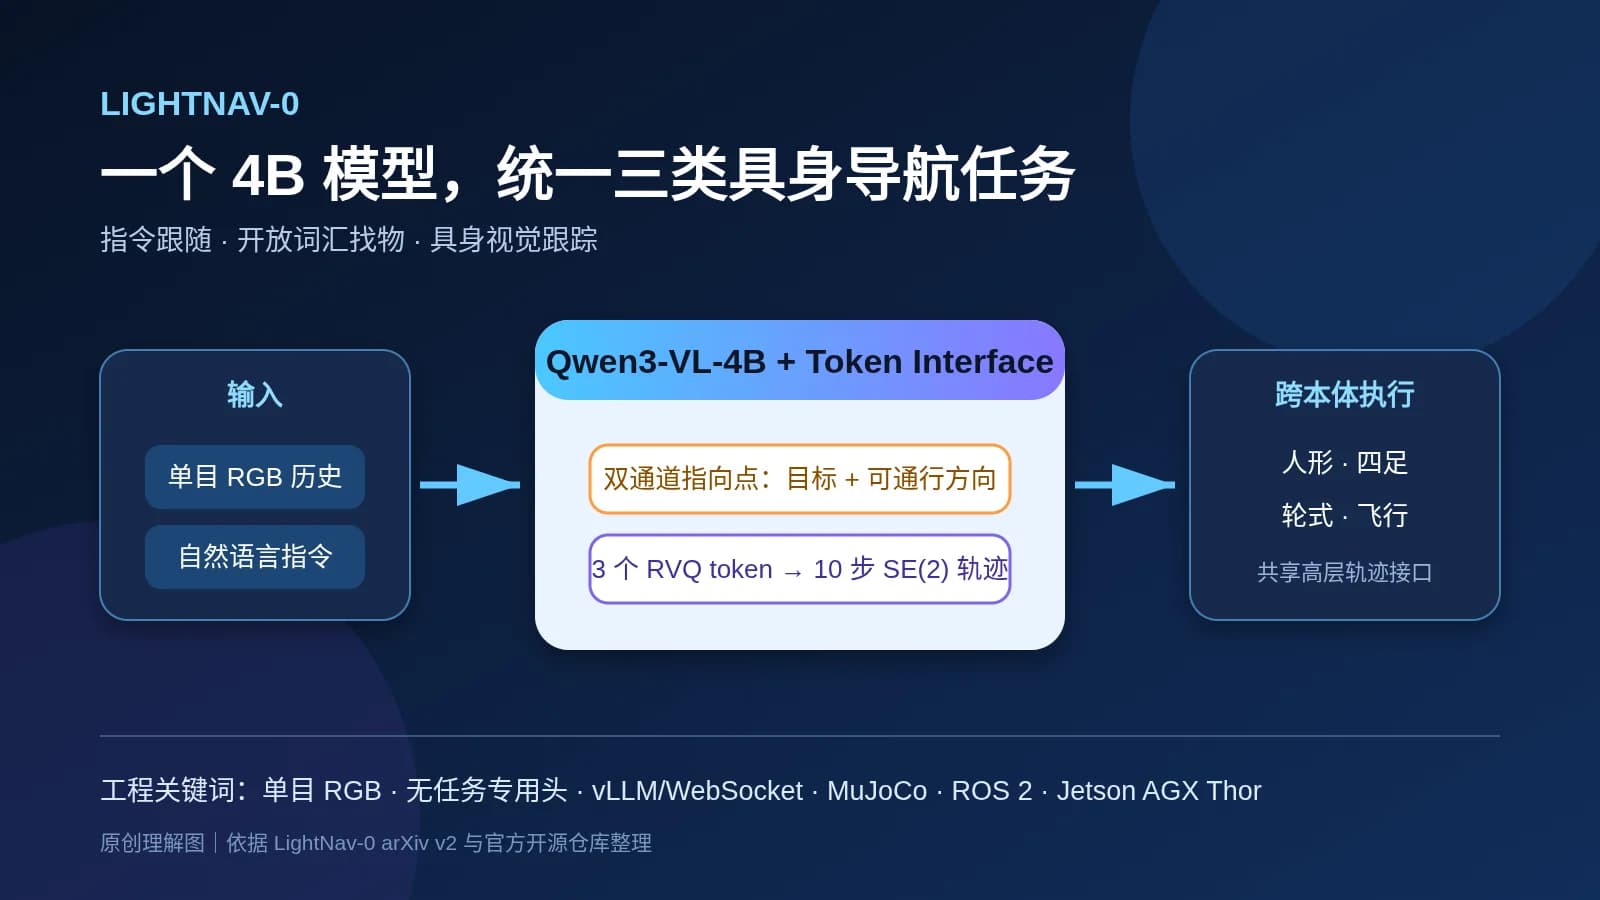
让人形机器人听懂“去右边的红色长椅”,让四足机器人跟住穿蓝衣服的人,再让轮式机器人寻找此前没有专门训练过的物体——过去,这往往意味着三套任务定义、三套动作头,甚至三套模型。
亮源新创 Light Origins 发布的 LightNav-0,尝试把这些能力收进同一个 4B 视觉语言模型:输入第一视角 RGB 历史和自然语言指令,模型先在图像中指出“目标在哪里、下一步往哪里走”,再用 3 个动作 token 生成未来 10 个 SE(2) 路径点。机器人本体不同,不需要更换模型,只需由各自的底层控制器接住这条轨迹。
官方把它称为“首个通用具身导航大脑”。更准确的工程表述是:LightNav-0 用统一的视觉—语言—轨迹接口,覆盖指令跟随、物体目标导航、开放词汇导航和具身视觉跟踪,并展示了跨人形、四足、飞行与轮式平台的零样本迁移。“通用”在这里指任务接口、场景和本体迁移能力,并不意味着它已经解决了所有导航与运动控制问题。
项目资料
- 项目:LightNav-0 — Eliciting VLM Spatial Intelligence for Generalist Embodied Navigation
- 团队:亮源新创 Light Origins(北京 / 深圳 / 新加坡)
- 真机部署合作:逐际动力 LimX Dynamics
- 仿真合作:群核科技
- 代码:GitHub
- 权重:Hugging Face
- 技术报告:arXiv:2608.30935v2
- 官方博客:LightNav-0:以规模化 Real2Sim2Real 实现零样本通用导航
本文以 2026 年 9 月 9 日的 arXiv v2 和当前开源仓库为准。
先看结论:它到底开源了什么?
| 项目 | 当前公开内容 |
|---|---|
| 模型骨干 | Qwen3-VL-4B-Instruct |
| 模型输入 | 带时间信息的单目第一视角 RGB 历史 + 自然语言指令 |
| 模型输出 | 可通行点、目标点、3 个 RVQ 动作 token |
| 轨迹接口 | 10 个 SE(2) 路径点:前向、横向与偏航 |
| 统一任务 | 指令跟随、ObjectNav、开放词汇导航、视觉跟踪 |
| 开源权重体积 | Hugging Face 当前仓库约 9.71 GB;不等同于运行时显存 |
| 推理方式 | Transformers/HF、vLLM、本地 CLI、Python API、WebSocket 服务 |
| 仿真 | Habitat 评测、MuJoCo TurtleBot/MicroDuck 演示 |
| 真机参考栈 | ROS 2 Humble,内置 Unitree Go2 与 LimX TRON 1 适配器 |
| 常规 GPU 建议 | 官方说明 4B bf16 权重约 10 GB,标准 vLLM 配置实际约占 15 GB;24 GB GPU 可较宽松运行一个引擎 |
| 端侧部署 | 官方提供 Jetson AGX Thor 实测与启动脚本;没有宣称普通 Orin 可直接获得同等速度 |
它不只是放出一份论文模型。仓库同时给出了视频离线推理、WebSocket 服务、MuJoCo 闭环、Habitat/EVT-Bench 评测、ROS 2 真机栈、MPC 轨迹跟随以及 Jetson AGX Thor 的部署记录,工程完成度明显高于“只有 checkpoint 和单帧 demo”的导航项目。
它为什么能把多种导航任务放进一个模型?
传统导航系统常把感知、目标识别、规划和动作预测拆成不同模块。这样做清晰可靠,但当任务从“跟随指令”换成“找物”或“跟人”,又或者机器人从轮式底盘换成人形,任务头、动作空间和训练数据往往都要重新适配。
LightNav-0 的思路不是继续叠加专用头,而是把空间推理与动作都改写成 VLM 熟悉的 token 生成问题。
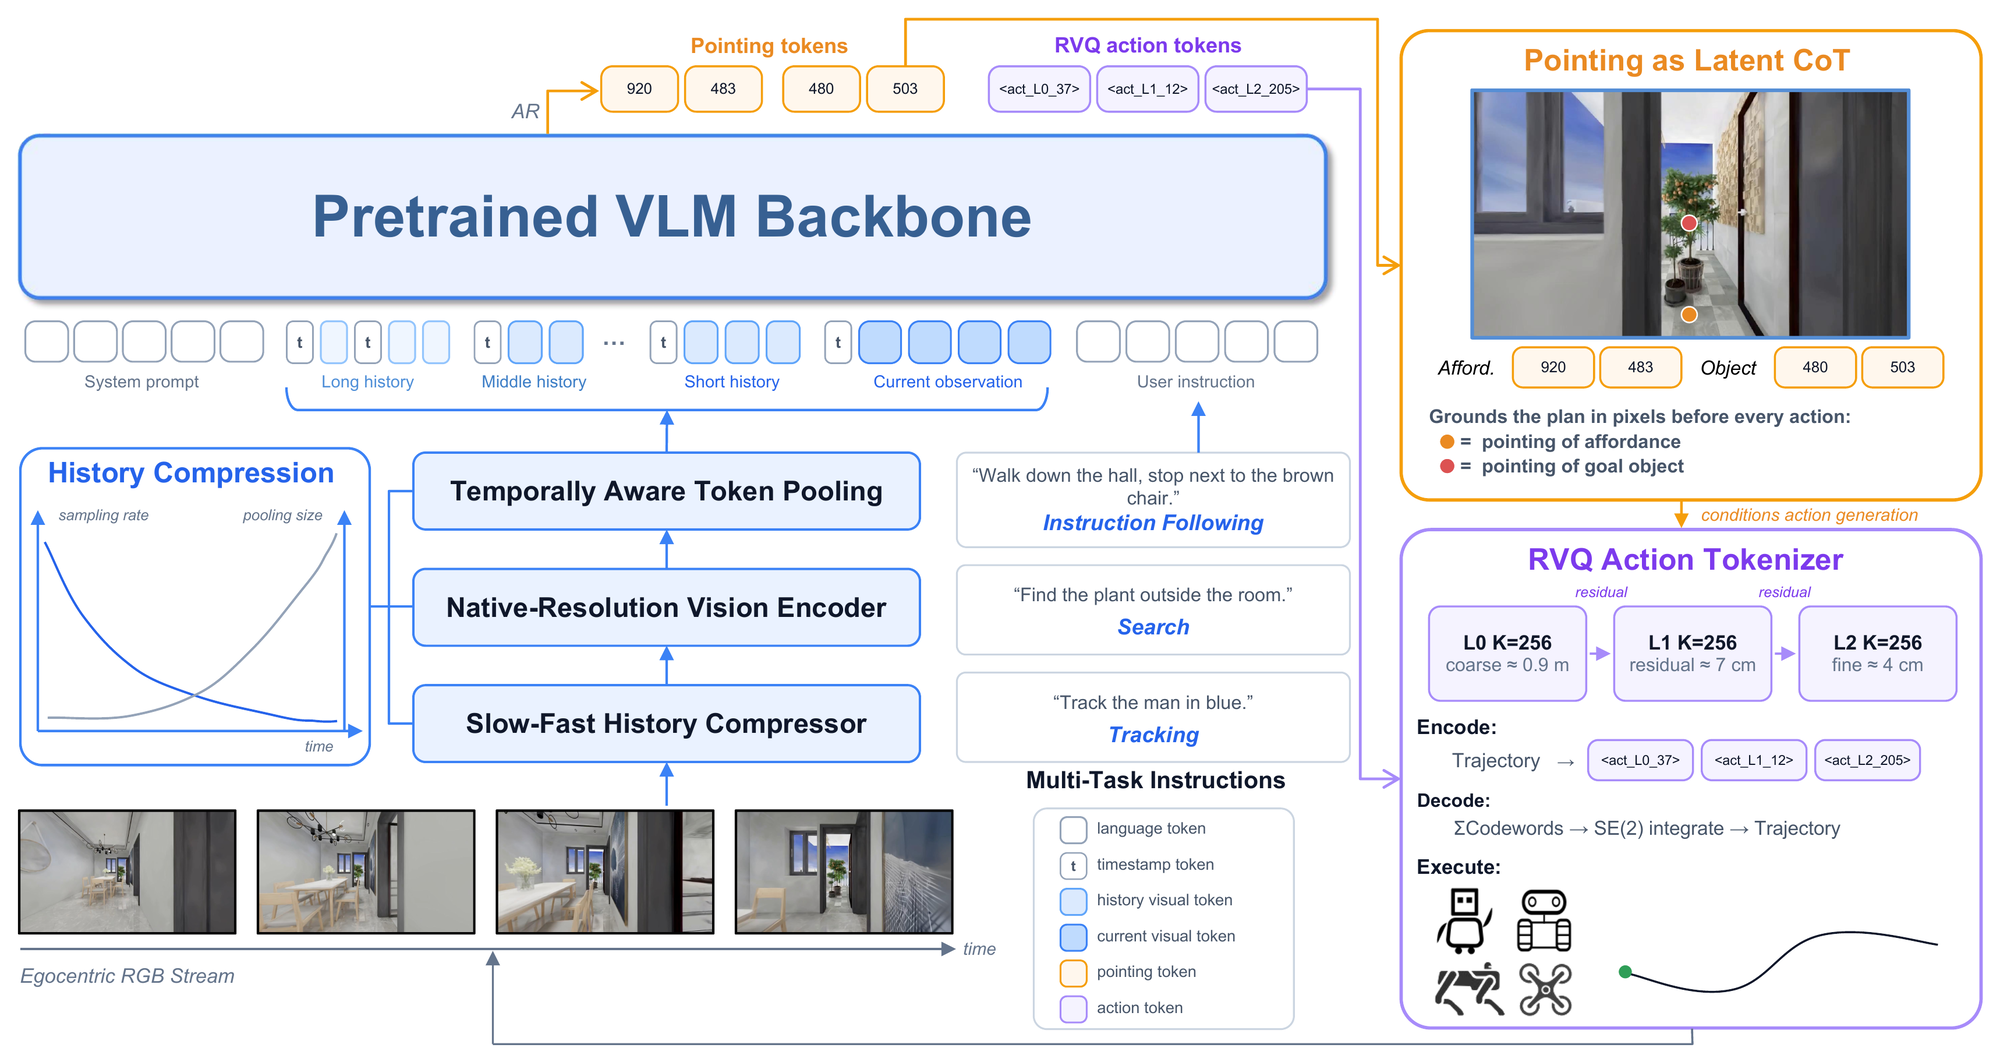
图 2|LightNav-0 总体架构
每次决策时,模型按顺序完成两件事:
- 先指再走。 模型输出一个可通行点(affordance point)和一个目标点(object point)。前者回答“局部往哪走可行”,后者回答“指令中的目标在哪里”。这两个图像网格 token 构成一种很短的视觉空间推理痕迹。
- 再把轨迹 token 化。 模型输出 3 个 RVQ 动作 token,解码成未来 10 个路径点。所有任务共用同一套语言模型头,不再为 ObjectNav、VLN 或 Tracking 分别添加预测头。
因此,任务语义来自自然语言,空间意图来自图像中的点,机器人真正执行的是统一的几何轨迹。人形、四足、轮式和飞行平台只需用各自控制器跟踪轨迹,不必让 VLM 学会每种电机的底层控制规律。
这里有一个必须说清楚的边界:模型推理输入不需要深度、地图、位姿或里程计,但官方 ROS 2 真机栈中的 MPC 需要里程计,将模型给出的局部路径点对齐并转换为速度指令。 所以它去掉的是模型侧的地图/定位依赖,不是把真机闭环控制全部取消。
三个关键设计
1. 按时间远近压缩视觉历史
导航不能只看当前一帧:转过弯后,目标可能暂时离开视野;跟踪移动目标时,也需要知道它刚才往哪里走。但如果每一帧都保留原分辨率,视觉 token 会随时间不断增长。
LightNav-0 对越近的画面保留越高采样率与更细空间分辨率,对越久远的画面采样更稀、池化更强,同时用时间戳 token 保留顺序。官方提供 256K、576K 和 1M 三档像素预算,使历史长度有上界,而不是把所有历史粗暴压成一张固定分辨率摘要。
2. 双通道 Point CoT:把“为什么这样走”落到像素上
它没有生成一段冗长文字推理,而是预测两个点:
- 可通行点:局部自由空间中的可执行方向;
- 目标点:当前可见时,指令所指向的目标。
这比文本 CoT 更短,也比三维坐标更少依赖深度、标定与统一坐标系。论文消融显示,加入双通道指向监督后,8 项导航设置的平均 SR 从 54.7 提升到 63.0,平均 SPL 从 34.3 提升到 39.9。它并不能证明“点就是完整可解释推理”,但说明显式像素级空间痕迹确实改善了轨迹生成。
3. 三级 RVQ:3 个 token 表达一条 10 步轨迹
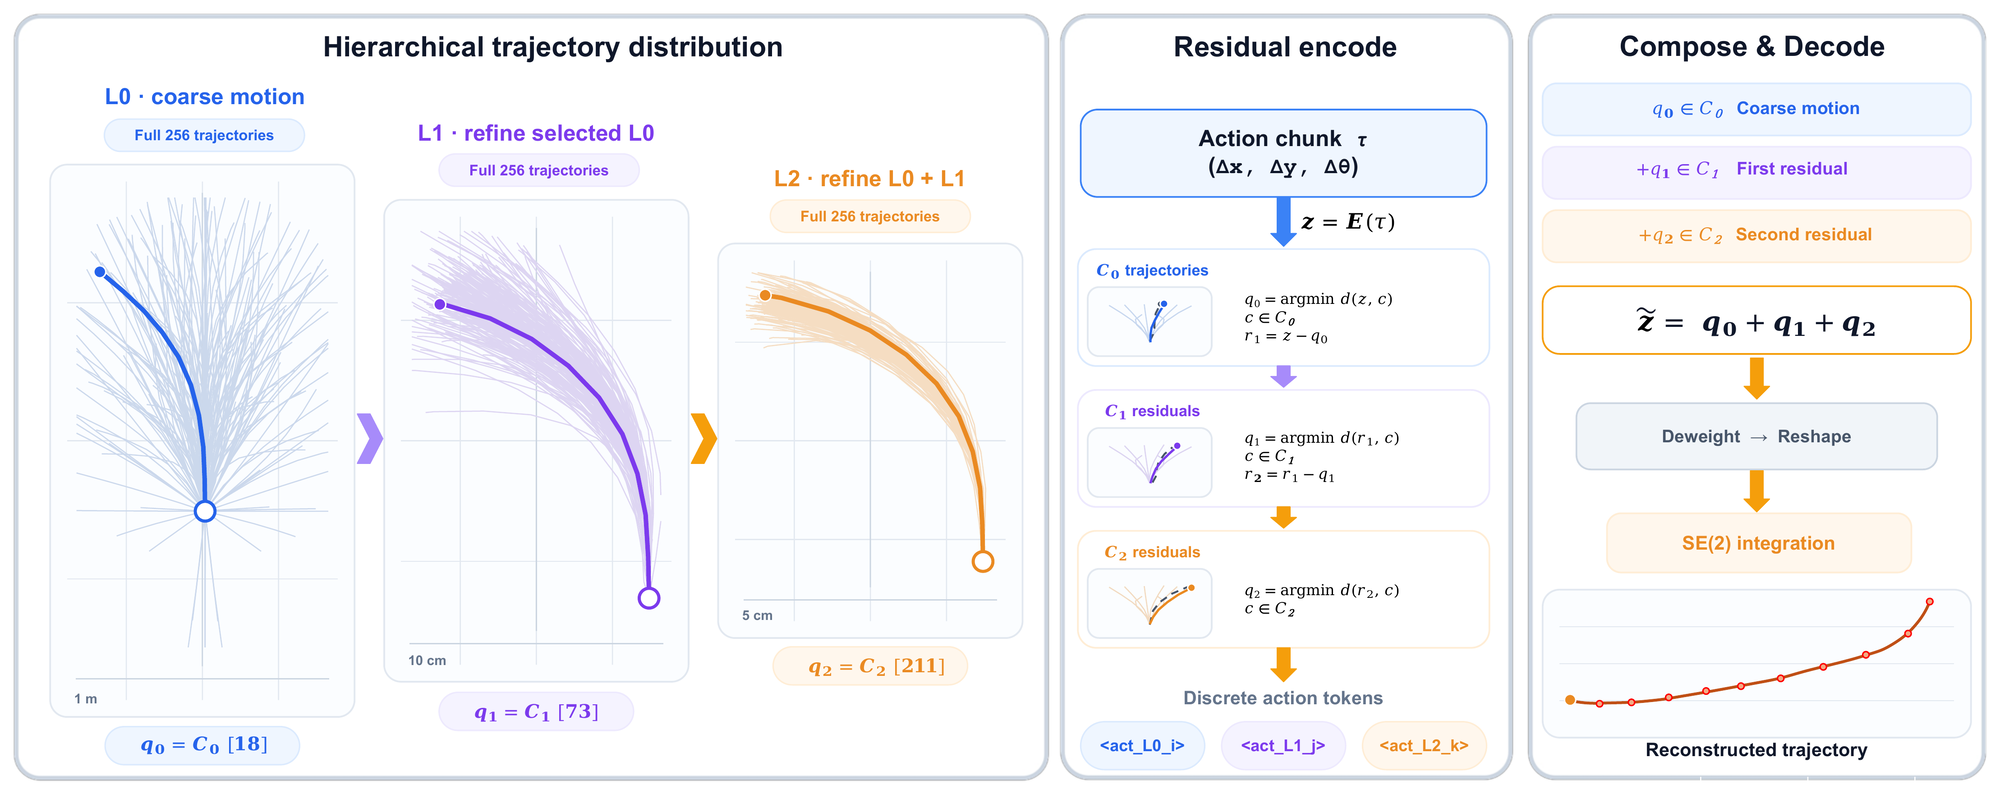
图 3|分层残差向量量化动作 tokenizer
三级码本各有 256 个条目:L0 先确定约 0.9 m 量级的粗轨迹,L1 和 L2 再依次编码剩余误差,把几何精度细化到约 7 cm 和 4 cm 的层级。即使只解码 L0,也能得到一条可执行的粗轨迹;三个 token 全部到齐后,再还原更细的 10 步 SE(2) 路径。
关键不在于“压缩率”本身,而在于模型不再逐点回归连续动作,而是沿用原本的自回归语言头输出离散 token。空间推理 token 与动作 token 因而能在同一个序列中自然衔接。
数据路线:Real2Sim2Real 不是简单的 Sim2Real
LightNav-0 的训练数据覆盖 2,000+ 场景、4,000+ 小时导航经验。官方路线可概括为:
真实场景素材 → 三维重建与统一仿真 → 自动生成目标、路线、第一视角视频与指令 → 模型后训练 → 真机部署发现失败模式 → 反向补充数据
这也是项目最值得关注的部分之一。团队不是只在少量手工场景中生成更多相似轨迹,而是强调扩大环境覆盖。论文的规模化实验显示:
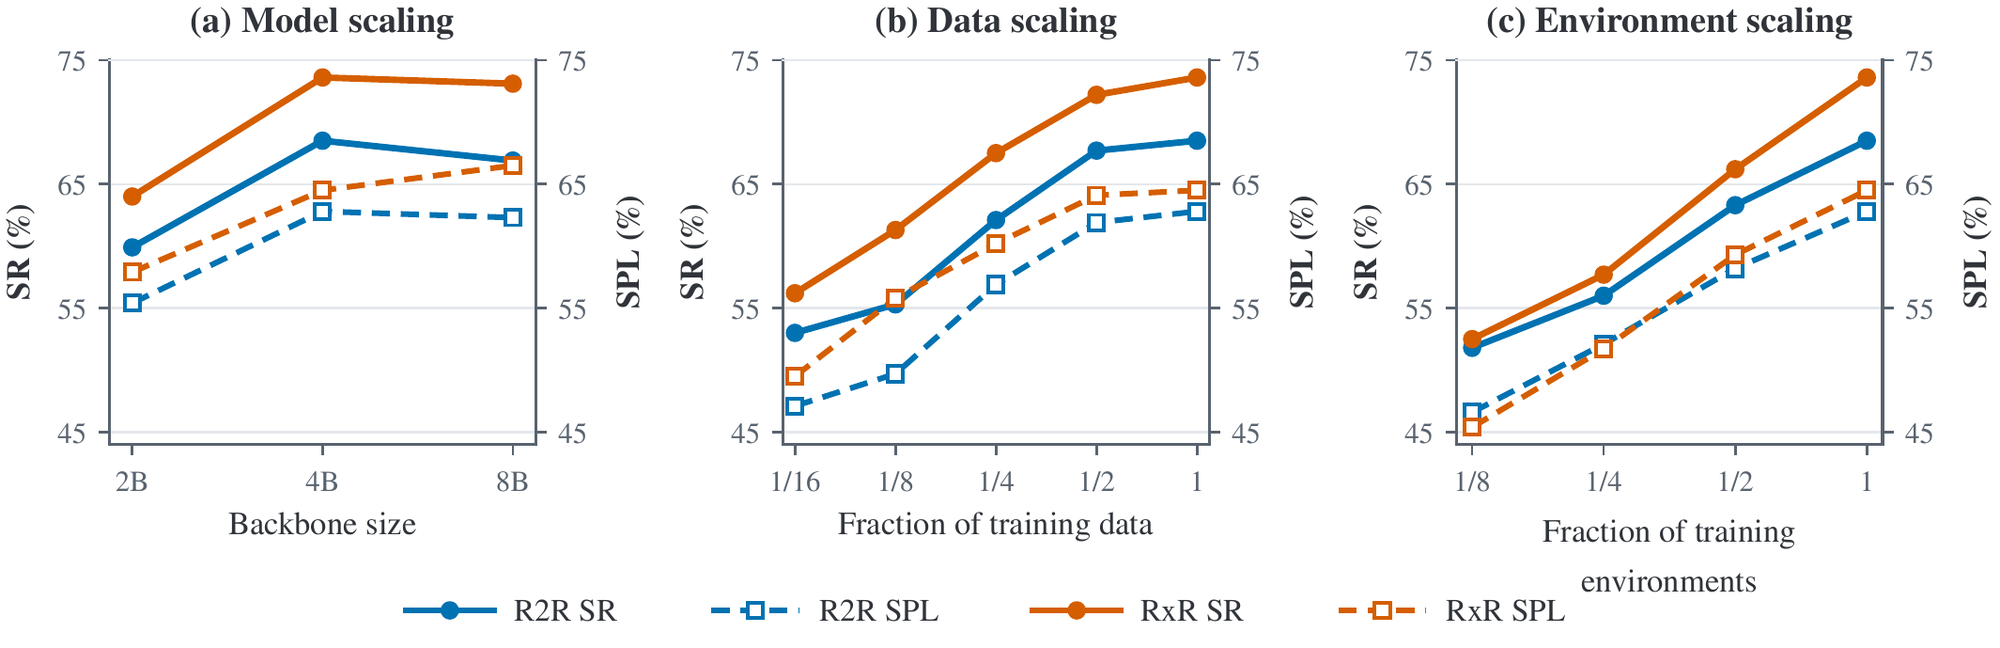
图 4|模型、数据与环境规模对连续 VLN 的影响
- 2B 扩到 4B 明显增益,但继续扩到 8B 出现指标有升有降;
- 增加数据量仍有收益,但接近完整数据时边际收益下降;
- 扩大训练环境覆盖,在测试区间内持续提升 R2R 与 RxR 的 SR/SPL。
换句话说,当前阶段最可靠的杠杆不是盲目堆参数,而是让模型真正见过更丰富的空间布局、视觉外观与任务组合。
结果怎么看:强,但要在同一输入条件下比较
当前仓库报告的 LightNav-0 结果来自同一个共享 checkpoint,没有针对单项 benchmark 再微调;输入为单个前向 RGB 流,不使用深度、里程计或全景相机。
| 任务 | 指标 | LightNav-0 |
|---|---|---|
| R2R val-unseen | SR / SPL | 68.5 / 62.8 |
| RxR val-unseen | SR / SPL | 73.6 / 64.5 |
| MP3D ObjectNav | SR | 53.3 |
| HM3D v1 ObjectNav | SR | 74.5 |
| HM3D v2 ObjectNav | SR | 77.2 |
| OVON Seen / Synonym / Unseen | SR | 55.3 / 54.6 / 47.0 |
| EVT-Bench 单目标跟踪 | SR / TR | 91.7 / 87.7 |
| EVT-Bench 干扰跟踪 | SR / TR | 82.6 / 80.1 |
| INSIGHT-Bench | SR / SPL / NE | 43.7 / 41.5 / 3.88 m |
官方“10 项公开仿真设置中达到最强单目成功率”的结论,限定词是 单目。全景或多相机方法同时观察多个方向,传感器条件更强,不能直接把柱状图高低理解为纯模型能力排序。LightNav-0 真正有说服力的地方,是一个 4B checkpoint 在统一的单目设置下同时覆盖了多种任务,而不是在所有传感器配置上无条件领先。
Quick Start:先从视频跑通模型
环境与硬件
- Linux + Python 3.11(项目声明
>=3.11,<3.12) - CUDA GPU
- 官方 bf16 权重约 10 GB,标准 vLLM 实际占用约 15 GB;24 GB GPU 是更稳妥的起点
- 模型仓库下载体积约 9.71 GB,另需为 Python/CUDA 依赖留空间
1. 安装
git clone https://github.com/lightorigins/LightNav-0.git
cd LightNav-0

python3.11 -m venv .venv
source .venv/bin/activate

pip install -e ".[vllm,video]"
hf download LightOriginsHQ/LightNav-0 \
  --local-dir checkpoints/LightNav-0
仓库固定了 transformers==5.8.0、vllm==0.19.1 和 nvidia-cutlass-dsl==4.5.2。这里不要随手升级成“最新版本”,因为代码明确依赖 vLLM 的私有接口,版本漂移可能直接导致引擎启动失败。
2. 用一段视频做离线预测
lightnav-predict \
  --model_path checkpoints/LightNav-0 \
  --backend vllm_local \
  --video clip.mp4 \
  --fps 4 \
  --instruction "follow the person in the red shirt"
正常运行时,程序会加载 checkpoint 自带的动作解码器,从视频帧历史生成原始 token 文本,并解码得到形状为 (10, 3) 的未来轨迹,即 10 个 [forward_m, lateral_m, yaw_rad] 路径点。若模型目录没有随附 action_tokenizer/,则需显式传入 --action_tokenizer_bundle。
3. 启动 WebSocket 服务
PORT=8050 CUDA_VISIBLE_DEVICES=0 \
lightnav-serve \
  --task tracking \
  --model_path checkpoints/LightNav-0 \
  --backend vllm_local
再开一个终端运行参考客户端:
lightnav-ws-client \
  --server ws://localhost:8050 \
  --video clip.mp4 \
  --fps 4 \
  --instruction "follow the person in the red shirt"
服务启动时会先完成一次合成 warm-up,再绑定端口。因此端口已经开放,才表示推理引擎真正就绪。导航/找物任务把 --task tracking 改为 --task vln。
最常见的三个问题
- Python 版本不对。 当前工程明确要求 Python 3.11,3.10 或 3.12 都不在声明范围内。
- 依赖被升级。 vLLM 与 Transformers 均有精确版本约束,破坏 pin 后可能在启动阶段失败。
- 显存判断过于乐观。 模型文件约 9.71 GB 不等于只需 10 GB 显存;权重、KV cache 与 CUDA Graph 合计约 15 GB,16 GB 卡余量很小,24 GB 更合适。
不接真机,先在 MuJoCo 闭环测试
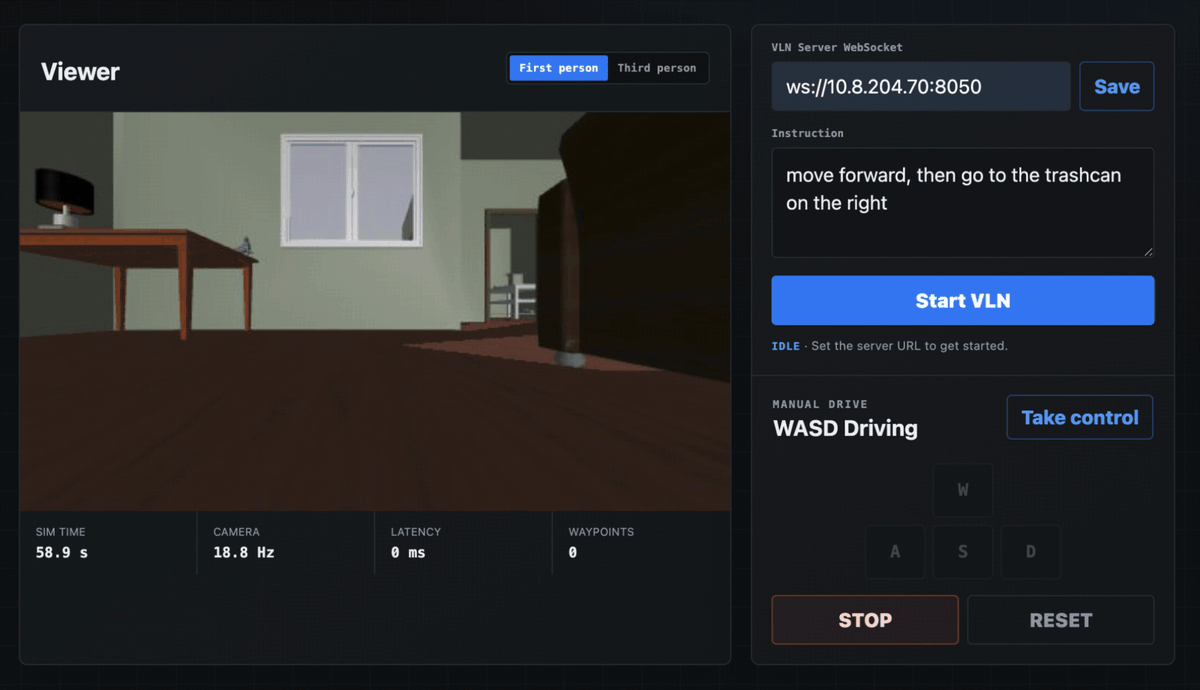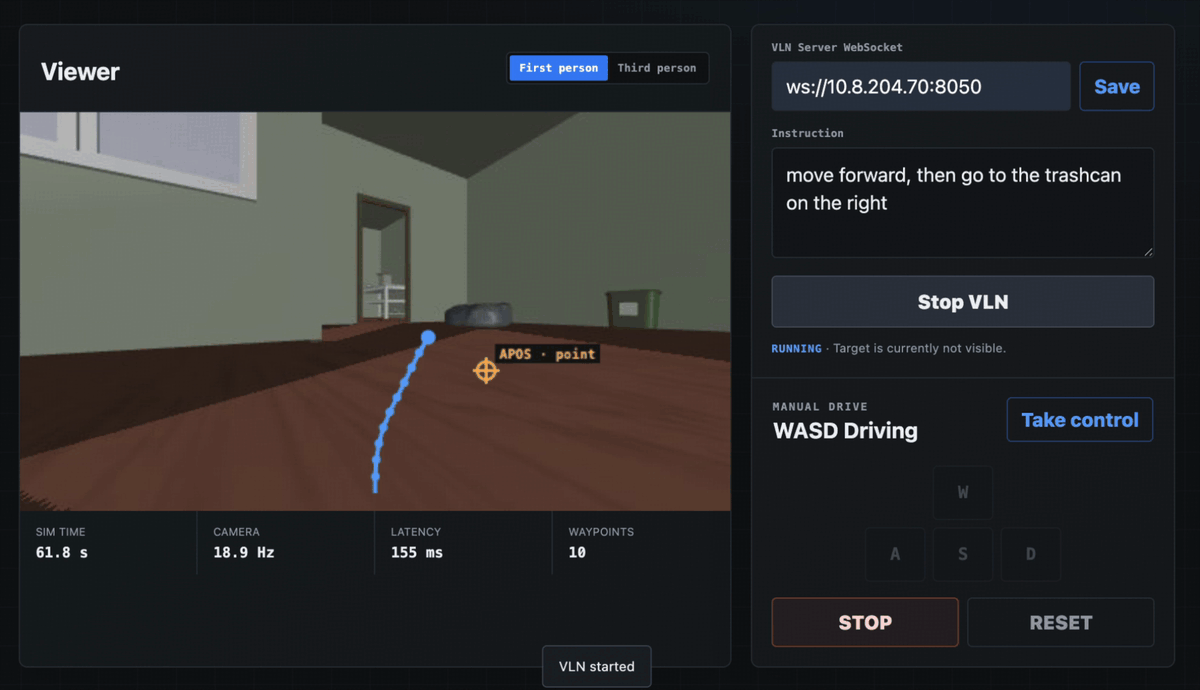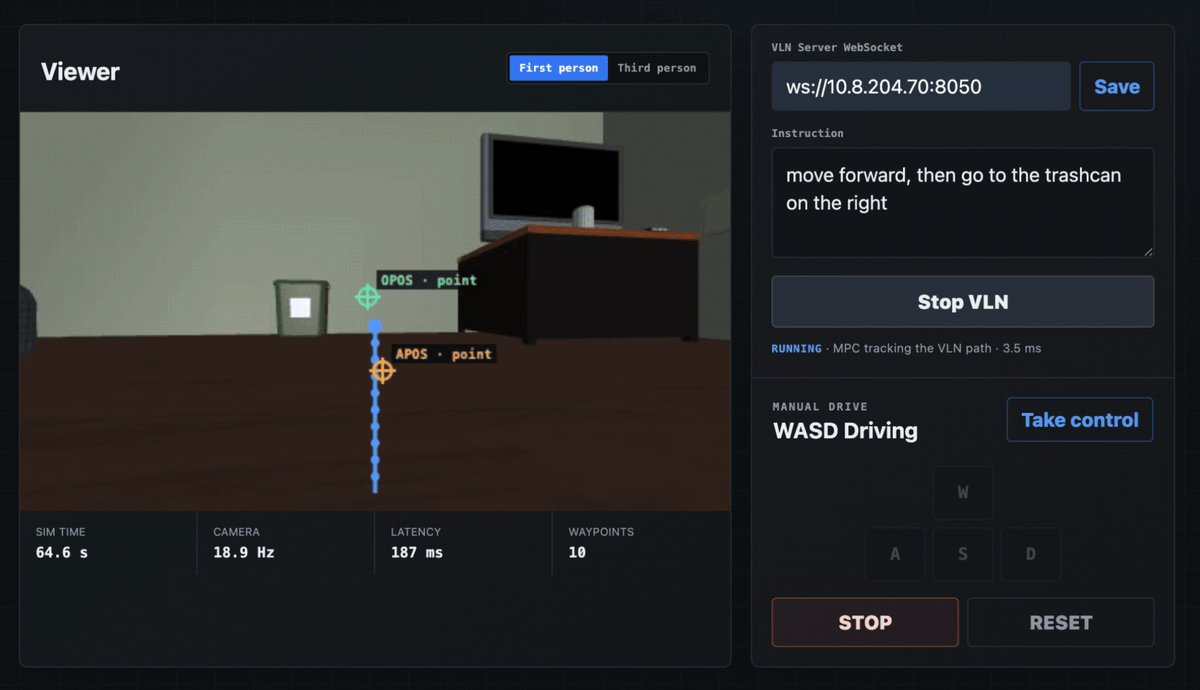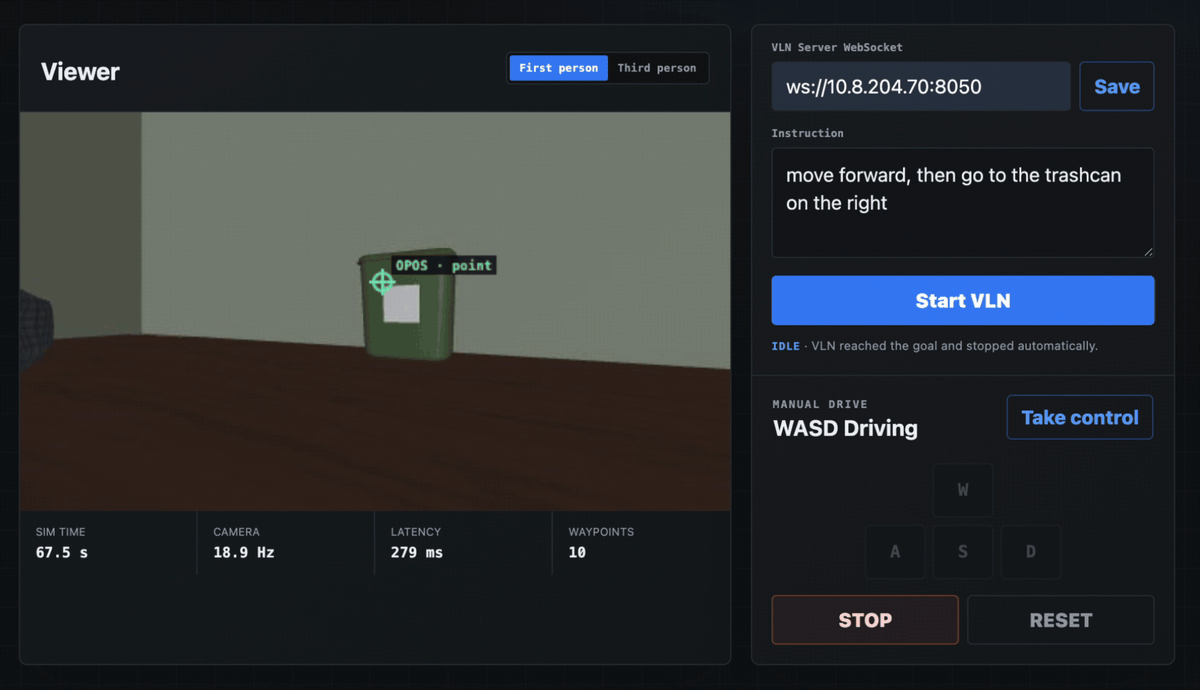
图 5|MuJoCo TurtleBot 闭环演示:与真机栈复用同一套 WebSocket 协议和 MPC(来源:官方仓库)
仓库自带一个 ProcTHOR 场景中的 TurtleBot 演示。客户端不需要 ROS、Habitat 或 GPU;GPU 只在运行 lightnav-serve 的主机侧需要。
cd mujoco_demo
./run.sh
然后打开 http://127.0.0.1:8088,填入模型服务地址,输入导航指令即可。这个步骤比直接上机器人更适合验证:服务连接、图像流、指令格式、轨迹返回、MPC 与停止逻辑是否完整闭环。
真机接入:GPU 服务端 + 机器人轻客户端
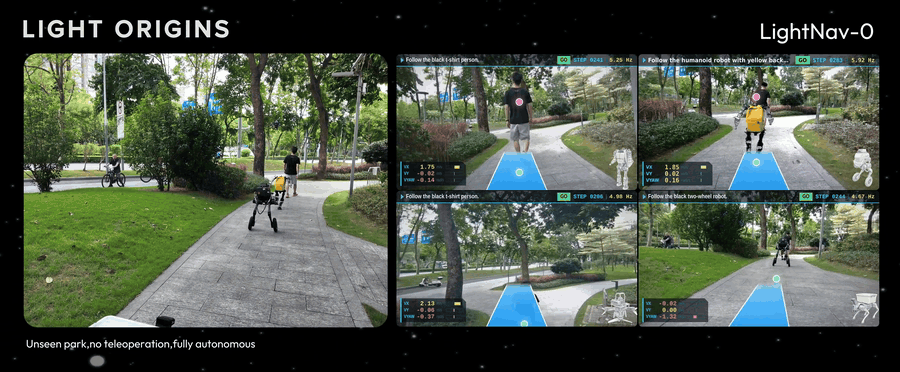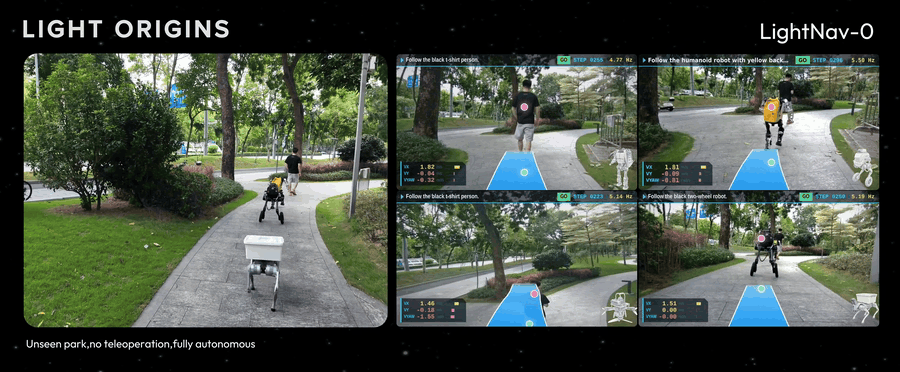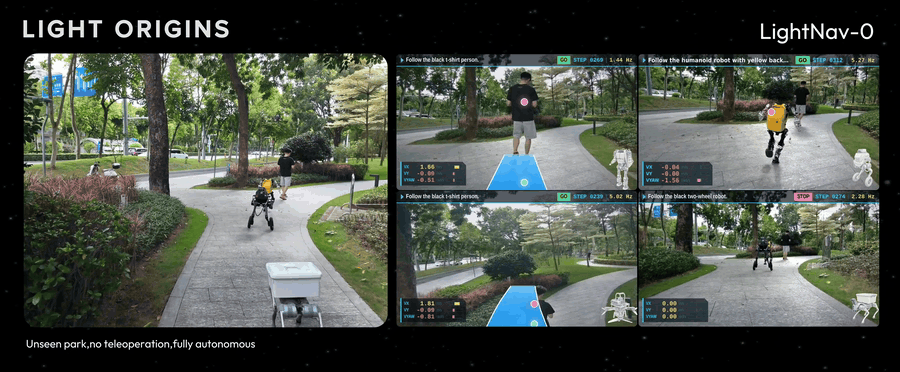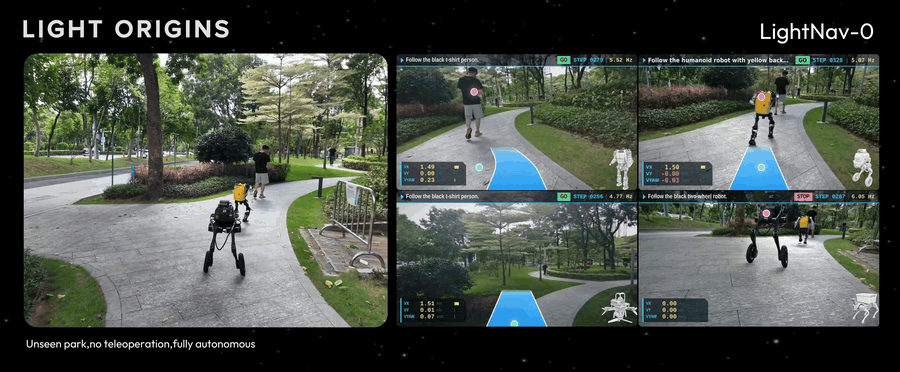
图 6|LightNav-0 跨本体零样本部署演示
官方推荐把系统拆成两部分:
- GPU 主机运行
lightnav-serve,维护视觉历史并生成轨迹; - 机器人端只需编码 JPEG、发送当前指令、接收路径点,并由底层控制器执行第一个路径点后重新规划。
仓库的 ROS 2 参考栈已包含相机节点、WebSocket 客户端、CasADi MPC、Web 控制台,以及 Unitree Go2 和 LimX TRON 1 适配器。新机器人需要实现统一接口:接收 cmd_vel,发布 odom、诊断信息与控制状态,并负责 watchdog、急停和控制权切换。
这套解耦很实用:机器人端不必安装 PyTorch,也不要求本体自带大显存 GPU;多个机器人还可共享同一个服务,通过独立 WebSocket session 保持各自的历史缓存。不过连接是有状态的,断线重连后历史会清空,必须重新 reset 并积累画面。
生产环境不应照搬“收到第一个 waypoint 就无条件执行”的最短 demo。至少还要补上:
- 指令与任务模式校验;
- 相机帧率、延迟和消息尺寸监控;
- 轨迹限幅、碰撞保护和底盘速度约束;
- 推理超时后的停车或保守控制;
- 机器人端 command watchdog 与独立急停;
- 可观测性:记录原图、pointing、轨迹、延迟与控制状态。
Jetson AGX Thor:端侧部署已经给出实测,但别泛化到 Orin
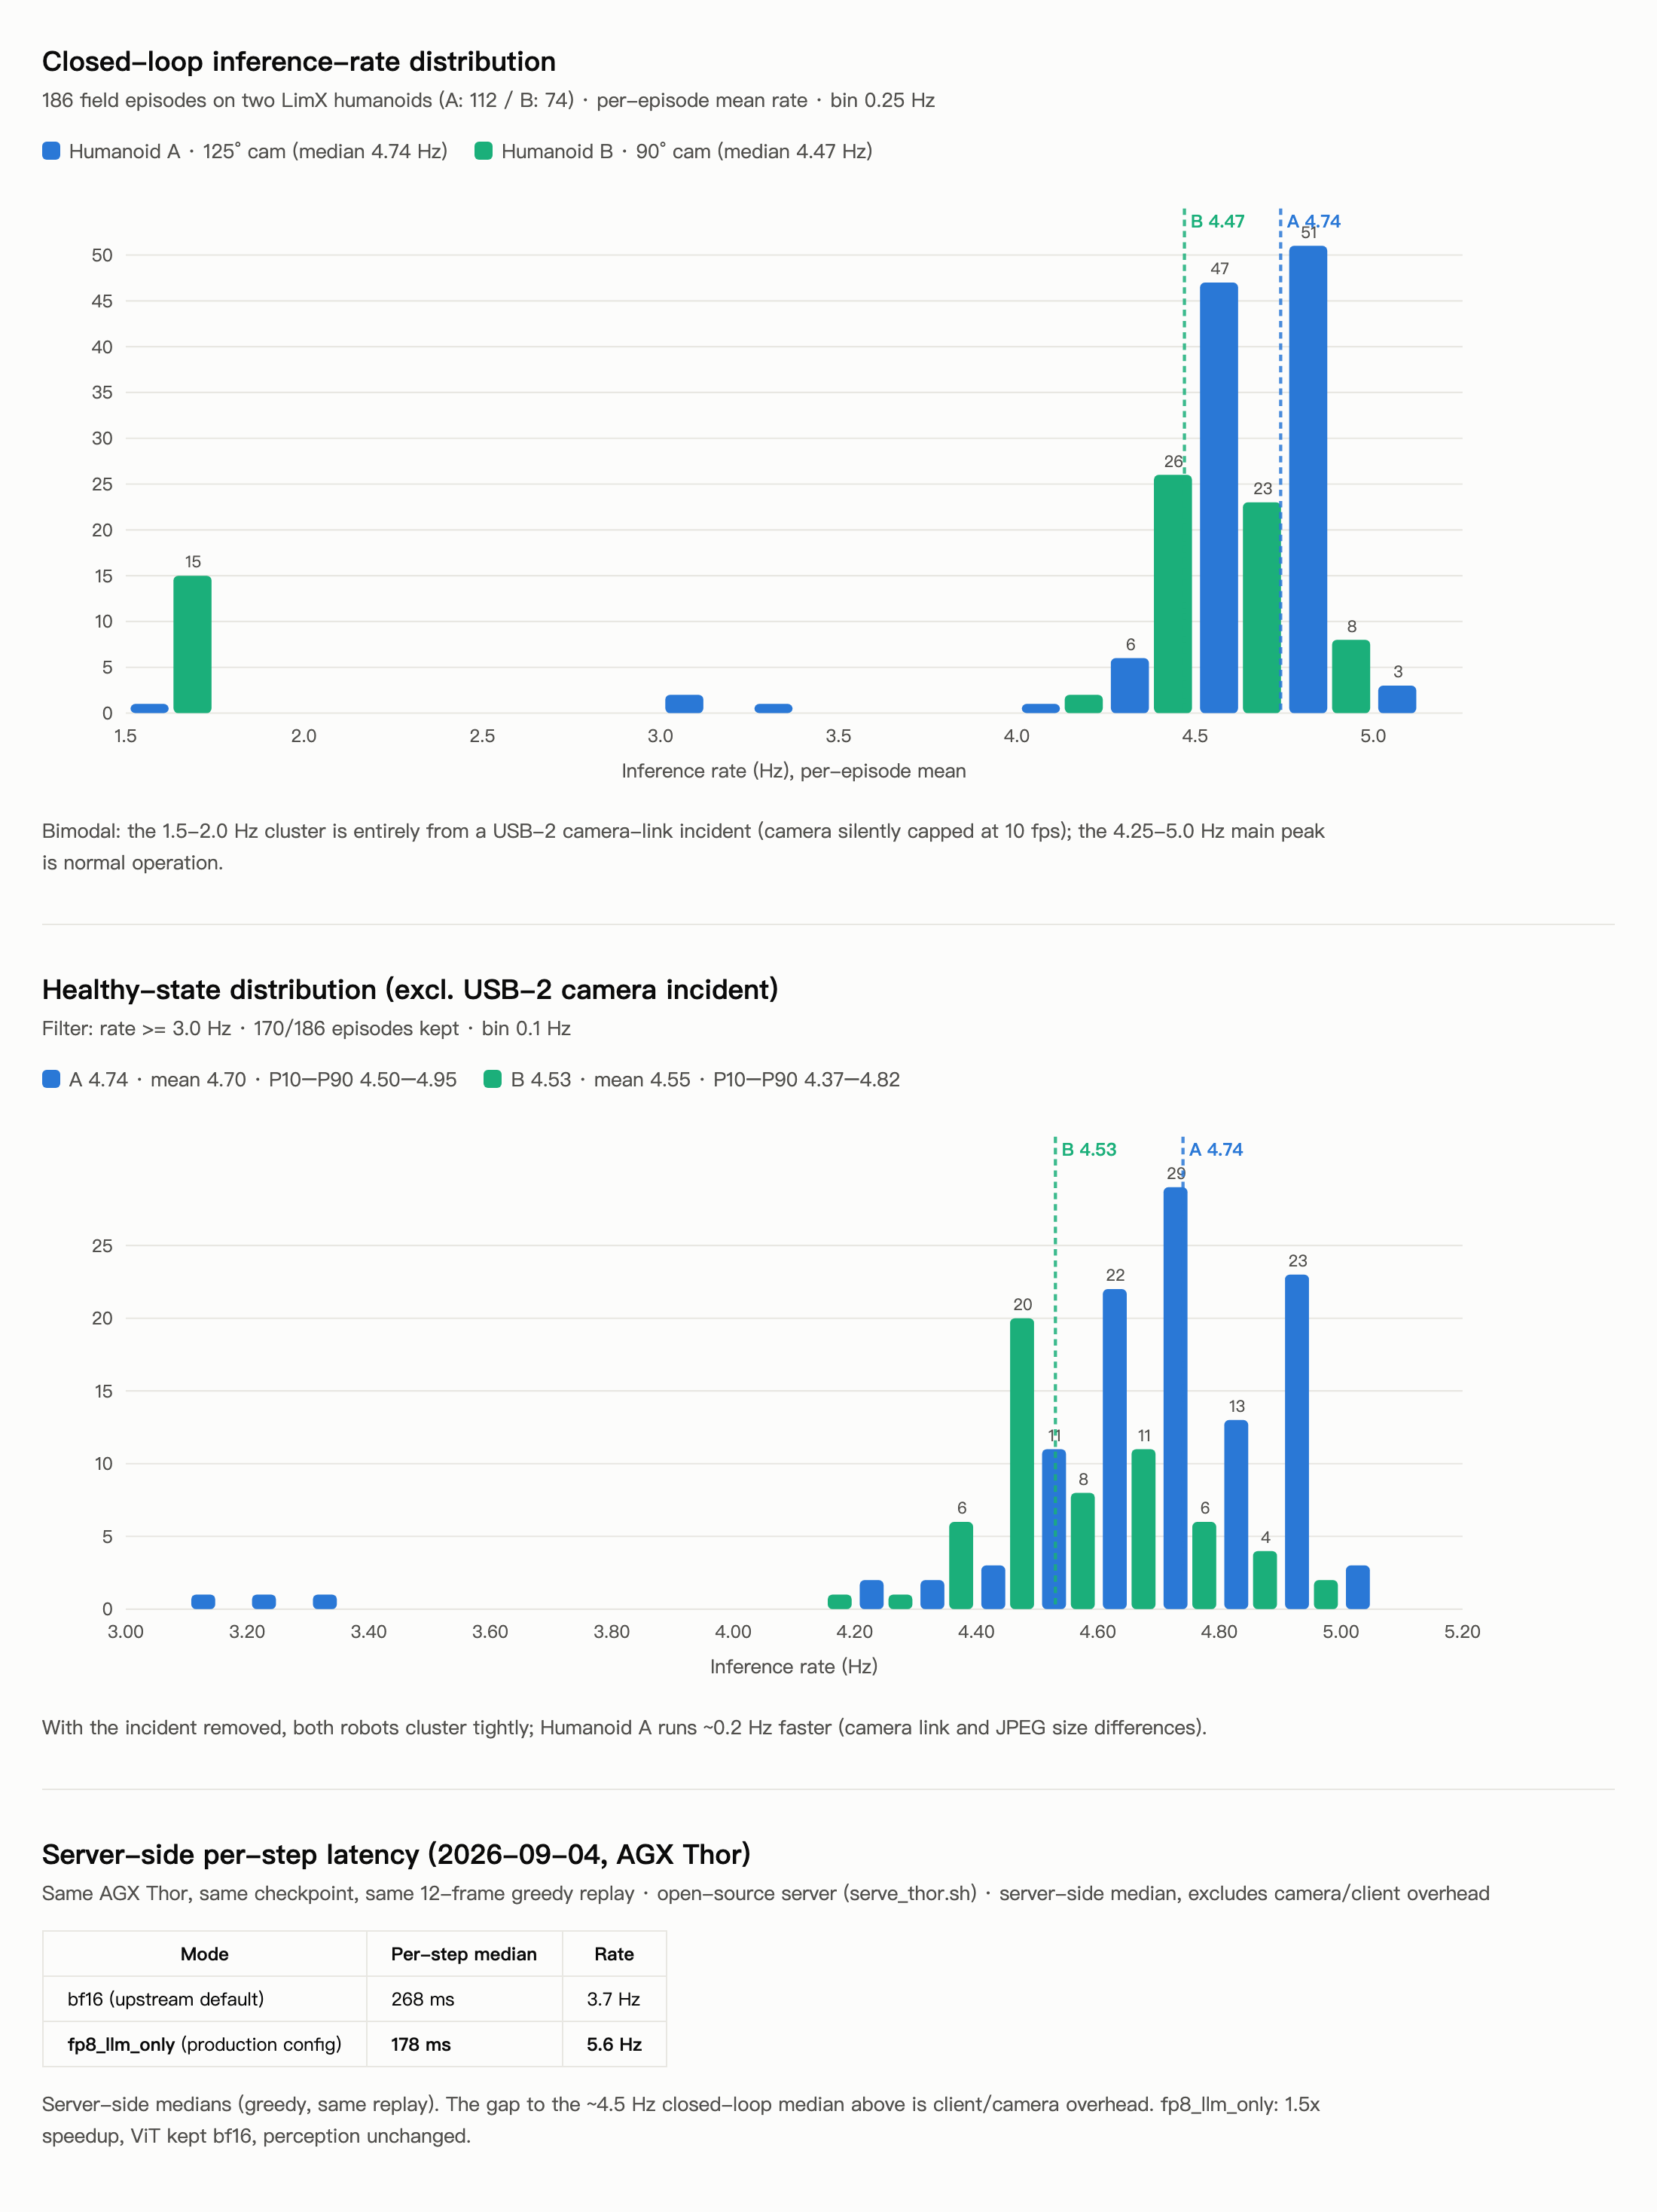
图 7|Jetson AGX Thor 上 186 个真机 episode 的闭环频率分布与服务端延迟(来源:官方仓库)
官方提供了 Jetson AGX Thor 的专门脚本与现场记录。在 640×360 输入、64 帧 SlowFast 历史、单会话条件下:
| 配置 | 服务端单步中位 | 频率 |
|---|---|---|
| bf16 | 268 ms | 3.7 Hz |
| 仅 LLM 动态 FP8、ViT 保持 bf16 | 178 ms | 5.6 Hz |
| 完整闭环 | — | 4.5–4.8 Hz |
这里最有价值的经验不是“FP8 一开就快”,而是 只量化 LLM、保留 ViT 为 bf16。官方发现全模型 FP8 会破坏感知判断,而且小 GEMM 的动态量化开销会让 ViT 反而变慢。
需要强调:这是 Jetson AGX Thor(SM 11.0) 的实测,不是 Jetson Orin NX/AGX Orin 的通用承诺。仓库也给出了 Thor 专用 CUDA 13、PyTorch 2.10、vLLM 0.19.1 与内核规避方案。若目标设备是 Orin,应重新评估算子兼容性、统一内存、吞吐与量化路径,不能直接套用 4.5–4.8 Hz。
指令怎么写,成功率更高?
官方经验是:先写动作,再用一种明确方式消歧,不要把多种描述策略堆在同一句里。
可靠性大致从高到低为:
- 方向 + 物体:
Turn left and walk to the red lamppost; - 关系锚点:
Walk towards the trash can next to the green lawn; - 极值:
Go to the leftmost TV in front; - 序数:
Go to the first chair on the right side of the dining table。
leftmost/rightmost 通常比 nearest/farthest 更稳定,因为前者可以直接从图像判断,后者隐含深度估计。序数描述还必须给出计数方向,否则“第一个”从哪里开始数并不明确。
适合什么,不适合什么?
适合
- 想研究一个模型统一 VLN、ObjectNav 与跟踪的团队;
- 需要单目 RGB + 语言的开放词汇导航原型;
- 有 24 GB 级 GPU,希望通过 WebSocket 给多种机器人共享导航服务;
- 想在 MuJoCo/Habitat 中先完成闭环,再接 ROS 2 真机;
- 关注跨本体轨迹接口、Real2Sim2Real 数据引擎或动作 token 化。
暂时不适合
- 要求安全认证、确定性避障或无人值守直接上线的生产系统;
- 没有 CUDA GPU,又希望纯 CPU 实时推理;
- 期望模型直接输出关节力矩,替代本体运动控制器;
- 依赖高频局部避障的高速移动平台;当前模型没有显式拆分高频反应策略与低频语义规划;
- 想把 Thor 实测速度直接外推到 Orin 或任意 Jetson 型号。
如果是我,我会这样把它接进现有机器人
- 视频离线验证:先用自己的相机录像跑
lightnav-predict,检查目标点、停止判断与轨迹是否合理。 - 服务化验证:启用
lightnav-serve和参考客户端,记录每步latency_ms、原始 token 与轨迹。 - MuJoCo 闭环:验证 WebSocket、MPC、超时停车与任务切换,不直接碰真机。
- 低速真机影子模式:模型只预测不下发控制,与人工操作轨迹对照。
- 受控场地低速闭环:加入碰撞传感器、速度限幅、watchdog 与硬件急停。
- 收集失败案例:重点记录重复目标、转角丢失、强遮挡、相机降帧、网络抖动和长时历史缓存问题。
- 最后再决定微调:先判断问题来自提示词、镜头视场、控制参数、场景覆盖还是模型能力,避免一遇失败就重训。
总结
LightNav-0 最有价值的地方,不是给导航模型再加一个更大的专用模块,而是把“看哪里、往哪里走、未来轨迹是什么”统一到 VLM 的 token 序列里。双通道指向点负责显式空间落点,三级 RVQ 用 3 个 token 表达 10 步轨迹,再由不同机器人自己的低层控制器执行。
从研究角度,它证明了 4B 级 VLM 可以成为跨任务、跨场景、跨本体的统一导航骨干;从工程角度,它也给出了从视频、服务、仿真到 ROS 2 真机和 Jetson AGX Thor 的完整路径。
但“通用导航大脑”仍应理解为阶段性能力:它统一了模型接口与高层轨迹生成,却仍依赖可靠的机器人控制、里程计、安全保护与场景验证。真正值得复现的,不只是排行榜数字,而是这套 VLM 空间先验 + 点式推理 + 轨迹 token + 跨本体控制接口 的系统设计。