
3 分钟看懂 SONIC:从 1 亿帧 Motion Tracking 到人形机器人的 Whole-Body Foundation
摘要
人形机器人正在从“会走路”走向真正的全身移动操作。
但当机器人需要走到桌前、调整朝向、弯腰、伸手、抓住物体,再起身走向下一个目标时,很快会遇到一个问题:这些动作并不是几个彼此独立的 Skill。手臂伸出去会改变质心,身体下蹲会改变腿部受力,迈步时需要重新组织支撑关系,一次看似简单的抓取,实际上可能需要整个身体共同参与。
过去常见的做法,是针对不同技能分别训练控制策略。行走有行走策略,跑步有跑步策略,起身、跳跃、遥操作和操作任务又分别使用不同的训练目标。技能数量不断增加之后,奖励设计、训练成本和策略之间的切换都会变得越来越复杂。
SONIC 给出的思路不同:与其不断训练新的 Skill,不如先训练一个足够通用的 Whole-Body Motion Tracker。
它把 Motion Tracking 作为人形机器人控制的基础任务,在超过 1 亿帧、约 611 小时的人体运动数据上扩大模型、数据和训练算力,最终得到一个能够跟踪大量全身动作的统一控制策略。在这个底座之上,游戏手柄、VR、视频、文字、音乐乃至 VLA,都可以通过不同接口向机器人提供运动目标,而不需要重新设计一套底层控制器。
更重要的是,SONIC 不只是做了一个更大的 Motion Tracker。它进一步建立了一套 Universal Motion Token,将机器人动作、人体动作和稀疏遥操作输入映射到同一种运动表示中。上层只需要描述“身体应该怎么运动”,底层控制器负责在真实物理约束下把这段运动稳定执行出来。
这让 SONIC 更像一个人形机器人的 Whole-Body Foundation:它不负责理解任务,却提供了一套可以被规划器、遥操作系统和 VLA 反复调用的全身运动能力。
1. 为什么要把 Motion Tracking 做成基础能力
先看一个简单场景。
机器人需要把地上的物体捡起来。
如果只从任务目标来看,这件事似乎只需要控制一只手:
把手移动到物体附近,然后抓住它。
但对于人形机器人,实际执行过程可能是:
走近目标,调整身体朝向,减速并站稳,降低身体高度,向前弯腰,改变双腿支撑状态,伸出手臂,抓住物体,然后重新调整重心并站起来。
手的目标只是其中一个约束。
真正需要控制的是整个身体。
这也是人形机器人和固定机械臂之间一个非常大的区别:移动和操作并不是两个完全独立的问题。
当手臂向前伸时,质心会发生变化;当机器人迈步时,左右脚的支撑关系不断切换;当身体快速转向、下蹲或者弯腰时,腰、腿和上肢都需要同时进行补偿。最终的动作是否成功,不只取决于末端执行器有没有到达目标,还取决于整个身体能否在过程中保持协调和平衡。
传统方法往往会把这些能力拆成很多单独的问题:
- 行走策略负责 locomotion;
- 上肢控制器负责 manipulation;
- 起身使用另外一个 policy;
- 跳跃、跑步、爬行继续增加新的 expert;
- 遥操作再单独训练一套控制器。
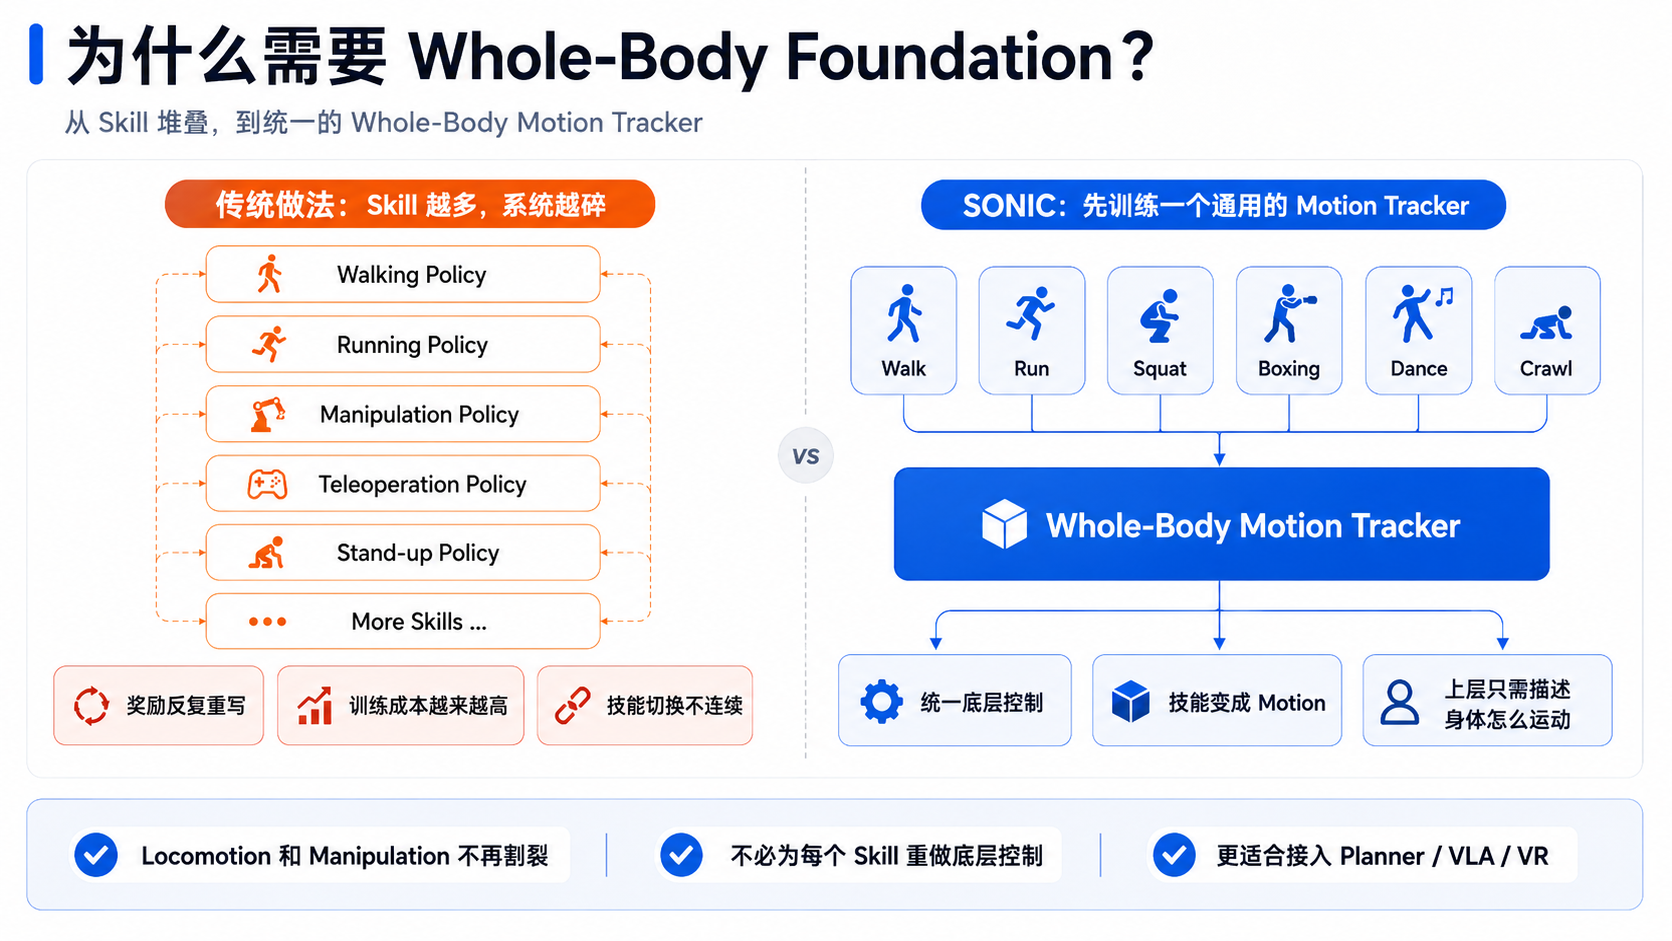
图 1|从 Skill 堆叠到统一 Whole-Body Motion Tracker。SONIC 不再为每个技能单独训练底层控制策略,而是把 Skill 转化为可跟踪的 Motion。
这在技能数量较少时是可行的。
但问题是,人形机器人的能力空间几乎没有明确边界。
正常走、快速走、跑步、侧移、转身、下蹲、跪地、爬行、跳跃、踢腿、挥手、搬运、推拉、双手操作……如果每增加一种行为,都需要重新设计奖励和训练一个新的控制策略,那么系统规模最终会被 Skill 数量拖住。
SONIC 因此把问题换了一个方向:
不训练“完成某个任务”的控制器,而是训练“跟踪任意合理全身运动”的控制器。
只要能够把“机器人接下来应该怎么运动”表达成一段参考 Motion,底层策略就负责把这段动作执行出来。
这样一来,Skill 不再被固化在控制器内部。
走路是一段 Motion,跑步是一段 Motion,拳击、下蹲、爬行也是 Motion。以后出现新的动作,也不一定需要重新设计一套控制奖励,而可以继续复用同一个 Motion Tracker。
这也是 SONIC 所谓 Supersizing 的真正含义。
作者没有把重点放在设计更多任务奖励上,而是把 Motion Tracking 本身扩大:
- 从百万级扩大到超过 1 亿帧 Motion;
- 从约 120 万参数扩大到 4200 万参数;
- 训练计算扩大到约 21000 GPU hours;
- 动作数据覆盖 locomotion、dance、combat、gesture、object manipulation、tool use 等大量不同类型的人体运动。
结果表明,随着数据、模型容量和计算量增加,Motion Tracking 在未见动作上的表现仍然持续提升。
所以 SONIC 真正想验证的并不是“42M 参数是不是足够大”,而是:
Motion Tracking 这个任务本身,能不能像视觉、语言模型一样,持续从更多数据和更大模型中受益。
论文给出的答案是肯定的。
2. 整个系统
理解 SONIC 最简单的方式,不是从 PPO 或 FSQ 开始,而是先把整个系统拆成三个层级。
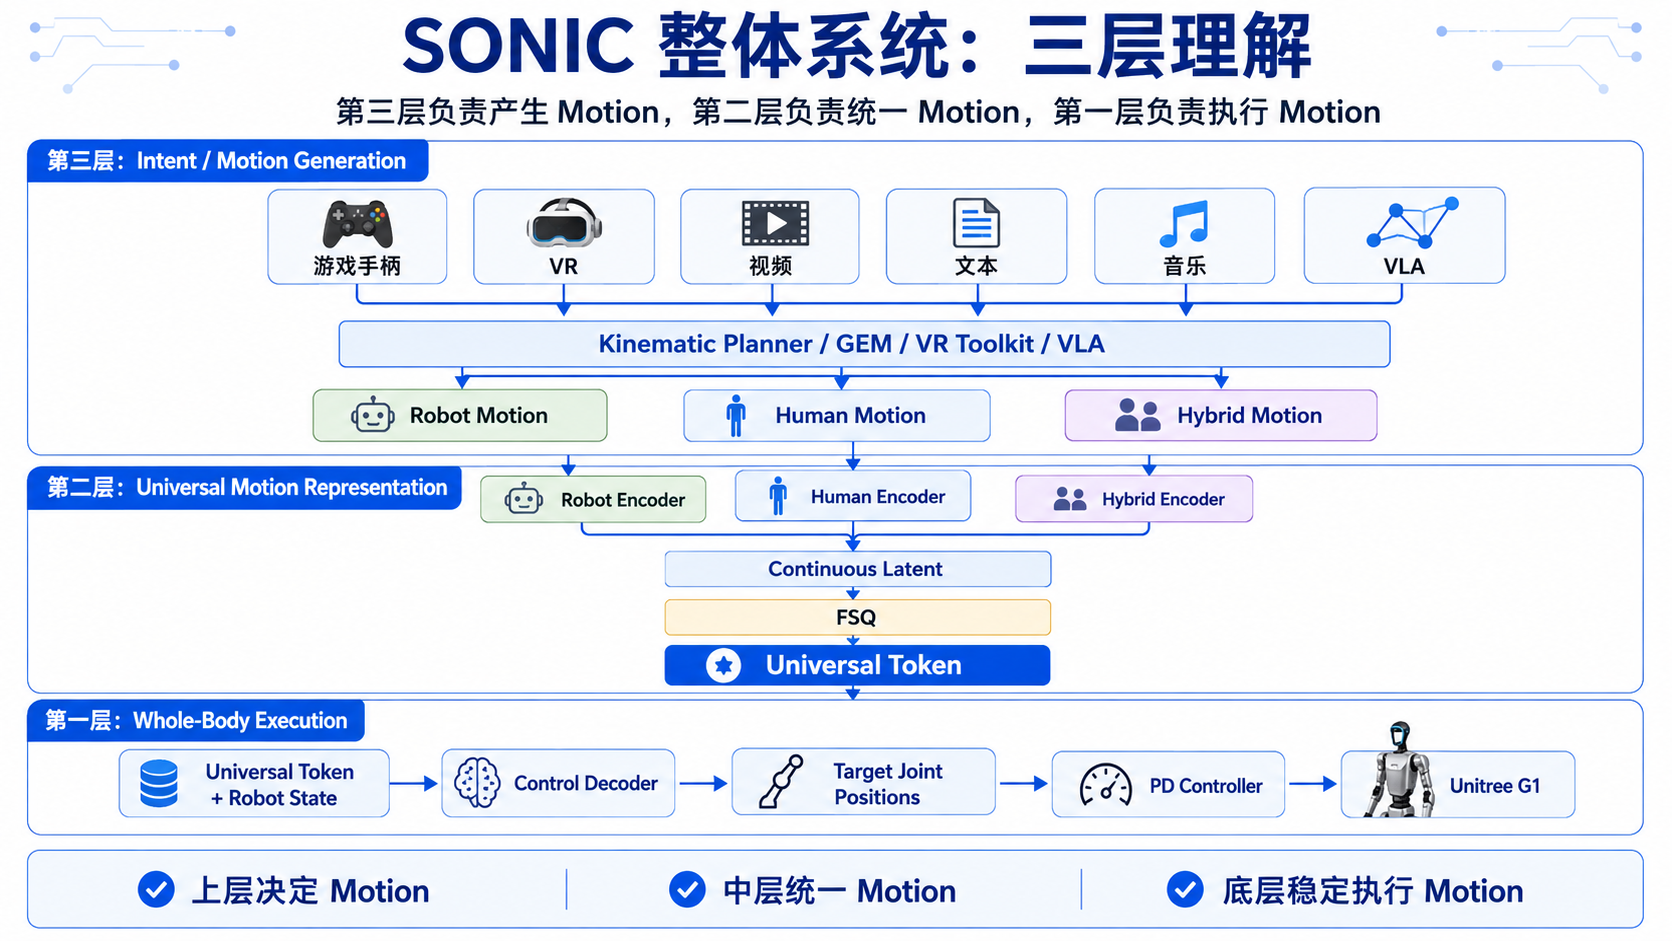
图 2|SONIC 的三层系统抽象:上层产生 Motion,中层统一 Motion,底层负责把 Motion 稳定执行到真实机器人。
这三个层级分别回答三个问题:
第三层:机器人接下来想做什么?
第二层:不同来源的动作,怎样变成同一种运动表示?
第一层:这段运动怎样在真实机器人上稳定执行?
整个链路可以概括为:
游戏手柄 / VR / 视频 / 文本 / 音乐 / VLA
                    ↓
        第三层:意图与 Motion Generation
                    ↓
     Robot / Human / Hybrid Motion
                    ↓
       第二层:Universal Motion Representation
                    ↓
             Universal Token
                    ↓
        第一层:Whole-Body Execution
                    ↓
          Target Joint Positions
                    ↓
                PD Control
                    ↓
              Unitree G1
这里最重要的一点是:
三层并不试图解决同一个问题。
它们之间有非常清晰的职责划分。
第三层 —— 决定“身体接下来应该怎么运动”
第三层负责处理外部输入和任务意图。
输入可能来自很多完全不同的来源。
例如游戏手柄只能提供:
- 前进速度;
- 移动方向;
- 朝向;
- 行走风格;
- 下蹲高度;
- 某个技能指令。
这些信息还不是完整的人形机器人动作,因此 SONIC 使用 Kinematic Planner,根据这些高层命令生成未来一小段完整的 Robot Motion。
视频、文字和音乐又是完全不同的问题。
RGB 视频里没有机器人关节角,“向前走”“左手出拳”这样的文字也不是 Motion。SONIC 因此接入 GEM,把视频、文字和音乐先转换成人体运动,再送到后续系统。
VR 也是类似的。
如果使用全身 VR,可以直接获得比较完整的人体动作;如果只有头显和两个手柄,系统只能观察头部和双手,此时下半身 Motion 需要由 Planner 补全。
所以第三层的职责可以概括成一句话:
把人的意图、环境输入或者交互命令,转化成一段结构化的 Motion。
这一层给到下一层的,不是电机指令,而主要是三种运动形式:
- Robot Motion;
- Human Motion;
- Hybrid Motion。
除此之外,还有一种特殊情况:VLA 可以学习直接预测后面要介绍的 Universal Token,从而绕过显式 Motion Encoding。
第二层 —— 把不同 Motion 翻译成同一种“运动语言”
第三层产生的三种 Motion 格式并不一致。
Robot Motion 描述的是 G1 自己的关节运动。
Human Motion 描述的是人体骨骼或者 SMPL Motion。
Hybrid Motion 则可能同时包含头部、双手关键点以及规划器生成的下肢运动。
如果让底层控制器分别适配三种格式,就又回到了“每种输入对应一套控制逻辑”的老问题。
SONIC 因此在中间加入了一层统一动作表示。
它准备了三个 Encoder:
Robot Motion
     ↓
Robot Encoder
     ┐

Human Motion
     ↓
Human Encoder
     ├──→ Shared Motion Representation

Hybrid Motion
     ↓
Hybrid Encoder
     ┘
三个 Encoder 虽然输入完全不同,但都被要求把“相同的动作”编码到相近的位置。
不过,Encoder 输出还不是最终的 Universal Token。
Encoder 首先得到一个连续的 latent representation,之后再经过 FSQ,也就是 Finite Scalar Quantization,把连续表示量化到一个有限的动作空间中。
所以更准确的链路是:
Motion
  ↓
对应 Encoder
  ↓
Continuous Latent
  ↓
FSQ
  ↓
Universal Token
这个 Universal Token 就成为 SONIC 中真正统一的 Motion Interface。
从这一刻开始,下游控制器不再关心动作最初来自:
- MoCap;
- 游戏手柄;
- 视频;
- VR;
- 文本;
- 还是 VLA。
它只需要处理统一的 Universal Token。
这也是 SONIC 很关键的一步:统一的不是输入设备,而是输入设备最终表达的“运动含义”。
第一层 —— 把 Motion 变成真实的 Whole-Body Control
有了 Universal Token,还没有结束。
因为“知道应该做什么动作”和“真实机器人能够把动作做出来”是两件不同的事情。
同一段目标 Motion,在机器人状态不同的时候,需要完全不同的瞬时控制。
例如机器人正在稳定站立时执行一个抬腿动作,与机器人刚刚受到外部推力后执行同一个抬腿动作,关节应该采取的补偿显然不同。
因此 SONIC 的 Control Decoder 不只读取 Universal Token。
它还读取机器人当前的 proprioception,包括:
- 关节位置;
- 关节速度;
- 根节点角速度;
- 重力方向;
- 上一个动作;
- 最近一段时间的历史状态。
Control Decoder 根据:
机器人现在是什么状态 + 接下来应该做什么 Motion
输出当前控制时刻的 29 个目标关节位置。
随后这些 target joint positions 被发送给机器人底层 PD Controller,再真正作用到电机。
于是完整执行过程变成:
Universal Token
        +
Current Robot State
        ↓
Whole-Body Control Decoder
        ↓
Target Joint Positions
        ↓
PD Controller
        ↓
Motors
        ↓
Robot State Changes
        ↓
下一控制周期重新读取状态
这形成了一个持续运行的闭环。
所以 SONIC 不是在“播放 Motion”。
它是在不断回答:
以机器人当前真实状态来看,为了继续跟上目标 Motion,这一刻应该怎样控制全身?
这也是 Motion Tracker 和简单 Motion Player 最本质的区别。
到这里,SONIC 的整体系统已经可以压缩成三句话:
第三层负责产生 Motion。
第二层负责统一 Motion。
第一层负责执行 Motion。
接下来真正值得追问的问题是:
Robot Motion、Human Motion 和 Hybrid Motion 的数据结构差别这么大,SONIC 到底怎样把它们压进同一个 Universal Token?
以及:
如果所有输入最终都要共享一个 Token Space,怎么保证“同一个动作”不会被三个 Encoder 编码成三套完全不同的语言?
这就要进入 SONIC 最核心的 Universal Motion Representation。
3. 不同的身体语言,怎样翻译成同一种 Universal Token?
上一节留下了一个关键问题:
Robot Motion、Human Motion 和 Hybrid Motion 的数据格式完全不同,为什么最后可以交给同一个 Control Decoder?
答案就在 SONIC 的第二层:Universal Motion Representation。
这也是整篇论文里最值得讲透的一部分。
3.1 三种 Motion,本质上描述的是同一件事
先看 Robot Motion。
这是最接近机器人本体的一种表达方式。它直接描述 Unitree G1 接下来应该如何运动,包括机器人未来若干帧的关节位置、关节速度等信息。
SONIC 的 Robot Encoder 每次会观察未来 10 帧参考动作,采样间隔为 0.1 秒。也就是说,它看到的不是“这一帧应该摆成什么姿势”,而是接下来大约 1 秒的运动趋势。
这一点很重要。
假设机器人即将起跳,如果只告诉它当前应该下蹲,它并不知道接下来是要站起来、继续蹲下还是马上离地。而给出一段未来 Motion 后,控制器就能提前知道:
接下来要下蹲、蹬地、腾空,然后准备落地。
于是它可以提前组织身体。
Human Motion 则完全不同。
这里输入的是人体三维关节点运动,例如从 MoCap、SMPL、全身 VR 或视频中获得的人体动作。
Human Encoder 同样使用 10 帧,但采样间隔只有 0.02 秒,大约覆盖未来 0.2 秒。人体动作输入更密集,同时也更适合实时遥操作场景。
第三种是 Hybrid Motion。
它主要服务于三点 VR。操作者只有头显和两个手柄,因此系统能够实时知道:
- 头在哪里;
- 左手在哪里;
- 右手在哪里。
但它并不知道人的腿接下来怎么走。
SONIC 的处理方式并不是强行从三个点直接猜整个人体,而是把任务拆开:
上半身由操作者实时提供,下半身由 Kinematic Planner 生成。
最终形成:
当前头部和双手关键点
        +
未来下半身 Robot Motion
        ↓
Hybrid Motion
这三类 Motion 输入格式完全不同,但它们可以描述同一个动作。
比如“向前走一步,同时右手向前伸”。
这个动作可以被表示成:
- 一段 G1 的机器人关节轨迹;
- 一段人体 SMPL Motion;
- 三点 VR 上半身输入 + Planner 生成的腿部运动。
SONIC 真正想做的是:
无论这个动作最初用什么格式表达,进入机器人控制系统之后,都应该变成同一种“运动语言”。
3.2 三个 Encoder 先把输入送进同一个连续空间
SONIC 为三种 Motion 分别设计了三个 Encoder:
Robot Motion
    ↓
Robot Encoder

Human Motion
    ↓
Human Encoder

Hybrid Motion
    ↓
Hybrid Encoder
三个 Encoder 都使用 MLP。
这里没有一个巨大的 Transformer 去一次处理几十秒动作,也没有把整条动作序列全部塞进网络。
实际训练和执行始终围绕一个局部 Motion Window 展开。
Encoder 做的第一件事,是把不同输入格式转换成一个连续 latent representation。
所以严格来说:
Motion
  ↓
Encoder
  ↓
Continuous Latent
到这里还没有 Universal Token。
真正的 Universal Token 出现在下一步。
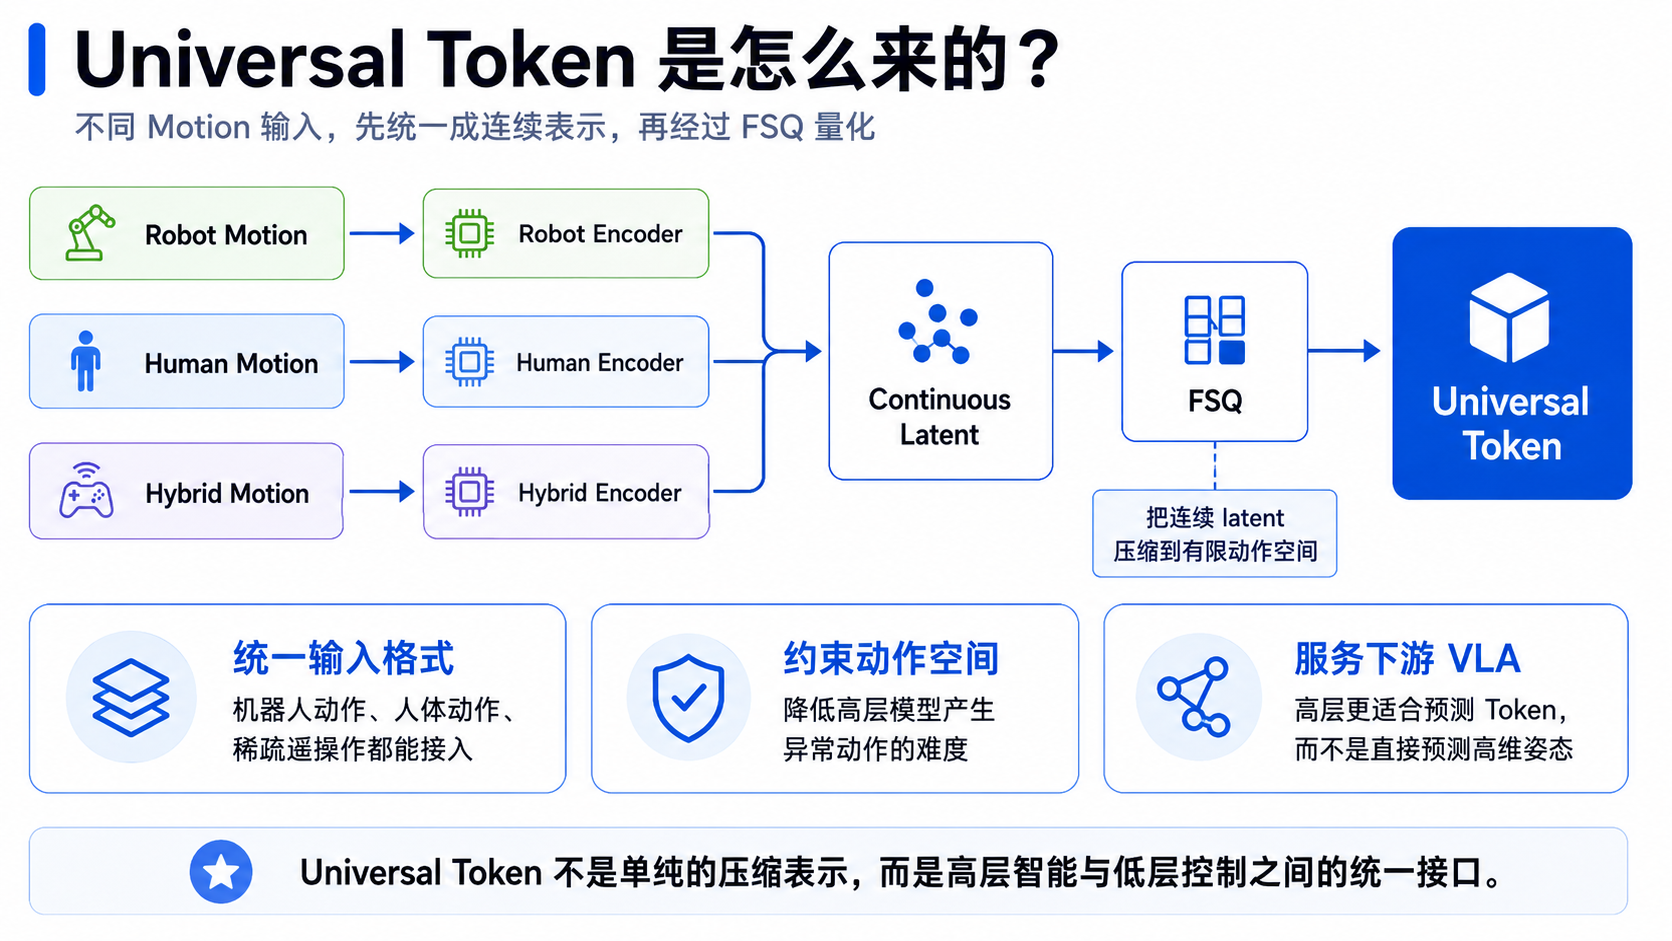
图 3|Universal Token 的形成过程。Robot、Human 和 Hybrid Motion 先通过不同 Encoder 映射到共享连续表示,再经过 FSQ 得到统一的动作 Token。
3.3 FSQ:把连续 Motion 压进一个受约束的动作空间
Continuous Latent 接下来会进入 FSQ,也就是 Finite Scalar Quantization。
可以把它理解为:
不再允许 latent 中的每一个维度随意取任意连续值,而是让它落到有限的量化等级中。
最终:
Continuous Latent
       ↓
      FSQ
       ↓
Universal Token
SONIC 默认使用两个 token,每个 token 为 32 维,因此形成一套 64 维的全身运动表示。
为什么要多做一次 FSQ?
如果只是为了控制机器人,理论上完全可以把连续 latent 直接交给 Control Decoder。
但 SONIC 想做的事情比“压缩动作”更大。
第一,限制 Motion Space
原始人体姿态和机器人关节空间都非常高维。
高层模型如果直接在这些空间里预测动作,很容易生成数据分布之外的奇怪姿态。
经过 FSQ 后,高层面对的是一个已经从大量 Motion 中学习出来的、相对规整的动作空间。
第二,让不同 Encoder 更容易说同一种语言
Robot Encoder、Human Encoder 和 Hybrid Encoder 本来完全可以各自形成一套 latent。
这样虽然每一套都可能能够控制机器人,但这个空间就失去了“Universal”的意义。
FSQ 配合后面要讲的几类一致性损失,会进一步约束三种输入落入同一套 Motion Representation。
第三,也是最关键的一点:给 VLA 一个更适合学习的动作接口
SONIC 后面做了一个非常重要的实验。
让 VLA 直接预测人体 SMPL Pose,与让 VLA 预测 Universal Token 进行对比。
在复杂的 soda-can-to-trash-can 任务中,机器人需要:
- 走到桌前;
- 拿起饮料罐;
- 走到垃圾桶;
- 一只脚踩垃圾桶踏板;
- 另一只脚保持单腿支撑;
- 最后把饮料罐扔进去。
使用 Universal Token 时成功率达到 60%,直接预测 SMPL Pose 则为 0%。
从这个角度看,Universal Token 真正有意思的地方并不是“它只有 64 维”。
而是:
高层 VLA 不再需要自己重新学一次人形机器人应该怎样保持平衡、怎样组织全身关节,而是在一个已经包含大量 Whole-Body Motion Prior 的空间里做决策。
所以 Universal Token 更像高层智能和低层身体之间的一套标准接口。
4. Universal Token 怎么变成真实机器人动作?
到这里,我们只是知道了“身体应该怎么运动”。
但机器人最终需要的是电机命令。
SONIC 的第一层解决的就是这个问题。
4.1 Control Decoder 不只读取 Token
一个非常重要的细节是:
Control Decoder 的输入不是只有 Universal Token。
它还会读取机器人的实时 proprioception,包括:
- 当前关节位置;
- 当前关节速度;
- Root Angular Velocity;
- Gravity Vector;
- 上一个 Action;
- 最近 10 个控制时刻的历史状态。
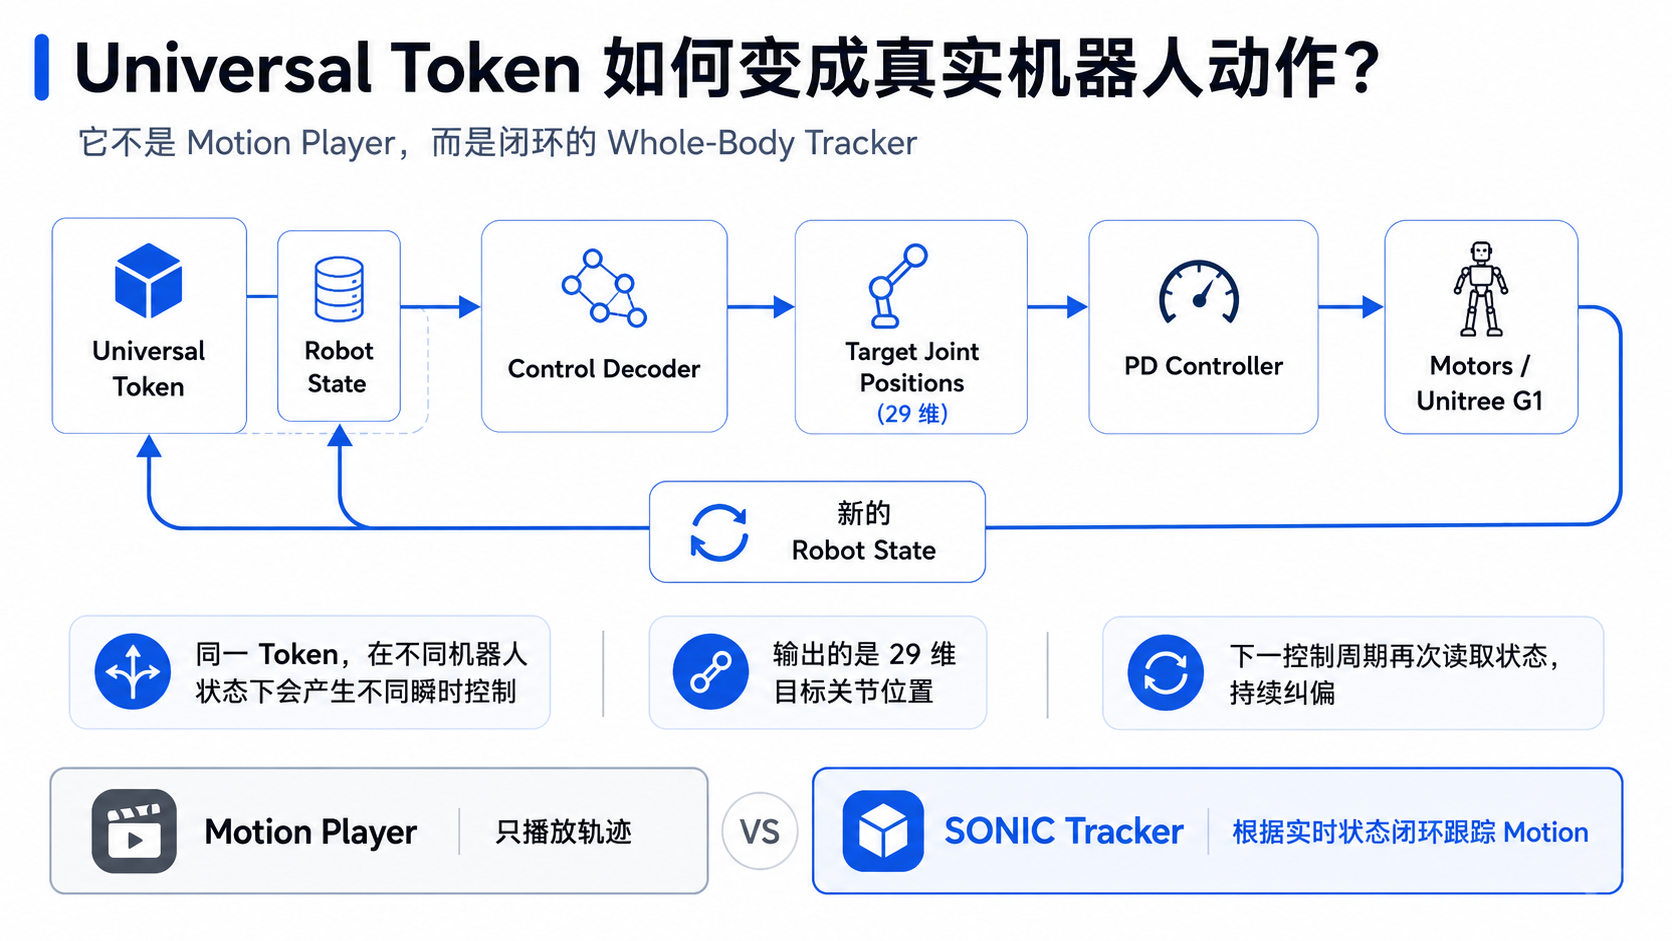
图 4|SONIC 的闭环执行链路。同一个 Universal Token 会根据机器人实时状态产生不同的瞬时控制,并在每个控制周期持续纠偏。
也就是说,它真正解决的问题是:
在机器人当前这个真实状态下,为了继续跟上目标 Motion,现在这一刻应该输出什么?
假设目标 Token 表达的是“向前迈一步”。
机器人当前非常稳定时,策略可以正常抬腿。
但如果机器人刚刚受到一个侧向推力,它可能需要:
- 调整腰部;
- 改变另一条腿的支撑;
- 推迟一点摆腿;
- 改变部分关节目标;
最终仍然继续完成这个“向前迈一步”的 Motion。
所以:
Universal Token 描述的是 Motion Intent,而 Control Decoder 输出的是当前状态下实现这个 Intent 的瞬时控制。
4.2 最终输出 29 个 Target Joint Positions
SONIC 的 Action Space 本身并不复杂。
Control Decoder 最终输出 G1 的 29 维目标关节位置。
随后这些目标位置交给关节级 PD Controller。
完整执行链变成:
Universal Token
        +
Robot State
        ↓
Control Decoder
        ↓
29 DoF Target Joint Positions
        ↓
PD Controller
        ↓
Motor
        ↓
机器人运动
下一控制周期,策略重新读取机器人最新状态,再重新计算下一步动作。
于是形成:
目标 Motion
   ↓
当前机器人状态
   ↓
计算控制
   ↓
机器人运动
   ↓
重新读取状态
   ↓
继续纠偏
这就是一个完整闭环。
也正因为如此,SONIC 不是一个 Motion Player。
如果只是 Motion Player,它只会:
第 100 帧播放第 100 帧关节角,第 101 帧播放第 101 帧关节角。
至于机器人有没有因为地面摩擦不同、受到扰动或者电机误差而偏离,它并不知道。
SONIC Tracker 则始终在根据真实状态回答:
我现在已经偏了多少?下一步应该怎么纠回来?
5. 这个 Universal Motion Space 是怎么学出来的?
前面一直在说:
- 三种 Encoder 要说同一种语言;
- Token 要保留足够完整的 Motion 信息;
- Robot Control Decoder 还要真的能控制机器人。
问题是,这几件事并不会自然同时发生。
所以 SONIC 的训练不只是一个 PPO Loss。
整个系统使用四类学习目标:
- PPO;
- Reconstruction;
- Token Alignment;
- Cycle Consistency。
它们分别解决四个完全不同的问题。
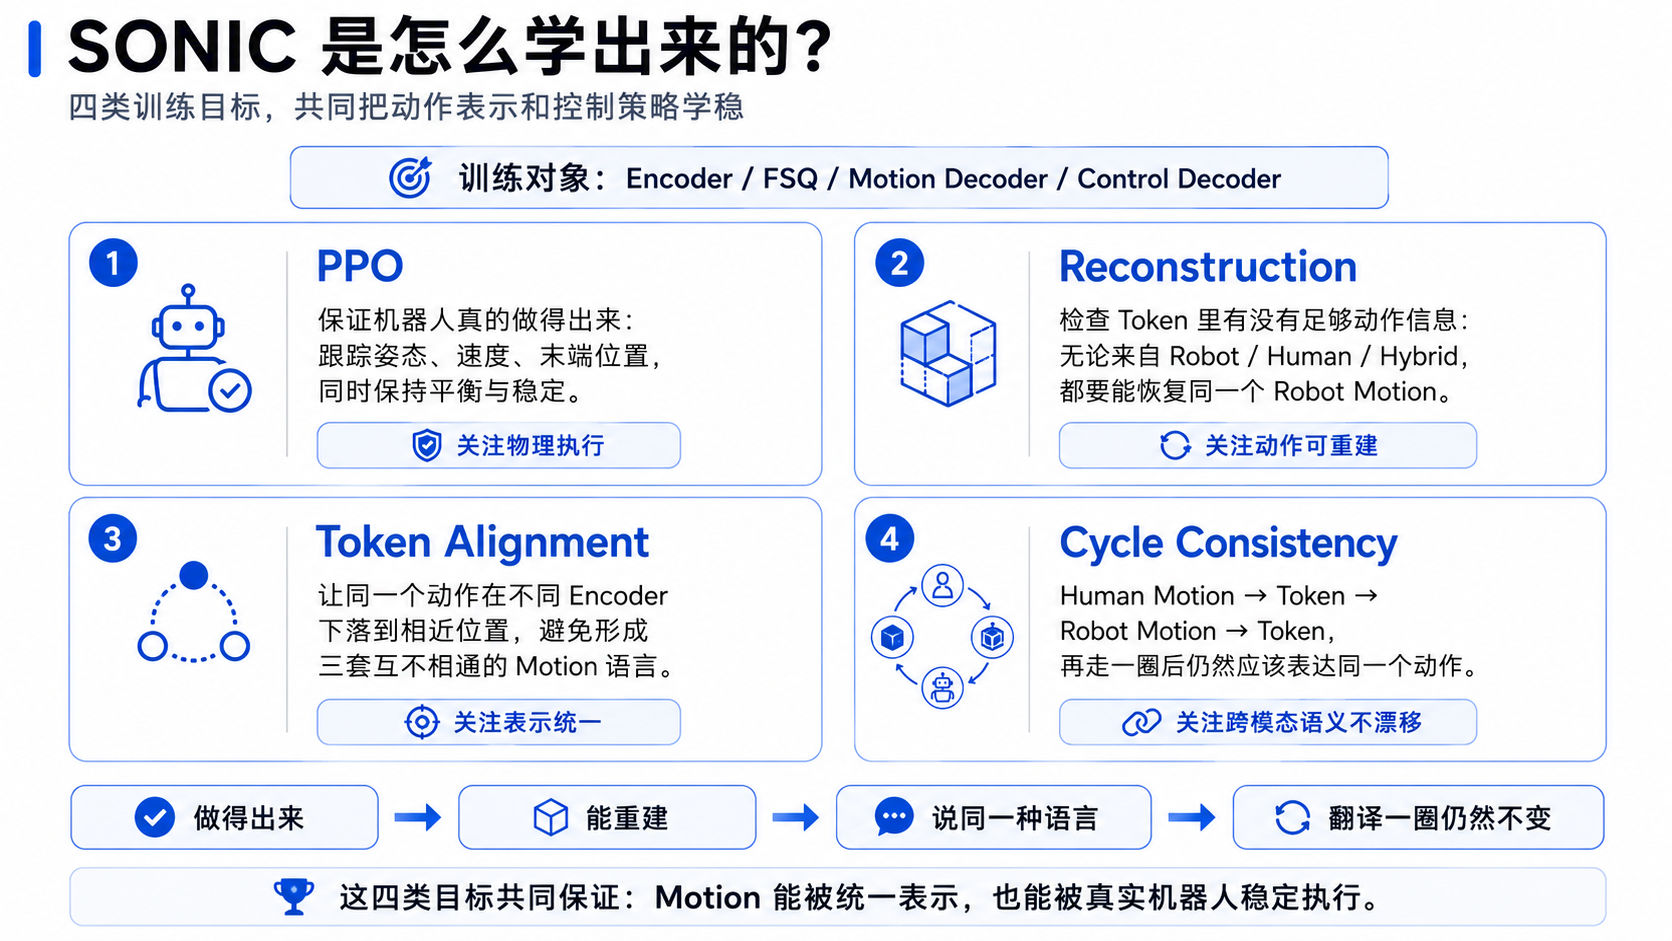
图 5|SONIC 的四类训练目标。PPO 保证物理执行,Reconstruction 保证动作信息完整,Token Alignment 对齐不同输入表示,Cycle Consistency 防止跨模态转换后的动作语义漂移。
5.1 PPO:先保证机器人真的做得出来
PPO 解决的是最底层的物理问题。
参考 Motion 再漂亮,如果机器人在仿真里一执行就摔倒,这个 Motion Representation 就没有实际价值。
因此 PPO 会不断评价机器人:
- Root Position 有没有跟上;
- Root Orientation 有没有跟上;
- 身体各个 Link 的位置对不对;
- 身体各 Link 的姿态对不对;
- 线速度和角速度对不对;
- 手、脚、头等末端位置对不对。
除此之外,还会约束:
- 动作变化不能过于剧烈;
- 关节不能超限;
- 不应该发生不合理接触;
- 头和手不能高频抖动;
- 脚部运动不能过于突兀。
所以 PPO 关注的是:
这个 Motion 在物理世界里到底能不能稳定做出来。
5.2 Reconstruction:Token 里面到底有没有完整动作信息?
SONIC 还有一个 Robot Motion Decoder。
它不是拿来直接控制电机的,而是做另外一件事:
从 Universal Token 中重新恢复 Robot Motion。
例如:
Robot Motion
    ↓
Robot Encoder
    ↓
Token
    ↓
Robot Motion Decoder
    ↓
恢复 Robot Motion
如果 Token 已经把动作信息丢掉了,那么恢复出来的 Motion 就会出现明显误差。
更重要的是,Human Token 和 Hybrid Token 也必须能恢复同一个 Robot Motion。
于是:
Human Motion
    ↓
Human Encoder
    ↓
Token
    ↓
Robot Motion Decoder
    ↓
Robot Motion
这条路径实际上已经形成了一个 Learned Retargeting Pipeline。
以前 Human-to-Robot Retargeting 可能需要在运行时不断做优化或 IK。
SONIC 仍然依赖离线 retargeting 数据作为训练监督,但在系统真正运行时,这个映射已经被学进了 Human Encoder 和 Motion Decoder。
因此 Reconstruction Loss 要回答的是:
这个 Token 里面是否真的保留了足够的 Motion 信息?
5.3 Token Alignment:三个 Encoder 说的是不是同一种语言?
仅有 Reconstruction 仍然不够。
因为完全可能出现:
Robot Encoder → 一套 latent

Human Encoder → 另一套 latent

Hybrid Encoder → 第三套 latent
只要 Motion Decoder 足够强,它甚至有可能分别理解这三种 latent,并把它们都恢复成正确 Motion。
从 Reconstruction 的角度看,一切正常。
但对于 VLA 来说,这就麻烦了。
同一个“向前走”:
- 从 Robot Motion 来时是一个 Token;
- 从 Human Motion 来时又是另一个完全不同的 Token;
- 从 VR 来又变成第三个。
那这个 Token Space 就不再是统一接口。
所以 SONIC 会直接要求:
同一段 Motion 从不同 Encoder 进入后,得到的 Token 应该尽可能靠近。
这就是 Token Alignment。
它解决的是:
不同数据格式能不能真正映射成同一种 Motion Language。
论文的 latent space 可视化也显示,去掉一致性损失后,不同 Encoder 之间的 token distance 会明显增大。
5.4 Cycle Consistency:翻译一圈之后,还是不是同一个动作?
最后还有一个看起来很绕,但其实非常直观的 Cycle Consistency。
来看这样一条路径:
Human Motion
     ↓
Human Encoder
     ↓
Human Token
     ↓
Robot Motion Decoder
     ↓
Robot Motion
     ↓
Robot Encoder
     ↓
Robot Token
问题来了:
从 Human Motion 翻译出来的 Robot Motion,重新被 Robot Encoder 理解以后,它还认为这是同一个动作吗?
如果答案是否定的,说明中间的 Human-to-Robot 转换虽然可能“表面上看起来差不多”,但已经发生了语义漂移。
Cycle Consistency 就负责检查这一点。
最简单的理解方式是:
Reconstruction 检查翻译结果对不对。
Cycle Consistency 检查翻译一圈以后,动作含义有没有变化。
例如原始动作是“右脚向前跨一步”。
如果 Human Encoder → Motion Decoder 最终虽然重建出了一个大致相似的腿部动作,但重新编码后却更接近“原地抬腿”,那说明中间映射仍然不够稳定。
Cycle Consistency 就会继续把它往正确的 Robot Motion Representation 拉。
5.5 四个目标真正构成了一个闭环
现在再回头看这四类 Loss:
PPO
→ 做得出来

Reconstruction
→ 能恢复出来

Token Alignment
→ 三种输入说的是同一种语言

Cycle Consistency
→ 跨模态翻译一圈后语义仍然不变
可以发现,它们其实是在从两个不同方向验证 Motion。
一边是:
Representation 是否正确?
另一边是:
Physics Execution 是否正确?
SONIC 不是只训练一个漂亮 latent,也不是只训练一个会走路的 PPO。
它真正希望得到的是:
既可以统一表示大量 Motion,又可以直接落到真实机器人控制上的 Motion Foundation。
6. 611 小时动作,SONIC 是一整段一整段训练的吗?
答案是否定的。
SONIC 数据规模达到超过 1 亿帧,但网络真正看到的始终是一个局部时间窗口。
6.1 Reference 看未来,机器人状态看过去
Robot Encoder 大约看到未来 1 秒 Robot Motion。
Human Encoder 大约看到未来 0.2 秒 Human Motion。
Control Decoder 的 proprioception 则包含过去 10 个时刻的机器人状态。
所以在一个控制时刻,策略看到的信息大致可以理解为:
过去约 0.2 秒
机器人刚才发生了什么
           ↓
        当前时刻
           ↑
未来约 0.2~1 秒
接下来应该做什么
这种结构其实很符合控制问题本身。
过去告诉策略:
我的身体刚才怎么运动,现在处于什么趋势?
未来告诉策略:
我接下来准备干什么?
然后策略决定:
那这一刻应该怎么动。
6.2 PPO 也不是拿几十秒 Motion 一次反向传播
SONIC 每个环境一次采集 24 个 control step。
策略运行在 50 Hz,因此一次 PPO rollout 覆盖大约半秒。
一条几十秒 Motion 可以连续执行,但 PPO 的经验收集和优化始终按固定长度 chunk 进行。
另外,作者还把长 Motion 按约 1 秒划分为多个 bin。
训练时会记录:
哪些动作片段最容易失败?
比如:
- 跳跃落地;
- 快速转身;
- 单腿支撑;
- 极低姿态。
失败率越高的 bin,会被提高训练采样概率。
所以系统不会一直把算力浪费在早已学会的简单站立或正常走路上。
它会不断回去“补课”。
这也是大规模 Motion Tracking 能够真正训练起来的一个重要工程细节。
7. Kinematic Planner、GEM 到底处在什么位置?
前面讲了大量 Encoder、Token 和 Tracker,但还有一个问题:
Universal Token 的上游 Motion 从哪来?
这里 SONIC 并没有试图用一个模型包办全部事情。
相反,它用了几个不同 Motion Generator。
7.1 Kinematic Planner:把“我要去哪”变成“身体怎么动”
用户推动游戏手柄时,输入的可能只是:
向前 2 m/s,朝左前方走。
这显然不是一个完整的人形动作。
Kinematic Planner 会把这个高层命令扩展成短期的 Robot Motion:
Velocity / Heading / Style
          ↓
Kinematic Planner
          ↓
Future Robot Motion
          ↓
Robot Encoder
这个 Planner 自身使用大规模 Motion 数据训练。
它每次处理大约 0.8 到 2.4 秒的运动片段,本质上在做 Motion In-betweening:
已知动作从哪里开始,也知道未来希望到哪里,中间这一小段怎样走得自然?
运行时 Planner 最快可以每 100 ms 重规划一次。
所以机器人改变速度、转向或者动作风格时,并不是直接把一个新的关节姿态硬切进来,而是重新生成一段平滑过渡 Motion。
这也是 SONIC 能做到:
- walking → running;
- forward → sideways;
- standing → squatting;
- 不同 boxing 技能连续切换;
而不需要不断切换底层 Expert Policy 的原因。
7.2 GEM:把视频、文字和音乐变成人体 Motion
如果输入是视频,情况又完全不同。
RGB 画面里没有机器人关节角。
SONIC 并没有让 PPO 自己理解像素,而是把这个问题交给 GEM。
流程是:
Video
 ↓
GEM
 ↓
Human Motion
 ↓
Human Encoder
 ↓
Universal Token
文本也是一样:
“Punches with his left arm”
             ↓
            GEM
             ↓
       Human Motion
音乐则先被转换成与节奏、旋律匹配的人体舞蹈 Motion。
因此严格来说:
SONIC 本身并不理解文字、音乐和视频。
GEM 负责“把这些模态翻译成人怎么运动”。
SONIC 负责“把人的运动翻译成机器人如何稳定执行”。
这种模块划分反而让整个系统更加清晰。
7.3 VLA 是最特殊的一条路径
前面的 Planner 和 GEM 最终都先产生 Motion,再经过 Encoder 和 FSQ。
VLA 可以更直接。
它学习直接预测 Universal Token。
于是链路缩短为:
Vision + Language
        ↓
       VLA
        ↓
Universal Token
        ↓
Whole-Body Tracker
这也是 Universal Token 真正开始体现“Foundation Interface”价值的地方。
上层 VLA 不需要知道:
- 脚什么时候应该落地;
- 左右腿怎样切换支撑;
- 腰如何补偿手臂动作;
- 每个关节现在应该输出多少角度。
这些 Whole-Body Prior 已经被压到了 Token 和 Tracker 中。
VLA 只需要决定:
接下来应该处于什么样的 Whole-Body Motion。
8. Supersizing 到底有没有用?
SONIC 标题里的关键词是 Supersizing。
作者真正想验证的问题是:
人形 Motion Tracking 能不能像其他 Foundation Model 一样,继续从更多数据、更大模型和更多算力里获益?
论文分别从三个方向做了 Scaling。
8.1 更多 Motion Data
训练数据从:
4M → 10M → 22M → 100M+ frames。
随着数据增加,尤其是在没有见过的动作类别上,Tracking Success 和 Tracking Accuracy 都持续改善。
8.2 更大的模型
Actor 从约 1.2M 参数扩大到:
16M → 42M。
在 test-content,也就是训练中从未出现过的动作内容上:
较小模型的 MPJPE-L 约为 27.7 mm,最大模型降低到约 23.8 mm;成功率也从约 98% 提高到约 99.6%。
8.3 更多训练算力
训练从约 2K GPU hours 扩大到 9K,再到约 21K GPU hours。
性能仍然继续上升。
因此 SONIC 真正想说明的并不是:
“我们用了 128 张 GPU,所以模型很强。”
而是:
Motion Tracking 这个学习目标,本身具有继续吃数据、吃模型容量和吃计算的能力。
这件事比某一项 benchmark 高几毫米更重要。
因为如果这个趋势成立,那么未来数据越来越多之后,不需要不断设计更多 Skill Reward,而可以继续把更多运动数据喂给同一个 Whole-Body Foundation。
这就是 SONIC 把 Motion Tracking 称为 foundational task 的底气。
9. SONIC 已经很强,但还不是“万能人形机器人”
SONIC 的 Demo 很容易给人一种感觉:
机器人会:
- 跑;
- 跳;
- 拳击;
- 跳舞;
- 下蹲;
- 跪地;
- 爬行;
- 视频遥操作;
- VR 遥操作;
- 文字控制;
- 音乐控制;
- VLA Loco-Manipulation。
是不是已经解决 Whole-Body Control 了?
还没有。
9.1 最难的仍然是 Contact
论文的 Sim-to-Real 结果很有意思。
整体 MPJPE-L:
- Simulation:约 22.3 mm;
- Real:约 25.7 mm。
差距并不夸张。
但如果只看 Foot:
- Simulation:约 29.0 mm;
- Real:约 53.7 mm。
误差几乎翻倍。
原因也很好理解。
空中挥手和真实世界踩地是两个难度完全不同的问题。
脚涉及:
- 摩擦;
- 地面刚度;
- 碰撞;
- 执行器延迟;
- 接触时刻;
- 足底受力。
这些都是 Sim-to-Real 最难拟合的部分。
9.2 持续复杂接触仍然会失败
作者展示的失败案例包括:
- 极低姿态的 zombie crawl;
- cross-legged sit。
共同特点是:
需要长期、复杂的多点地面接触。
这说明 SONIC 已经非常擅长大量动态人体 Motion,但“更多身体部位长期压在地面上”这类 Contact-rich Skill 仍然不容易。
9.3 SONIC 也不负责真正的高层任务理解
另外还必须划清一个边界:
SONIC 是非常强的“身体”。
但它不是完整的“大脑”。
它本身不负责:
- 看懂一个房间;
- 判断应该先拿哪个物体;
- 理解一句复杂任务指令;
- 做长时程任务规划。
视频、文本和音乐理解来自 GEM。
自主 manipulation 中的视觉语言决策来自 GR00T。
SONIC 负责的是:
不管上面是谁做决定,我都提供一个稳定、统一的 Whole-Body Execution Layer。
而恰恰是这一点,让它和人形 VLA 的发展路线产生了很强的联系。
10. 从 SONIC 到 COSA 0.5:Whole-Body Foundation 真正进入 VLA 系统
如果把 SONIC 看到这里,再看逐际动力发布的 COSA 0.5,会发现两套系统虽然具体实现不同,但背后存在一个非常清晰的共同判断:
真正的人形 VLA 不能把 locomotion 和 manipulation 当成两套独立系统,它需要一个能够持续接收全身目标、同时解决 Tracking 和 Balance 的 Whole-Body Foundation。
但如果说 SONIC 的重点是建立和验证这个 Whole-Body Motion Foundation,那么 COSA 0.5 已经进一步把它放进了完整的人形 VLA 技术栈。
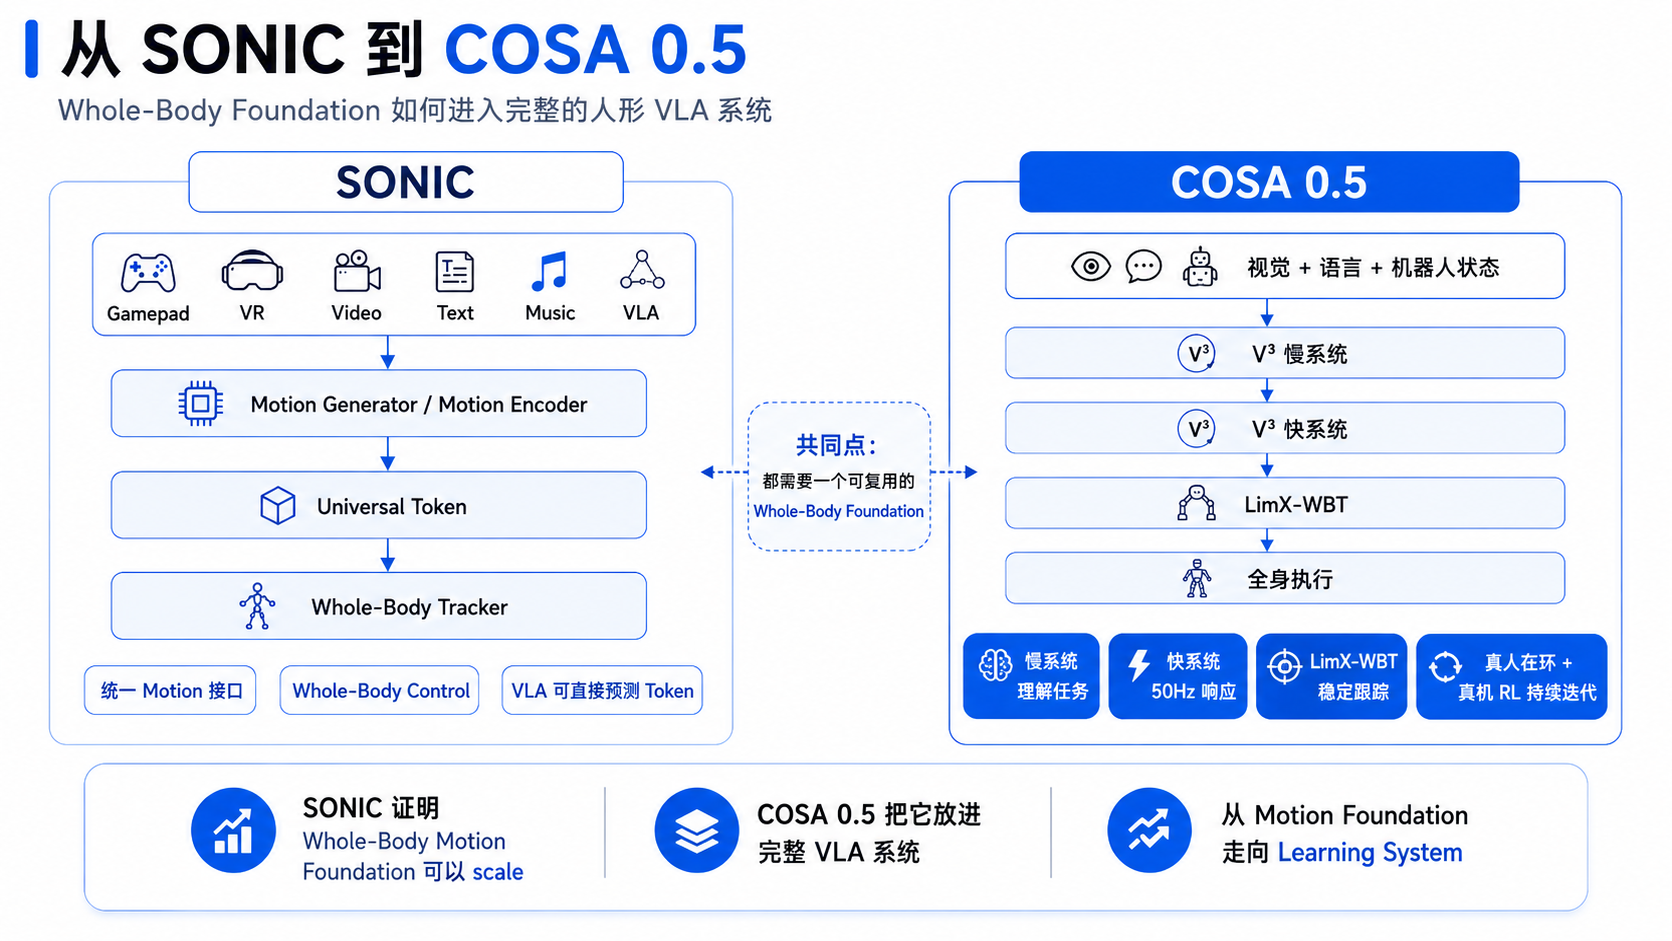
图 6|从 SONIC 到 COSA 0.5 的系统视角。两者都把可复用的 Whole-Body Foundation 作为底层能力,而 COSA 0.5 进一步向上构建了快慢 VLA,并加入真人在环与真机 RL 学习闭环。
10.1 SONIC 有 Whole-Body Tracker,COSA 有 LimX-WBT
先看最底层。
SONIC:
Universal Token + Robot State
          ↓
Whole-Body Tracker
          ↓
Joint Target
COSA 0.5:
Full-Body Motion Target
          ↓
LimX-WBT
          ↓
43-DoF Whole-Body Execution
两者在系统定位上非常接近:
上游负责给目标,底层 Tracker 负责把目标做出来,同时保持平衡。
COSA 对 LimX-WBT 的定位也非常明确。
它是一个与具体任务无关的 Whole-Body Tracker,只需要训练一次。无论上游是 VLA 还是人类遥操作,最终都转换成统一的全身运动目标,再交给 LimX-WBT 执行。
换句话说,LimX-WBT 本身不需要理解:
“我要把鲨鱼玩偶放到椅子上。”
它只需要处理:
下一段时间内,双手、双腿、底盘、头部应该去哪里,我怎样在不摔倒的情况下准确跟上这些目标?
这种分层带来的直接好处是:
上层任务模型和下层全身控制器可以独立迭代。
VLA 换了,不需要重新设计 Balance Controller。
遥操作方式变了,也不需要再造一套 locomotion policy。
这是一个非常重要的工程边界。
10.2 COSA 0.5 更进一步:把“理解”和“行动”也拆开
SONIC 重点解决的是:
如何构建一个 scalable Whole-Body Motion Foundation,以及如何让不同 Motion Source 接入它。
COSA 0.5 更进一步解决:
一个真正运行在动态真实环境中的人形 VLA,上层本身应该怎么组织?
V³-0 把 VLA 拆成两个不同时间尺度的系统。
V³ 慢系统 —— 理解
慢系统读取:
- 头部相机;
- 手腕相机;
- Language Instruction。
它负责理解:
- 视野里有什么;
- 物体在哪里;
- 用户让机器人做什么;
- 下一步任务是什么。
最终输出一个 compact Intent Latent。
慢系统运行频率低于 5 Hz。
因为“这是一个垃圾桶”“我要把这个物体放进去”这种语义,并不需要每 20 ms 重新理解一次。
V³ 快系统 —— 行动
快系统直接读取:
- 慢系统最近一次 Intent Latent;
- 当前相机画面;
- Robot State。
然后以 50 Hz 生成短时 Whole-Body Action Chunk。
其中包含:
- 双手目标;
- 双腿目标;
- 底盘目标;
- 头部目标。
快系统采用小型 flow-matching policy,只需少量去噪步骤,就能生成连续的短期目标轨迹。
这里有一个很重要的思想:
语义理解可以慢,但身体反应不能慢。
机器人走向桌子的几秒钟内:
- 自己的位置一直在变;
- 电机实际响应在变;
- 摩擦和动力学误差在积累;
- 人可能突然介入;
- 物体也可能移动。
如果每一次动作调整都必须等待大型 VLM 重新推理,控制回路一定跟不上真实世界。
所以 V³-0 不是单纯为了“节省计算”才做快慢拆分。
它是在系统层面明确区分:
Thinking 的时间尺度和 Acting 的时间尺度本来就不同。
这其实是 COSA 0.5 很漂亮的一点。
10.3 再往下,是第三个时间尺度:LimX-WBT
于是 COSA 0.5 最终形成:
V³ 慢系统
理解任务
< 5 Hz
    ↓

V³ 快系统
生成短时 Whole-Body Action Chunk
50 Hz
    ↓

LimX-WBT
实时 Tracking + Balance
控制频率运行
    ↓

43-DoF Oli
三个模块各自独立异步运行。
慢系统不阻塞快系统。
快系统不需要等待下一次语言理解。
Whole-Body Tracker 也不会因为上层模型正在推理而漏掉控制周期。
这相比“一个大模型从图像一路算到关节动作”的端到端想象,要更符合真实人形机器人的实际系统需求。
10.4 更有意思的是,COSA 直接拿 SONIC 做了同条件对比
这部分非常值得关注。
COSA 0.5 技术报告中,逐际动力在 Oli 上复现了一版 SONIC,并让它和 LimX-WBT 使用相同的训练数据和算力,在同一内部 Whole-Body Motion 测试集上进行对比。
报告给出的结果为:
| 指标 | SONIC | LimX-WBT |
|---|---|---|
| MPJPE | 13.75 mm | 12.85 mm |
| MPJAE | 3.3° | 1.5° |
| Joint-space jerk | 129.2 | 115.2 |
| Base orientation jerk | 113.0 | 90.3 |
在这个 matched-data、matched-compute 的内部 benchmark 中,LimX-WBT 不只是位置误差更低,姿态误差和运动平滑度也同时更好。
其中:
- MPJPE 约降低 7%;
- MPJAE 约降低 55%;
- Joint-space jerk 约降低 11%;
- Base orientation jerk 约降低 20%。
对于 Whole-Body Tracker 来说,“准”和“稳”通常需要一起考虑。
Tracking 很准,但每一个关节都在高频抖动,并不是好的真实机器人控制器;过度追求平滑,又可能让机器人始终跟不上 Motion Target。
因此能够同时降低 Tracking Error 和 Jerk,是一个更值得关注的结果。
当然,这仍然是逐际动力内部评测集以及其 SONIC 复现结果,不能直接等价为所有平台上的通用结论。但至少在同一机器人、同数据和同算力条件下,它说明 LimX-WBT 已经不只是一个“类似 SONIC 的底层模块”,而是在这一方向上继续向 Tracking Accuracy 和 Motion Smoothness 推进。
10.5 COSA 0.5 真正进一步的地方,是把系统做成了 Learning Loop
如果只是:
VLA
 ↓
Whole-Body Tracker
 ↓
Robot
那么 COSA 与 SONIC 的故事还只是“把 Whole-Body Foundation 接到 VLA”。
COSA 0.5 更有意思的部分其实在后面:
机器人失败以后怎么办?
行为克隆最大的一个问题是:
训练数据里没有见过的状态,真机运行时迟早会遇到。
抓偏一次、起点变化一点、执行器产生误差,机器人就可能进入 Demonstration Distribution 之外。
传统方式通常是:
失败 → 再收一批数据 → 重新训练。
COSA 0.5 把它变成一个持续闭环:
Expert Demonstration
        ↓
Behavior Cloning
        ↓
Robot Autonomous Rollout
        ↓
真实失败
        ↓
Human Intervention
        +
Failure Annotation
        ↓
Reward Model
        ↓
Real-Robot RL
        ↓
Policy Update
机器人自主执行任务时,专家可以随时接管整台机器人的 Whole-Body Control。
注意,这不是只把手腕拉回正确位置。
专家接管的是同一套全身运动链路。
因此机器人出现:
- 抓取偏差;
- 身体位置不合适;
- 无效重复动作;
时,专家可以直接重新组织整套 Whole-Body Motion,然后再把控制权平滑交还给策略。
这些真实失败片段又被用来训练 Reward Model,并进一步进行 Real-Robot RL。
COSA 0.5 报告中:
basket cleanup 任务的成功率从 18.01% 提升到 74.00%。
三个任务汇总后,失败率从 39.65% 降低到 11.33%。
这里反映出 COSA 0.5 与 SONIC 一个很有意思的阶段差异:
SONIC 重点证明 Motion Foundation 可以 Scale。
而 COSA 0.5 已经开始回答:
如何把 Motion Foundation 放进一个能从真实世界失败中持续学习的完整系统。
可以把它概括成:
从 Motion Foundation,走向 Learning System。
10.6 最终还是要回到“整理房间”
架构图、Token、Tracker、Flow Matching、RL 最后都只是手段。
COSA 0.5 最直观的 Demo 是让 Oli 连续整理一个真实房间。
机器人从角落进入,在接近 3 分钟的连续过程中:
- 把脏衣服放进洗衣篮;
- 把玩偶放到椅子上;
- 叠箱子;
- 收走桌面玩具;
- 扶正椅子;
- 把垃圾扔进桶里;
- 最后把钱包递给人。
整个流程没有任务之间的 Reset。
这件事真正难的并不是“夹爪能不能夹起一个玩具”。
难的是:
走到目标
   ↓
重新调整朝向
   ↓
减速
   ↓
弯腰
   ↓
伸手
   ↓
全身重新平衡
   ↓
抓取
   ↓
起身
   ↓
继续走向下一个目标
当任务变成长时间连续行为之后,Locomotion 和 Manipulation 已经没有一个真正清晰的边界。
这也是为什么 SONIC 和 COSA 最终都会走向 Whole-Body Foundation:
对于人形机器人来说,移动本身就是操作的一部分,操作也始终建立在移动和平衡之上。
COSA 0.5 进一步把这种 Whole-Body Execution 放进快慢 VLA 和真机学习闭环中,让“理解—行动—执行—再学习”真正形成了一条完整链路。
11. 对 Goal Tracking 的启发:也许不应该让一个 Policy 从 Goal 一路学到 Joint Action
最后回到一个更加基础、但几乎所有移动机器人都会遇到的问题:
Goal Tracking。
假设最终目标不是“向前走 1 m/s”,而是一个精确状态:
目标 x
目标 y
目标 base height
目标 yaw
甚至再加一个末端 6D Pose
最直接的做法当然是:
Goal
 ↓
RL Policy
 ↓
Joint Action
让一个 Policy 自己学会所有事情:
- 面向目标;
- 走过去;
- 过程中不断修正方向;
- 靠近后减速;
- 精确调整 x / y;
- 调整最终 yaw;
- 调整 base height;
- 选择最终双脚站姿;
- 站稳;
- 保持目标状态。
理论上可以。
但实际上,这相当于让一个策略同时解决:
Planning + Motion Generation + Balance + Tracking。
SONIC 和 COSA 给了一个非常值得借鉴的拆法。
结语
SONIC 表面上是一篇“大规模 Motion Tracking”的论文。
但如果只看到:
- 1 亿帧;
- 42M 参数;
- 128 GPU;
- 99% Tracking Success;
其实会错过它更重要的意义。
它真正做的是重新划分人形机器人的系统边界。
过去,我们习惯按照 Skill 划分能力:
走路、跑步、跳跃、遥操作、Manipulation。
SONIC 换了一种划分方式:
上层
决定接下来想怎么运动

中层
把各种 Motion 统一成一种表示

底层
在物理世界中稳定执行
一旦这个边界成立,Skill 就不再一定对应 Policy。
Skill 可以变成 Motion。
Motion 可以变成 Token。
Token 可以成为 VLA 和机器人身体之间的接口。
而 COSA 0.5 进一步展示了这条路线进入完整人形 VLA 之后的形态:
慢系统
理解任务
   ↓
快系统
高频生成 Whole-Body Action
   ↓
LimX-WBT
稳定执行
   ↓
真实机器人
   ↓
Human-in-the-loop + Real-Robot RL
   ↓
继续学习
如果说 SONIC 回答的是:
一个可扩展的 Whole-Body Motion Foundation 应该是什么样?
那么 COSA 0.5 已经进一步开始回答:
如何把这样的 Whole-Body Foundation 真正变成人形 VLA 系统的一部分,并让它在真实世界中持续行动、失败、纠正和学习?
对今天的人形机器人来说,这可能比继续增加第 101 个 Skill 更重要。
参考
- SONIC: Supersizing Motion Tracking for Natural Humanoid Whole-Body Control
- COSA 0.5:《COSA 0.5 发布:人形 VLA V³-0 的全身能力升级》:https://www.limxdynamics.com/cosa05v3/#zh
sonic部署延迟蛮高的
强啊
这是好事啊!
之前看论文的时候一直没完全想明白 Universal Token 到底解决了什么,看完这里才比较有感觉。