
CVPR2026-SaPaVe:机器人终于学会“转头再动手”,VLA 从固定视角走向主动感知
让机器人“拿起柜子里的白碗”,听起来并不复杂。
但如果柜门挡住了头部相机,第三人称相机也被机械臂遮住,目标根本不在当前画面里呢?
多数 Vision-Language-Action(VLA)模型的默认逻辑是:看图、理解指令、生成动作。问题在于,它们通常假设相机已经处在一个足够好的位置。一旦视角不理想,后面的语言理解和动作生成再强,也只能在不完整的视觉信息上做决定。
人类不会一直站着不动。我们会侧头看进抽屉、低头确认柜门把手,也会在手臂挡住视线时重新换个角度。换句话说,感知并不是动作之前的一次性输入,改变视角本身就是动作的一部分。
CVPR 2026 Highlight 论文 SaPaVe,正是把这件事放进了端到端 VLA:机器人不仅预测手臂和灵巧手怎么动,还同时决定头部相机该往哪里看。
论文:arXiv:2603.12193|CVPR 2026 论文|官方项目页
真正的问题不是“看不清”,而是 VLA 不会决定该往哪里看
传统主动感知常被写成 Next-Best-View:系统生成若干候选视角,再选择信息增益最大的一个。它能解决一部分几何探索问题,却很难直接理解“拿下面柜子里的调料瓶”这种带有常识和任务语义的指令。
VLM 能理解“柜子里”“最上层”“右边第二个”这些语义,但很多方法只让它从离散候选视角中做选择,无法自然落到连续的相机控制上。
另一条看似直接的路线,是把头部动作与手臂动作全部塞进现有 VLA 的同一个动作向量,再一起微调。SaPaVe 认为这会遇到两个结构性问题:
第一,现有大规模机器人数据几乎都来自固定或近似最优视角,同时包含连续头部运动与全身操作标注的数据非常少。
第二,头部转动和双臂操作不是同一种控制问题。前者主要回答“该往哪里看”,具有较强的跨本体共性;后者则与机器人关节结构、灵巧手和动力学紧密相关。强行共用一个动作出口,容易让两类监督互相干扰,也可能破坏原模型已经学到的操作先验。
因此 SaPaVe 的核心不是简单加一个电机,而是同时拆开两个问题:
- 语义主动感知(Semantic Active Perception):根据图像与语言,主动调整视角,找到任务关键线索。
- 主动视角执行(Active-View Execution):相机持续变化时,仍能把新观察稳定地转化为抓取、开门、放置等动作。
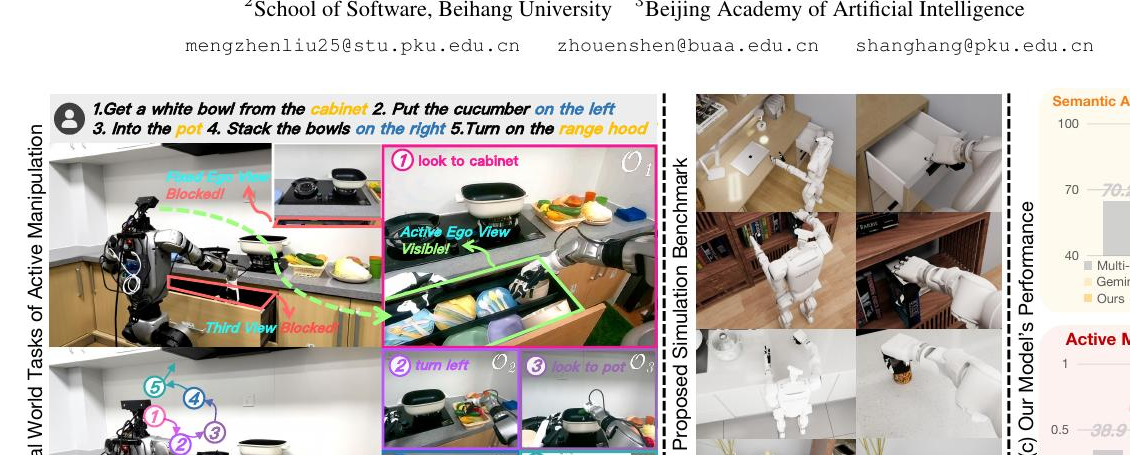
图 1 SaPaVe 展示的主动操作场景、ActiveManip-Bench 与关键结果
第一个关键设计:头部动作和身体动作分开预测
SaPaVe 将策略写成:
其中, 是当前 RGB 图像和可选的三维几何信息, 是语言指令。模型一次预测长度为 的动作块:
- 是头部相机的 2 自由度相对运动,即 pitch 与 yaw;
- 是双臂与灵巧手的 26 自由度关节位置增量。
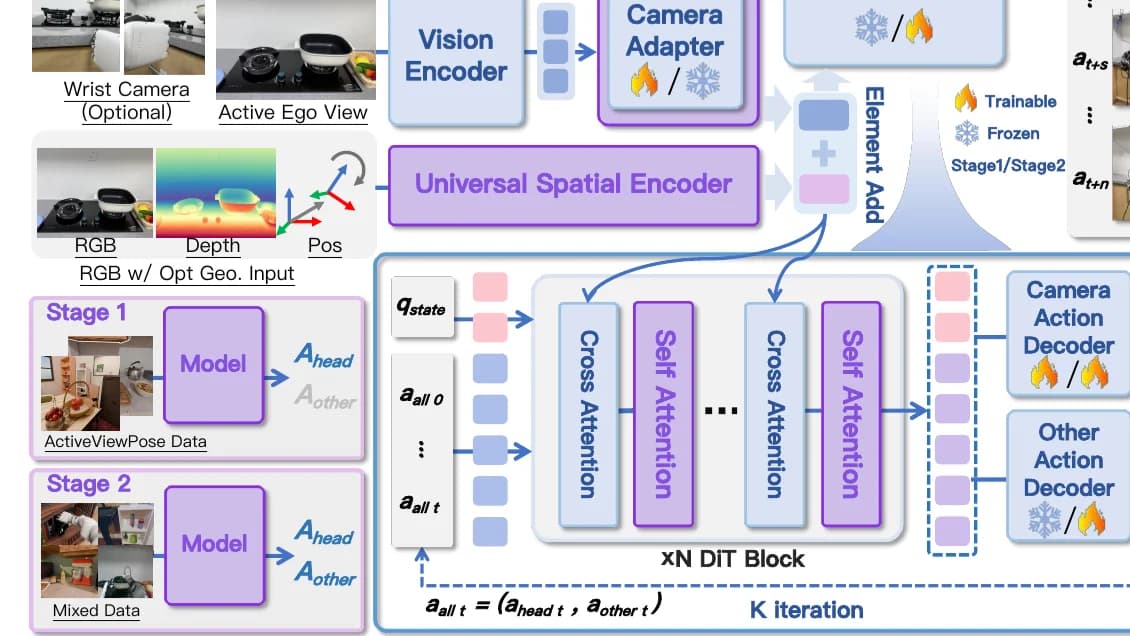
两类动作仍由同一个视觉—语言条件共同驱动,但最后进入独立的 Camera Action Decoder 和 Other Action Decoder。底层动作模型采用类似 GR00T N1 System 1 的 Diffusion Transformer(DiT)。
这个“共享理解、分开出动作”的结构很关键。它让相机控制可以先使用便宜的大规模合成数据学习,不必要求每条数据都同时带有完整的人形机器人操作轨迹。
与此同时,作者在 Eagle-2 VLM 上加入 LoRA 形式的 Camera Adapter,只用不到 2% 的可训练参数,把“语言语义”对齐到“头该怎么转”。原有 VLM 主干不被全面改写,从而尽量保留高层语义能力。
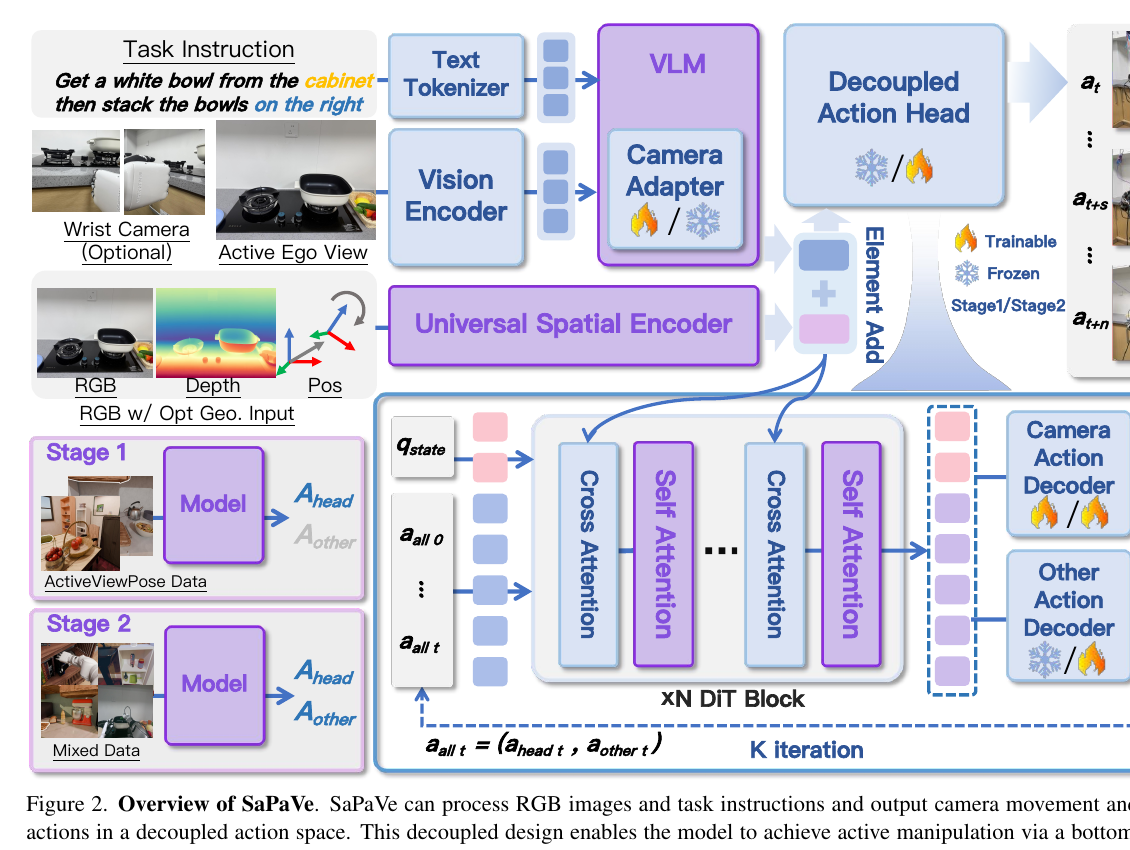
图 2 SaPaVe 完整架构:Camera Adapter、双动作头、两阶段训练与三维空间注入
第二个关键设计:先学会“看”,再学习“边看边做”
SaPaVe 采用一种自底向上的两阶段训练方式。
第一阶段:只训练机器人往哪里看
第一阶段使用作者构建的 ActiveViewPose-200K。每条样本包含图像、语言指令和最优相机运动,目标是让模型从当前画面与任务语义预测头部的 pitch/yaw 变化。
此时主要更新 Camera Adapter 和 Camera Action Decoder,操作动作分支保持冻结。模型先把“上层架子”“柜台下面”“第二个盘子”等语义,变成连续的头部运动。
作者把这一阶段形容成训练一个 embodied cameraman:它不是泛泛地把目标移到画面中央,而是根据后续操作需要寻找一个“够用的视角”。例如抽油烟机把手只需要短暂向上看见,不必为了追求完美居中而把头转到不利于操作的位置。
ActiveViewPose-200K 是怎么来的?
真实采集 20 万条“语言—视角动作”数据成本很高,因此作者采用半自动流程:从 Objaverse 筛选约 4000 个高质量三维资产,用 Infinigen 生成 500 个多样室内场景,再基于约 3000 个任务模板匹配目标、计算最优视角,并利用 GPT-4o 改写指令,最后进行人工修订。
数据不仅包含明确方向,例如“向左看”,还包含需要常识推断的表达,例如“拿底柜里的物体”。模型必须理解“底柜”通常意味着向下寻找,而不是在当前画面里机械检索。
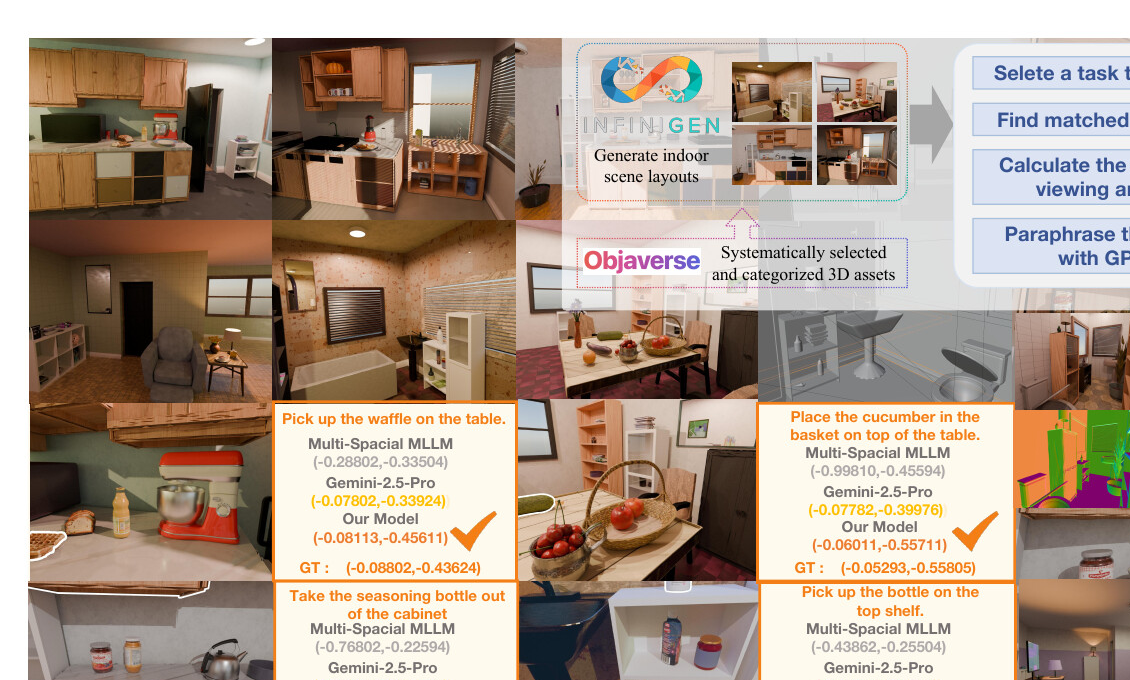
图 3 ActiveViewPose-200K 的半自动构建流程与样例
第二阶段:让头、手和任务真正协调起来
第二阶段混合 ActiveViewPose-200K、仿真主动操作数据和真实机器人数据,解锁两个动作头进行联合训练;Camera Adapter 保持冻结,以免第一阶段学到的主动观察先验被后续操作数据冲淡。
训练目标可以概括为:
它同时约束头部继续跟踪任务相关区域,以及双臂和手完成具体操作。论文实现中设置 、,以平衡 2 自由度头部动作与 26 自由度身体动作的维度差异。
这里最重要的不是两个 loss 相加,而是训练顺序:先建立主动观察能力,再让观察服务于操作。 消融实验中去掉第一阶段,四类真实任务的平均成功率从完整模型的 85% 降到 53.75%;这说明“该往哪里看”并不会仅靠少量主动操作数据自然涌现出来。
相机一转,为什么手还能知道物体在哪里?
主动相机带来了一个新问题:每次转头后,物体在图像中的位置都会变化。如果模型只依赖二维外观,很容易把“画面发生移动”误认为“物体发生移动”,动作块也会在动态视角下失去稳定性。
SaPaVe 为此引入 Universal Spatial Knowledge Injection。它借用 MapAnything 的通用空间编码器,可接收 RGB、深度、相机位姿、射线方向等不同组合的几何输入。RGB 由冻结的 DINOv2 ViT-L 编码,几何信息经卷积或 MLP 投影后,与 VLM 语义 token 做逐元素融合,再作为条件进入 DiT 的交叉注意力。
直觉上,VLM 告诉策略“要找什么、为什么找”,三维空间编码器则提醒它“目标在真实空间的哪里”。这样,头部视角改变之后,身体动作不必完全从新的二维像素位置重新猜测几何关系。
消融结果也支持这一点:移除 Universal Spatial Knowledge Injection 后,四类真实任务平均成功率从 85% 降至 68.75%,即使在相对简单的遮挡抓放任务上也下降了 15 个百分点。
ActiveManip-Bench:专门把“看不到”变成考题
传统操作 Benchmark 通常把相机放在稳定、清楚的位置,很难区分模型是真的会主动感知,还是只是擅长在理想画面上做动作。
SaPaVe 因此基于 NVIDIA Isaac Sim 构建 ActiveManip-Bench:使用带主动头部相机的 Unitree G1 人形机器人,覆盖 12 类任务、100 个物体和 20 个场景,并把任务划分为无遮挡、遮挡和完全出视野等条件。任务既包括抓取、重定向、开关等原子操作,也包括从抽屉取物、开柜取物和倾倒液体等长程链条。
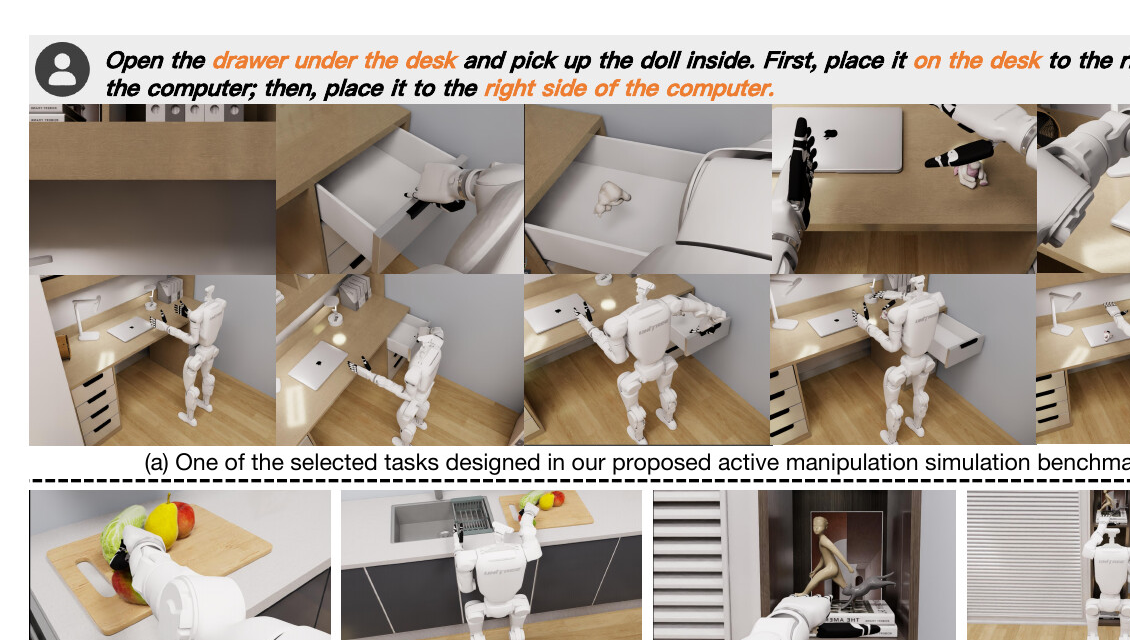
图 4 ActiveManip-Bench 的长程任务与多场景示例
实验最值得看的,不只是 85%
1. 学会“往哪里看”:84.3%
在 ActiveViewPose-200K 上,SaPaVe 第一阶段平均成功率为 84.3%,高于 Gemini-2.5-Pro 的 72.7%、Multi-SpatialMLLM 的 70.2% 和 Qwen2.5-VL-72B 的 62.3%。
这并不意味着一个 2B 模型在通用视觉语言能力上超过了这些大模型。这里测的是:预测的相机 pitch/yaw 是否落在真值允许范围内。它说明专项的“语义到连续相机动作”训练,比让通用 VLM 临时做空间猜测更有效。
2. 主动头部相机:74.83%,固定相机:36.17%
在相同底层架构下,只改变相机配置,固定相机平均成功率为 36.17%;固定头部加腕部相机提升到 52.33%;主动头部相机达到 74.83%。在完全出视野的抓放任务中,固定相机只有 11%,主动相机达到 72%;在完全出视野的关节物体操作中,则从 7% 提升到 68%。
还有一个反直觉结果:主动头部相机再叠加腕部相机,平均成功率反而是 73.16%,略低于只用主动头部相机的 74.83%。更多相机并不自动等于更好;额外动态视角也会增加融合难度。

图 5 固定与动态相机配置的仿真成功率
需要注意,论文 Fig. 1 的概览图写作 75.2%,但 Table 2 六类任务给出的平均值是 74.83%,官方项目页也采用 74.83%。本文以可逐项核对的 Table 2 为准。
3. 真实 Unitree G1:85%
真实机器人使用 Unitree G1、Inspire 3 灵巧手、自定义 2 自由度主动头部和 RealSense D455 RGB-D 相机。在遮挡/出视野抓放与关节物体操作四类任务上,SaPaVe 平均成功率为 85%,而直接扩展动作空间并微调的 和 GR00T-N1 分别为 45% 与 53.75%。
也就是说,SaPaVe 相比二者分别提高 40 和 31.25 个百分点。这个比较支持的结论是:在论文给定的数据与任务上,“先学主动观察、再联合操作”的路线明显优于直接把头部动作并入现有 VLA 微调;它并不能被外推成 SaPaVe 在所有机器人任务上都全面胜过 或 GR00T-N1。

图 6 SaPaVe 与现有 VLA 在真实主动操作任务中的成功率(对应论文 Table 3: Performance on active manipulation in real-world settings)
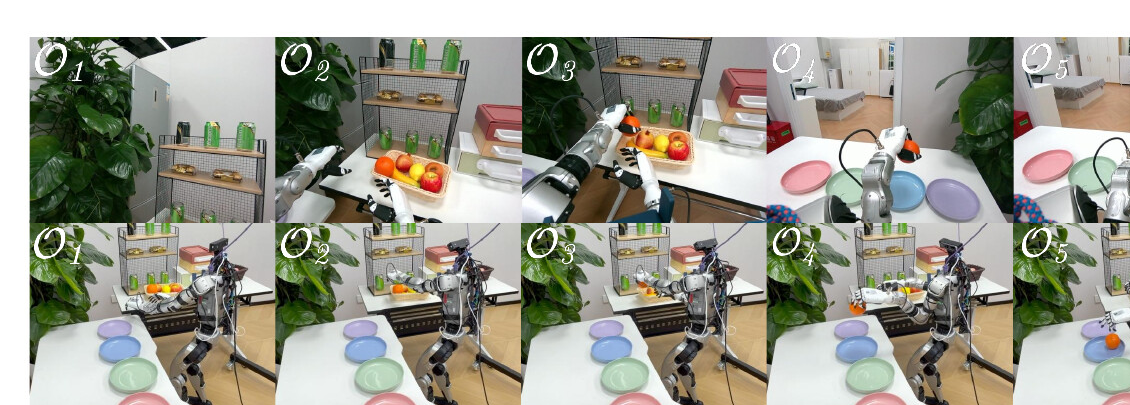
图 7 Unitree G1 的真实执行轨迹,同时给出头部视角与第三人称视角
SaPaVe 真正推进了什么?
SaPaVe 最重要的贡献,不是让机器人头部“多转两下”,而是把 VLA 的基本闭环从:
$$
\text{固定观察}\rightarrow\text{生成动作}
$$
改成:
$$
\text{理解任务}\rightarrow\text{主动改变视角}
\rightarrow\text{获得新证据}\rightarrow\text{立即操作}.
$$
这让“感知”第一次更明确地成为策略可以控制的变量。尤其对人形机器人而言,头部不是一个固定传感器支架,而是本体能力的一部分:它可以低头、抬头和转向,让视野配合双臂工作。
但 SaPaVe 目前仍是局部主动感知。论文真实平台的底座保持静止,头部即使看见机械臂范围之外的目标,也无法靠近并完成任务。因此它解决的是桌面或柜体附近的局部搜索,而不是跨房间的全局探索。作者也把“头部主动观察”扩展到“移动底座主动导航与接近”列为下一步方向。
此外,官方项目页当前主要提供论文与演示视频,尚未列出代码入口。ActiveViewPose-200K、ActiveManip-Bench 和训练实现能否完整复现,还需要等待进一步开放。
从更长的研究路线看,SaPaVe 给出的答案很清楚:下一代 VLA 不应该只学习“看见以后怎么做”,还要学习为了把事情做好,下一步应该去看哪里。