
Evoke 开源:一个能记住来路、随时改剧情的交互式世界模型,怎么跑起来?
如果让视频模型生成一段雪山漫游,最初几秒往往很漂亮。可是镜头绕过山峰又回头,原来的村庄还在原位吗?生成到一半说“天空出现极光”,它能在同一个世界里响应吗?Evoke 把这两个问题放在一起解决:用镜头可查询的外部世界状态保存场景线索,再用每段视频的新指令控制接下来的生成。
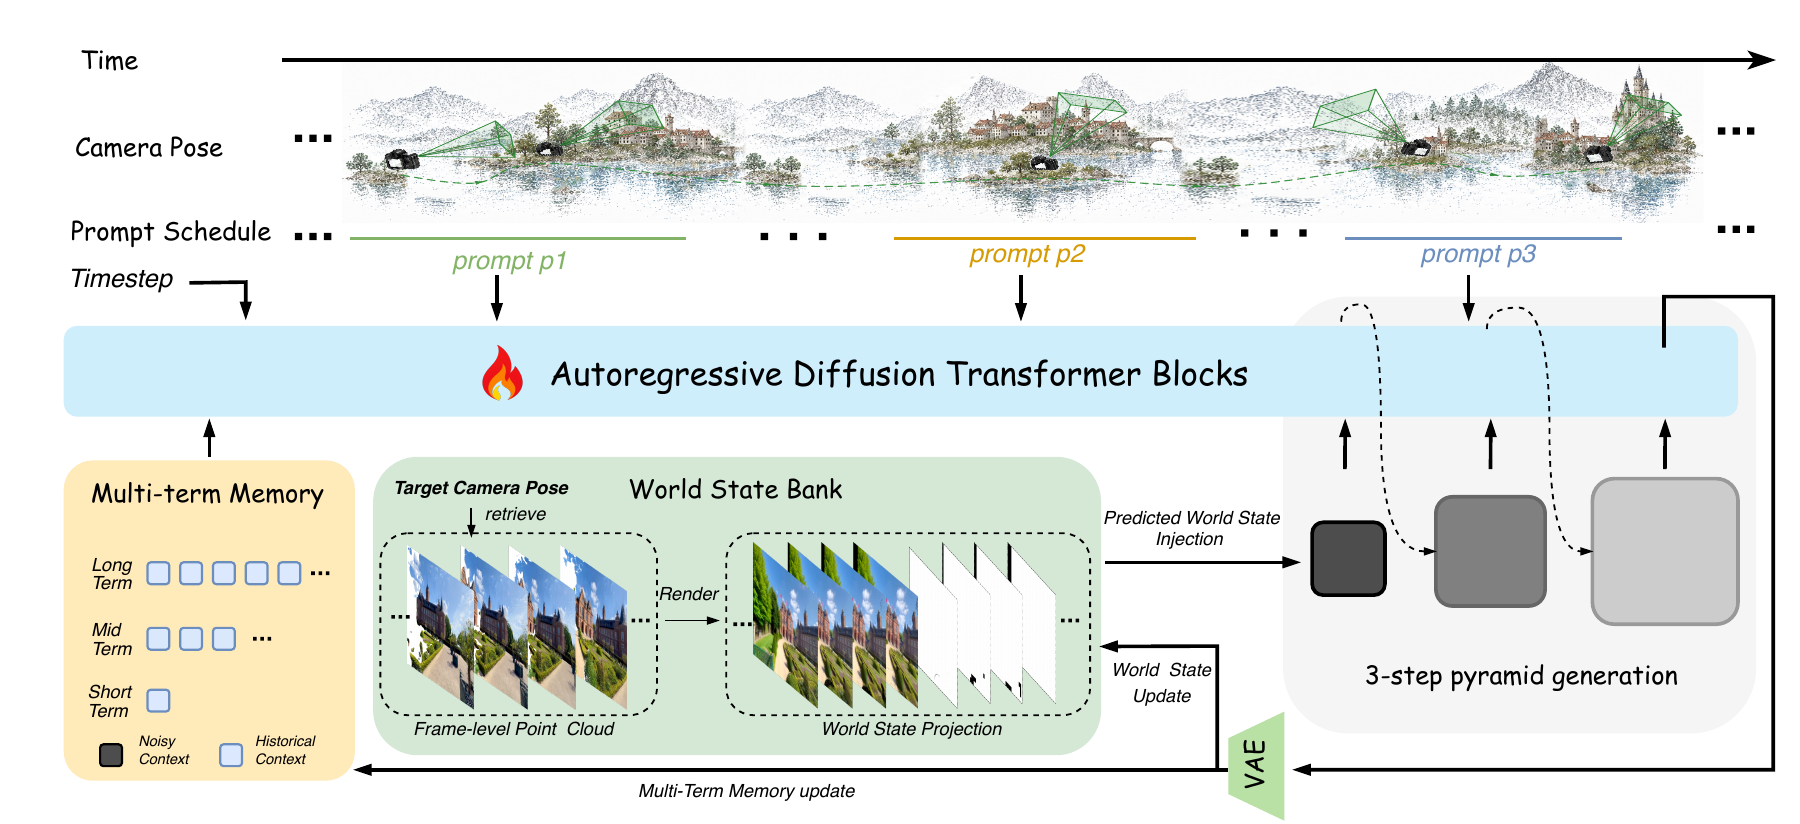
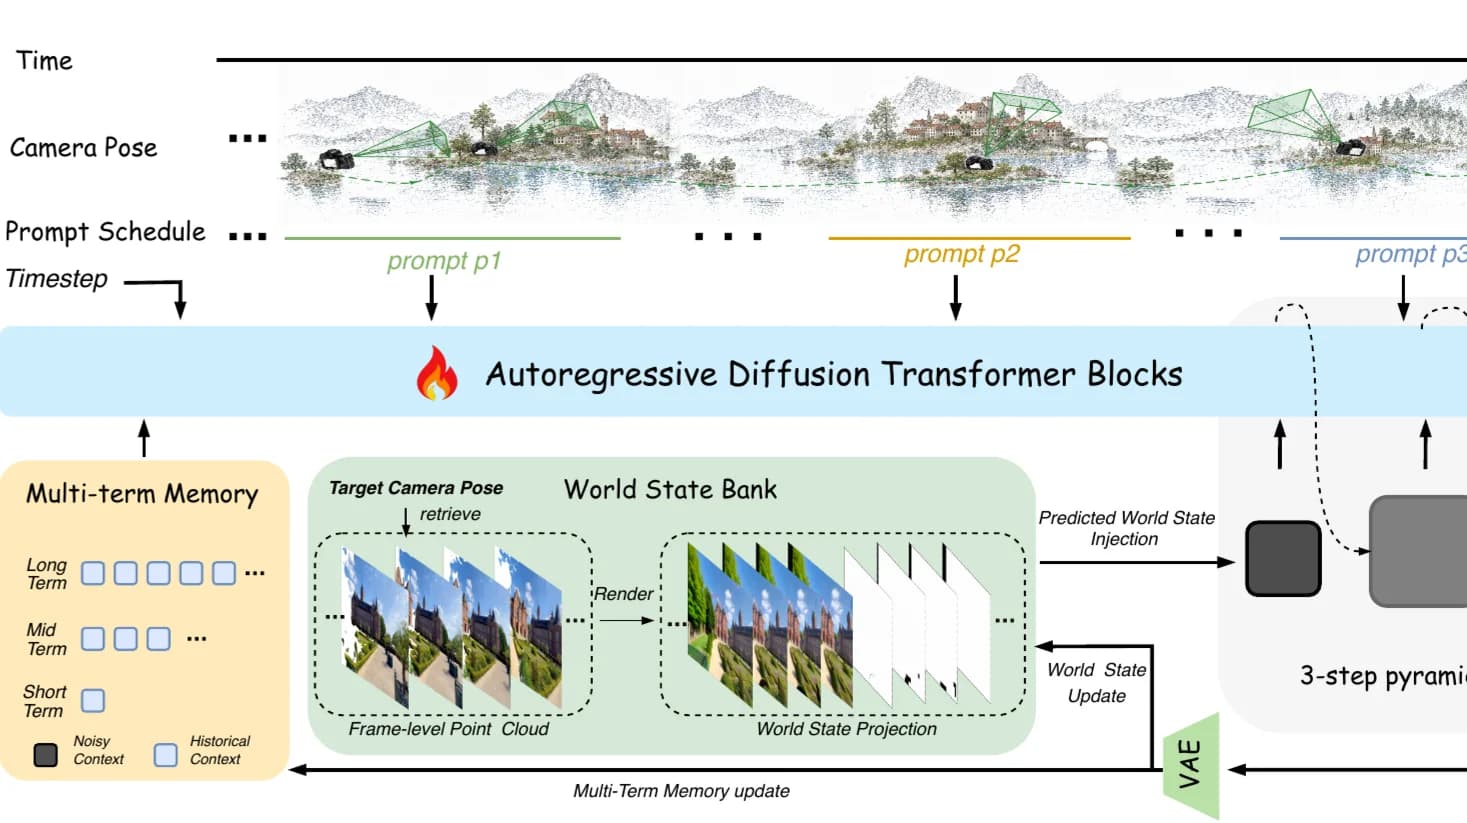
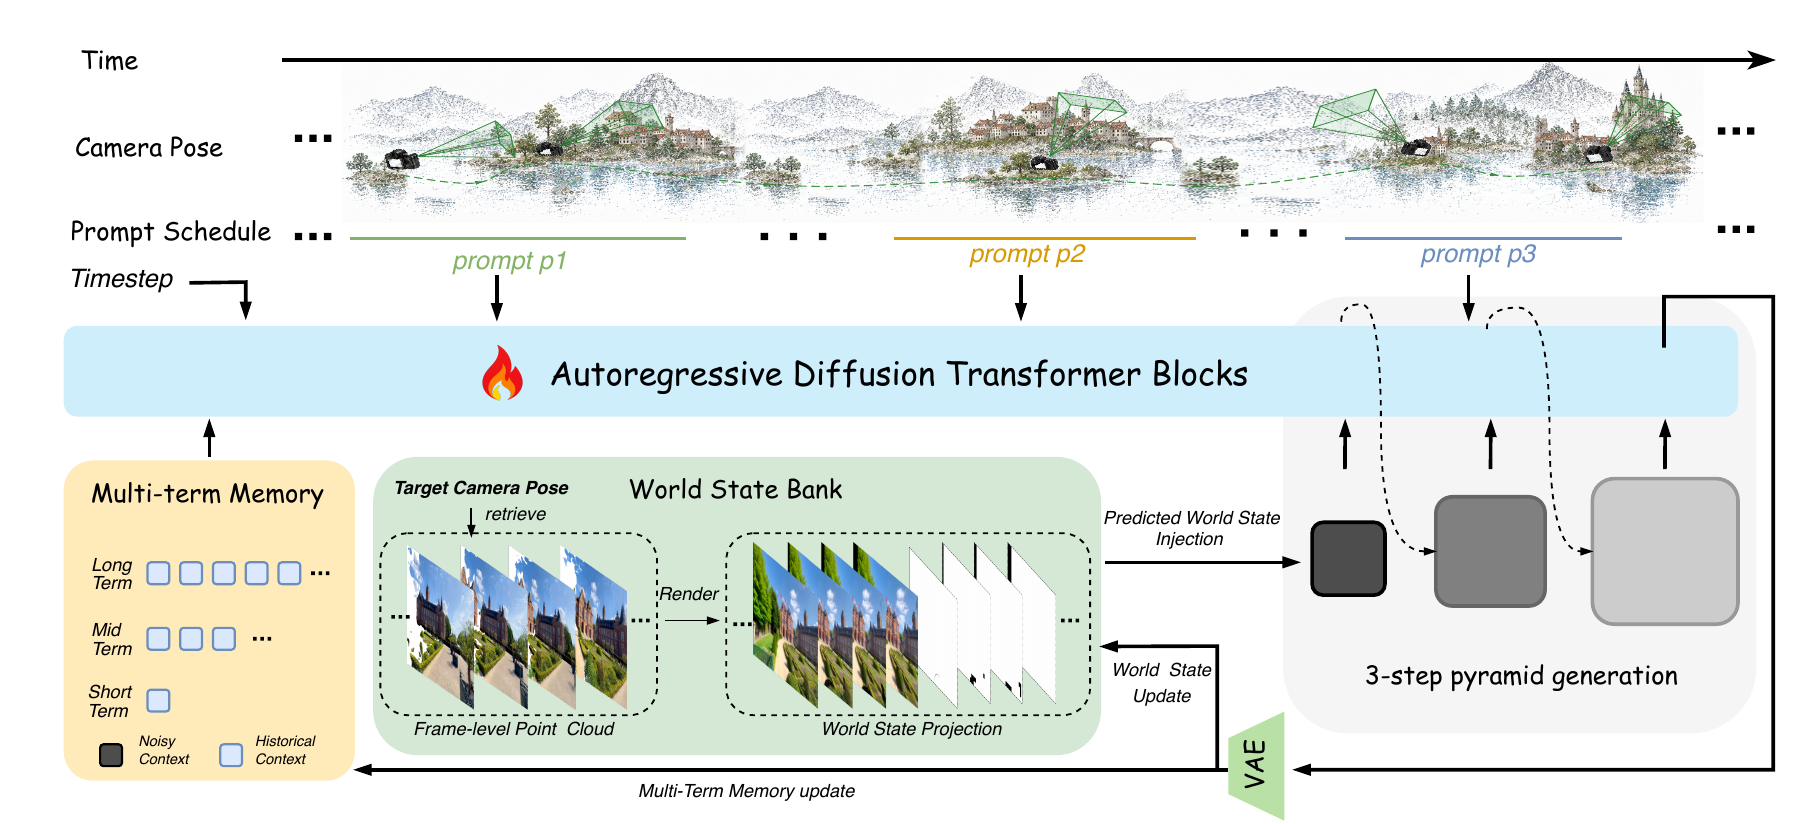
图 1|Evoke 官方项目页的模型流程图。上方是时间、相机位姿与分段提示;左下是长中短期记忆;中间的 World State Bank 按当前视角检索历史场景,再把渲染结果送进自回归扩散 Transformer;右侧三步采样产生新片段,VAE 解码后更新世界状态。原图
先划清定位:Evoke 是生成式视频世界模型,不是可导出网格和刚体的游戏引擎,也不是能直接输出机器人动作的 VLA。项目提供模型权重、推理脚本和两类本地交互界面;对读者最直接的玩法是拿首帧和镜头轨迹生成可延续视频,再逐段改变提示词。项目页|代码|权重
| 当前公开信息 | 具体含义 |
|---|---|
| 模型 | 约 14B 参数;发布的后蒸馏学生每段采样 3 步、不使用 CFG |
| 输出 | 384×640、24 fps;每段 36 帧,约 1.5 秒 |
| 单卡速度 | 官方单张 H200 测得每 1.5 秒片段约 2.11 秒;这不是端到端交互响应保证 |
| 交互加速 | 2026-09-12 的 五张 H200 Interactive UI 更新,片段平均 1.34 秒,属于另一部署配置 |
| 许可证 | 主仓库 Apache-2.0;必需的 ViGeo 深度后端另有 CC-BY-NC-4.0 约束 |
这些数据来自当前 README、交互 UI 说明和权重说明。14B 和三步指的是发布的后蒸馏模型:仓库另有 50 步、CFG 5.0 的阶段一模型和训练用教师,别把它们混成同一个模型。
“记住一个世界”究竟是怎么做的?
常见延长视频的办法,是把越来越长的历史帧塞回生成器。历史越长,注意力计算和缓存越吃资源;缩短历史又容易让老地点变样。Evoke 留下一部分压缩的长中短期上下文,同时把生成过的片段结合位姿与单目深度写成帧级点云。当相机来到某个视角,系统从 World State Bank 找出相关的历史视图,渲染一张带可见性掩码的“旧世界提示图”。模型只需要读此刻视角相关的资料,不必重新通读整场旅行。
这里“持久化”主要说场景信息存在去噪器上下文之外,并能随生成过程反复读取;它并不意味着点云是经过物理测量的精确三维地图。单目深度、相机尺度和遮挡误差仍会影响回访一致性。项目还设计了能承受长时段训练的教师:分组关注邻近片段,检索部分远帧,并维护线性注意力全局状态;在 30 秒的自回归生成中把内容漂移暴露给三步学生。论文 v2|README 方法概述
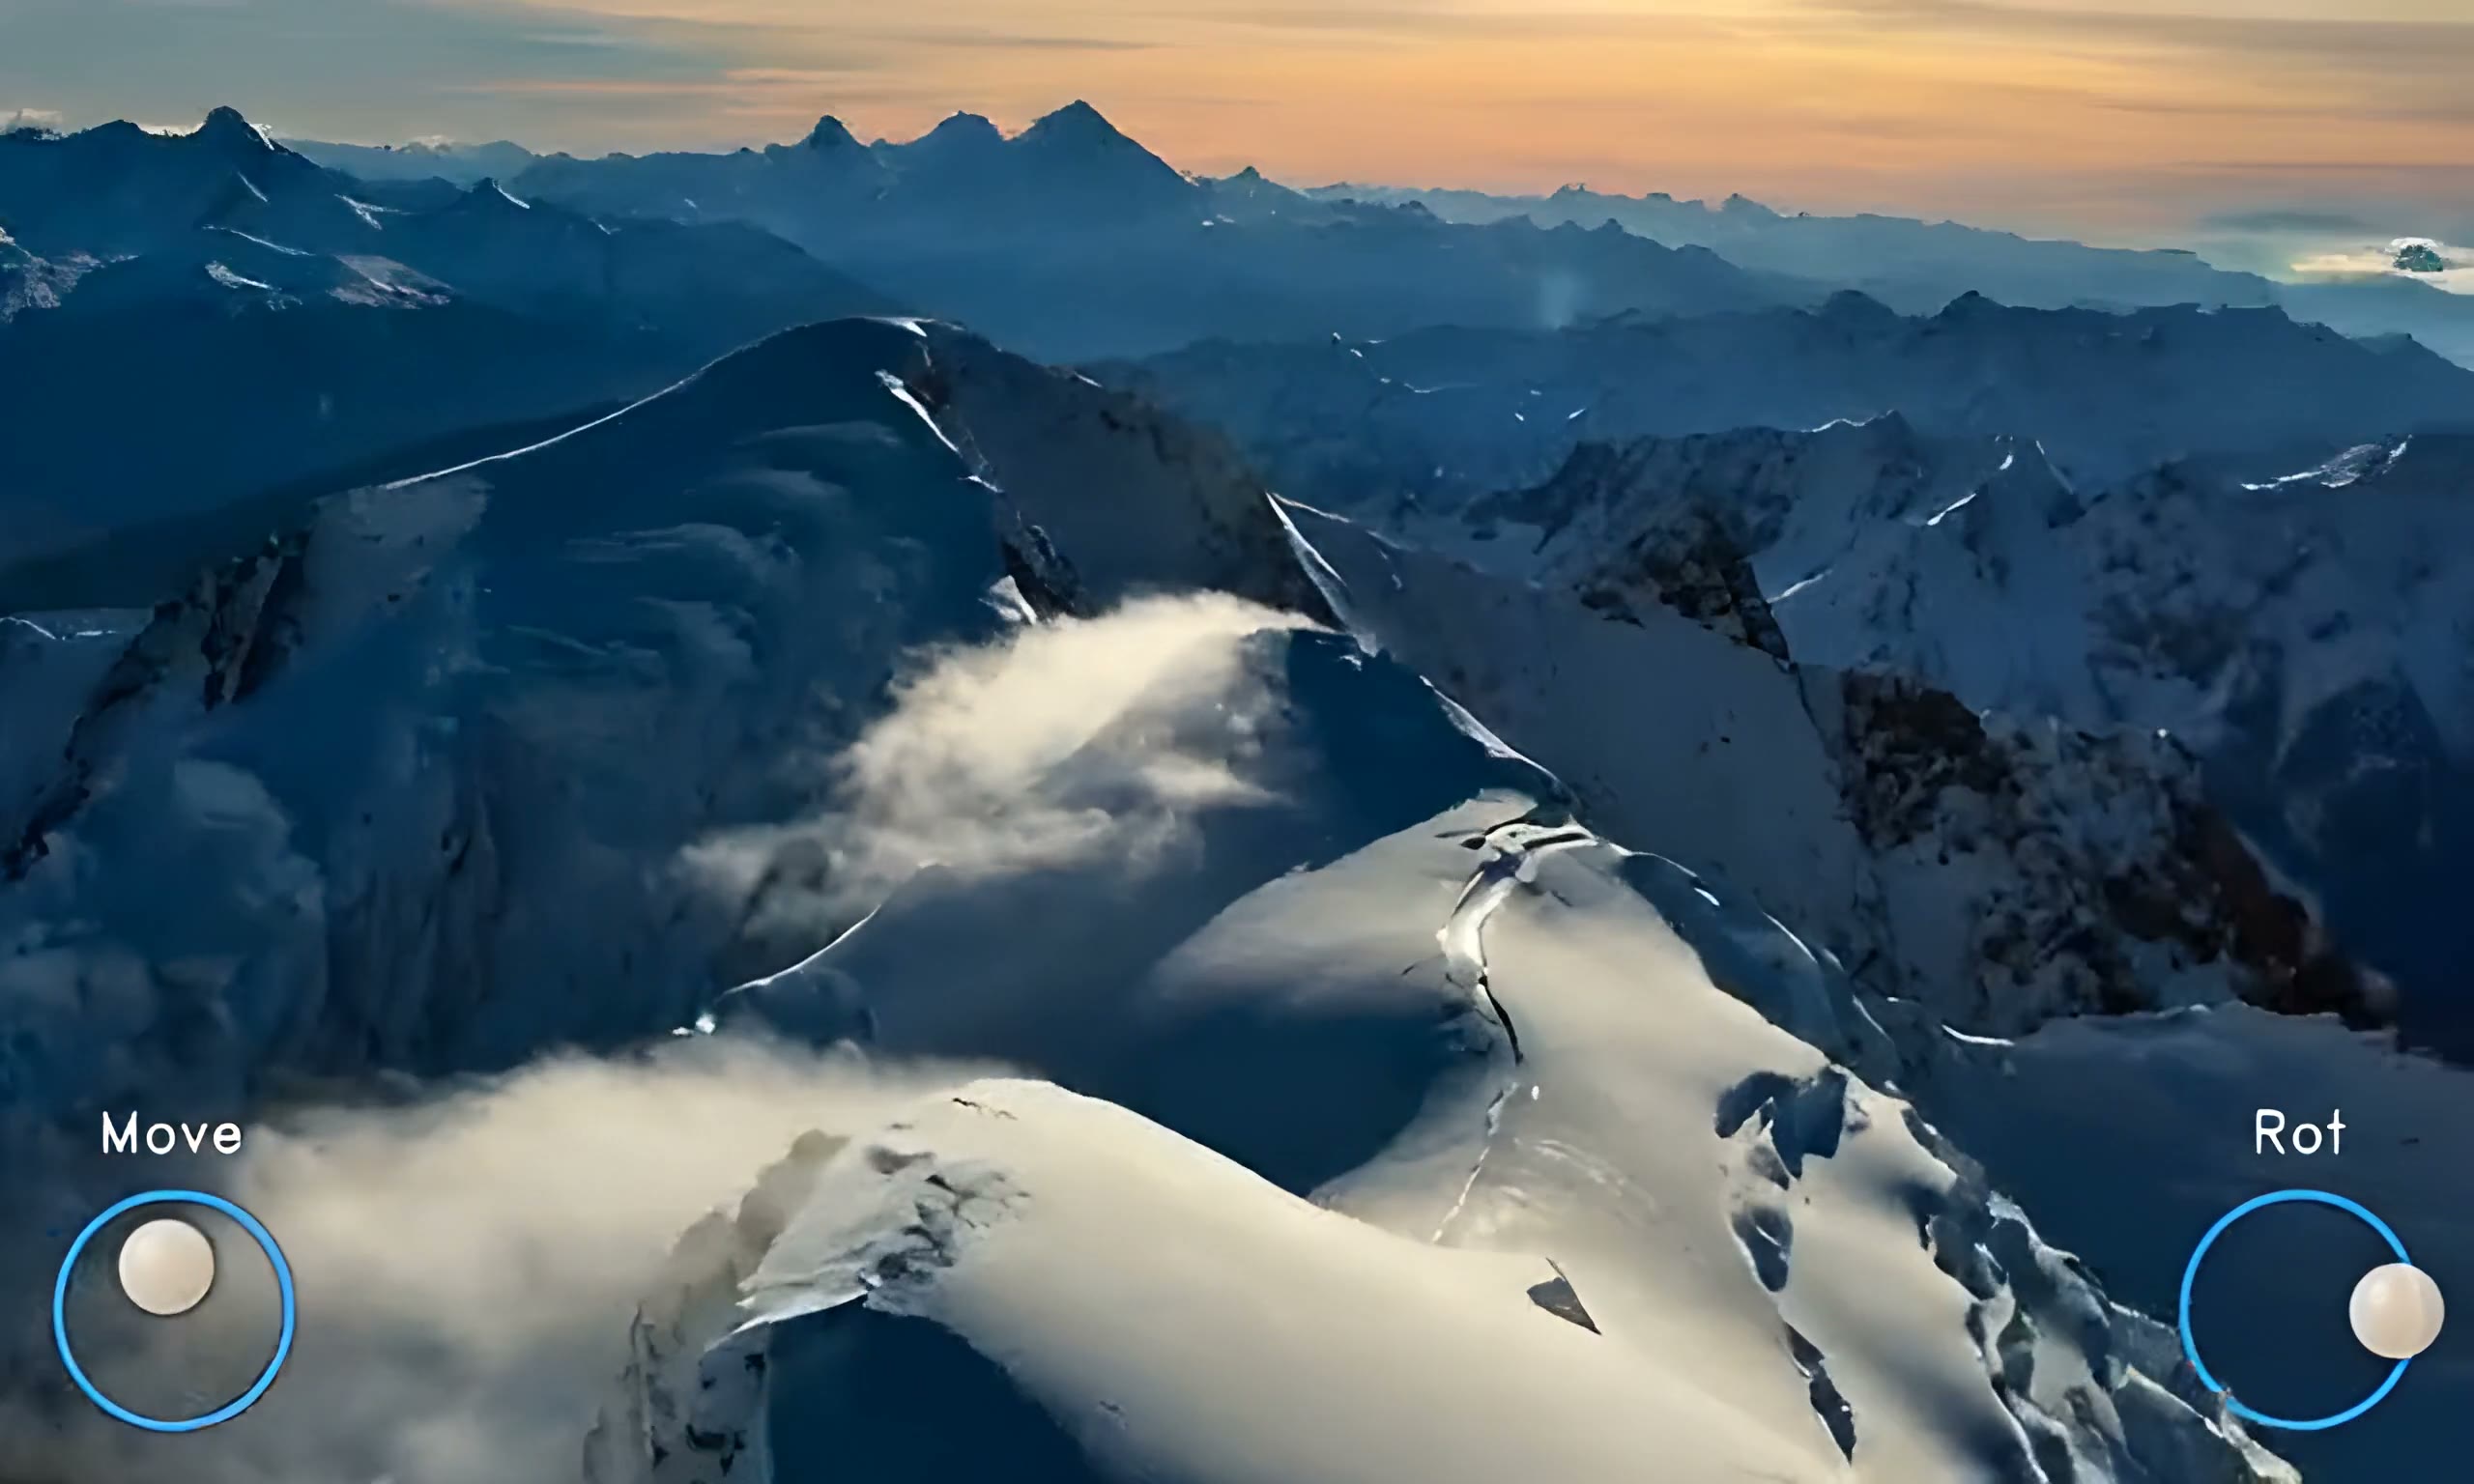
图 2|官方项目页的镜头控制示例。图内的 Move / Rot 分别代表位移和视角旋转;这是生成演示截图,不是游戏引擎输出的可编辑场景。
Quick Start:先从仓库自带案例验证
准备 Linux、NVIDIA CUDA GPU、Python 3.10、CUDA 12.4 对应环境及 ffmpeg 可执行文件。仓库声明它实际验证的组合是 torch 2.4、flash-attn 等固定版本,基准硬件为 H200;没有官方两张 RTX 5090 的显存、速度或兼容性保证。先完整阅读仓库 Environment和requirements.txt:其中 diffusers==0.39.0.dev0 是非 PyPI 的开发分支,官方 README 没给出可直接复制的安装地址。因此以下步骤是官方运行路径,安装前仍须拿到与仓库匹配的该开发包,不能把一行 pip install -r requirements.txt 当成已验证的一键安装。
git clone https://github.com/AlayaLab/Evoke.git
cd Evoke

# 在 Python 3.10 / CUDA 12.4 环境中;先解决官方要求的 diffusers 开发包
python -m pip install torch==2.4.0 torchvision==0.19.0 \
  --index-url https://download.pytorch.org/whl/cu124
python -m pip install -r requirements.txt
ffmpeg -version

# 仓库默认路径需要基础组件、后蒸馏权重及 ViGeo 深度权重
hf download AlayaLab/Evoke --local-dir models
hf download pkqbajng/ViGeo --local-dir models/ViGeo1.1

# 自带的首帧 + 镜头轨迹案例;2 段用于先检查流水线
MODE=i2v NUM_CHUNKS=2 bash scripts/inference/infer_post_distill.sh
运行成功的判据是日志显示加载 models/evoke/stage3_post_distillation,在默认的 output_evoke/infer/post_distill_i2v/<case>/ 找到 geo_pred.mp4,并在 run_info.json 查到本次权重与配置。NUM_CHUNKS=2 是两段生成,不代表两秒。如果缺 models/evoke-base、models/ViGeo1.1/vigeo.pt 或发布权重,先核对文件层级;若预检报 cannot import torch + cv2,检查环境解释器,按推理文档设置 EVOKE_PYTHON_BIN。没有 GPU 和完整权重的机器只能检查脚本与输入,无法验证生成结果。本篇没有实际运行 14B 权重推理。
Hugging Face 权重页的自动“Use this model”小组件展示了通用 DiffusionPipeline.from_pretrained(...) 图像示例;模型卡明确说这个仓库只存权重,根目录的 model_index.json 是布局映射而非可加载 pipeline。复现应使用上面的项目脚本和完整目录结构。模型卡|仓库权重布局
从固定 Demo 走向自己的场景
官方提供三类输入:v2v 用参考视频及相机轨迹延续;i2v 用一张首帧及轨迹;t2v 只给文本,不支持这一模式下的相机控制。还有 segment 模式可以在第几个片段更换提示词。最小切换方式如下:
MODE=v2v NUM_CHUNKS=4 bash scripts/inference/infer_post_distill.sh
MODE=t2v NUM_CHUNKS=4 bash scripts/inference/infer_post_distill.sh
MODE=segment NUM_CHUNKS=6 MAX_CASES=0 \
  bash scripts/inference/infer_post_distill.sh
这些命令使用仓库 examples/ 的内置数据。换自己的数据时,复制对应 examples/i2v/cases.jsonl 等模板,把行内 image_path、pose_path、prompt_path 指向自己的文件,再通过 JSONL=... 指定新文件。相机轨迹是 .npz,需要 cam_c2w [T,4,4] 和 intrinsics;若轨迹帧率或参考分辨率不同,须在每行准确声明 pose_fps、pose_source_resolution,否则镜头节奏会错却未必报错。自有数据字段和结果目录

图 3|官方项目页的长时段生成展示。**它演示场景能够继续延展;单张截图不能证明所有回访视角始终正确。
想像游戏一样边走边生成,用哪个 UI?
Director UI 在仓库 ui/,单卡、本地访问;提供首帧、分段提示、双摇杆式镜头控制、分段预览、继续生成及从指定片段分叉重做。完成上述权重与环境准备后运行:
python -m pip install -r ui/requirements.txt
python ui/app.py
访问 http://127.0.0.1:7860,等待状态 READY;第一次载入权重和 ViGeo 可能需要数分钟。该服务默认只绑定本机,没有内建身份验证和限流。Director UI 文档
Interactive UI 是 2026-09-12 新增的另一路径,官方演示用四张 H200 做 DiT 序列并行、第五张做几何及辅助工作,网页支持 WASD 位移、IJKL 视角、实时改提示和缓冲播放。进入仓库 InteractiveUI/ 后运行 python launch.py --check、python launch.py,页面为 http://127.0.0.1:7861/play/;官方明确要求至少五张 GPU,并使用设备索引 0–4。两张 5090 不满足这一启动拓扑。Interactive UI 文档
Evoke-Turbo、Benchmark 与容易踩的坑
9 月 11 日又发布了 Evoke-Turbo 权重,使用同一三步、无 CFG 的推理流程,重点改善导航与一致性。若已经下载基础组件和 ViGeo,只需另下 Transformer 权重,并显式指定:
hf download AlayaLab/Evoke-Turbo --local-dir models/evoke-turbo/transformer
TRANSFORMER_PATH=models/evoke-turbo MODE=i2v NUM_CHUNKS=20 \
  bash scripts/inference/infer_post_distill.sh
当前 README 报告 WBench(158 个案例、交互项只评 Navigation)均分 80.8210 → 82.0;Turbo 的导航 78.6300 → 83.8978、一致性 86.8700 → 88.1469,但 Video Quality 82.7900 → 81.8914。Turbo 模型卡说明两组使用不同提示词和相机位姿,其 seed-44 结果从六种提示词变体中选出:这些是官方公布的两组结果,不能解读为严格同设置的因果对照,更不能据此推出机器人任务成功率。WBench 表|Turbo 评分来源
运行上最需留心的是:TRANSFORMER_PATH 必须指向 transformer/ 的父目录,输出视频在 <OUT_ROOT>/<case>/geo_pred.mp4;长片段要看日志的 cov(历史渲染覆盖率)与 warp / diffusion / decode+dump 耗时,单卡“扩散三步”不等于总链路三次前向就完成播放。官方小时级运行需要 STREAM_LONG=1 等专门设置,默认累积视频可能耗尽显存。持续交互还可能出现长距离镜头跟随退化,Interactive UI 文档也没有保证每一段始终无缓冲。推理诊断与长视频配置|UI 限制
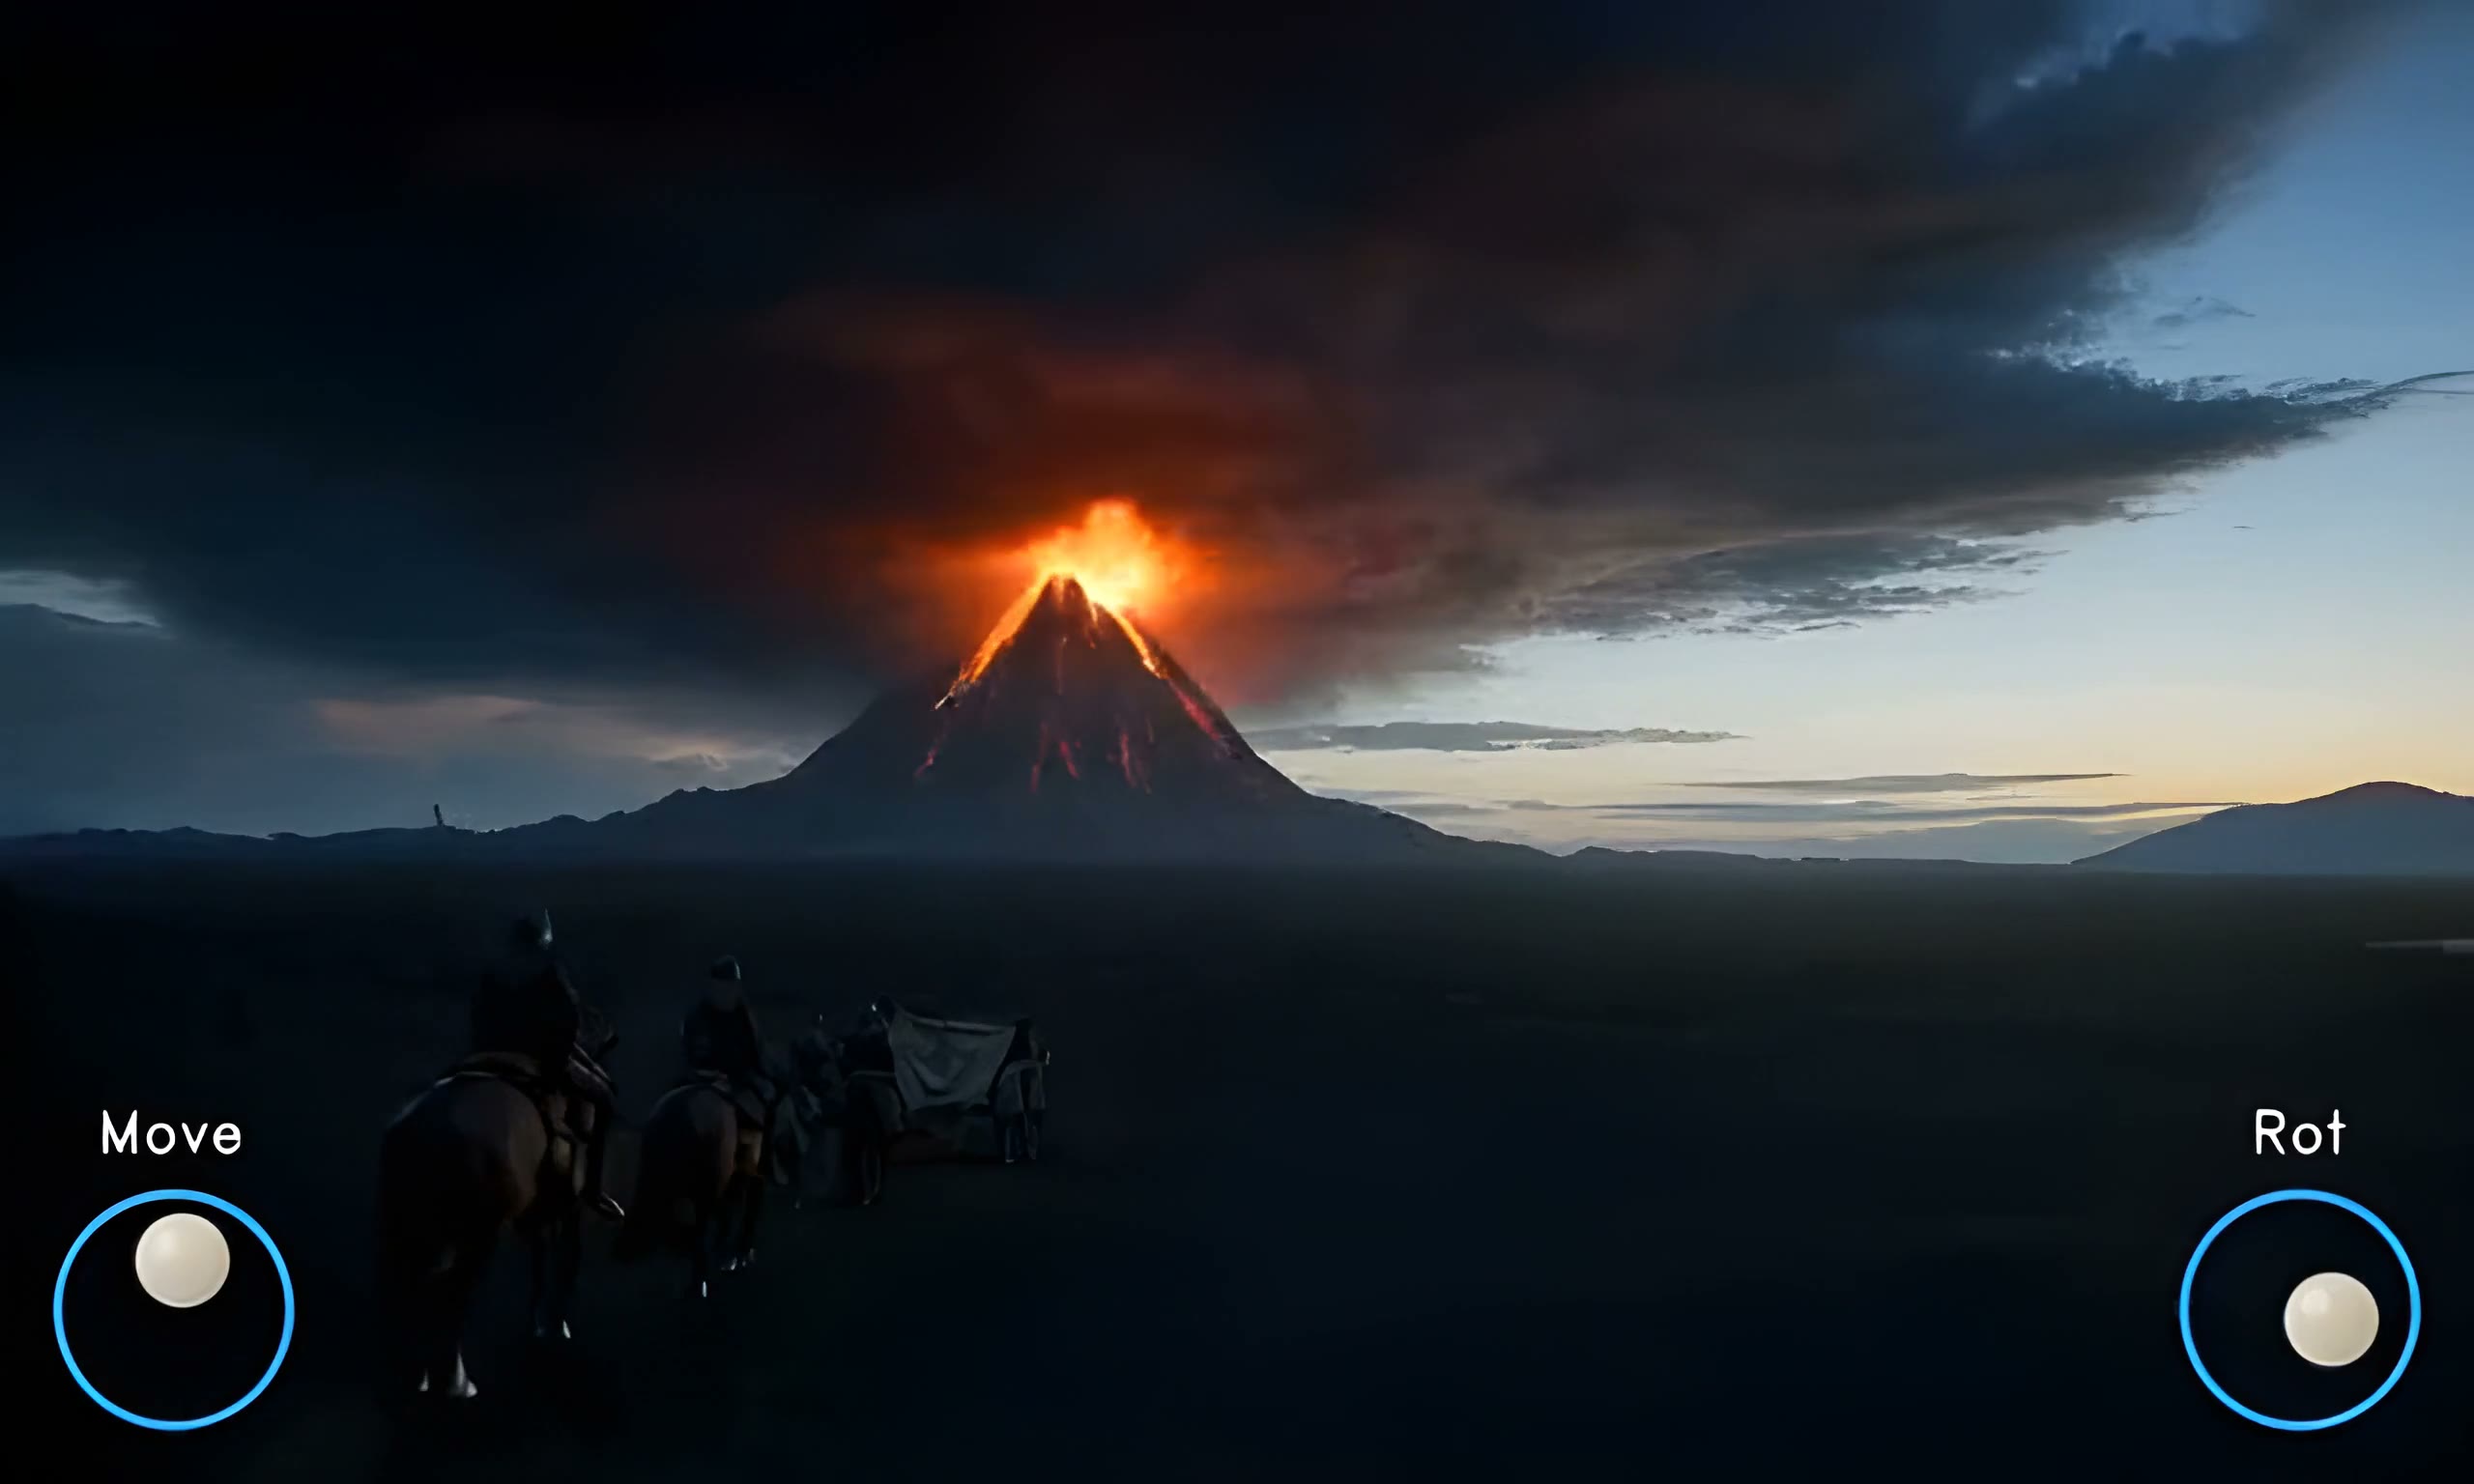
图 4|官方项目页的场景范围展示。适合作为生成效果配图;实际能力仍要结合分段提示、镜头回访与长时段日志评估。
适合谁?如果是我会怎样试?
适合要研究可导航的视频生成、分段指令控制、世界状态检索的人,以及有足够 GPU 资源的生成式场景原型团队。若目标是精确三维资产、可碰撞的物理仿真、可直接迁移到机器人控制器,Evoke 目前不能替代这些系统。研究它与具身智能的关系,可以从“带位姿的历史视图怎样影响未来观察”切入,但目前公开结果不足以证明它可直接做 VLA 数据生成、闭环机器人规划或 Jetson 端侧部署。
如果在你现有的双 5090 工作站上试,我会先检查 CUDA/torch 与非 PyPI diffusers 开发包兼容性,以及权重和深度模型的本地空间;用 MODE=i2v NUM_CHUNKS=2 测安装与单卡显存,再试 Director UI 做两次镜头回访和一次段中改提示。记录每段的 GPU 峰值、cov、生成/解码延迟和场景一致性;确认能跑之后,再把自己的位姿轨迹与首帧放进 JSONL。只有这些真实测量完成,才讨论是否能用于具身场景数据,而不把 H200 公开数字当作 5090 性能预测。