
OpenBMB 开源 Meshy:把强化学习训练拆成服务,一条队列同时管数据、节拍和 GPU
GitHub:OpenBMB/Meshy
官方中文博客:Meshy:角色驱动下 SPMD 范式的 RL 训练框架
大模型强化学习框架,通常都绕不开一个“总导演”。
它负责依次通知 rollout 生成样本、reward 打分、trainer 更新权重,再把结果收回来,进入下一轮。这种 Single-Controller 架构非常直观,也很适合同步 RLHF:整个系统一次只推进一个明确阶段,程序运行到哪一行,训练就进行到哪一步。
但今天的后训练任务已经变了。
生成越来越长,样本完成时间差异越来越大;训练与推理希望重叠执行;Agent 轨迹可能停下来等待工具返回;同一时刻,队列里甚至可能混有不同权重版本产生的样本。继续让一个中央控制器负责派发、汇总和维护所有状态,它就容易从“总导演”变成系统的交通路口。
OpenBMB 新开源的 Meshy,选择了另一条路线:
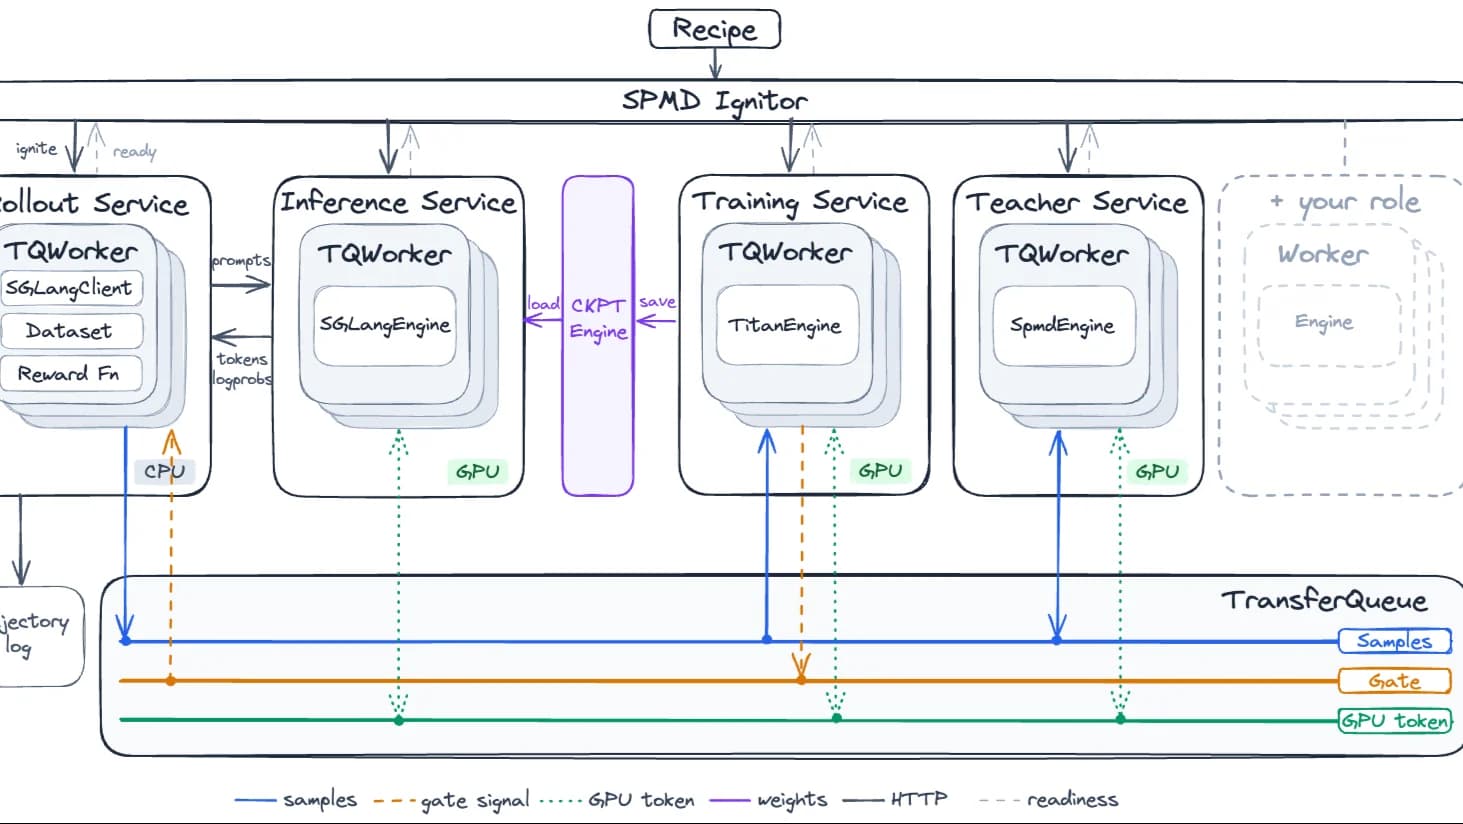
不再设置负责串起全流程的中央控制器,而是把 Inference、Training、Rollout、Teacher 都做成独立服务,让数据是否就绪来决定系统下一步做什么。
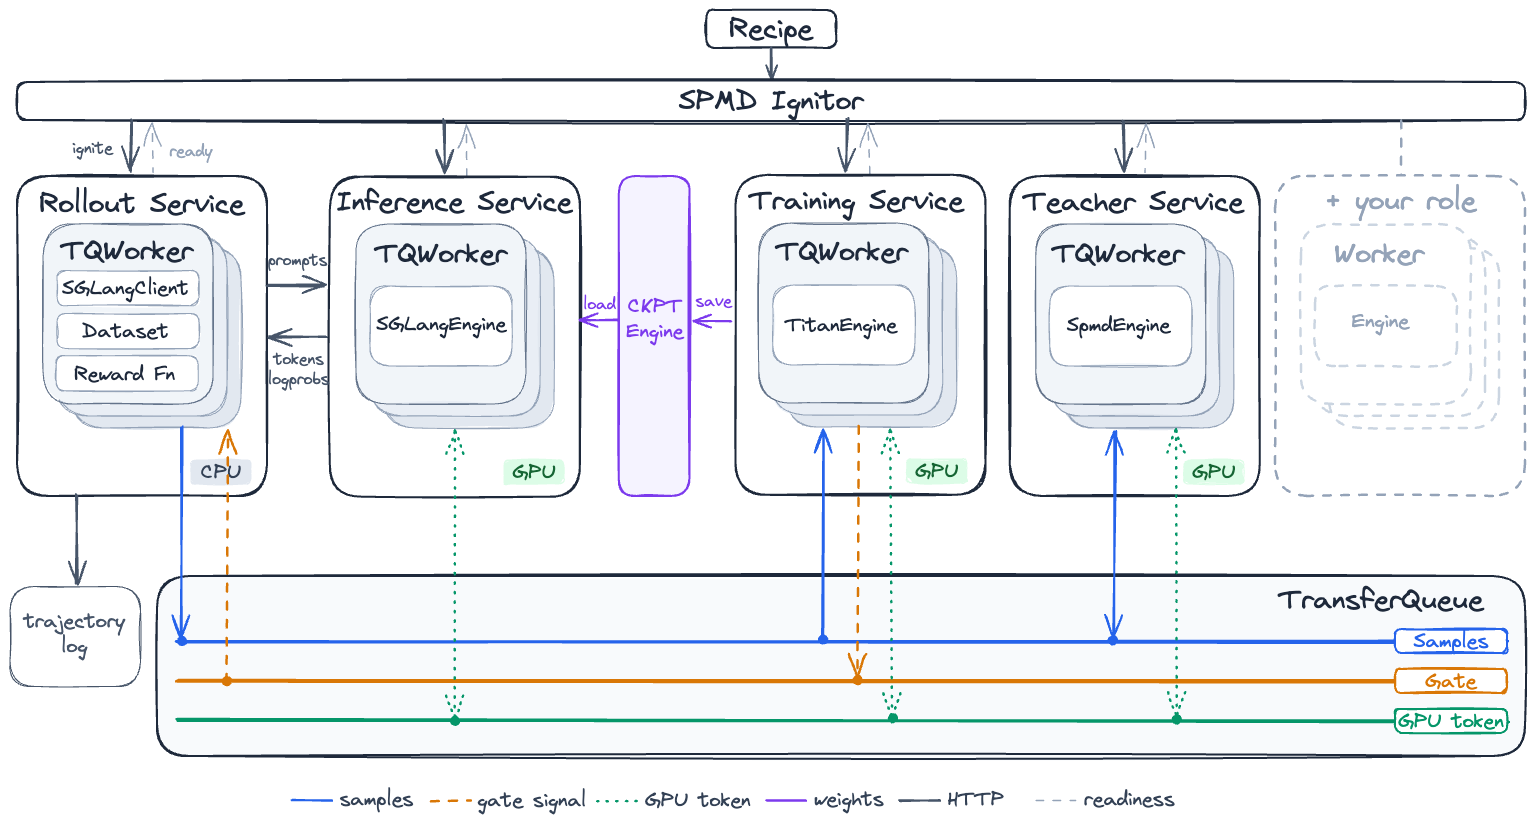
图 1|Meshy 官方系统架构图
Meshy 到底是什么?
先给它一个准确定位:
Meshy 是一个基于 SGLang、TorchTitan 与 TransferQueue 构建的、角色驱动的 LLM 强化学习训练框架。
它目前不是一个面向普通开发者的聊天模型训练器,也不是“输入一个数据集就自动对齐”的低代码产品。它更接近一套 RL 系统基础设施:帮助研究者组织 rollout、推理、训练、Teacher 等异构角色,并在同步、有限异步、全异步及在线策略蒸馏之间复用同一套服务。
当前官方仓库已经提供以下配方:
| 配方 | 模型与数据 | 典型 GPU 布局 | 主要用途 |
|---|---|---|---|
grpo_gsm8k |
Qwen3-1.7B + GSM8K | 默认 1 卡 | 最小端到端 GRPO 闭环 |
grpo_gsm8k_qwen3_8b |
Qwen3-8B + GSM8K | 8 卡 | 非对称训推共置 |
justrl |
R1-Distill-Qwen-1.5B + DAPO-Math-17k | 8 卡 | 锁步 GRPO |
justrl_async |
同上 | 8 卡 | 有界异步,生成可领先一批 |
justrl_fully_async |
同上 | 16 卡分离部署 | 全异步、流式 mini-batch |
justrl_minicpm5_* |
MiniCPM5-1B / 2.6B | 4 或 8 卡 | MiniCPM5 系列训练 |
justrl_qwen3_30b_a3b |
Qwen3-30B-A3B | 8 卡 | MoE + TP/EP 并行 |
math_grpo_minicpm5_2_6b* |
MiniCPM5-2.6B + S9 数学数据 | 4 或 8 卡 | 128K 上下文、全异步数学训练 |
需要注意:“框架支持 1 卡启动”不等于所有 recipe 都能单卡运行。 单卡路径主要是 grpo_gsm8k;JustRL、MoE、128K 长上下文等配方都有明确的多卡要求。
它和常见 RL 框架最不一样的地方
1. 每个角色都是独立服务
在 Meshy 中,Rollout、Inference、Training 和 Teacher 不再是中央训练循环里的几个函数,而是长期运行的独立 Service。
每个 Service 内部又拆成两层:
- Engine:负责模型计算、进程组、GPU 状态、权重和 checkpoint;
- Worker:负责业务循环、批处理,以及从 TransferQueue 读取和写入数据。
一次实验则由 recipe 声明:有哪些角色、每个角色多少副本、每个副本占几张 GPU,以及哪些角色需要共用显卡。
这意味着新增一个 Teacher 或 Scoring 角色时,理想路径不是改写整个中央循环,而是:实现新 Service、声明它消费和产生的数据列,再把它放进 recipe。
2. 数据本身就是流程控制
TransferQueue 可以理解成一组分区表:
- 一行代表一条样本;
- 一列代表一种数据,如 token、logprob、advantage、reward、weight version;
- 不同服务可以向同一行补写不同列;
- 只有消费者要求的列全部到齐,这一行才会变成“可消费”。
例如 Trainer 声明自己需要 tokens + logprobs + advantage。当这三列没有全部准备好时,Trainer 不会取走样本;当 Rollout 或其他服务补齐这些列后,样本自然进入 Trainer 的可见范围。
这里没有额外的“请开始训练”RPC。列的就绪状态,本身就是控制信号。
更关键的是,大块 tensor 由消费者直接从 storage 获取,不必先送到中央 driver,再由 driver 转发。Meshy 官方博客认为,这是它与典型 Single-Controller 架构最实质的差异。
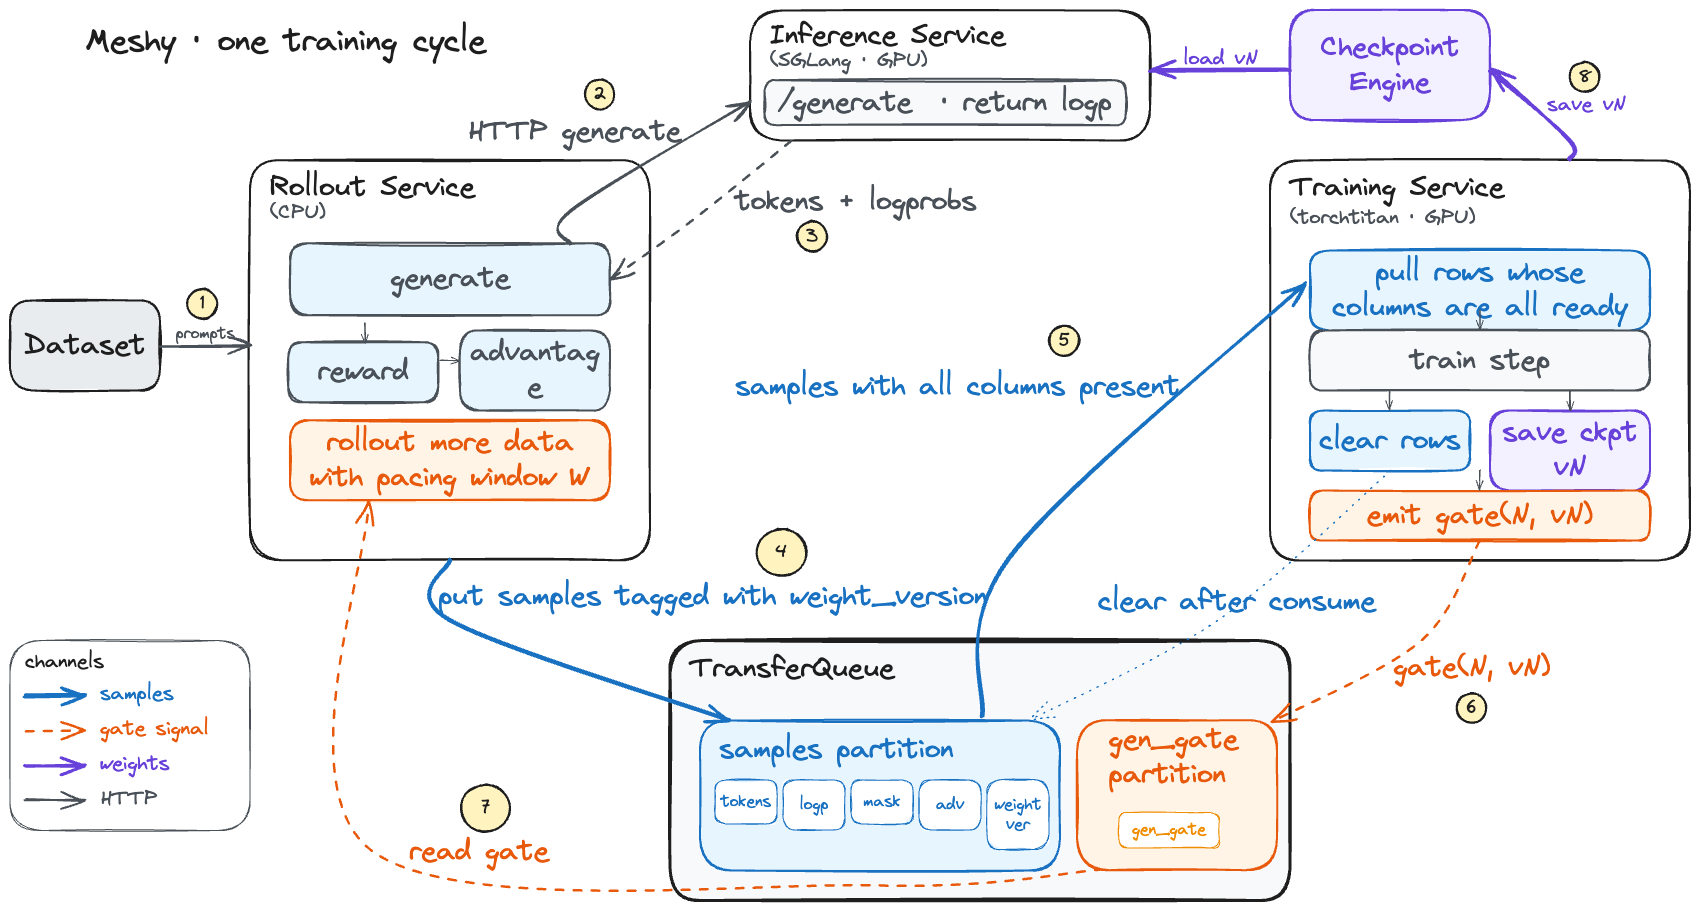
图 2|Meshy 单轮训练数据流
图中一轮 GRPO 的逻辑是:Rollout 从数据集取 prompt,通过 SGLang Inference Service 生成 token 和 logprob;完成 reward、advantage 后,把带权重版本的样本写入 TransferQueue;Trainer 只取列已经齐全的行,更新模型、保存新 checkpoint,再发出新的 generation gate。
3. 没有服务发现:每个进程自己算出完整拓扑
服务化系统通常还需要注册中心:哪个服务在哪台机器、监听哪个端口、使用哪组 GPU?
Meshy 的做法很干脆:所有 GPU 进程通过同一条 torchrun 命令启动,每个进程拿到同一份 recipe 和全局 GPU 列表,再执行同一个确定性函数,本地推导出相同拓扑。
因此,Ignitor 的职责主要发生在启动阶段:计算部署、点火服务、检查 GPU 数量和共置关系、守护生命周期;它不是运行时的任务调度中心。
这让“拓扑”变成 recipe 的纯函数结果,也让 GPU 数量不足、端口冲突、共置环错配等问题尽量提前暴露。
4. GPU 使用权也被做成了队列里的令牌
RL 训练里经常需要训推共置:生成时 SGLang 使用 GPU,训练时释放推理显存,让 TorchTitan 接管;训练完成后再加载新权重,把 GPU 交回推理。
Meshy 把这件事抽象成 ColocationRing。
- Inference 通常是
FALLBACK:没有其他任务申请时持续生成; - Training、Teacher 通常是
ON_DEMAND:需要计算时主动申请 GPU; - 当前持有者在安全边界停止计算、释放显存并交出令牌;
- 新持有者恢复模型与状态后开始执行;
- 新 checkpoint 路径可以随令牌一起传递,避免推理端悄悄使用旧权重。
这套抽象的价值,在加入第三个 GPU 角色时最明显。传统训推共置往往只写死“两方切换”,Teacher 加进来以后又要补一套状态机;Meshy 则允许多个角色加入同一个环,只要求各自实现显存释放与恢复接口。
一处配置,切换同步、有限异步和全异步
Meshy 内置的 justrl、justrl_async 和 justrl_fully_async 使用相同模型和训练超参数,核心差别集中在 rollout 的推进窗口:
| 模式 | pacing_window |
含义 |
|---|---|---|
| 同步/锁步 | 1 |
rollout 等待当前版本 gate,按批推进 |
| 有界异步 | 2 |
允许生成领先训练一个批次 |
| 全异步 | None |
不设置固定窗口,Trainer 流式消费 mini-batch |
这并不意味着异步训练只有一行代码那么简单。策略滞后、混合权重版本样本、失败恢复和评测公平性仍然是算法与系统问题。Meshy 的贡献更准确地说是:让不同节拍可以复用同一套 Service 与数据通路,而不必维护两套完全分叉的同步/异步框架。
Quick Start:先用单卡跑通最小闭环
运行前提
官方当前要求:
- NVIDIA GPU,宿主机驱动能够支持 CUDA 12.9 容器;
- Docker 与 NVIDIA Container Toolkit;
- 若手动安装,建议 Ubuntu 24.04、Python 3.12+;
- 首次运行会从 Hugging Face 下载
Qwen/Qwen3-1.7B与 GSM8K 数据,需要可用网络与磁盘空间。
对于刚开源的 alpha 项目,建议优先使用容器,不要先在已有训练环境里混装 PyTorch、SGLang、TorchTitan 和 TransferQueue。
1. 拉取源码与官方推荐镜像
git clone https://github.com/OpenBMB/Meshy.git
cd Meshy

docker pull ztonyzhao/meshy:0.1.0-alpha
2. 挂载源码和模型缓存进入容器
docker run --gpus all -it --rm \
  --ipc=host \
  -v "$PWD":/workspace/Meshy \
  -v "$HOME/.cache/huggingface":/root/.cache/huggingface \
  -w /workspace/Meshy \
  ztonyzhao/meshy:0.1.0-alpha bash
这里主动挂载了仓库源码。原因是截至本文核验的 Dockerfile 主要负责准备 CUDA、PyTorch、SGLang、TorchTitan 与 TransferQueue 依赖,并没有把当前仓库源码 COPY 到镜像中。挂载源码后,版本关系也更清楚。
3. 安装当前源码并启动最小 recipe
进入容器后执行:
uv pip install -e .
python scripts/launch.py --recipe recipe.grpo_gsm8k
它默认使用 1 张 GPU,在 Qwen3-1.7B 与 GSM8K 上跑通 rollout → reward/advantage → training → checkpoint/gate 的完整链路。
启动成功时,首先应看到类似信息:
[launch] recipe=recipe.grpo_gsm8k cards=1 nproc-per-node=1 colocate=True runtime=...
运行产物位于:
.xrl_runtime/<timestamp>/
├── logs/
├── tensorboard/
├── weights/
└── trajectory JSONL
这里的成功判据不是“终端没有立即报错”,而是:Inference、Rollout、Training 和 TransferQueue 相关进程均已就绪;队列持续产生和消费样本;训练日志出现 step;运行目录中出现日志、轨迹和权重产物。
最常见的三个问题
- 容器看不到 GPU:先用
docker run --rm --gpus all nvidia/cuda:12.9.1-base-ubuntu24.04 nvidia-smi检查宿主机驱动与 NVIDIA Container Toolkit。 - recipe 找不到或
import meshy失败:确认当前目录是仓库根目录,并已执行uv pip install -e .。 - 首次运行长时间没有进入训练:先检查 Hugging Face 模型与数据是否仍在下载,再查看
.xrl_runtime/<timestamp>/logs/;Meshy 是多进程框架,真正的 traceback 往往在具体 Service 日志里。
怎么接入自己的数据和奖励函数?
对大多数 GRPO 实验,第一步通常不需要写新 Service,只要增加 Dataset adapter 和 reward。
官方约定很小:
- 构造函数接收
dataset_kwargs; next_batch(builder)返回一组 prompt Sample;- 返回空列表表示本轮数据结束;
- reward 接收完成生成的 Sample,返回标量分数。
然后在 recipe 里通过 module:attr 字符串接入:
RolloutServiceConfig(
    model_path="Qwen/Qwen3-1.7B",
    dataset="recipe.my_dataset:MyDataset",
    dataset_kwargs={
        "path": "/data/train.jsonl",
        "batch_size": 4,
        "seed": 42,
    },
    reward="recipe.my_dataset:MyDataset.reward",
    group_size=4,
    pacing_window=1,
)
工程上建议先让 reward 保持纯函数、可重复测试,并对异常样本显式返回或记录错误。不要一开始就把远程 Judge、工具执行、沙箱交互和多个奖励模型全部塞进同一条链路,否则排障时很难判断是数据、生成、评分还是队列出了问题。
怎么写自己的训练拓扑?
一个 recipe 至少导出三部分:
SERVICE_GROUPS = [...]   # 有哪些角色、多少副本、各用几张卡
COLOCATIONS = [...]      # 哪些 GPU 角色共享同一组卡,可选

def main():
    Ignitor(SERVICE_GROUPS, COLOCATIONS).run()
如果只是从共置切换到分离部署,可以移除 colocate_with 和 COLOCATIONS,各个 Service 的业务代码不用改变。
如果要加入新角色,则需要明确三件事:
- 它消费 TransferQueue 中的哪些列;
- 它会新增或改写哪些列;
- 它是中间处理者还是最终消费者——只有最终消费者才应清理样本行。
第三点很容易踩坑。如果中间 Teacher 在写回分数后就把行清掉,下游 Trainer 会永远等不到完整样本。
生产环境怎么上?
如果是我,我不会直接把官方 demo 扩成十几张卡长期训练,而会分五步:
- 固定版本:锁定 Meshy commit、Docker image digest、模型 revision 和数据集快照。当前仓库没有正式 Release/Tag,不能长期跟随
main。 - 单卡闭环:先用
grpo_gsm8k验证模型下载、SGLang 生成、TQ 数据流、TorchTitan 更新和 checkpoint 全链路。 - 换自己的最小数据:只替换 Dataset 和 reward,保持同步
pacing_window=1,先验证训练曲线和样本格式。 - 再改资源拓扑:先做 2 卡或小规模 disaggregate,对比共置与分离部署的 GPU 利用率、权重同步时间和峰值显存。
- 最后打开异步:逐步从窗口 1 调到 2,再考虑完全异步;同时监控策略版本滞后、样本等待时间、队列积压和训练稳定性。
建议把以下内容纳入最低可观测性:
- 每个 Service 独立日志与退出码;
- TQ 每个分区的待生产、已就绪、待消费行数;
- 样本的
weight_version与训练消费版本差; - GPU 令牌当前持有者、等待者及每次切换耗时;
- checkpoint 保存、推理端加载和验证结果;
- rollout 吞吐、trainer step time、失败样本和截断比例。
目前有哪些限制?
Meshy 的设计很有意思,但它仍然是一个刚开源的 alpha 工程,选型时要把边界看清楚。
- 当前没有官方性能 Benchmark。 官方材料重点解释架构,没有给出与 verl、slime、Relax 在同硬件、同模型、同精度和同算法下的吞吐对比。因此现在可以说它减少了中央数据转发与调度路径,不能据此直接宣称“训练更快多少”。
- TQ 从可选组件变成必需基础设施。 数据、gate 和 GPU token 都依赖 TransferQueue;架构更统一,但团队也必须理解并维护它。
- 调试从一条调用栈变成多服务日志。 队列状态更可观察,却无法再靠中央 controller 的一个断点看完整世界。
- 环境版本较新且绑定较紧。 当前手动安装文档要求 Python 3.12、CUDA 12.9,并固定了特定 PyTorch、SGLang、TorchTitan 和 TransferQueue 版本,直接混入旧集群环境有较高冲突风险。
- 分布式不是“多写一个副本数”那么简单。 官方文档明确提醒,简单增加 Rollout/Trainer 副本并不会自动带来数据分片和独立 gate stream。
- 许可证状态需要确认。 截至本文核验的 commit,仓库根目录没有 LICENSE 文件。研究试用可以继续关注项目更新,商业使用或二次分发前应先向维护者确认授权边界。
Meshy 适合谁?不适合谁?
比较适合
- 正在研究同步与异步 LLM RL、需要频繁改训练节拍的团队;
- 希望在 SGLang 推理与 TorchTitan 训练之间做共置或分离部署的人;
- 需要加入 Teacher、Scoring、在线蒸馏等新角色,不想反复改中央训练循环的系统研究者;
- 愿意通过 recipe、数据列契约和多进程日志管理复杂系统的基础设施团队。
暂时不太适合
- 只想单卡 LoRA/SFT、希望开箱即用完成训练的个人开发者;
- 现有环境无法支持官方 CUDA/Python 组合,且不方便使用容器的集群;
- 需要成熟 Release、稳定兼容矩阵、完整 Benchmark 和明确商业许可证的生产团队;
- 流程固定、规模不大、同步 controller 已经足够稳定的项目。对这类任务,换架构未必能收回迁移成本。
最后怎么看 Meshy?
Meshy 最值得关注的,不是它又提供了一份 GRPO recipe,而是它重新回答了一个系统问题:
当 RL 的进度单位从“全局训练轮次”变成“样本、权重版本和独立服务”时,是否还需要一个中央控制器替所有角色推进流程?
它给出的答案是:让角色独立运行,让数据列决定何时可计算,让 topology 从 recipe 确定性地产生,再把 GPU 使用权也变成可以传递的 token。
这条路线未必会替代所有 Single-Controller 框架。对于小规模、固定流程的同步训练,中央循环依然简单、成熟、好调试。但在全异步 RL、多轮 Agent、Teacher/Student 在线蒸馏和多角色共置这些场景里,Meshy 的“服务 + 队列 + 数据契约”确实提供了一种更自然的表达方式。
目前最合理的态度不是急着比较谁“碾压”谁,而是先用单卡 recipe 跑通,再用自己的数据验证三件事:队列是否真的更容易观测,角色是否真的更容易扩展,异步化是否真的减少了等待而没有引入不可接受的策略滞后。
如果这三点成立,Meshy 才不只是架构图漂亮,而是真正值得进入后训练基础设施栈。
项目链接
- GitHub:https://github.com/OpenBMB/Meshy
- 官方中文博客:https://maydomain.notion.site/meshy-blog-zh
- 架构文档:Architecture and Services
- 共置机制:Colocation
- 自定义 Recipe:How to Build a Recipe
- 手动安装:Manual Installation