
DeepSeek-V4.1-Flash:全局 KV 仅 890 B/token,百万上下文怎么做成的?
一条长链 Agent 运行几十轮之后,真正昂贵的往往不只是“再生成一个 token”。
每次工具返回结果,模型都可能需要重新处理越来越长的输入;已经计算过的上下文还要以 KV Cache 的形式留在 HBM、主机内存或 SSD 中。上下文越长,请求越多,计算、存储和搬运三笔账就一起上涨。
DeepSeek-AI 在 2026 年 9 月发布的 DeepSeek-V4.1-Flash,瞄准的正是这笔“长上下文记忆账单”。它不是在上一代模型上简单做一次低比特量化,而是把 Causal Encoder-Decoder(CED)、Compressed Sparse Attention 2(CSA2)、FP4 KV Cache 和 SWA Bounded Replay 组合成一套架构级方案。
结果是:模型最高支持 100 万 token 上下文,Prefill 每 token 激活 8B 参数,Decode 激活 16B 参数;常驻 HBM 的全局 KV Cache 被压到 890 B/token,约为 DeepSeek-V4-Flash 的四分之一。
论文: DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression
作者:DeepSeek-AI
模型权重:DeepSeek-AI / DeepSeek-V4.1-Flash
长上下文真正卡住的,已经不只是注意力计算
在短对话里,KV Cache 更像是一种用空间换时间的优化:保存历史 token 的 Key 和 Value,后续解码便不必重复计算。
但到了百万 token 和长链 Agent 场景,这个“缓存”本身会变成系统负担。论文把问题拆成三层:
- 计算:工具调用不断把新内容接回上下文,Cache Miss 时会触发大规模 Prefill;
- 存储:运行时全局 KV 长驻 HBM,可复用的持久化 KV 还要占用主机内存或 SSD;
- 带宽:缓存需要在 SSD、主机内存和加速卡之间加载、迁移,I/O 与互联带宽会限制吞吐。
因此,长上下文部署不能只问“注意力算得快不快”,还要问“每个 token 留下多少状态、这些状态存在哪里、下次调用如何恢复”。
论文 Fig. 1 给出了最直观的量级变化:DeepSeek-V1 的全局 KV 为 389,120 B/token,V3.2 降到 48,068 B,V4-Flash 为 3,514 B,而 V4.1-Flash 进一步降至 890 B。相对 V4-Flash 约缩小 3.9 倍,相对 V1 约缩小 437 倍。
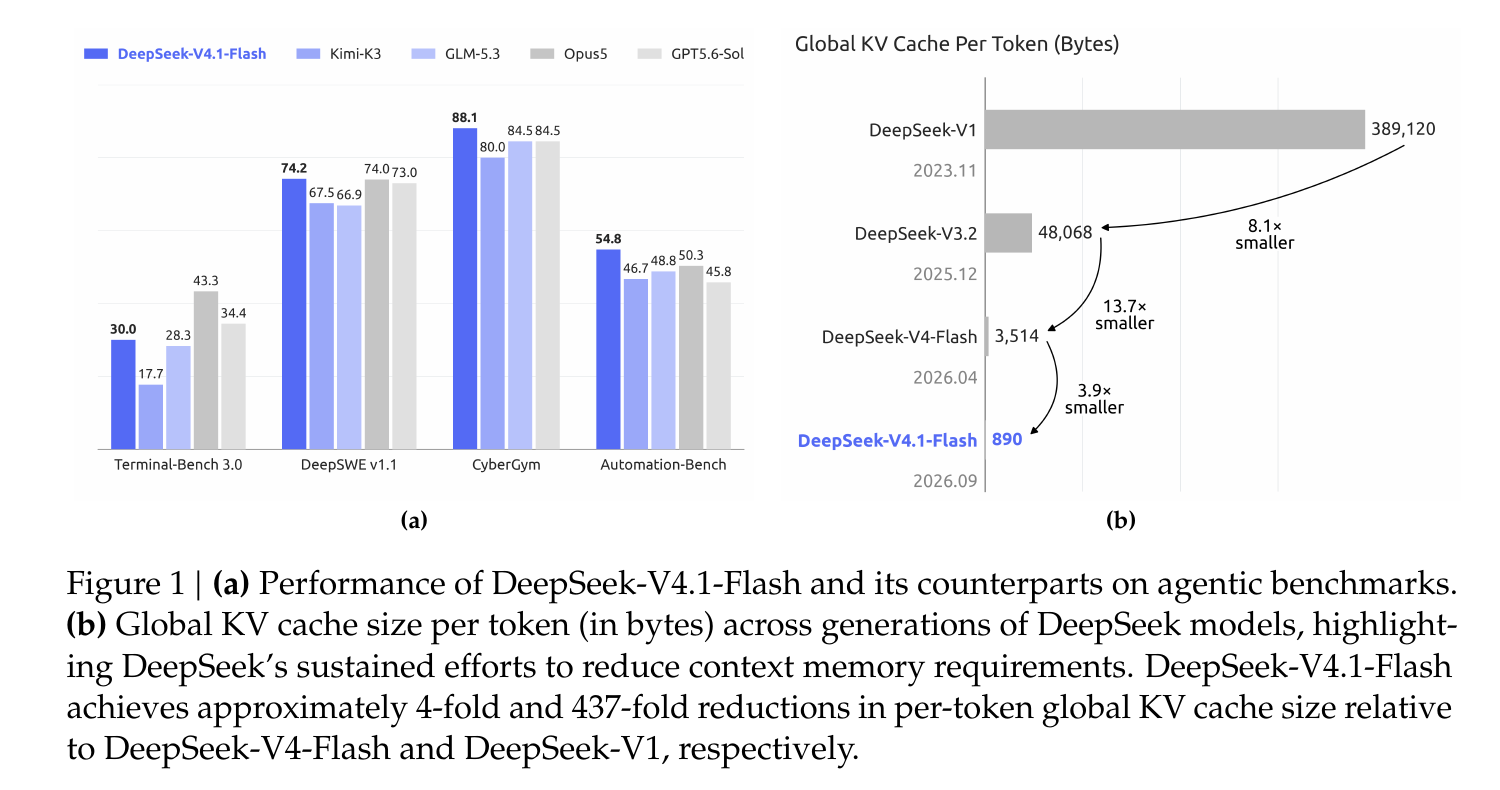
图 2 Agent 基准与历代全局 KV Cache 大小:V4.1-Flash 达到 890 B/token
这里必须先划清边界:890 B/token 指常驻 HBM 的全局 KV Cache,不是一个请求的全部显存占用。 模型权重、激活、局部滑窗 KV、运行时工作区等仍然要占空间。若只做一个直观换算,100 万 token 对应的全局 KV 约为 890 MB(按十进制计);它能说明压缩量级,但不能直接当作整机显存预算。
第一刀:CED 让 Prefill 不必完整跑过整个模型
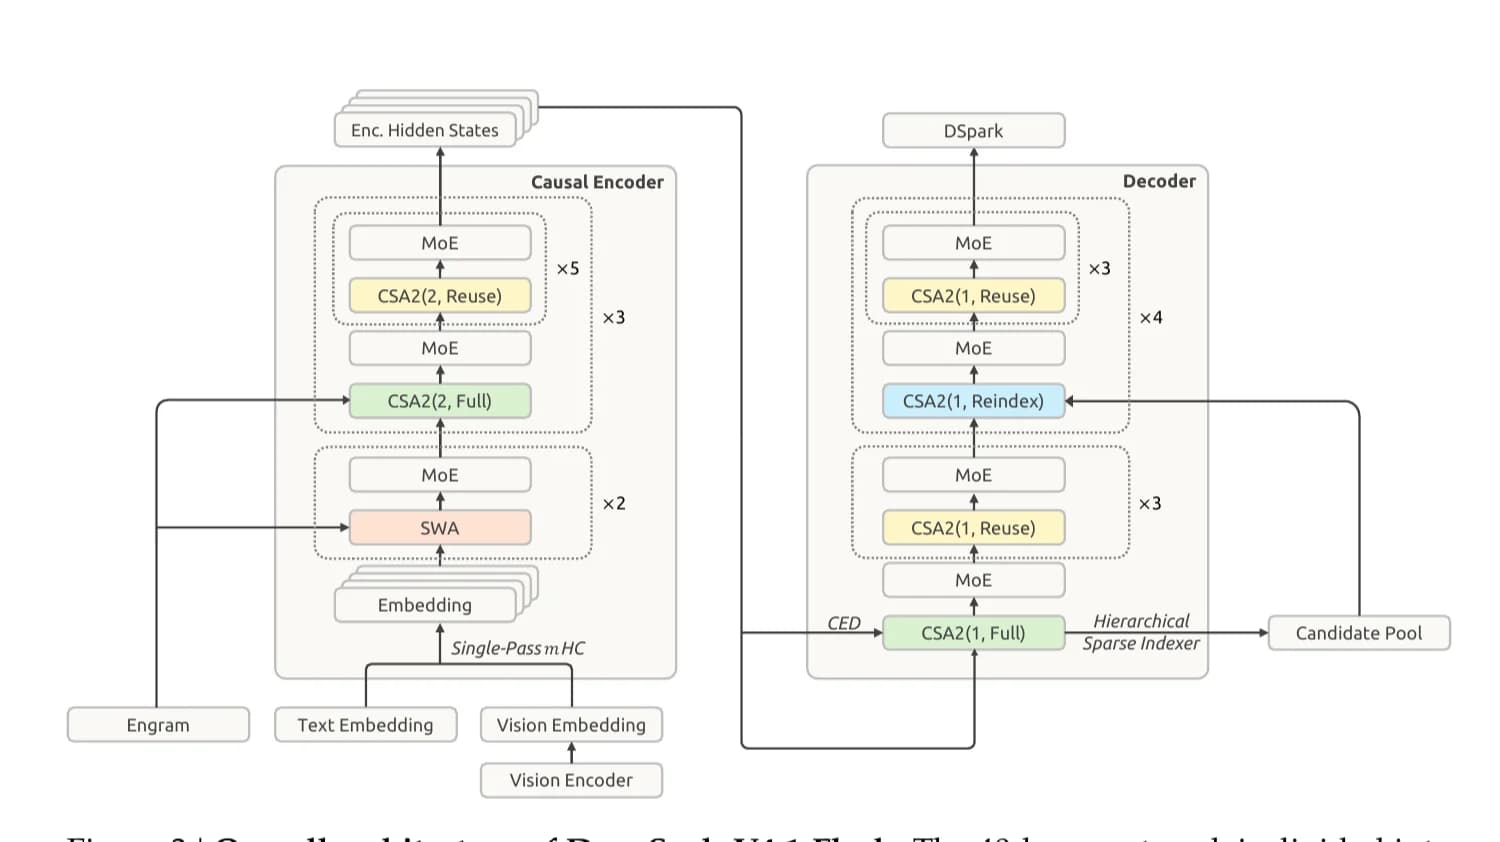
DeepSeek-V4.1-Flash 的语言骨干有 40 层,由 20 层因果编码器和 20 层解码器组成,总骨干参数为 552B,另有 196B Engram 参数。
普通 Decoder-only 模型处理长输入时,每个 prompt token 都要穿过完整网络。CED 改变了这条路径:输入先经过因果编码器,解码器所需的全局 KV 再由编码器最终隐藏状态投影得到。这样,大部分输入 token 不必再完整执行解码器的全套计算。
这正是“Prefill 激活 8B、Decode 激活 16B”的来源。它并不表示模型只有 8B 或 16B 参数,而是指 MoE 路由后,每个 token 在相应阶段实际参与计算的参数规模。
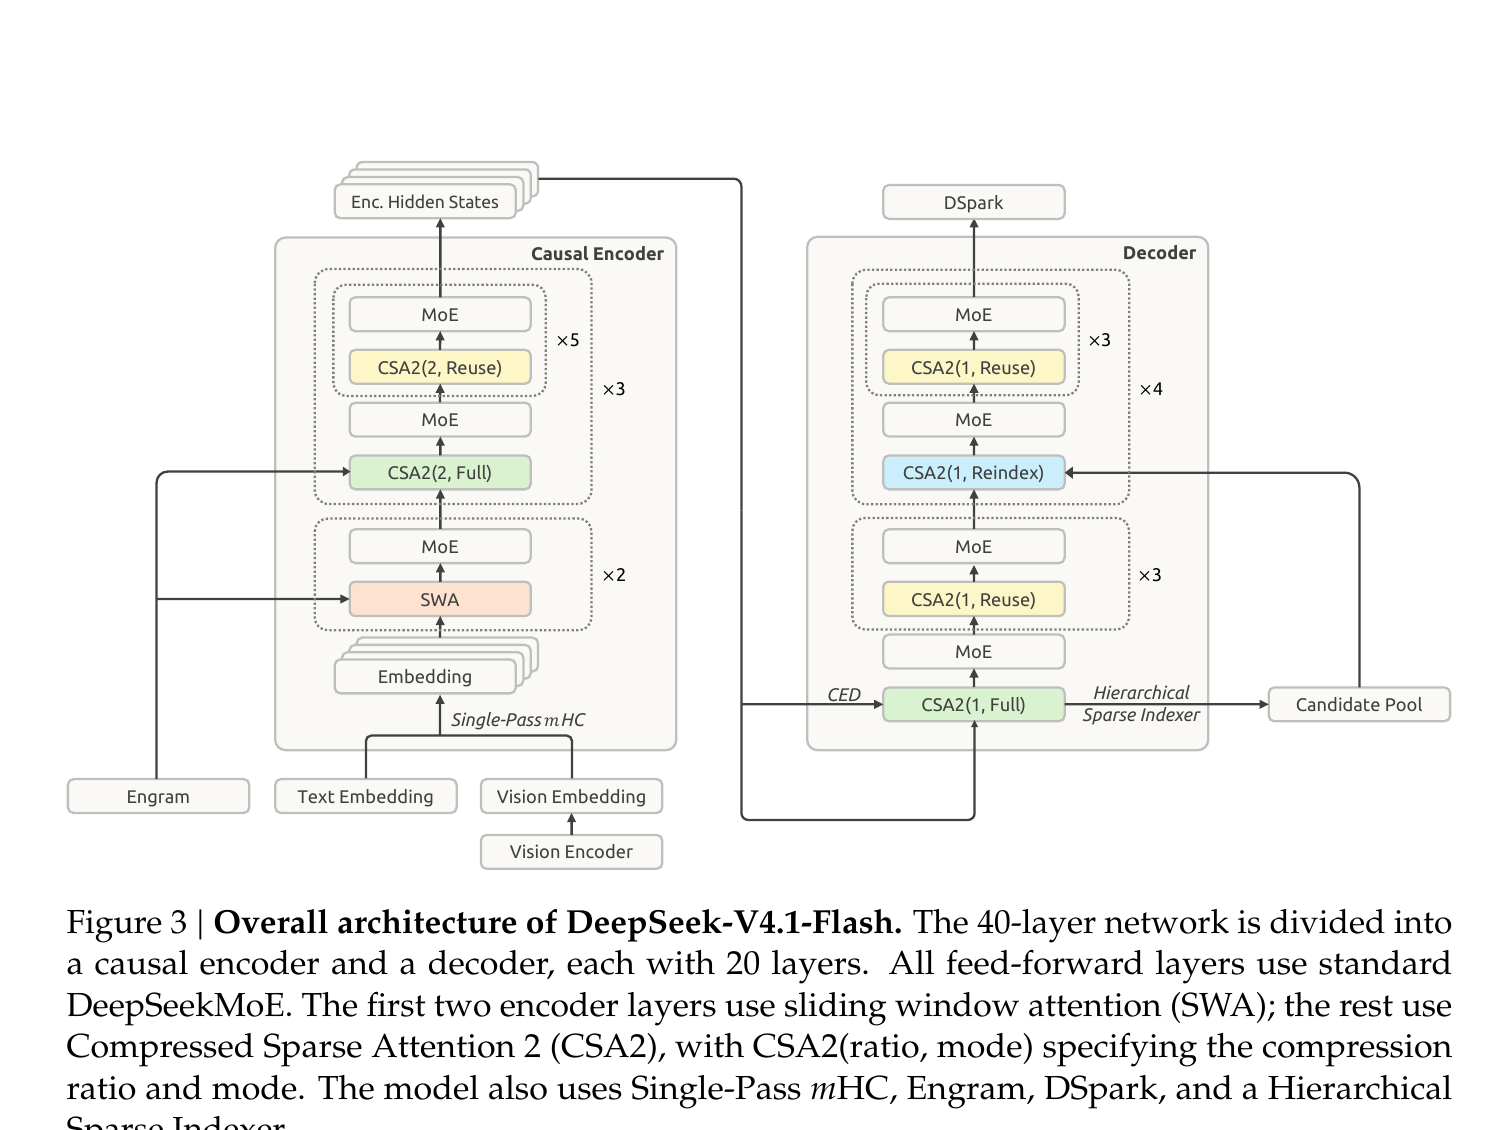
图 3 DeepSeek-V4.1-Flash 总体架构:20 层因果编码器、20 层解码器,以及 CSA2、Engram、DSpark 等组件
对于 Agent,这个设计尤其重要。工具调用会不断产生新的观察结果,缓存一旦没有命中,系统就要重新 Prefill。CED 优化的不是偶尔发生的一次启动,而是长任务中反复出现的输入处理成本。
第二刀:CSA2 不让每一层都保存一套全局记忆
CED 解决 Prefill 计算,CSA2 负责继续压缩跨层 KV 与索引开销。
它保留每层自己的 Query 和滑动窗口 KV,但把全局主 KV、Indexer K 与 Top-K 选择结果按不同程度跨层复用。论文把 CSA2 层固定分成三种模式:
- Full Mode:自己生成主 KV 和索引,完整跑一次 Top-K 检索;
- Reindex Mode:复用前层的主 KV 和 Indexer K,但用自己的 Query 重新选择 Top-K;
- Reuse Mode:主 KV 和 Top-K 结果都复用,直接做稀疏注意力。
这三种模式不是简单的“算或不算”,而是在表达能力与系统成本之间设置三个档位。少数 Full 层建立新记忆,Reindex 层允许不同深度重新判断哪些历史信息重要,Reuse 层则避免重复存储和检索。
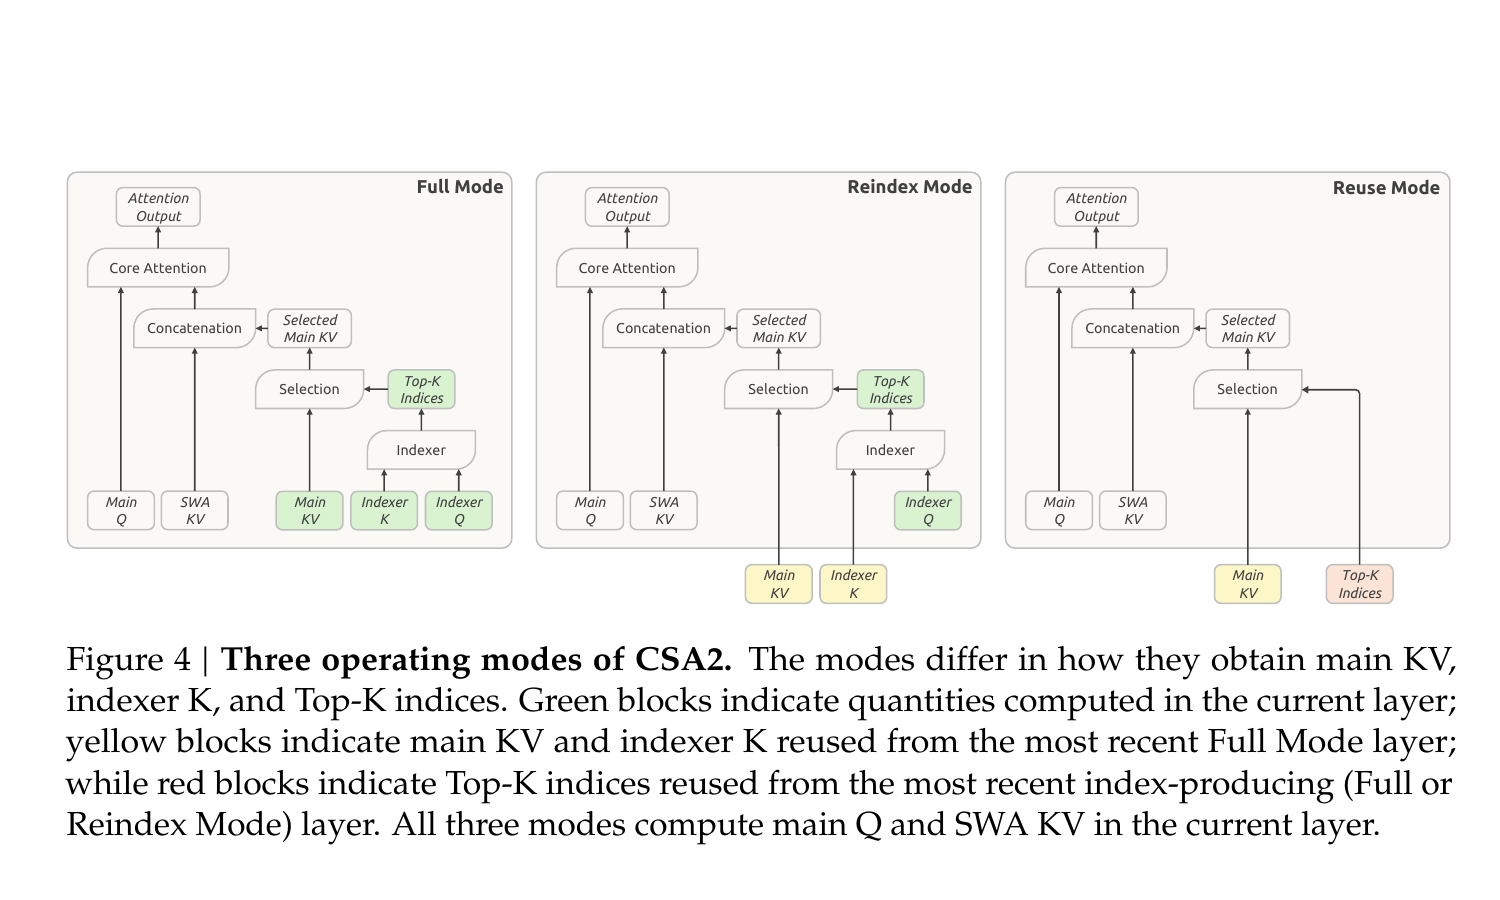
图 4 CSA2 的 Full、Reindex、Reuse 三种工作模式
百万 token 下,即使只在少数层重新索引,如果每次仍扫描全部历史,Decode 成本还是会随上下文增长。为此,CSA2 又加入 Hierarchical Sparse Indexer:第一个 Full 层扫描全局并建立候选池,后续 Reindex 层只在候选池中选择 Top-512。候选池大小固定时,后续索引器的单次搜索成本便不再随完整上下文线性增长。
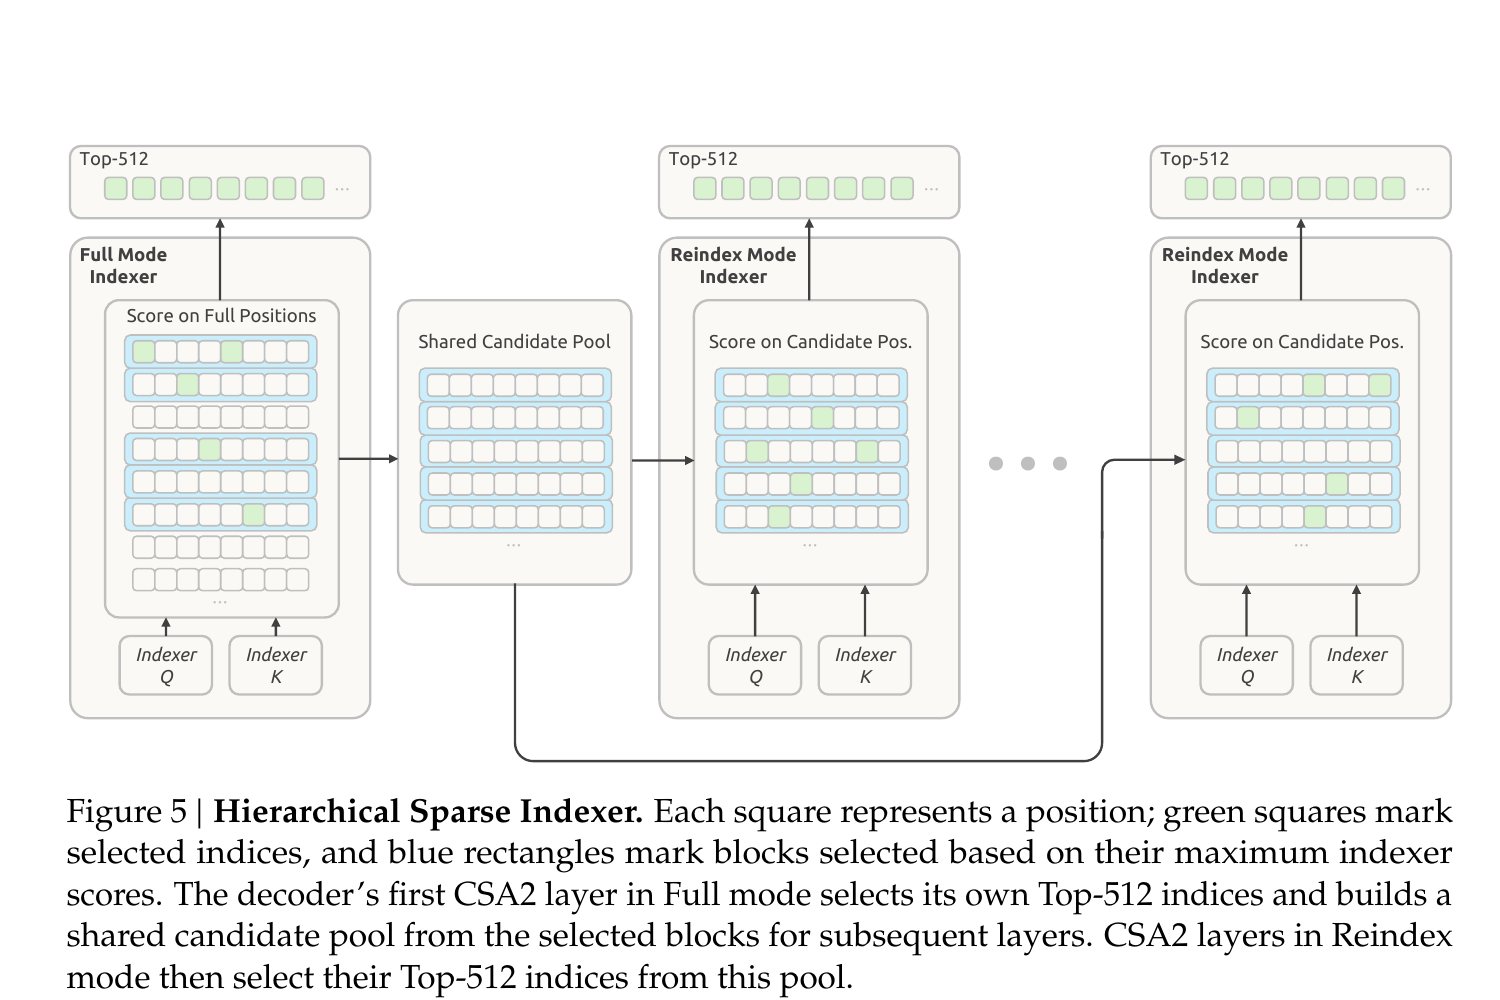
图 5 分层稀疏索引:首层建立共享候选池,后续层只在池内重排 Top-512
需要注意的是,第一个 Full 层仍要看完整的因果可见范围。所谓“近似常数成本”针对的是后续更深的索引器,而不是把所有长上下文检索都变成了常数复杂度。
第三刀:FP4 管 HBM,Bounded Replay 管 SSD
CSA2 解决“跨层重复存什么”,FP4 继续解决“每个数用多少位存”。
DeepSeek-V4.1-Flash 将量化感知训练扩展到主 KV Cache,采用 E2M1 数据与每 16 个通道一个 E4M3 scale 的约四比特格式。论文选择在 RoPE 之后量化,并在注意力计算前反量化。这样,FP4 的主要作用是节省缓存空间,而不要求所有硬件原生支持 FP4 矩阵乘法。
不过,模型没有把所有 KV 都降成 FP4。对量化更敏感的滑动窗口 KV 仍保留 FP8。这也是为什么“FP4 KV Cache”不能被理解成整套缓存无差别四比特化。
持久化缓存则采用另一种思路。过去若要精确恢复各层 SWA 状态,需要重放最近的 个 token;SWA Bounded Replay 只重放最近的 个 token,用少量 Prefill 重算换取不再把整套 SWA KV 长期写入 SSD 或主机内存。论文称,这使持久化 KV 占用降到 V4-Flash 的约八分之一,实验中的性能损失可忽略。
换句话说,这里不是“压缩一切”,而是把数据分成两类:值得长期保留的全局状态尽量压小;能低成本恢复的局部状态少存一点,需要时重算。
1M 上下文下,Decode 计算为什么没有一起爆炸
CED、CSA2、分层索引与低精度缓存叠加之后,V4.1-Flash 的单 token Decode FLOPs 随上下文长度增长得很慢。论文报告,从 4K 扩展到 1M、上下文放大 256 倍时,Decode FLOPs 只增加约四分之一。
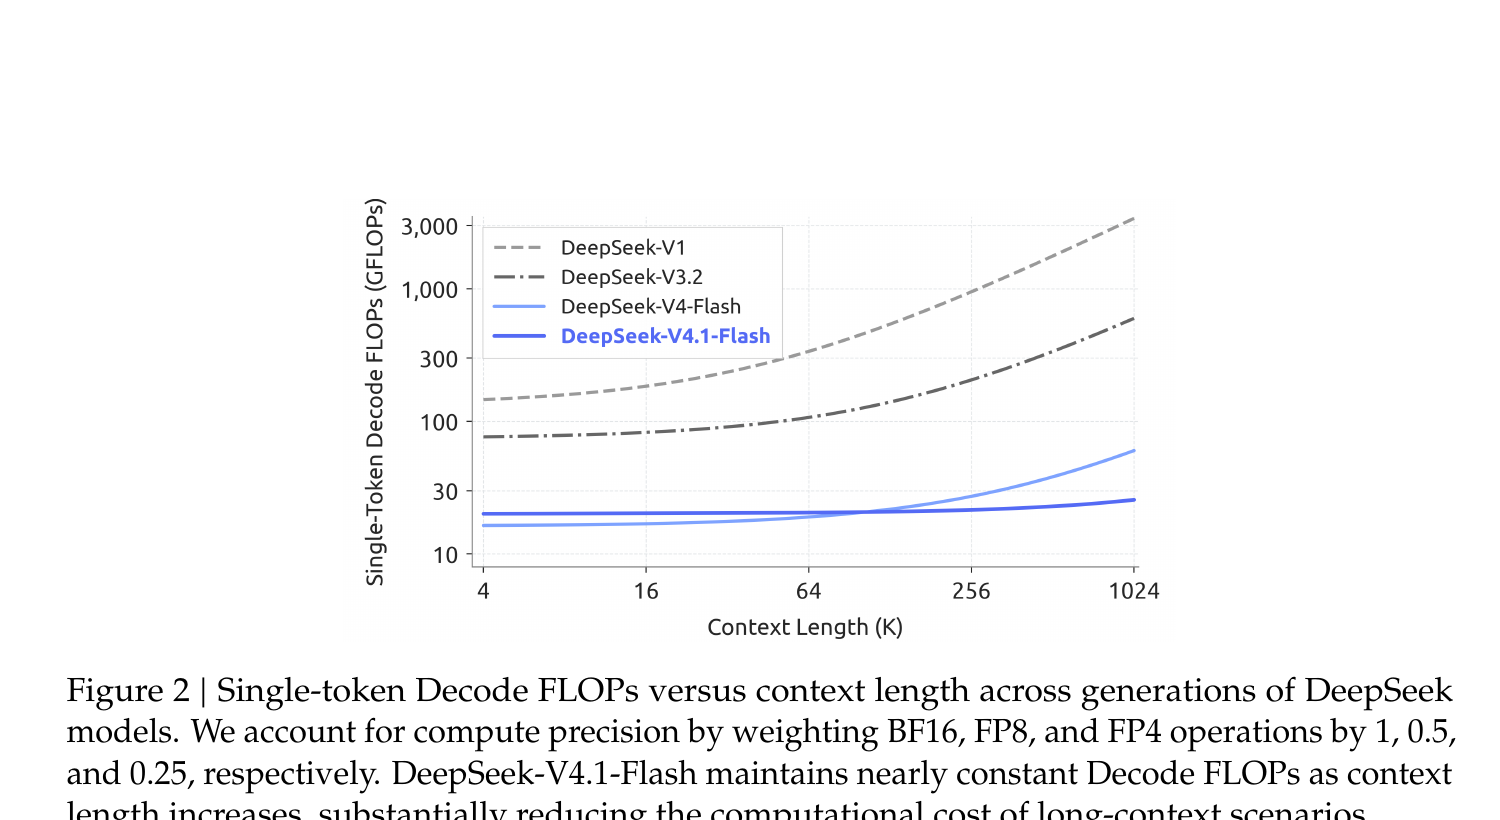
图 6 不同 DeepSeek 代际的单 token Decode FLOPs 随上下文增长曲线
这张图反映的是按 BF16、FP8、FP4 分别赋予 1、0.5、0.25 权重后的计算量估计,并不等同于某一款 GPU 上的真实延迟。真正的吞吐还会受到 kernel 实现、并行策略、缓存命中、数据搬运和硬件 FP4 支持影响。
压缩之后,能力是否被牺牲了
从论文内部同设置对比看,V4.1-Flash-Base 并没有因为更激进的缓存设计而整体退化。它以 552B 骨干和 8B/16B 激活参数,在 MMLU-Pro、BigCodeBench、HumanEval、GSM8K 等项目上达到或超过参数更大的 V4-Pro-Base;同时原生加入多模态训练,在 MMMU-Pro、CVBench、DocVQA 和 RefCOCO 上给出了结果。
但 Table 1 也说明它不是所有指标都更高:例如 LongBench-V2 为 45.2,低于 V4-Pro-Base 的 51.5;MGSM 为 80.2,也低于两代对照模型。因此,更准确的结论是 总体能力与部署效率的帕累托前沿前移了,而不是“所有能力无损、所有任务全面胜出”。
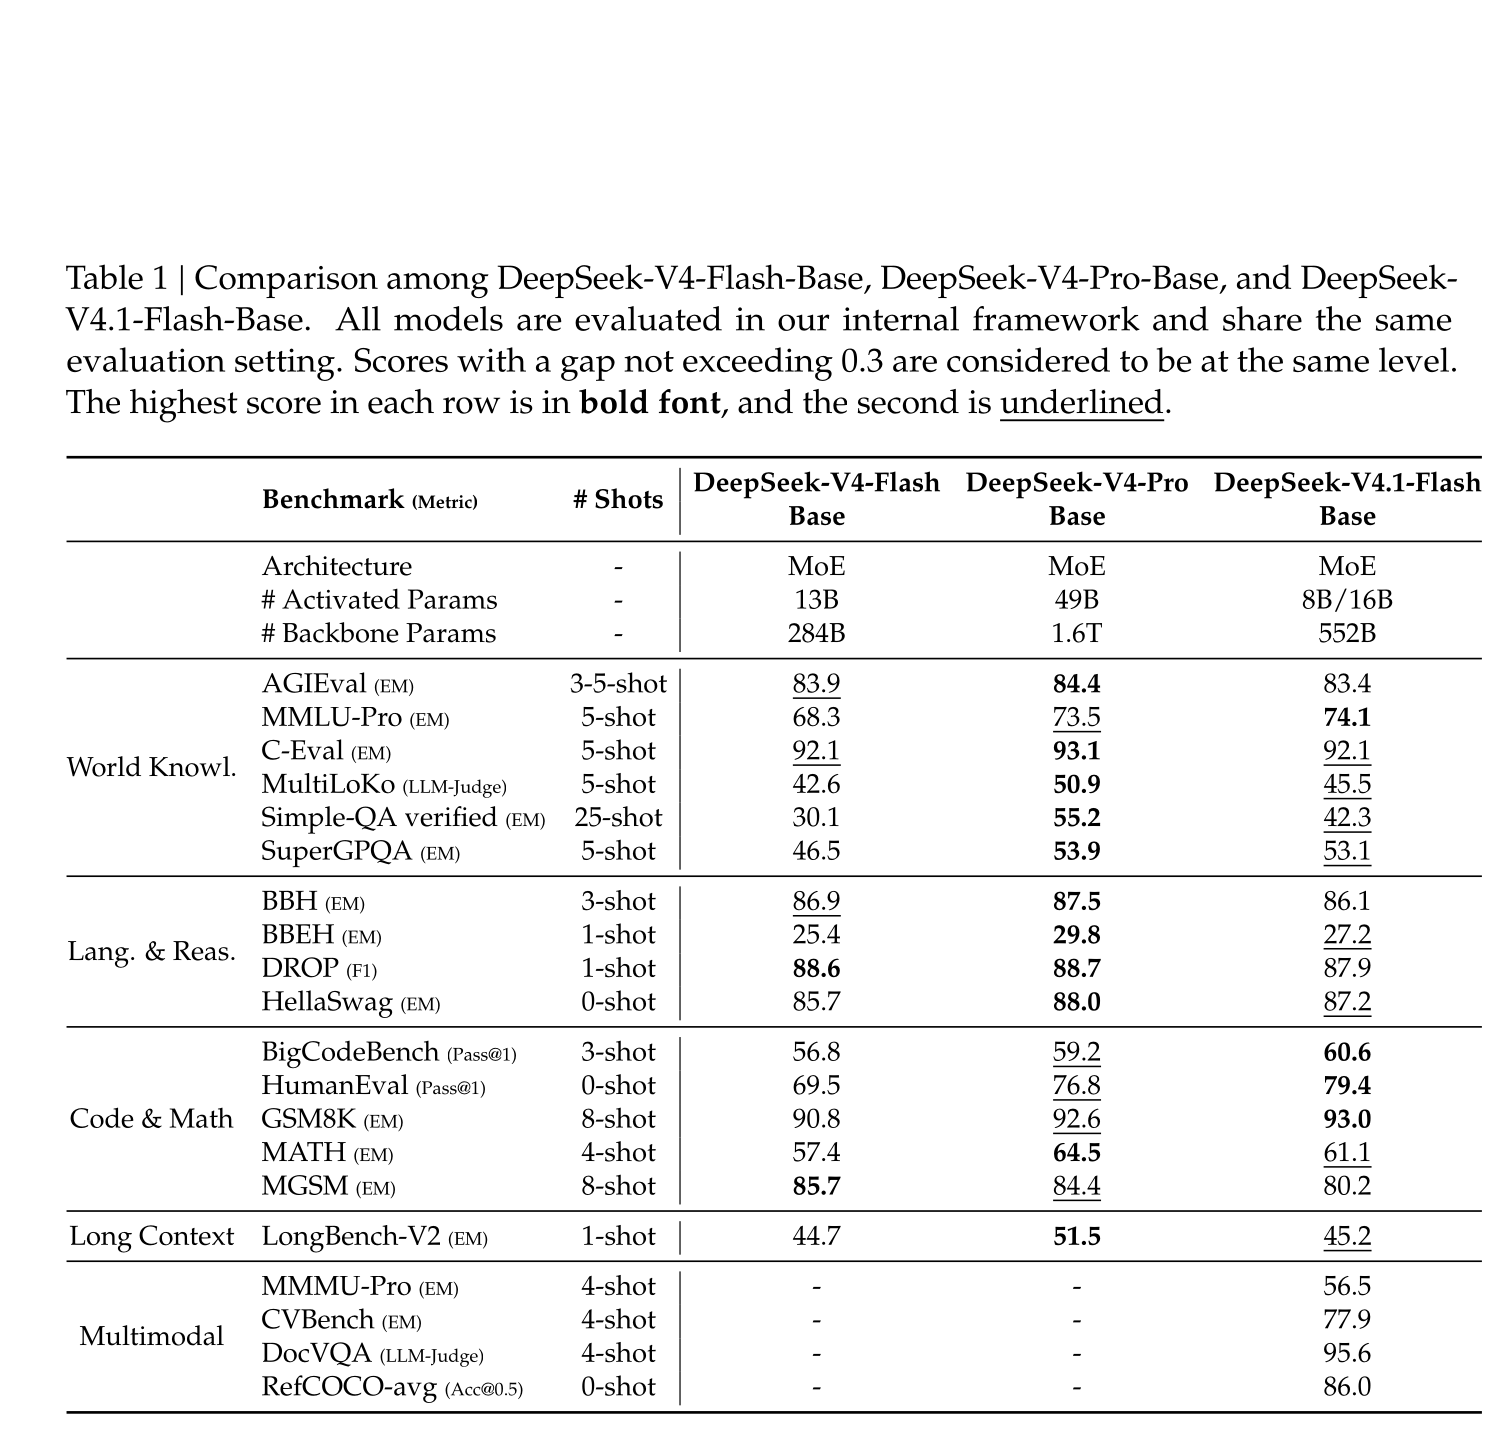
图 7 三个 DeepSeek Base 模型的架构与基础能力比较
后训练模型在 Agent 基准上的提升更明显:DeepSWE v1.1 从 V4-Flash 的 54.4 提升到 74.2,Terminal-Bench 2.1 从 82.7 提升到 90.6,Automation-Bench 从 37.7 提升到 54.8。论文也主动承认,在 Terminal-Bench 4.0 等需要专家知识的科学型 Agent 任务,以及部分视觉 Agent 任务上,与领先闭源大模型仍有差距。
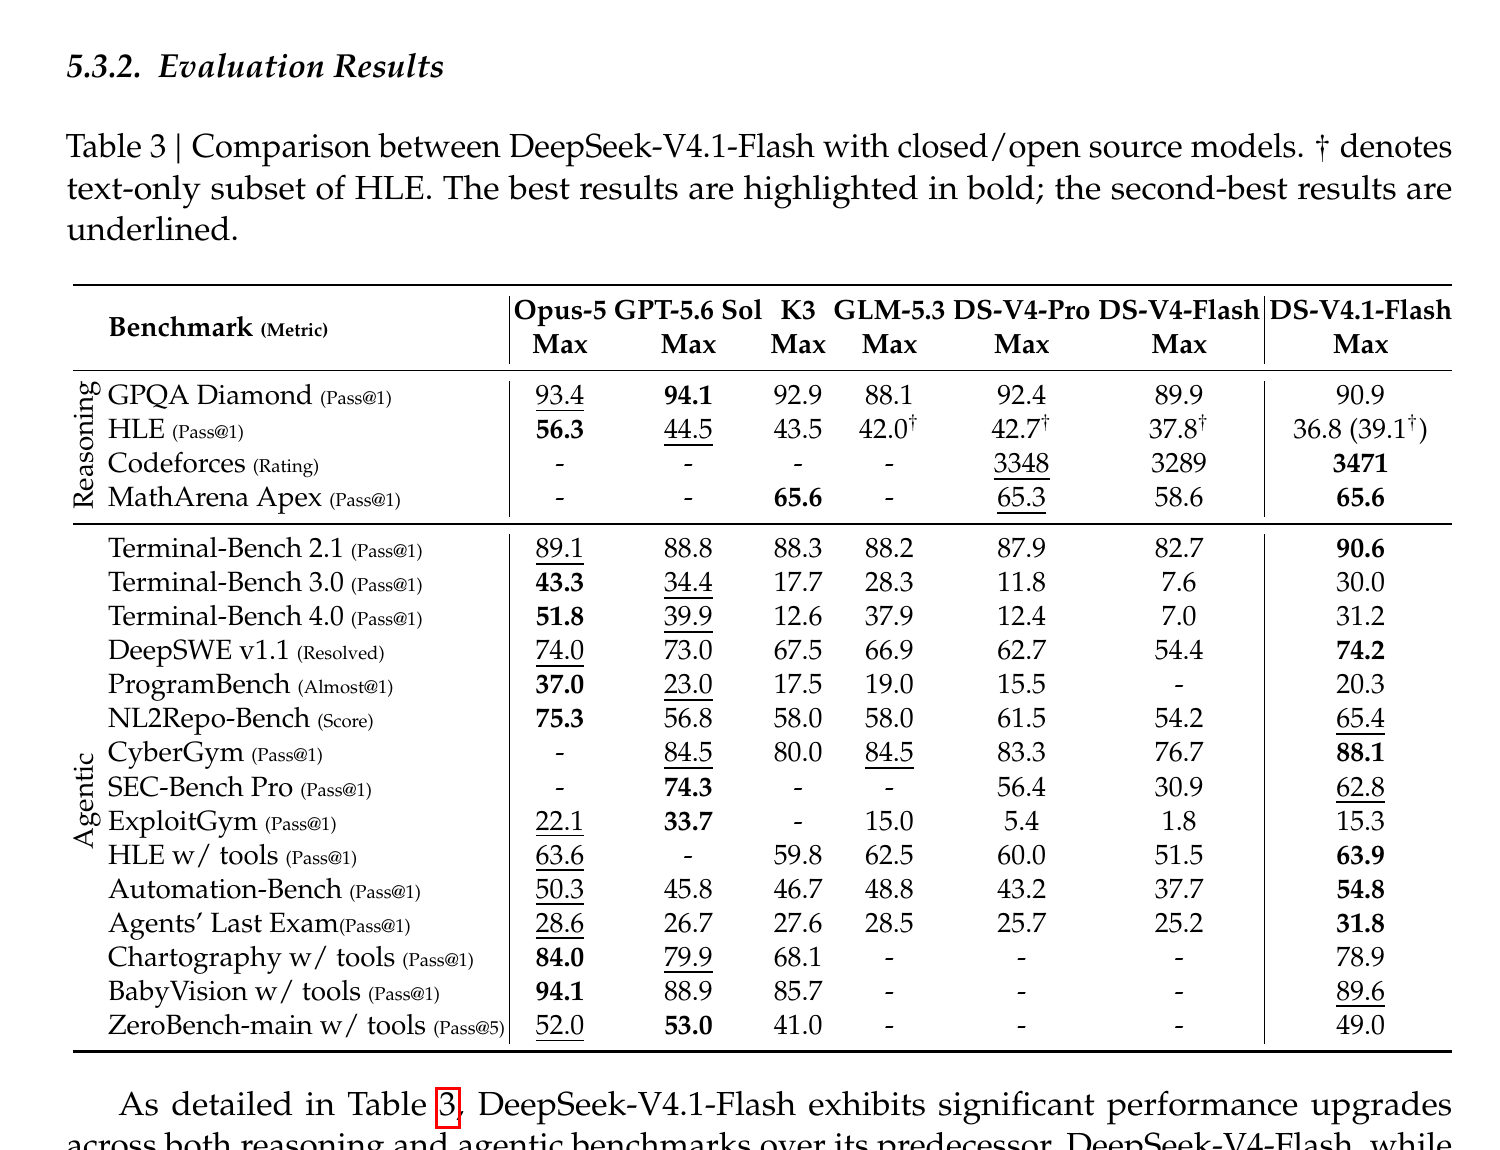
图 8 V4.1-Flash 与开源、闭源模型在推理和 Agent 基准上的比较
对长上下文与 Agent 部署团队,真正有用的是什么
DeepSeek-V4.1-Flash 最值得借鉴的并不是一个孤立的“890 字节”数字,而是它对部署问题的分层处理:
- 用 CED 缩短输入 token 的计算路径;
- 用 CSA2 减少跨层重复状态和重复索引;
- 用 FP4 压低必须常驻 HBM 的全局缓存;
- 用 Bounded Replay 把部分持久化存储换成可控重算;
- 再通过 kernel fusion、状态管理与推理系统把架构收益真正兑现。
这套思路特别适合输入远长于输出、频繁调用工具、需要复用前缀的 Agent 服务。它也提醒部署团队:模型的“激活参数少”不自动等于便宜,“支持 1M 上下文”也不自动等于 1M 上下文可以低成本并发。必须把 Prefill、Decode、HBM、持久化缓存和迁移带宽放在一张系统账单里评估。
DeepSeek-V4.1-Flash 的关键变化,正是把 KV Cache 从一个推理实现细节,提升成模型架构设计的中心变量。对未来的长上下文模型而言,竞争可能不再只是“谁能读得更长”,还包括“读完之后,谁留下的记忆更少、更便宜,也更容易再次调用”。